Rimay Quantum Feature Extraction - Kipu Quantum による Qiskit Function
API リファレンスをご覧ください。
Qiskit Functions は実験的な機能であり、IBM Quantum® Premium Plan、Flex Plan、On-Prem (IBM Quantum Platform API 経由) Plan のユーザーのみが利用できます。プレビューリリースの状態であり、変更される場合があります。
概要
Rimay は、量子ハードウェア上で生成された特徴量で、古典的な機械学習パイプラインを拡張します。この関数は、古典的な表形式データを受け取り、量子変換された特徴量のセットを返します。量子システムがデータを処理すると、入力間の非線形な関係を捉えた豊かな特徴量が生成されます。生成された特徴量は、単独で使うことも、元の特徴量と組み合わせて使うこともでき、任意の古典モデルの学習に利用できます。小規模から中規模のデータセットでは、量子変換された特徴量により、純粋に古典的なベースラインと比べて予測品質を向上できる場合があります。
この関数は、次のようなユーザーを対象としています。
-
小規模から中規模の表形式データセットに対する既存の機械学習パイプラインを持ち、予測品質が頭打ちになっているデータサイエンスチーム。量子回路を自分で構築することなく、Rimay を前処理ステップとして 1 つ追加するだけで利用できます。
-
機械学習タスクに対する量子的手法を探求する研究者。
説明
量子特徴抽出アルゴリズム [1] は、量子機械学習の 2 つの原理を組み合わせています。1 つ目は量子特徴マップで、データを高次元のヒルベルト空間に埋め込み、より表現力の高い表現を生成します。2 つ目は量子リザーバーコンピューティングで、量子多体系のダイナミクスを入力の非線形変換として利用します。
Rimay は、特徴量の値と特徴量間の相互情報量を、スピングラスハミルトニアンの局所場と結合係数に符号化します。カウンターディアバティックな量子ダイナミクスにより、系は低エネルギー状態へと発展し、その状態には入力データの相関の非線形な混合が含まれます。Rimay は、1 体および 2 体の期待値を測定することで、これらの相関を抽出します。この期待値が、機械学習モデルに入力する、量子変換された特徴量です。
ワークフロー
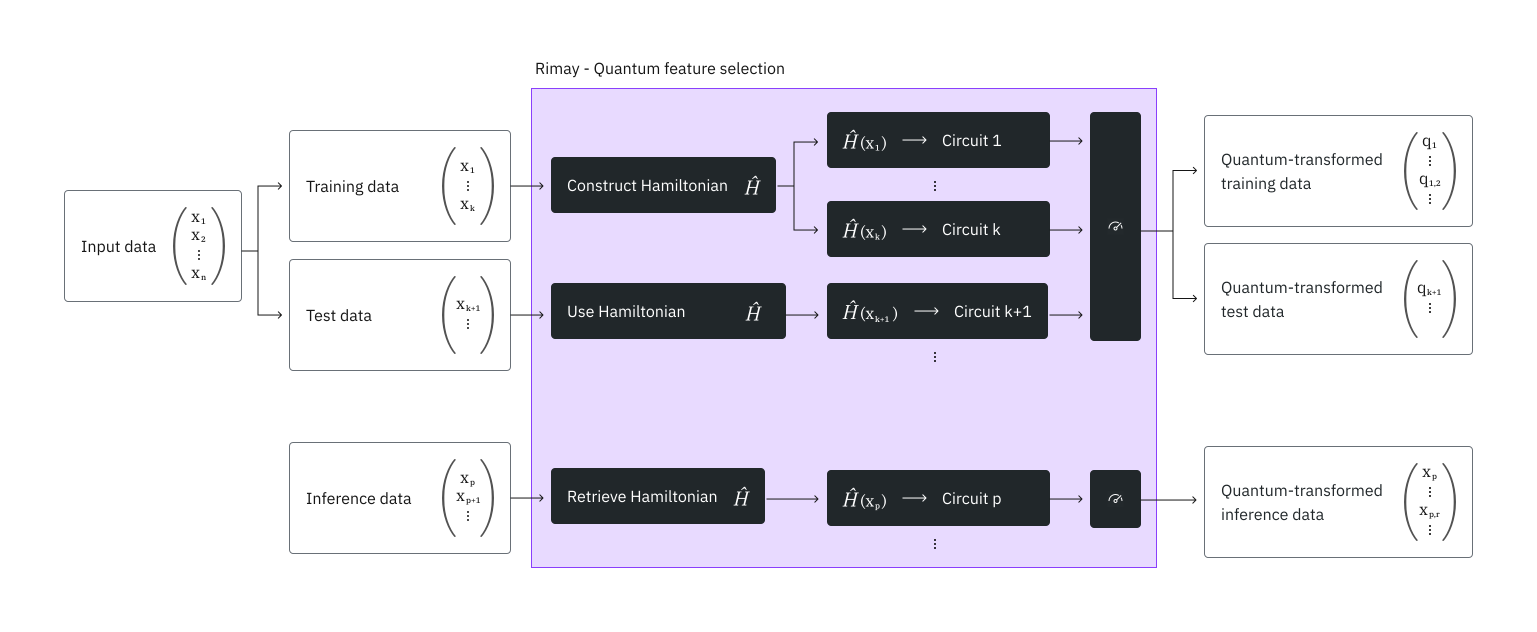
-
古典的な機械学習の場合と同様に、表形式データを前処理します。Rimay には数値の特徴量が必要なため、たとえば scikit-learn の
OneHotEncoderなどを使って、カテゴリカルな特徴量を数値に変換します。 -
データを訓練セットとテストセットに分割し、例のセクションに示すように、両方を関数にアップロードします。
-
Rimay は訓練データを使って、データを表すハミルトニアンを構築します。各特徴量が 1 つの量子ビットに対応し、訓練セット全体によって、どの特徴量が、したがってどの量子ビットが相互作用するかが決まります。Rimay はこの構造を保存し、テストデータや後の推論データを同じハミルトニアンでマッピングします。
-
各サンプルについて、特徴量の値がハミルトニアンの局所場を設定し、特徴量間の相互情報量がステップ 3 の構造の結合係数を設定します。Rimay は、このハミルトニアンのカウンターディアバティックな発展を回路にデジタル化し、その回路を QPU 上で実行します。
-
Rimay は得られたビット列を測定し、1 体の期待値と、物理的に結合された量子ビットの 2 体の期待値を計算します。
-
期待値は、そのままモデルに入力したり、元の特徴量と組み合わせたりできる形式でダウンロードします。
この構造のため、実行に必要な量子ビット数は特徴量の数に等しく、送信される回路の数はサンプルの数に等しくなります。
マッピングをフィットした後は、たとえば推論のために、新しいデータをそのマッピングに通せます。Rimay は、フィット中に作成したハミルトニアンを取得し、それを使って新しいサンプルの回路を構築します。
Rimay を機械学習パイプラインに統合する
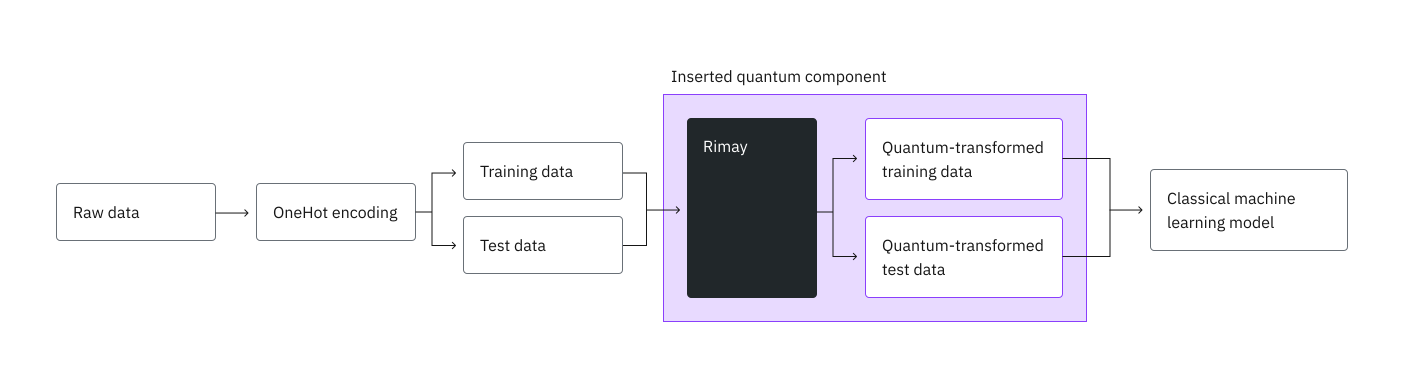
従来のパイプラインと同様に、まず生データを前処理します。たとえばカテゴリ特徴量をワンホットエンコーディングし、訓練セットとテストセットに分割します。両方のセットをそのままモデルに入力する代わりに、まず Rimay に入力し、量子変換された特徴量でモデルを訓練します。
ベンチマーク
Kipu Quantum は、OpenML のドイツ信用データセット [2] で Rimay のベンチマークを行いました。このデータセットは、1000人の信用申請者を信用リスクの良し悪しに分類するものです。カテゴリ属性が13個、数値属性が7個あります。カテゴリ属性をワンホットエンコーディングすると、数値特徴量は48個になります。ベンチマークでは、サンプルの20%をテストセットとして取り分けています。
ベースラインとして、従来の特徴量でいくつかの古典モデルを訓練しました。Rimay では、ランダムフォレストを2通りの方法で訓練しました。量子変換された特徴量のみを使う場合(Random forest Q)と、量子変換された特徴量に従来の特徴量を組み合わせる場合(Random forest H、ハイブリッドの意)です。量子変換された特徴量では、ランダムフォレストが最も良い性能を示したため、表にはランダムフォレストのみを掲載しています。
| モデル | 特徴量 | 正解率 | AUC | F1スコア | 適合率 | 再現率 |
|---|---|---|---|---|---|---|
| CatBoost | 古典 | 0.775 | 0.781 | 0.850 | 0.795 | 0.914 |
| Random forest | 古典 | 0.765 | 0.781 | 0.846 | 0.782 | 0.921 |
| XGBoost | 古典 | 0.760 | 0.758 | 0.835 | 0.803 | 0.871 |
| LightGBM | 古典 | 0.770 | 0.751 | 0.840 | 0.818 | 0.864 |
| Random forest Q | 量子 | 0.750 | 0.793 | 0.840 | 0.762 | 0.936 |
| Random forest H | ハイブリッド | 0.770 | 0.798 | 0.854 | 0.770 | 0.957 |
ハイブリッド特徴量により、適合率を除くランダムフォレストのすべての指標が向上し、ハイブリッドのランダムフォレストは、従来の特徴量を用いた CatBoost よりも高い AUC、F1スコア、再現率に達しています。最も大きな効果は再現率に見られ、0.921 から 0.957 に上昇しています。量子変換された特徴量のみでは、古典モデルの適合率には届きません。
テストセットには200サンプルしか含まれていないため、あと1サンプルを正しく予測すると正解率は0.005変わります。差は有意な効果ではなく、さらなる検証が必要な傾向として読んでください。また、予測精度は、抽出された特徴量に含まれるハードウェア起因のノイズにも左右されることがあります。そのため、ショットノイズが結果の制約にならないよう、十分なショット数を使用してください。
ベンチマークでは、次のリソースを使用しました。
| 例 | 量子ビット数 | サンプル数 | ショット数 | 合計時間(分) | QPU使用時間(分) | プロセッサー |
|---|---|---|---|---|---|---|
| ドイツ信用 | 48 | 1000 | 5000 | 23 | 22 | ibm_boston |
| ドイツ信用 | 48 | 1000 | 5000 | 3 | 2 | ibm_phoenix |
サンプル数、つまり回路の数が QPU 時間を左右します。必要な QPU 時間を大幅に削減できるため、Nighthawk r2 プロセッサータイプを使用してください。
入力
mode によって、実行に必要なパラメータが決まります。各入力パラメータの説明については、APIリファレンスを参照してください。
入力ファイル
-
関数を実行する前に、すべてのファイルを
catalog.file_upload()でアップロードしてください。 -
アップロードすると、同じ名前の以前のファイルは置き換えられます。送信済みでまだ開始されていないジョブがある場合も同様です。複数のジョブを同時に実行するには、ジョブごとにファイルに別々の名前を付けてください(例:
run1_x_train.csvとrun2_x_train.csv)。 -
各ファイルは、ヘッダー行を持つ CSV ファイルです。特徴量ファイルの各列が1つの特徴量であり、すべての値は数値でなければなりません。
-
y_trainには、x_trainの1行につき1つのラベルを持つ、数値の列がちょうど1つ含まれます。カテゴリラベルは数値に対応付けてください(例:good を 1、bad を 0 にする)。 -
x_testとx_inferenceは、x_trainと同じ列を同じ順序で持っている必要があります。
mapping_id は、フィットによって生成されたマッピングにアクセスするための唯一の手段であり、検索や復元はできません。このIDによってそのマッピングの使用が認可されるため、認証情報と同様に扱い、共有しないでください。紛失した場合は新しいマッピングをフィットする必要があり、量子ハードウェアでの実行がもう1回必要になります。また、マッピングはそのプロセッサーでのみ実行できるため、フィットに使用した backend_name も記録しておいてください。
制限
-
各特徴量は1つの量子ビットにマッピングされるため、プロセッサーにはデータの特徴量数以上の量子ビットが必要です。特徴量がそれより多い場合は、まず特徴量選択の手法で特徴量を減らしてください。
-
各サンプルは1つの回路になり、1回の実行では訓練サンプルとテストサンプルを合わせて数えます。1回の実行に含められるサンプルは最大15,000件です。
-
1つのジョブで要求できる実行回数は最大1,000万回です。そのため、サンプル数に
shotsを掛けた値が1,000万を超えてはいけません。 -
ジョブは、回路がプロセッサーのキューで待機する時間も含めて、24時間以内に完了する必要があります。それより長く実行されたジョブは、結果が得られないまま停止されます。混雑しているプロセッサーでは、大規模なデータセットをこれらの制限よりも十分に小さく保ってください。
出力
job.result() は辞書を返します。量子変換された特徴量そのものは CSV ファイルに書き出され、catalog.file_download() でダウンロードできます。辞書の各キーの説明については、APIリファレンスを参照してください。各実行フェーズにかかった時間については、実行メタデータを参照してください。
各出力ファイルには、入力ファイルの順序に従って入力の1行につき1行が含まれ、量子変換された特徴量ごとに1列があります。名前が corr_ で始まる列は、2体の期待値です。ファイルにラベル列は含まれません。訓練データのラベルは、y_train ファイルに残ります。
実行メタデータ
resource_usage には、実行が経由した各実行フェーズのエントリが1つずつ含まれます。"RUNNING: MAPPING"、"RUNNING: POST_PROCESSING"、そして QPU 上では通常 "RUNNING: WAITING_FOR_QPU" です。各エントリには、フェーズの実時間(秒)を表す CPU_TIME と、QPU 時間(秒)を表す QPU_TIME が含まれます。QPU 上では、IBM が課金した QPU 時間は、回路が実行されたフェーズである "RUNNING: MAPPING" に記録されます。
"RUNNING: WAITING_FOR_QPU" は、ジョブが IBM のキューで待機した時間です。実行はこの時間を IBM のジョブのタイムスタンプから取得し、"RUNNING: MAPPING" には含めません。IBM がすべてのジョブについてそれらのタイムスタンプを報告しない場合、このエントリは存在せず、待機時間は "RUNNING: MAPPING" に含まれます。
IBM® は、ジョブの終了後しばらくしてから使用量の計算を完了します。実行は最大1分ほどその完了を待ちます。その時間を過ぎても計算中の使用量は QPU_TIME に含まれず、最終的な使用量は IBM Quantum Platform に表示されます。実行が IBM から使用量を読み取れない場合、QPU_TIME は None になります。
例:
"metadata": {
    "version": "0.3.0",
    "resource_usage": {
        "RUNNING: MAPPING": {"CPU_TIME": 12.4, "QPU_TIME": 6.0},
        "RUNNING: WAITING_FOR_QPU": {"CPU_TIME": 28.8, "QPU_TIME": 0.0},
        "RUNNING: POST_PROCESSING": {"CPU_TIME": 0.3, "QPU_TIME": 0.0},
    },
}
はじめに
IBM Quantum Platform の API キーを使用して認証し、次のように Qiskit Function を選択します。
次のコードは、認証情報を保存済みであることを前提としています。まだ保存していない場合は、Qiskit Functions Catalog クライアントのインストールの手順に従って、API キーでアカウントを保存してください。
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"pandas": "pandas", "qiskit_ibm_catalog": "qiskit-ibm-catalog"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit_ibm_catalog import QiskitFunctionsCatalog

catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")

# Verify that you have access to the function
catalog.list()
[QiskitFunction(kipu-quantum/rimay)]
# Access function
rimay = catalog.load("kipu-quantum/rimay")
関数のサイズ
各ジョブは S、M、L のいずれか1つのサイズで実行されます。指定したサイズが小さすぎる場合、ジョブは拒否されます。サイズが必要以上に大きい場合は、作業に必要な以上に大きなコンピュートプロファイルで実行されます。
Rimay ジョブのサイズは、マッピングするサンプル数によって決まります。fit-transform では x_train と x_test の行数、transform では x_inference の行数です。y_train のラベルは数えず、delete の実行ではサンプルをマッピングしません。
| サイズ | ジョブあたりのサンプル数 | コンピュートプロファイル | vCPU | RAM |
|---|---|---|---|---|
S | 2,999まで | 8x32 | 8 | 32 GB |
M | 3,000~9,999 | 8x32 | 8 | 32 GB |
L | 10,000~15,000 | 16x128 | 16 | 128 GB |
サンプル数が唯一の基準です。サイズによって変わるのはコンピュートプロファイルだけで、特徴量、サンプル、ショットに関する制限はどのサイズでも同じです。S と M は同じコンピュートプロファイルで実行され、対応するサンプル数だけが異なります。
ジョブがサイズを要求しない場合は、デフォルトの M が使用されます。したがって、9,999サンプルを超えるジョブは L を要求する必要があります。
このマッピングは、rimay.sizes_map で関数自体から読み取ることもできます。また、ジョブがサイズを要求しない場合に使用されるサイズは、rimay.default_size で確認できます。
送信前にサイズを計算する
ご自身の入力に対して実行してください。入力を読み取るだけで他には何もしません。ジョブは送信されず、何も予約されないため、何度でも呼び出せます。
データセットそのもの(ファイル名ではありません)を、input_file と同じ順序で、実行の mode とともに渡します。呼び出し方は例のステップ2を参照してください。
from os import PathLike
from typing import Any, Literal, Sequence, Sized

Size = Literal["S", "M", "L"]

# Upper bounds (inclusive) in samples.
_SMALL = 2_999
_MEDIUM = 9_999

FIT_TRANSFORM, TRANSFORM, DELETE = "fit-transform", "transform", "delete"

# Which positions of input_file hold samples, per mode. The labels in
# y_train submit no circuits of their own, so they are not counted.
SAMPLE_POSITIONS = {FIT_TRANSFORM: (0, 2), TRANSFORM: (0,)}

def calculate_function_size(problem: Sequence[Sized], **kwargs: Any) -> Size:
    """Return the size ("S", "M" or "L") required to run the function."""
    metrics = _measure(problem, **kwargs)
    if _is_small(metrics):
        return "S"
    if _is_medium(metrics):
        return "M"
    return "L"

def _measure(problem: Sequence[Sized], **kwargs: Any) -> dict:
    """The samples the job submits."""
    return {"samples": count_samples(problem, kwargs.get("mode"))}

def count_samples(problem: Sequence[Sized], mode: Any) -> int:
    """Rows across the data sets of ``problem`` that carry samples."""
    if mode == DELETE:
        return 0
    if mode not in SAMPLE_POSITIONS:
        raise ValueError(f"cannot size mode {mode!r}")
    if _is_name(problem) or (
        isinstance(problem, (list, tuple))
        and any(_is_name(data) for data in problem)
    ):
        raise TypeError(
            "pass the data, not the file name: read each input_file, e.g. with "
            "pandas.read_csv, and pass the data sets in input_file order"
        )
    if not isinstance(problem, (list, tuple)):
        raise TypeError(
            "pass a list of data sets in input_file order, e.g. [x_train, y_train], "
            f"not a single {type(problem).__name__}"
        )
    return sum(
        len(problem[i]) for i in SAMPLE_POSITIONS[mode] if i < len(problem)
    )

def _is_name(value: Any) -> bool:
    """A file name or path rather than data."""
    return isinstance(value, (str, bytes, PathLike))

def _is_small(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'S'."""
    return metrics["samples"] <= _SMALL

def _is_medium(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'M'."""
    return metrics["samples"] <= _MEDIUM
サイズが小さすぎる場合、ジョブはエラー 4600 で失敗し、メッセージには代わりに使用すべきサイズが示されます。必要以上に大きい場合は、ジョブは通常どおり実行され、4601 の通知イベントが記録されます。
例
この例では、データのアップロード、関数の実行、量子変換された特徴量の取得の方法を示します。前処理と古典モデルの訓練を含むエンドツーエンドの例については、チュートリアルを参照してください。
1. データをアップロードする
この例では、4つの数値特徴量とバイナリラベルを持つ小さな合成データセットを使用します。これにより、実行に必要な量子ビットは4つだけで、すぐに完了します。次のセルは、訓練用の特徴量、訓練用のラベル、テスト用の特徴量、そしてこの例のステップ4で使う特徴量の、4つの CSV ファイルを書き出します。ご自身のデータを使うには、前処理した訓練セットとテストセットを、同じレイアウトのファイルとして書き出してください。
from pathlib import Path

Path("x_train.csv").write_text("""f0,f1,f2,f3
0.7227,1.3355,1.9595,2.5562
0.2731,0.5779,0.8983,1.1624
0.1139,0.1817,0.2163,0.2426
0.0341,0.1311,0.0854,0.09
0.8996,1.6951,2.497,3.3407
0.9669,1.8906,2.7705,3.6569
0.6366,1.2821,1.8793,2.4602
0.7718,1.4979,2.2223,2.933
0.5465,1.1008,1.67,2.2195
0.9475,1.9423,2.8942,3.8199
0.8829,1.6842,2.4703,3.2865
0.0675,0.0365,0.0705,0.0162
""")
Path("y_train.csv").write_text("label\n1\n0\n0\n0\n1\n1\n0\n1\n0\n1\n1\n0\n")
Path("x_test.csv").write_text("""f0,f1,f2,f3
0.543,1.0786,1.5684,2.0607
0.9928,1.9037,2.9302,3.8422
0.2269,0.3637,0.4628,0.597
0.9896,1.9511,2.8913,3.8208
""")
Path("x_inference.csv").write_text("""f0,f1,f2,f3
0.2708,0.542,0.8506,1.0897
0.3585,0.6025,0.9517,1.2609
0.8871,1.6559,2.4577,3.2992
""")
95
訓練用とテスト用のファイルをアップロードします。x_inference.csv はステップ4でアップロードします。
for file_name in ("x_train.csv", "y_train.csv", "x_test.csv"):
    catalog.file_upload(file_name, rimay)
2. 関数を実行する
関数のサイズの計算ツールを使用して、アップロードしたデータから実行のサイズを計算します。
import pandas as pd

x_train = pd.read_csv("x_train.csv")
y_train = pd.read_csv("y_train.csv")
x_test = pd.read_csv("x_test.csv")

size = calculate_function_size(
    [x_train, y_train, x_test], mode="fit-transform"
)
print(size)
S
データの特徴量数以上の量子ビットを持つプロセッサーを選択し、そのサイズで fit-transform モードの関数を実行します。サンプルデータには4つの特徴量があるため、どの IBM Quantum プロセッサーでも実行できます。
backend = catalog.least_busy(operational=True, simulator=False)

job = rimay.run(
    mode="fit-transform",
    input_file=["x_train.csv", "y_train.csv", "x_test.csv"],
    backend_name=backend.name,
    shots=5000,
    function_size=size,
)
print(job.job_id)
85dabc9f-a769-4f4a-8e92-f3be73f85ca2
次のようにして、ワークロードのステータスを確認するか、結果を返します。
# Monitor the job status
job.status()
'DONE'
result = job.result()

# Keep both: the mapping_id is the only handle on the mapping this run
# fitted, and the mapping runs only on the processor it was fitted on.
mapping_id = result["mapping_id"]
fit_backend_name = result["backend_name"]
3. 結果を取得する
量子変換された特徴量をダウンロードします。各ファイルがそれぞれの名前で保存されるように、target_name を渡します。
for file_name in result["output_files"]:
    catalog.file_download(file_name, rimay, target_name=file_name)
693iB [00:00, 171kiB/s]
254iB [00:00, 111kiB/s]
4. 新しいデータをマッピングする
モデルの訓練後は、フィットしたマッピングで新しいデータをマッピングします。たとえば推論を実行する場合です。この例では、この例の最初のセルが書き出した x_inference.csv をマッピングします。フィットが返した mapping_id を渡すことで、新しい行が新規のマッピングではなく同じマッピングでマッピングされます。
マッピングは1つのプロセッサーの量子ビットレイアウト向けに構築されるため、フィットと同じ backend_name を渡してください。これはフィットが result["backend_name"] で返したものです。least_busy() は別のプロセッサーを返す可能性があるため、プロセッサーの選択には使用しないでください。Rimay は、何かを送信する前に、他のプロセッサーを拒否します。ショット数もフィットから引き継がれます。
catalog.file_upload("x_inference.csv", rimay)

x_inference = pd.read_csv("x_inference.csv")
size = calculate_function_size([x_inference], mode="transform")

job = rimay.run(
    mode="transform",
    input_file=["x_inference.csv"],
    # The processor the mapping was fitted on
    backend_name=fit_backend_name,
    shots=5000,
    mapping_id=mapping_id,
    function_size=size,
)
# Monitor the job status
job.status()
'DONE'
result = job.result()

for file_name in result["output_files"]:
    catalog.file_download(file_name, rimay, target_name=file_name)
202iB [00:00, 73.5kiB/s]
5. マッピングを削除する
フィットしたマッピングが不要になったら、削除してください。delete の実行では量子処理を行わないため、プロセッサー、ショット、関数サイズは不要です。削除は元に戻せません。削除後は、mapping_id は何も指さなくなり、それを使った transform の実行は失敗します。
job = rimay.run(mode="delete", mapping_id=mapping_id)
job.result()
{'output_files': [],
 'mode': 'delete',
 'deleted': True,
 'mapping_id': '30L40joyUPYfnvgwo2d7MXXSzqvHkggR-Kzn81wfIYw',
 'metadata': {'version': '0.6.0', 'resource_usage': {}}}
エラーメッセージを取得する
ワークロードのステータスが ERROR の場合は、次のように job.error_message() を使用してエラーメッセージを取得します。
job = rimay.run(
    mode="fit-transform",
    input_file=["x_train.csv", "y_train.csv"],
    backend_name=backend.name,
    shots=0,
)
job.error_message()
Rimay が報告するすべてのエラーには、IBM Quantum エラーコードのコード、メッセージ、そして渡した値と許可されている値を示す解決策が含まれています。次の表に、最も一般的なエラーを示します。
| コード | 原因 |
|---|---|
1221 | パラメータが不足している、または型が正しくない、mode が無効である、input_file で指定したファイルがアップロードされていない、ファイル同士が一致しない、特徴量が数値でない、または mapping_id が保存されているマッピングと一致しない。 |
1221 | "transform" の実行が、そのマッピングを生成したフィットとは異なる backend_name を指定している。 |
1216 | インスタンスに、指定した backend_name のプロセッサーがない。解決策には、インスタンスが持つプロセッサーが一覧表示されます。 |
1200 | API キーに、ジョブが実行されるインスタンスへのアクセス権がない。 |
3200 | backend_name が ibm_ で始まっていない。 |
4500 | データの特徴量数が、プロセッサーの量子ビット数より多い。 |
6000 | サンプル数に shots を掛けた値が1,000万回の実行を超えている。 |
6001 | shots が1より小さい。 |
6002 | データのサンプル数が、1回の実行で許可される数より多い。 |
ユースケース
Kipu Quantum は、小~中規模のデータセットにおける表形式データの分類で、量子特徴抽出を次の用途に適用してきました。
表形式データ以外では、凍結されたニューラルネットワークで画像を数値特徴量に変換し、量子特徴抽出によってそれを量子変換された特徴量にマッピングすることができます。
サポートを受ける
サポートが必要な場合は、support@kipu-quantum.com までお問い合わせください。
次のステップ
-
この Qiskit Function のAPIリファレンスをご覧ください。
-
Kipu Quantum の Rimay 量子特徴抽出で信用リスクを分類するチュートリアルを試してください。
参考文献
[1] Simen, A., et al. (2025). Digitized Counterdiabatic Quantum Feature Extraction. arXiv preprint arXiv:2510.13807.
[2] Hofmann, H. (1994). Statlog (German Credit Data). OpenML dataset 31.
[3] Zhang, Q., et al. (2026). Quantum-enhanced satellite image classification. arXiv preprint arXiv:2602.18350.
追加情報
Rimay はケチュア語の言葉で、「説明する」という意味です。