Constrained Quantum Optimizer - Aqariosによる Qiskit Function
APIリファレンスを参照してください
Qiskit Functionsは実験的な機能であり、IBM Quantum® Premium Plan、Flex Plan、および On-Prem (IBM Quantum Platform API経由) Plan のユーザーのみが利用できます。これらはプレビューリリースの状態であり、変更される可能性があります。
概要
Aqariosによる Constrained Quantum Optimizer を使用すると、手動での再定式化や回路マッピングを行うことなく、IBM® 量子ハードウェア上で制約付きバイナリ最適化問題を解くことができます。問題をLPファイル、MPSファイル、またはLuna Modelとして与えるだけです。この関数は、再定式化、回路合成、トランスパイル、およびハードウェア実行を自動的に処理します。ソルバーは、Quantum Approximate Optimization Algorithm (QAOA) の制約ネイティブな拡張である FlexQAOA アルゴリズムの反復的なウォームスタート [1] を利用します。
このオプティマイザーは、制約付きのバイナリ問題を対象としています。特に、one-hot制約とset-packing制約は、XY-mixerを使用してネイティブに強制できます。その他の制約タイプは、ペナルティ項として自動的に再定式化されます。
この関数は離散問題のみを解きます。すべての決定変数は、量子ビットにエンコードできるように、バイナリ、または明示的な下限と上限を持つ整数でなければなりません。連続(実数値)変数はサポートされておらず、連続変数を含むモデルはエラーコード4710で拒否されます。
説明
パフォーマンスは、問題インスタンスとその後の処理ステップの両方に依存する場合があります。場合によっては、古典的なサンプルと量子生成されたサンプルが、同等の後処理を経た後に同様の最終的な解の質を達成することがあります。したがって、評価は最適化ワークフロー全体を考慮する必要があります。
Constrained Quantum Optimizerは、Iterative warm-start XY-mixer QAOA(IWS-QAOA) [1] を実装しています。このアルゴリズムは、固定角度のQAOA回路を量子ハードウェア上で実行し、前回の反復の測定結果を使用して各回路の初期ウォームスタート確率を更新します。変分パラメータのトレーニングは不要であり、代わりに固定の線形ランプパラメータ化が選択されます。
XY-mixerを使用してone-hot制約を強制することで、探索空間が実質的により小さな実行可能な部分空間に縮小されるため、制約付き問題の解の質を劇的に向上させることができます。また、ペナルティ項による追加の複雑さが最適化のランドスケープに導入されることもありません。
ワークフロー
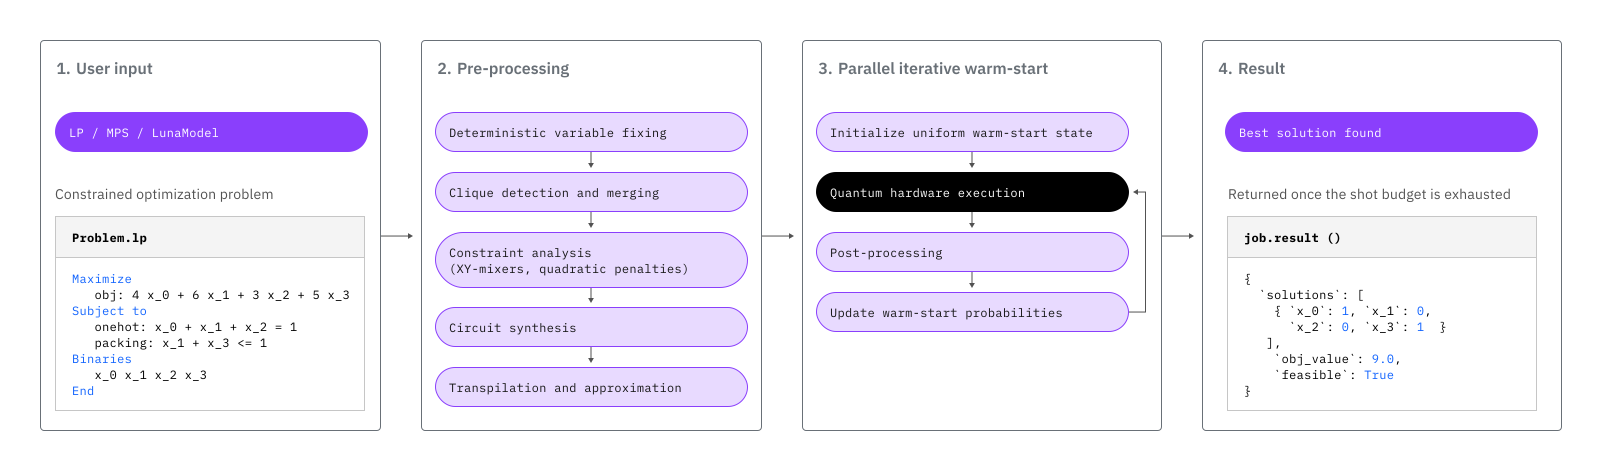
この関数のワークフローを以下に説明します。
-
前処理: 回路合成の前に、オプティマイザーは入力問題の制約構造を解析します。
-
グラフの前処理: 問題に該当する場合、それはグラフとして解析され、エッジが変数間の関係を決定します。このグラフ解析により、前処理で問題を2通りに改善できます。第一に、クリークマージによって個々の制約を1つの大きな制約にまとめ、単一のXY-mixerで表現できるようになります。第二に、隣接ノードが1つしかない変数を確定的に固定でき、問題のサイズと複雑さを削減できます。
-
制約の解決: 前処理器は各制約を個別に処理します。制約がone-hot制約である場合、XY-mixerを通じて強制できます。set-packing制約である場合は、まずone-hot制約に変換されます。等式制約は二次ペナルティによって処理され、不等式制約はunbalanced penalizationによって処理されます。
-
ペナルティの導出: one-hot等式制約として表現できない制約は、ペナルティ項に変換されます。オプティマイザーは、問題の構造からペナルティの強度を自動的に導出します。
-
-
反復的なウォームスタート: オプティマイザーは、複数の_並列ウォームスタートチェーン_を実行します。各チェーンは、変数の割り当てに関する確率分布を保持しており、これがQAOA回路の開始確率(ウォームスタート状態)として使用されます。各反復において、チェーンは量子回路からサンプリングを行い、古典的な後処理を適用し、サンプルの出現に基づいて分布を更新します。反復を重ねるにつれて、変分最適化ループなしに、高品質な解に探索を集中させます。
チェーンの数 (num_parallel)、チェーンあたりの総ショット数 (total_shots)、およびQAOAの繰り返し数 (reps) は、解の質と実行時間のトレードオフを制御する主要なパラメータです。
ベンチマーク
以下のベンチマークは、Constrained Quantum Optimizer Qiskit Functionが、100を大きく超えるバイナリ変数を持つ制約付き最適化問題に対して、高品質で実行可能な解を見つけることができることを示しています。精度は、求められた目的関数値と既知の最適値との比率です。実行時間は、関数の呼び出しから結果の受け渡しまでのウォールクロック時間です。QPU使用量は、課金対象となるQuantum Compute時間です。
2つの問題を検討しました。Maximum Independent Set (MIS) 問題と、よく知られたMaxCut問題を3つ以上のカテゴリに拡張したMax--Cutです。Max--Cutはまた、グラフ彩色判定問題に相当する最適化問題でもあります(すべてのエッジがカットされる場合、そのグラフは-彩色可能です)。
| 問題 | 変数 | 制約 | 量子ビット | 精度 | 実行可能性 | 総実行時間 (秒) | QPU使用量 (秒) | 総ショット数 |
|---|---|---|---|---|---|---|---|---|
| MIS es60fst02 | 186 | 280 | 124 | 100.0% | True | 940.2 | 147.0 | 25.0k |
| MIS sloane_2dc_128 | 128 | 5173 | 74 | 100.0% | True | 347.6 | 106.0 | 12.5k |
| Max-3-Cut Karate Club | 99 | 33 | 99 | 98.7% | True | 279.5 | 166.0 | 25.0k |
| Max-4-Cut Karate Club | 132 | 33 | 132 | 100.0% | True | 258.3 | 200.0 | 25.0k |
ベンチマークに関する注記
-
上記の結果は、デフォルトのオプションで
use_sessionを有効にしたibm_marrakeshHeron r2プロセッサ上で得られました。sloane_2dc_128インスタンスについては、total_shots=12500が使用されました。 -
MISインスタンスにおける量子ビット数の削減(128および186変数に対して74および124)は、前処理における変数の固定を反映しています。
-
MISの問題インスタンスは、Quantum Optimization Benchmarking Libraryから取得されています。- Max--Cut問題のインスタンスは、彩色数が5であるZachary Karate Clubグラフです。
はじめに
このガイドでは、関数の読み込み方法と簡単な問題の実行方法を示すことで、Constrained Quantum Optimizerの基本的な使用方法を説明します。より詳しいチュートリアルについては、Find the Maximum Independent Set with the Aqarios Constrained Quantum Optimizerを参照してください。
IBM Quantum APIキーとインスタンスCRNを使用して認証し、カタログから関数を読み込みます。
以下のコードは、認証情報を保存済みであることを前提としています。設定するには、Save your IBM Cloud account credentialsの手順に従ってください。
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"luna_model": "luna-model", "networkx": "networkx", "qiskit_addon_opt_mapper": "qiskit-addon-opt-mapper", "qiskit_ibm_catalog": "qiskit-ibm-catalog"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit_ibm_catalog import QiskitFunctionsCatalog

catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")

# Verify that you have access to the function
catalog.list()
[QiskitFunction(aqarios/constrained-quantum-optimizer)]
# Load the function
optimizer = catalog.load("aqarios/constrained-quantum-optimizer")
# Check the list of backends you have access to
catalog.backends()
[<IBMBackend('ibm_pittsburgh')>,
 <IBMBackend('ibm_boston')>,
 <IBMBackend('ibm_phoenix')>,
 <IBMBackend('ibm_fez')>,
 <IBMBackend('ibm_miami')>,
 <IBMBackend('ibm_marrakesh')>,
 <IBMBackend('ibm_kingston')>]
# Select the backend you want to use
backend = catalog.backend("ibm_phoenix")
例1: 簡単な制約付き問題
最初の例では、オペレーションズリサーチでよく使われる最適化問題の記述形式であるLPファイルを使用してこの関数を使う方法を示します。2つの制約に従う、5つのバイナリ変数からなる次の任意の最適化問題を定式化します。
1. 問題の定式化
数学的表現を、以下のLP文字列形式として直接記述します。
lp_str = """\\Problem name: Example
Minimize
  obj: [ 2 x_1 x_2 + 4 x_2 x_3 - 2 x_3 x_4 - 4 x_4 x_5 - 4 x_1 x_3 - 8 x_2 x_5 ] / 2
Subject To
  c1: x_1 + x_2 + x_3 <= 1
  c2: x_3 - x_4 + x_5 = 0
Binaries
  x_1 x_2 x_3 x_4 x_5
End
"""
[ ... ] / 2は、LP標準における二次目的関数のために必要な表記であることに注意してください。
2. オプティマイザーの実行
オプティマイザーを使用して問題を解きます。
# Set up low-resource options for the simple problem
options = {"total_shots": 2000, "num_parallel": 5, "use_session": True}

# Dispatch the job
job_1 = optimizer.run(
    problem=lp_str, backend_name=backend.name, options=options
)

print(f"Job ID: {job_1.job_id}")
Job ID: 2e06a3a8-7c29-4c76-94d7-194293363f4a
# Monitor the job status
job_1.status()
'RUNNING: WAITING_FOR_QPU'
3. 結果の取得
変数名を関連する割り当てにマッピングした解が、結果として提供されます。
result = job_1.result()

result
{'solutions': [{'x_1': 0, 'x_2': 1, 'x_3': 0, 'x_4': 1, 'x_5': 1}],
 'solution_bitstrings': ['01011'],
 'raw_energy': -6.0,
 'objective_value': -6.0,
 'feasible': True,
 'metadata': {'resource_usage': {'RUNNING: MAPPING': {'CPU': 5.405},
   'RUNNING: OPTIMIZING_FOR_HARDWARE': {'CPU': 9.902},
   'RUNNING: WAITING_FOR_QPU': {'CPU': 25.456},
   'RUNNING: EXECUTING_QPU': {'CPU': 25.202},
   'RUNNING: POST_PROCESSING': {'CPU': 6.481}},
  'circuit_metrics': {'before_transpilation': {'num_qubits': 6,
    'gate_count': 42,
    'depth': 15,
    'two_qubit_gate_count': 12,
    'two_qubit_gate_depth': 7,
    'operations': {'rz': 12,
     'p': 8,
     'ry': 7,
     'rzz': 4,
     'cx': 3,
     'xx_plus_yy': 3,
     'global_phase': 2,
     'cry': 2,
     'x': 1}},
   'after_transpilation': {'num_qubits': 6,
    'gate_count': 254,
    'depth': 100,
    'two_qubit_gate_count': 48,
    'two_qubit_gate_depth': 33,
    'operations': {'rz': 78, 'sx': 122, 'cz': 48, 'measure': 6, 'x': 0}}},
  'solver_info': {'variable_mapping': {'x_1': 0,
    'x_2': 1,
    'x_3': 2,
    'x_4': 3,
    'x_5': 4}}}}
返される辞書のsolutionsフィールドには、見つかったすべての縮退した最良解が、各変数名をその割り当てに対応付ける辞書として含まれます。同じ解はsolution_bitstringsにビット列としても返されます。metadata.solver_info.variable_mappingは、ビット列のどの文字位置がどの変数に対応するかを示します。解のデータに加えて、objective_value、feasibleフラグ、および追加のmetadataが提供されます。
例2: Maximum Independent Set
Maximum Independent Set (MIS) 問題は、部分集合内のどの2つの頂点もエッジで結ばれていないような、グラフ内の頂点の最大の部分集合を求める問題です。この例では、12ノードの正則グラフでMISを解きます。この問題の詳細と、より大規模な例については、チュートリアルを参照してください。
この問題はqiskit-addon-opt-mapperを使用して構築されます。 必要に応じて、必要なパッケージをインストールしてください。
# %pip install networkx qiskit-addon-opt-mapper
ステップ1: 問題の定義
ランダムな3-正則グラフを構築し、MIS最適化問題を作成します。各グラフノードはバイナリ変数となり、各エッジは、両端点のうち高々1つしか選択されないことを保証する制約を導入します。
import networkx as nx
from qiskit_addon_opt_mapper.applications import IndependentSet
from qiskit_addon_opt_mapper.translators import to_docplex_mp

# 12-node random 3-regular graph
G = nx.random_regular_graph(3, 12, seed=7)

# Build MIS problem and export as LP string
mis = IndependentSet(G)
mis_problem = mis.to_optimization_problem()
lp_str = to_docplex_mp(mis_problem).export_as_lp_string()

print(lp_str)
\ This file has been generated by DOcplex
\ ENCODING=ISO-8859-1
\Problem name: Independent set

Maximize
 obj: x_0 + x_1 + x_2 + x_3 + x_4 + x_5 + x_6 + x_7 + x_8 + x_9 + x_10 + x_11
Subject To
 c0: x_0 + x_4 <= 1
 c1: x_0 + x_9 <= 1
 c2: x_0 + x_8 <= 1
 c3: x_1 + x_2 <= 1
 c4: x_1 + x_7 <= 1
 c5: x_1 + x_3 <= 1
 c6: x_2 + x_4 <= 1
 c7: x_2 + x_11 <= 1
 c8: x_3 + x_10 <= 1
 c9: x_3 + x_11 <= 1
 c10: x_4 + x_5 <= 1
 c11: x_5 + x_10 <= 1
 c12: x_5 + x_6 <= 1
 c13: x_6 + x_8 <= 1
 c14: x_6 + x_7 <= 1
 c15: x_7 + x_9 <= 1
 c16: x_8 + x_11 <= 1
 c17: x_9 + x_10 <= 1

Bounds
 0 <= x_0 <= 1
 0 <= x_1 <= 1
 0 <= x_2 <= 1
 0 <= x_3 <= 1
 0 <= x_4 <= 1
 0 <= x_5 <= 1
 0 <= x_6 <= 1
 0 <= x_7 <= 1
 0 <= x_8 <= 1
 0 <= x_9 <= 1
 0 <= x_10 <= 1
 0 <= x_11 <= 1

Binaries
 x_0 x_1 x_2 x_3 x_4 x_5 x_6 x_7 x_8 x_9 x_10 x_11
End
ステップ2: オプティマイザーの実行
オプティマイザーを使用して問題を解きます。
options = {"total_shots": 2000, "use_session": True}

# Dispatch the job
job_2 = optimizer.run(
    problem=lp_str, backend_name=backend.name, options=options
)

print(f"Job ID: {job_2.job_id}")
Job ID: f041431c-b42e-4627-afe5-522fea61faf6
# Monitor the job status
job_2.status()
'QUEUED'
ステップ3: 結果の取得と解釈
最後に、解を取得し、正しさを検証します。
result = job_2.result()

print(f"Feasible: {result['feasible']}")
print(f"Independent set size: {int(result['objective_value'])}")

# Extract the selected nodes
solution = result["solutions"][0]
independent_set = [
    int(k.split("_")[1]) for k, v in solution.items() if v == 1
]
print(f"Selected nodes: {sorted(independent_set)}")

# Verify no two selected nodes share an edge
conflicts = [
    (u, v)
    for u, v in G.edges()
    if u in independent_set and v in independent_set
]
print(f"Edge conflicts: {conflicts}")
Feasible: True
Independent set size: 5
Selected nodes: [1, 4, 6, 9, 11]
Edge conflicts: []
例3: グラフの3彩色 (Max-3-Cut)
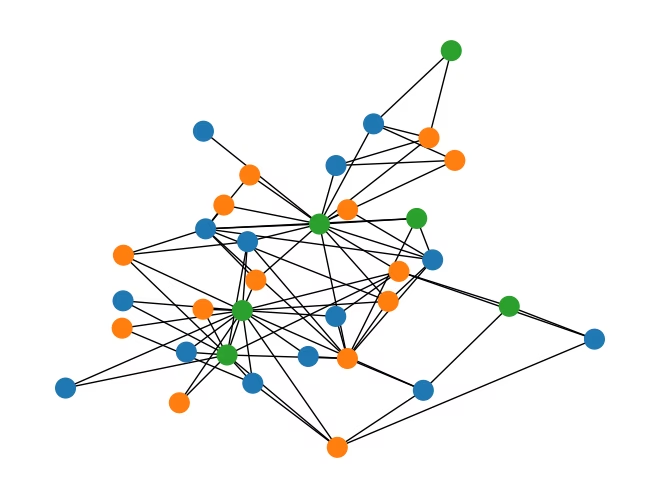
Max--Cut問題は、グラフの頂点を個のグループに分割し、両端点が異なるグループに属するエッジの数を最大化します。の場合、これは異なる色をまたぐエッジを最大化する3彩色を見つけることと等価です。
形式的には、各ノードを、色に対するバイナリ変数を用いて、個のグループのいずれかに割り当てます。各ノードに対するone-hot制約は、一意な割り当てを強制します。目的関数は、グループをまたぐエッジを最大化します。
one-hot制約は、オプティマイザーがネイティブに扱えるXY-mixerで処理するのに最適です。
この例では、Zachary Karate Clubグラフ (34ノード、78エッジ) を使用し、Luna Modelでモデルを構築します。 必要に応じて、必要なパッケージをインストールしてください。
# %pip install networkx matplotlib luna-model
ステップ1: 問題の定義
まず、luna-modelパッケージを使用してバイナリ変数を生成します。次に、目的関数を定義し、制約をモデルに追加します。
import networkx as nx
from luna_model import Model, quicksum

k = 3
G = nx.karate_club_graph()

# Instantiate the Model object
model = Model(name="Max-3-Cut")

# Add binary variables
x = model.add_variables("x", shape=(G.number_of_nodes(), k))

# Add the objective by using the numpy dot abstraction
model.objective = quicksum(x[i].dot(x[j]) for i, j in G.edges)

# Bulk-add the one-hot constraints
model.add_constraints(x.sum(axis=1) == 1)

# Encode the model to send via API
model_enc = model.encode_b64()
ステップ2: オプティマイザーの実行
オプティマイザーを使用して問題を解きます。
options = {"use_session": True}

# Dispatch the job
job_3 = optimizer.run(
    problem=model_enc, backend_name=backend.name, options=options
)

print(f"Job ID: {job_3.job_id}")
Job ID: df911d83-9df7-44a1-bfad-5d66e08676c3
# Monitor the job status
job_3.status()
'RUNNING: WAITING_FOR_QPU'
ステップ3: 結果の取得と可視化
結果を取得し、可視化します。
result = job_3.result()
solution = result["solutions"][0]

# Map each node to its assigned color group
node_group = {}
for i in G.nodes:
    for c in range(k):
        if solution[f"x{i},{c}"] == 1:
            node_group[i] = c

print(f"Feasible: {result['feasible']}")
print(f"Violations: {int(result['objective_value'])}")

# Visualize the partition
colors = ["tab:blue", "tab:orange", "tab:green"]
node_colors = [colors[node_group[i]] for i in G.nodes()]
nx.draw(G, nx.kamada_kawai_layout(G), node_color=node_colors, node_size=200)
Feasible: True
Violations: 4
変更履歴
[0.4.0] - 2026-09-22
破壊的変更
- 入力パラメータ
modelの名前をproblemに変更しました。 - 出力フィールド
obj_valueの名前をobjective_valueに変更しました。 postprocessingオプションをpostprocessing_levelに置き換えました。これは文字列ではなく、範囲[0, 3]の整数を受け取ります。以前の値は"off"->0、"weak"->1、"medium"->2、"strong"->3に対応し、デフォルトは3のまま変わりません。metadata.circuit_metricsの構造を変更しました。平均化されたゲート数の単一のフラットな辞書ではなく、before_transpilationとafter_transpilationのそれぞれについて、num_qubits、gate_count、depth、two_qubit_gate_count、two_qubit_gate_depth、operationsを個別に報告するようになりました。前処理中に問題が解かれ、回路が実行されなかった場合、このフィールドはNoneになります(エラーコード4712)。
機能
- 実行間で回路の合成とルーティングを再現可能にする
seed_transpilerオプションを追加しました。 - 関数が送信するすべてのQiskit Runtimeジョブに独自のタグを付加する
job_tagsオプションを追加しました。 solutionsと同じ解をビット列形式で返す出力フィールドsolution_bitstringsを追加しました。- 各変数名を
solution_bitstringsのエントリ内の文字位置に対応付けるmetadata.solver_info.variable_mappingを追加しました。
ドキュメント
- 連続(実数値)変数はサポートされておらず、整数変数には明示的な境界が必要であることを文書化しました。このようなモデルはエラーコード
4710で失敗します。
サポートを受ける
質問や問題がある場合は、ジョブIDを添えてsupport@aqarios.comに連絡してください。
次のステップ
- Aqariosによる Constrained Quantum Optimizer へのアクセスをリクエストする。
- パラメータと出力の完全なドキュメントについては、APIリファレンスを参照してください。
- 実際のQOBLIBベンチマークインスタンスを深く掘り下げるには、Find the Maximum Independent Set with the Aqarios Constrained Quantum Optimizerチュートリアルを試してください。
- 論文Constrained Quantum Optimization via Iterative Warm-Start XY-Mixersを確認してください。
参考文献
- Bucher et al. (2026), Constrained Quantum Optimization via Iterative Warm-Start XY-Mixers 10.1088/1367-2630/ae8ea2