Optimization Solver: Q-CTRL Fire OpalによるQiskit Function
APIリファレンスを参照してください
Qiskit Functionsは、IBM Quantum® Premium Plan、Flex Plan、およびOn-Prem(IBM Quantum Platform API経由)Planのユーザーのみが利用できる実験的な機能です。プレビューリリースの状態にあり、変更される可能性があります。
パッケージのバージョン
このページのコードは以下の要件を使用して開発されました。 これらのバージョン以降の使用を推奨します。
qiskit-ibm-runtime~=0.47.0
sympy~=1.14.0
概要
Fire Opal Optimization Solverを使用すると、量子の専門知識を必要とせずに、量子ハードウェア上でユーティリティスケールの最適化問題を解くことができます。高レベルの問題定義を入力するだけで、Solverが残りの処理を行います。ワークフロー全体はノイズを考慮した設計になっており、内部的にFire OpalのPerformance Managementを活用しています。Solverは、最大規模のIBM® QPU上でもフルデバイススケールで、古典的に困難な問題に対して一貫して正確な解を提供します。
Solverは柔軟性があり、目的関数または任意のグラフとして定義された組み合わせ最適化問題を解くために使用できます。問題をデバイストポロジーにマッピングする必要はありません。制約ありと制約なしの両方の問題を解くことができます。制約はペナルティ項ではなく、硬いHamming-weight-1制約として強制されます。このガイドに含まれる例では、異なるSolver入力タイプを使用して、制約なしおよび制約付きのユーティリティスケール最適化問題を解く方法を示しています。最初の例は156ノード、3-Regularグラフで定義されたMax-Cut問題に関するものであり、2番目の例はコスト関数で定義された50ノードのグラフ分割問題に取り組んでいます。
Optimization Solverへのアクセスを取得するには、Q-CTRLにお問い合わせください。
機能の説明
Solverは、ハードウェアレベルでのエラー抑制から効率的な問題マッピングおよびクローズドループの古典的最適化まで、アルゴリズム全体を完全に最適化および自動化します。Solverのパイプラインは裏側で各ステージのエラーを削減し、意味のあるスケールアップに必要な強化されたパフォーマンスを実現しています。基礎となるワークフローはQuantum Approximate Optimization Algorithm(QAOA)から着想を得ており、ハイブリッド量子古典アルゴリズムです。Optimization Solverワークフロー全体の詳細な概要については、公開されている論文を参照してください。
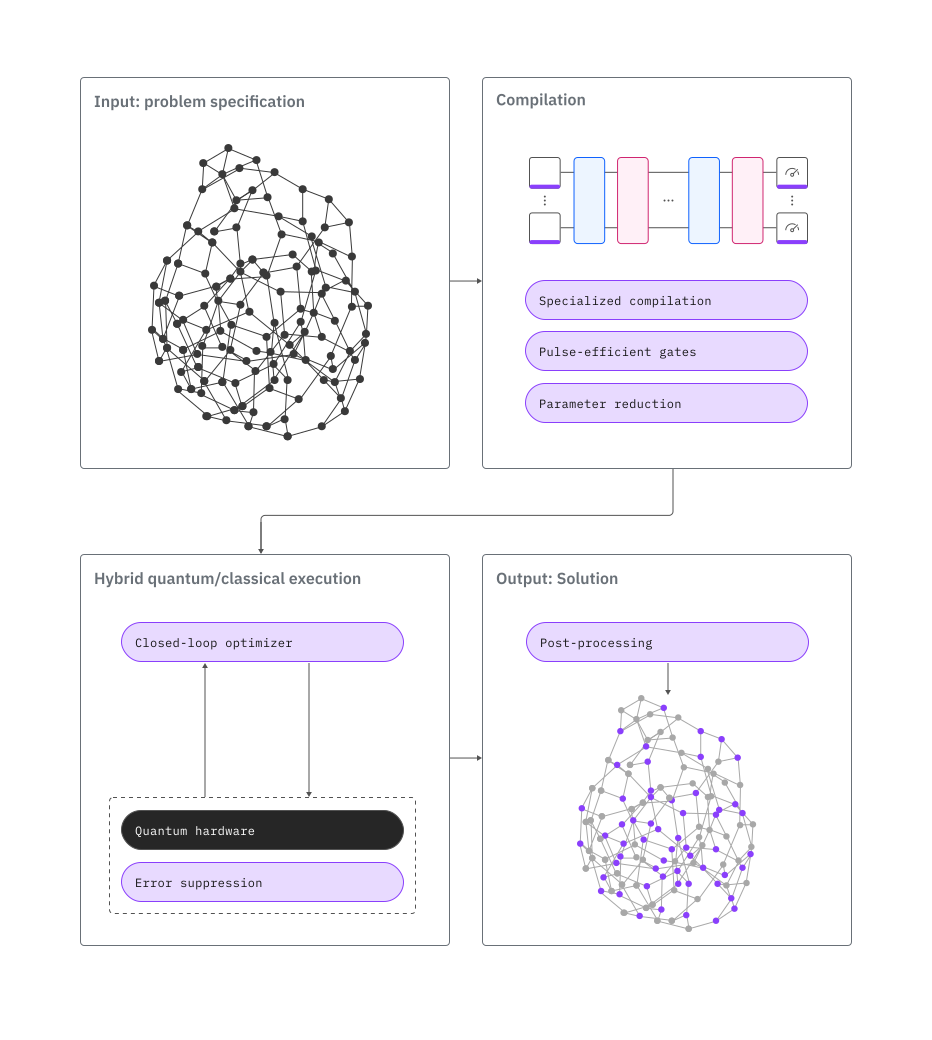
Optimization Solverで一般的な問題を解くには:
- 問題を目的関数、グラフ、または
SparsePauliOpスピンチェーンとして定義します。 - Qiskit Functions Catalogを通じて機能に接続します。
- Solverで問題を実行し、結果を取得します。
受け付ける問題形式
-
目的関数の多項式表現。理想的にはPythonで既存のSymPy Polyオブジェクトを使用して作成し、sympy.sreprを使用して文字列にフォーマットします。
-
特定の問題タイプのグラフ表現。グラフは Python の networkx ライブラリを使用して作成する必要があります。その後、networkx 関数
nx.readwrite.json_graph.adjacency_dataを使用して文字列に変換します。 -
特定の問題のスピンチェーン表現。スピンチェーンは
SparsePauliOpオブジェクトとして表現する必要があります。詳細についてはドキュメントを参照してください。
この機能が現在サポートしていないバックエンドを使用したい場合は、Q-CTRLにお問い合わせしてサポートを追加してください。
ベンチマーク
パフォーマンスは、問題インスタンスとその後の処理ステップの両方に依存する可能性があります。場合によっては、同等の後処理を行った後、古典的なサンプルと量子生成サンプルが同様の最終解の品質を達成することもあります。したがって、評価には最適化ワークフロー全体を考慮する必要があります。
公開されているベンチマーク結果は、Solverが120量子ビットを超える問題を正常に解き、量子アニーリングやトラップイオンデバイスで以前に公開された結果をも上回ることを示しています。以下のベンチマーク指標は、いくつかの例に基づいた問題タイプの精度とスケーリングの大まかな目安を提供します。実際の指標は、目的関数の項数(密度)とその局所性、変数の数、多項式の次数などのさまざまな問題の特性によって異なる場合があります。
「量子ビット数」は厳密な制限ではなく、非常に一貫した解の精度が期待できる大まかな閾値を表しています。これらの制限を超えた大きな問題サイズも正常に解かれており、これらの制限を超えてテストすることをお勧めします。
任意の量子ビット接続性はすべての問題タイプでサポートされています。
| 問題タイプ | 量子ビット数 | 例 | 精度 | 合計時間 (s) | Runtime使用量 (s) | イテレーション数 |
|---|---|---|---|---|---|---|
| 疎に連結された二次問題 | 156 | 3-regular Max-Cut | 100% | 1764 | 293 | 16 |
| 高次バイナリ最適化 | 156 | Ising spin-glass model | 100% | 1461 | 272 | 16 |
| 密に連結された二次問題 | 50 | 完全連結Max-Cut | 100% | 1758 | 268 | 12 |
| 硬い制約を持つ制約付き問題 | 50 | エッジ密度8%の重み付きグラフ分割 | 100% | 1074 | 215 | 10 |
はじめに
まず、IBM Quantum APIキーを使用して認証します。次に、以下のようにQiskit Functionを選択します。(このスニペットは、すでにアカウントをローカル環境に保存していることを前提としています。)
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"networkx": "networkx", "numpy": "numpy", "qiskit_ibm_catalog": "qiskit-ibm-catalog", "qiskit_ibm_runtime": "qiskit-ibm-runtime", "sympy": "sympy"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit_ibm_catalog import QiskitFunctionsCatalog

catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")

# Verify that you have access to the function
catalog.list()
[QiskitFunction(qunova/hivqe-chemistry),
 QiskitFunction(global-data-quantum/quantum-portfolio-optimizer),
 QiskitFunction(algorithmiq/tem),
 QiskitFunction(qedma/qesem),
 QiskitFunction(multiverse/singularity),
 QiskitFunction(ibm/circuit-function),
 QiskitFunction(q-ctrl/optimization-solver),
 QiskitFunction(colibritd/quick-pde),
 QiskitFunction(q-ctrl/performance-management),
 QiskitFunction(kipu-quantum/iskay-quantum-optimizer)]
# Access Function
solver = catalog.load("q-ctrl/optimization-solver")
例:制約なし最適化
最大カット(Max-Cut)問題を実行します。以下の例は156ノード、3-regularの非重み付きグラフMax-Cut問題におけるSolverの能力を示していますが、重み付きグラフ問題も解くことができます。
qiskit-ibm-catalogに加え、この例を実行するにはnetworkxとnumpyパッケージも使用します。IPythonカーネルを使用してノートブックでこの例を実行する場合は、次のセルのコメントを解除してこれらのパッケージをインストールできます。
# %pip install networkx numpy
1. 問題を定義する
グラフ問題を定義し、problem_type='maxcut'を指定することでMax-Cut問題を実行できます。
import networkx as nx
import numpy as np

# Generate a random graph with 156 nodes
maxcut_graph = nx.random_regular_graph(d=3, n=156, seed=8)
# Optionally, visualize the graph
nx.draw_networkx(
    maxcut_graph, nx.kamada_kawai_layout(maxcut_graph), node_size=100
)
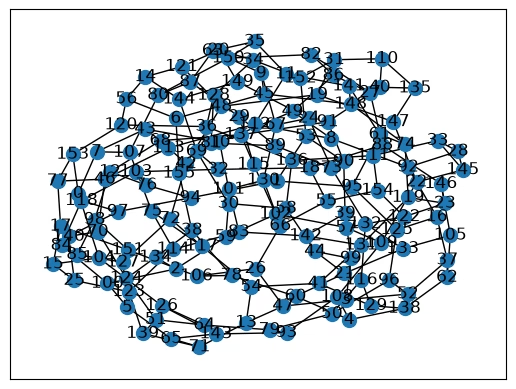
Solverは問題定義の入力として文字列を受け付けます。
# Convert graph to string
problem_as_str = nx.readwrite.json_graph.adjacency_data(maxcut_graph)
2. 問題を実行する
グラフベースの入力方法を使用する場合は、問題タイプを指定してください。
# This cell is hidden from users
from qiskit_ibm_runtime import QiskitRuntimeService

service = QiskitRuntimeService()
backend_name = service.least_busy(n_qubits=156).name
# Solve the problem
maxcut_job = solver.run(
    problem=problem_as_str,
    problem_type="maxcut",
    backend_name=backend_name,  # E.g. "ibm_fez"
)
Qiskit Functionワークロードのステータスを確認するか、以下のように結果を返します:
# Print the ID so you can use it later, if necessary
print(maxcut_job.job_id)

# Get job status
print(maxcut_job.status())
34b53970-d95a-4e24-8763-fc6f3d112843
QUEUED
3. 結果を取得する
結果辞書から最適なカット値を取得します。
variables_to_bitstring_index_mapサブ辞書が含まれており、順序を確認するのに役立ちます。# Poll for results
maxcut_result = maxcut_job.result()
# Take the absolute value of the solution since the cost function is minimized
qctrl_maxcut = abs(maxcut_result["solution_bitstring_cost"])
# Print the optimal cut value found by the Optimization Solver
print(f"Optimal cut value: {qctrl_maxcut}")
Optimal cut value: 210.0
グラフが密に連結されていない場合、PuLPなどのオープンソースソルバーを使用して問題を古典的に解くことで結果の精度を検証できます。高密度の問題では、解を検証するために高度な古典的ソルバーが必要になる場合があります。
例:制約付き最適化
前述の最大カット問題の例は、一般的な二次制約なしバイナリ最適化問題です。Q-CTRL の Optimization Solver は、ハード制約を目的関数のペナルティ項としてエンコードする代わりに、constraint 入力を通じて Solver に直接渡すことで、制約付き最適化問題も解くことができます。Solver は現在、ハミング重み1の制約をサポートしています。各制約は、正確に1つの変数が1に等しく、残りが0に等しくなければならない変数のグループを指定します。
以下の例では、制約付き最適化問題であるグラフ分割のコスト関数とハード制約のセットを構築する方法を示します。この問題は、グラフ内のすべてのノードをいくつかのグループのいずれか1つに割り当て、両端点が同じグループに属するエッジの総重みを最小化するというものです。
qiskit-ibm-catalog および qiskit パッケージに加えて、この例を実行するには numpy、networkx、および sympy パッケージも使用します。IPython カーネルを使用してノートブックでこの例を実行する場合は、次のセルのコメントを解除してこれらのパッケージをインストールできます。
# %pip install numpy networkx sympy
1. 問題を定義する
ランダムに重み付けされたノードを持つグラフを生成して、ランダムなグラフ分割問題を定義します。
import networkx as nx
from sympy import Symbol, Poly, srepr

# To change the weights, change the seed to any integer.
rng_seed = 18
_rng = np.random.default_rng(rng_seed)
node_count = 50
edge_probability = 0.08
graph = nx.erdos_renyi_graph(
    node_count, edge_probability, seed=rng_seed, directed=False
)

# add node weights
min_weight = -1.0
max_weight = 1.0
for i in graph.nodes:
    weight = (max_weight - min_weight) * _rng.random() + min_weight
    graph.add_node(i, weight=weight)

# Optionally, visualize the graph
nx.draw_networkx(graph, nx.kamada_kawai_layout(graph), node_size=200)
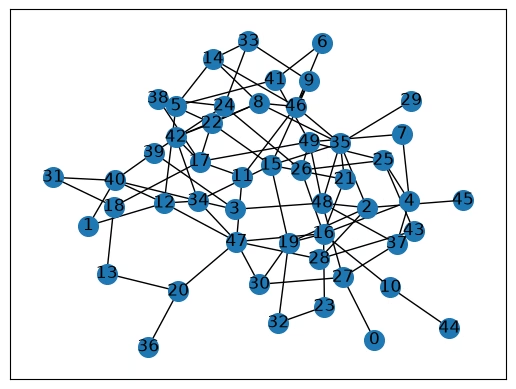
重み付きグラフ分割の標準的な最適化モデルは、次のように定式化できます。グラフのノードを3つのグループ に分割し、ノード がグループ に割り当てられている場合は 、そうでない場合は とします。目標は、両端点が同じグループに割り当てられているエッジの総重みを最小化することです。ここで、エッジ の重みは、その2つの端点の重みの合計、 です。
# Construct the cost function.
group_count = 3
variables = [
    Symbol(f"n[{i},{g}]")
    for i in range(node_count)
    for g in range(group_count)
]
node_group_var = {
    (i, g): variables[i * group_count + g]
    for i in range(node_count)
    for g in range(group_count)
}
cost_function = Poly(0, *variables)

for i, j in graph.edges():
    edge_weight = graph.nodes[i]["weight"] + graph.nodes[j]["weight"]
    for g in range(group_count):
        cost_function += (
            edge_weight * node_group_var[(i, g)] * node_group_var[(j, g)]
        )
すべてのノードは、3つのグループのうち正確に1つに割り当てられなければなりません。これはハミング重み1の制約です。すべてのノード について、 のうち正確に1つが1に等しく、残りは0に等しくなければなりません。
この要件をコスト関数のペナルティ項としてエンコードする代わりに、constraint 入力を使用してハード制約として直接 Solver に渡します。
# Build the hard constraint: exactly one group per node.
constraint_dict = {
    str(tuple(f"n[{i},{g}]" for g in range(group_count))): 1
    for i in range(node_count)
}
print(f"Problem constraints: {constraint_dict}")
Problem constraints: {"('n[0,0]', 'n[0,1]', 'n[0,2]')": 1, "('n[1,0]', 'n[1,1]', 'n[1,2]')": 1, "('n[2,0]', 'n[2,1]', 'n[2,2]')": 1, "('n[3,0]', 'n[3,1]', 'n[3,2]')": 1, "('n[4,0]', 'n[4,1]', 'n[4,2]')": 1, "('n[5,0]', 'n[5,1]', 'n[5,2]')": 1, "('n[6,0]', 'n[6,1]', 'n[6,2]')": 1, "('n[7,0]', 'n[7,1]', 'n[7,2]')": 1, "('n[8,0]', 'n[8,1]', 'n[8,2]')": 1, "('n[9,0]', 'n[9,1]', 'n[9,2]')": 1, "('n[10,0]', 'n[10,1]', 'n[10,2]')": 1, "('n[11,0]', 'n[11,1]', 'n[11,2]')": 1, "('n[12,0]', 'n[12,1]', 'n[12,2]')": 1, "('n[13,0]', 'n[13,1]', 'n[13,2]')": 1, "('n[14,0]', 'n[14,1]', 'n[14,2]')": 1, "('n[15,0]', 'n[15,1]', 'n[15,2]')": 1, "('n[16,0]', 'n[16,1]', 'n[16,2]')": 1, "('n[17,0]', 'n[17,1]', 'n[17,2]')": 1, "('n[18,0]', 'n[18,1]', 'n[18,2]')": 1, "('n[19,0]', 'n[19,1]', 'n[19,2]')": 1, "('n[20,0]', 'n[20,1]', 'n[20,2]')": 1, "('n[21,0]', 'n[21,1]', 'n[21,2]')": 1, "('n[22,0]', 'n[22,1]', 'n[22,2]')": 1, "('n[23,0]', 'n[23,1]', 'n[23,2]')": 1, "('n[24,0]', 'n[24,1]', 'n[24,2]')": 1, "('n[25,0]', 'n[25,1]', 'n[25,2]')": 1, "('n[26,0]', 'n[26,1]', 'n[26,2]')": 1, "('n[27,0]', 'n[27,1]', 'n[27,2]')": 1, "('n[28,0]', 'n[28,1]', 'n[28,2]')": 1, "('n[29,0]', 'n[29,1]', 'n[29,2]')": 1, "('n[30,0]', 'n[30,1]', 'n[30,2]')": 1, "('n[31,0]', 'n[31,1]', 'n[31,2]')": 1, "('n[32,0]', 'n[32,1]', 'n[32,2]')": 1, "('n[33,0]', 'n[33,1]', 'n[33,2]')": 1, "('n[34,0]', 'n[34,1]', 'n[34,2]')": 1, "('n[35,0]', 'n[35,1]', 'n[35,2]')": 1, "('n[36,0]', 'n[36,1]', 'n[36,2]')": 1, "('n[37,0]', 'n[37,1]', 'n[37,2]')": 1, "('n[38,0]', 'n[38,1]', 'n[38,2]')": 1, "('n[39,0]', 'n[39,1]', 'n[39,2]')": 1, "('n[40,0]', 'n[40,1]', 'n[40,2]')": 1, "('n[41,0]', 'n[41,1]', 'n[41,2]')": 1, "('n[42,0]', 'n[42,1]', 'n[42,2]')": 1, "('n[43,0]', 'n[43,1]', 'n[43,2]')": 1, "('n[44,0]', 'n[44,1]', 'n[44,2]')": 1, "('n[45,0]', 'n[45,1]', 'n[45,2]')": 1, "('n[46,0]', 'n[46,1]', 'n[46,2]')": 1, "('n[47,0]', 'n[47,1]', 'n[47,2]')": 1, "('n[48,0]', 'n[48,1]', 'n[48,2]')": 1, "('n[49,0]', 'n[49,1]', 'n[49,2]')": 1}
すべての変数を constraint に追加する必要はありません。ディクショナリーから除外された変数は制約されないままになるため、同じ問題内でハード制約されたグループの変数と自由な変数を混在させることができます。
2. 問題を実行する
# Solve the problem
partition_job = solver.run(
    problem=srepr(cost_function),
    constraint=constraint_dict,
    backend_name="ibm_marrakesh",  # E.g. "ibm_marrakesh"
)
Qiskit Functionワークロードのステータスを確認するか、以下のように結果を返します:
# Print the ID so you can use it later, if necessary
print(partition_job.job_id)

# Get job status
print(partition_job.status())
b8085944-f313-444e-be39-ea61b1b47ebd
QUEUED
3. 結果を取得する
解を取得して結果を分析します。解のコストは、両端点が同じグループに属することになったエッジの総重みを表すため、コストが低いほどグラフの分割がより優れていることを示します。
partition_result = partition_job.result()
qctrl_cost = partition_result["solution_bitstring_cost"]
solution_bitstring = partition_result["solution_bitstring"]

# Print results
print(f"Total weight of same-group edges: {qctrl_cost}")
print(f"Solution bitstring: {solution_bitstring}")
Total weight of same-group edges: -36.5539
Solution bitstring: 100100100100100001100100100100100100100100100100100001010100010100100100100010001001100100100001100001100001010001001010100100100100100010100100100100
サポートを受ける
ご質問や問題がある場合は、Q-CTRLにお問い合わせください。
変更履歴
-
2026年8月10日:
constraint入力を介したハード(ハミング重み1)制約のサポートを追加し、それらを使用するように制約付き最適化の例を更新しました。 -
2026-02-11:
ibm_miamiのサポートを追加しました
次のステップ
-
Q-CTRL Optimization Solverへのアクセスをリクエストします。
-
このQiskit FunctionのAPIリファレンスをご覧ください。
-
Q-CTRLのOptimization Solverで高次バイナリ最適化問題を解くチュートリアルに挑戦します。
-
Mazdaケーススタディを参照してください。
-
Network Railケーススタディを参照してください。
-
Australian Armyケーススタディを参照してください。
-
Transport for New South Walesケーススタディを参照してください。