Parity Twine Optimizer: ParityQCによる Qiskit Function
APIリファレンスをご覧ください
Qiskit Functionsは実験的な機能であり、IBM Quantum® Premium Plan、Flex Plan、および On-Prem (IBM Quantum Platform API経由) Plan のユーザーのみが利用できます。これらはプレビューリリースの状態であり、変更される可能性があります。
概要
Parity Twine Optimizerを使用すると、Parity Twine methodを用いて量子コンピュータで最適化問題を解くことができます。 このアプローチはParity Architectureを基盤としており、ParityQCコンパイラを使用して、デバイスの接続性を考慮しながら、量子アルゴリズムの実行に必要なゲート数と回路深度を最小化します。
このリソース削減により、標準的なSWAPの多いトランスパイル手法では実行不可能なサイズの、産業界に関連する最適化問題を解くことが可能になります。 Parity Twine Optimizerはトランスパイルのステップを自動化しており、最小限のユーザー入力で使用できます。
Parity Twineアプローチは、quantum approximate optimization algorithm (QAOA)やquantum Fourier transform (QFT)などの量子アルゴリズムにおけるゲート数と回路深度の削減という点で、他のすべてのコンパイル手法を上回ります。 量子情報を物理量子ビットから抽象化することで、SWAPゲートを使用せずに非局所的な相互作用を実装します。代わりに、Parity Twineチェーン(CNOTゲートの並び)が、論理的なパリティ情報を量子ビット間に系統的に分配します。
オプティマイザーはQAOAを使用して、与えられたコスト関数のエネルギーを最小化します。QAOAは、コストハミルトニアン()の基底状態を近似することで組合せ最適化問題を解くように設計された、ハイブリッドな量子古典変分アルゴリズムです。混合項()は、解空間を探索するために状態間の遷移を促します。パラメータとによって制御されるこれらの項を交互に並べたものが、初期状態に作用するユニタリ を定義します。
問題のユニタリexp()のエンコードには、すべての論理的な体回転演算子(exp())のエンコードが必要です。 これは、QAOA回路の深度と2量子ビットゲート数を削減する体生成子(Parity Twine Networks)を使用することで実現できます。
説明
Parity Twine Optimizerの入力は、最適化問題、選択したIBM Quantumハードウェア名、およびトランスパイルとハードウェア実行の設定を調整するための追加のオプション引数から構成されます。オプティマイザー 関数は、問題定義をParity Twine Compilerにルーティングします。図1にこの関数のワークフローの概要を示します。
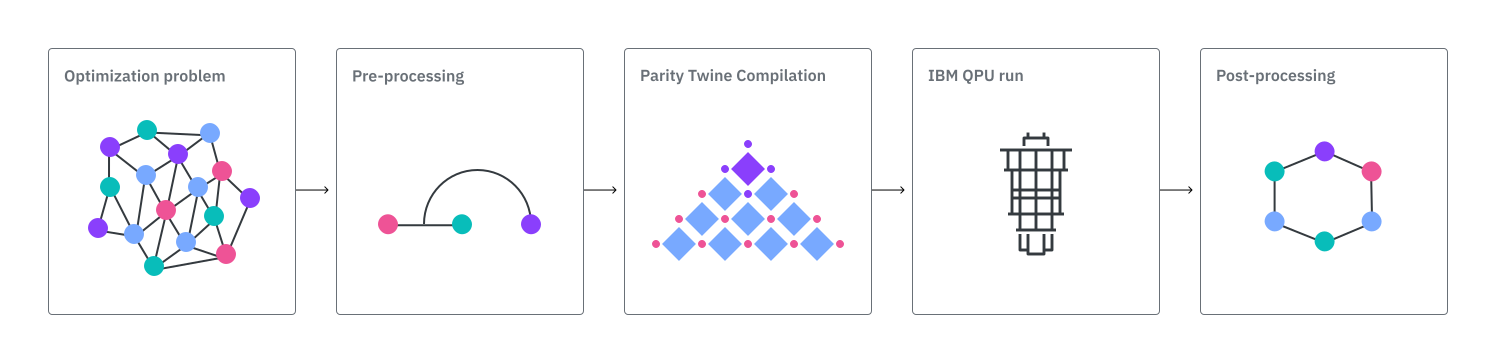
入力の最適化問題は、(正規化された)ハミルトニアンに前処理されます。次に、ParityQCコンパイラがパラメータ化されたParity Twineアンザッツ回路を構築し、それが選択したハードウェアのネイティブ ゲートセットに合致する論理的なアンザッツにトランスパイルされます。
QAOA回路のパラメータは、"efficient depth one"アプローチを使用して古典的に最適化され、トランスパイルされた回路に割り当てられます。 QAOAの1ラウンドのみが使用されるため、最適なとのパラメータは、多くの回路呼び出しにわたる高コストな反復最適化を必要とせず、CPU上でのグリッドサーチを使用して得られます。これにより、オプティマイザーに必要なQPU実行時間が大幅に最小化されます。回路あたりの実行時間は、主にQPU上でジョブを実行するための一定のオーバーヘッドによって決まります。 回路パラメータが設定されると、ジョブは指定されたIBM® QPUに送信されます。
生の結果は、その後後処理されます。このステップでは、解のビット列をランダムな順序で走査し、コスト関数の値を減少させる場合にビット値を反転させる局所的な貪欲探索を使用します。
ベンチマーク
パフォーマンスは、問題インスタンスとその後の処理ステップの両方に依存する場合があります。場合によっては、古典的なサンプルと量子生成されたサンプルが、同等の後処理を経た後に同様の最終的な解の質を達成することがあります。したがって、評価は最適化ワークフロー全体を考慮する必要があります。
Sherrington-Kirkpatrickモデル
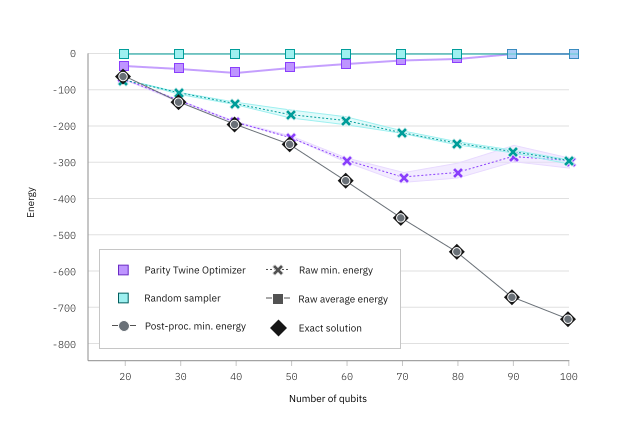
図2は、Parity Twine Optimizerの有効性を示しています。これは、量子ビット数を増やしていくSherrington-Kirkpatrickモデルについて、オプティマイザーを使用して得られた結果とランダムサンプリングとの結果を比較したものです。
ランダムおよびオプティマイザーの両方の結果を後処理すると、正確な基底状態が得られますが、Twine QAOAからの生の最小エネルギー出力は、常にランダムな 値よりも優れています。検討した中で最大の量子ビット数(90および100)では、ハードウェアノイズによってオプティマイザーの結果が劣化し、ランダムサンプリングに匹敵する生の値に戻ってしまいます。
Sherrington-Kirkpatrickモデルの紹介と、Parity Twine Optimizerを使用してそれを解く方法の詳細については、このチュートリアルをご覧ください。
Market Split問題
表1は、Market Split (MS) 問題の様々なインスタンスに適用したParity Twine Optimizerの具体的なパフォーマンス指標を示しています。 これらは、QOBLIB - Quantum Optimization Benchmarking Libraryから取得したものであり、Parity Twine Optimizerを使用してライブラリに行われた submissionsに対応しています。
MS violationは、解がすべての制約を満たすことからどれだけ離れているかを測る精度指標であり、として定義されます。この指標の値が低いほど、より正確な解であることを示します。
表1は、ibm_bostonデバイスをバックエンドとして100,000ショットを用いたParity Twine Optimizerによる、各インスタンスの5回の実行の平均値を報告しています。
各インスタンスの実行から得られた最小のMS violationが報告されています。
| インスタンス | 量子ビット | 2量子ビットゲート数 | 2量子ビット深度 | MS violation | マッピング時間 (秒) | QPU実行時間 (秒) | 後処理時間 (秒) |
|---|---|---|---|---|---|---|---|
| ms_03_050_002 | 20 | 399 | 76 | 0 | 45 | 29 | 71 |
| ms_03_100_022 | 20 | 399 | 76 | 0 | 30 | 29 | 77 |
| ms_03_200_177 | 20 | 399 | 76 | 0 | 33 | 29 | 63 |
| ms_04_050_001 | 30 | 899 | 116 | 1 | 68 | 29 | 216 |
| ms_04_100_003 | 30 | 899 | 116 | 2 | 89 | 29 | 187 |
| ms_04_200_030 | 30 | 899 | 116 | 3 | 89 | 29 | 219 |
| ms_05_100_003 | 40 | 1599 | 156 | 3 | 237 | 30 | 364 |
| ms_06_050_001 | 50 | 2499 | 196 | 4 | 499 | 30 | 464 |
| ms_07_050_001 | 60 | 3599 | 236 | 17 | 858 | 31 | 637 |
| ms_08_050_001 | 70 | 4899 | 276 | 36 | 1561 | 31 | 773 |
表1: Market Split問題のさまざまなインスタンスに関するパフォーマンス指標。インスタンス名は、QOBLIB問題ライブラリ内の対応する例の名前です。説明セクションで前述したように、CPUで得られた最適な回路パラメータを使用してQAOAの1ラウンドのみが使用されるため、QPU時間は最小限でほぼ一定です。
Market Split問題の紹介と、Parity Twine Optimizerを使用してそれを解く方法の詳細については、このチュートリアルをご覧ください。
Maximum Independent Set問題
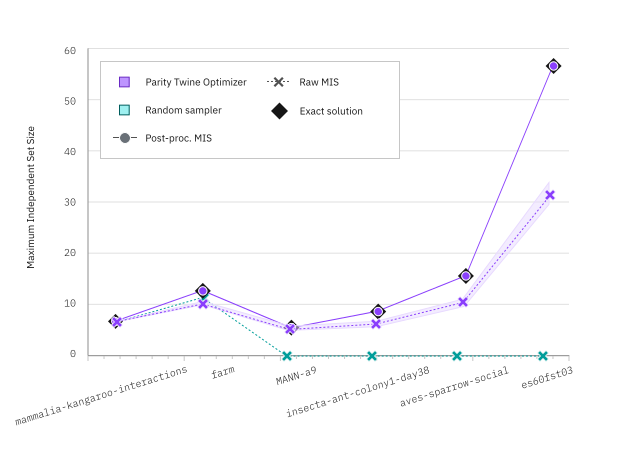
図3は、QOBLIB - Quantum Optimization Benchmarking Libraryから取得した選択されたインスタンスについて、maximum independent set問題に対しParity Twine Optimizerを使用して得られた結果とランダムサンプリングとの比較を示しています。これらは18(mammalia-kangaroo-interactions)量子ビットから 114(es60fst03)量子ビットまでの範囲にわたります。
小規模なインスタンスでは、オプティマイザーとランダムサンプリングによる生のMaximum Independent Setサイズの結果は似ていますが、より大規模なインスタンスでは、オプティマイザーがはるかに優れた結果を与えます。 ランダムサンプリングとオプティマイザーの両方の結果を後処理すると、再び正確な値と一致する集合サイズが得られます。
はじめに
IBM Quantum Platform APIトークンを使用して認証し、Qiskit Functionを次のように選択します。
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"qiskit_ibm_catalog": "qiskit-ibm-catalog"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit_ibm_catalog import QiskitFunctionsCatalog

# Authenticate and load the Qiskit Function
catalog = QiskitFunctionsCatalog(
    channel="ibm_quantum_platform",
)
function = catalog.load("parityqc/parity-twine-optimizer")
例
Parity Twine Optimizerは、以下のように簡単なQUBOの例に適用できます。まず、問題は辞書を使用して定義されます。
problem = {"()": 3, "(0,)": 1, "(0, 1)": 2, "(1, 2)": -1}
次に、変数の型をbinaryまたはspinとして定義する必要があります。
variable_type = "spin"
これは、である目的関数を定義します。
バックエンドを選択します。例えば以下の通りです。
backend_name = "ibm_phoenix"
ユーザーアカウント/インスタンスから利用可能なバックエンドのリストを確認するには、catalog.backends()を使用します。
バックエンドが指定されない場合、最も混雑していない(空いている)バックエンド(保留中のジョブ数が最も少ないもの)が自動的に選択されます。
オプティマイザーが読み込まれたら(前述の通り)、デフォルトのオプションを使用して問題に対して実行できます。
function_job = function.run(
    problem=problem, variable_type=variable_type, backend_name=backend_name
)
print(f"Job ID: {function_job.job_id}")
以下のようにジョブのステータスを確認します。
# Monitor the job status
function_job.status()
以下のように結果を取得します。
# Retrieve the job result if the status is DONE
result = function_job.result()

result
結果を出力すると、以下が得られます。
{
    'solution': {'0': -1, '1': 1, '2': 1},
    'objective_value': -1.0,
    'solution_bitstring': '100',
    'metadata': {
        'circuit_metrics': {
            'depth': 20,
            'gate_count': 198,
            'two_qubit_gate_depth': 4,
            'two_qubit_gate_count': 4,
            'num_qubits': 3,
            'operations': {'delay': 158, 'rz': 17, 'sx': 14, 'cz': 4, 'measure': 3, 'x': 2}
        },
        'solver_info': {
            'variable_mapping': {'0': 0, '1': 1, '2': 2},
            'bitstring_distributions': {
                'before_postprocessing': {'100': 71760, ... },
                'after_postprocessing': {'100': 88440, '011': 11560}
            },
            'best_parameters': {
                'beta': [-0.46259546391008877],
                'gamma': [0.6181957189727373]
            }
        },
        'resource_usage': {
            'RUNNING: MAPPING': {'CPU_TIME': 42.878},
            'RUNNING: OPTIMIZING_FOR_HARDWARE': {'CPU_TIME': 0.094},
            'RUNNING: WAITING_FOR_QPU': {'CPU_TIME': 790.623},
            'RUNNING: EXECUTING_QPU': {'QPU_TIME': 28.0},
            'RUNNING: POST_PROCESSING': {'CPU_TIME': 0.828}
        }
    }
}
solution辞書は、問題内で定義された量子ビット(、および)に対応し、それらの最適化されたスピン値を示します。
objective_valueは、最適化問題のコストまたはエネルギーです。これはsolutionの質を定量化します。
metadataは、トランスパイルに関する情報(2量子ビットゲート数/深度、使用されたゲート、アクティブな量子ビット)と、量子および古典計算時間の両方に関する様々な実行時間を提供します。
さらに、metadataからはアルゴリズムの内部動作を垣間見ることができます。最適化された変分パラメータ(betaとgamma)を確認したり、生の量子結果に古典的な後処理を適用した後、測定されたビット文字列の分布がどのように改善されたかを確認したりできます。
結果出力内のすべてのビット文字列は、variable_mappingを使用して問題変数にマッピングできます。
例えば、'solution_bitstring': '100'を'variable_mapping': {'0': 0, '1': 1, '2': 2}とともに、バイナリの解{'0': 1, '1': 0, '2': 0}にマッピングできます。
スピン変数の観点で問題を解いているため、バイナリからスピンへの変換(0 -> 1、1 -> -1)を適用する必要があります。
こうして、最終的な解'solution': {'0': -1, '1': 1, '2': 1}が得られます。
Parity Twine Optimizer関数の入力と出力の詳細については、APIリファレンスを参照してください。
変更履歴
[1.0.2] - 2026-09-15
Notes
このリリースは、Parity Twine Optimizer Qiskit Functionの最初の安定した本番バージョンです。今後のリリースでは、以下の内容が導入される予定です。
- 高次の問題コンパイル、
- 追加の最適化アルゴリズム、および
- 前処理と後処理の改善。
機能
- 効率的なParity Twine Compilerを使用して、疎および密なQUBO問題を解きます。
ドキュメント
- 入門ユーザーガイド。
- Market SplitおよびSherrington-Kirkpatrick問題の例を用いたチュートリアル。
- APIドキュメント。
サポートを受ける
質問や問題がある場合は、ParityQCに問い合わせてください。
次のステップ
- フォームに記入して、この関数へのアクセスをリクエストしてください。
- このQiskit Functionについては、APIリファレンスをご覧ください。
- Parity Twine OptimizerをMarket Split問題に適用するチュートリアルをお試しください。
- Parity Twine OptimizerをSherrington-Kirkpatrickモデルに適用するチュートリアルをお試しください。
- Connectivity-aware Synthesis of Quantum Algorithms, Drier et al. (2025)のArXivプレプリントをご覧ください。