古典シャドウによるノイズを含む量子状態の学習
使用量の目安: Heron r2 プロセッサーで 34 分(注: これはあくまで目安です。実際の実行時間は異なる場合があります。)
学習成果
-
JuliaからIBM®量子プロセッサー上でランダム化測定を収集し、後の分析のために保存する
-
学習の前に、測定データに不良な量子ビットやゲートがないか確認する
-
ノイズのある状態の行列積演算子(MPO)モデルを古典シャドウにフィットさせる
-
保留した測定データでモデルを検証し、理想的な回路と比較する
前提条件
-
Greenberger-Horne-Zeilinger(GHZ)状態のシャドウ・トモグラフィーチュートリアルで紹介した古典シャドウ
-
量子情報の基礎で扱う密度行列と混合状態
-
横磁場イジング模型の時間発展をシミュレーションするチュートリアルで紹介した、
Qiskit.jlとQiskitIBMRuntime.jlを使ったJuliaからの回路の実行
背景
実際の量子プロセッサーでは、ノイズによって、回路が準備するよう設計された純粋状態が混合状態に変わります。完全な量子状態トモグラフィーでを再構成できますが、必要な測定回数は量子ビット数に対して指数関数的に増加します。Vottoら[1]は代わりに、ランダム化測定から最大96量子ビットののコンパクトなモデルを学習しました。このチュートリアルは、彼らのワークフローに従います。
ランダム化測定[2]では、すべての量子ビットを独立なランダムユニタリーで回転させ、計算基底で測定します。回転を1回引いたものを測定設定と呼び、各設定をショット繰り返します。出力ビットを持つ1ショットは、古典シャドウ[3]
を与え、設定とショットにわたる平均はになります。前提となるチュートリアルでは各を3つのパウリ基底から選びますが、このチュートリアルでは論文と同様に、すべての1量子ビット・ユニタリーから一様に(ハール・ランダムに)選びます。同じ式が適用できます。
シャドウは、一度に少数の量子ビットの性質を推定します。論文ではそれらを行列積演算子(MPO)にまとめます。MPOは密度行列を、量子ビットごとに1つの小さなテンソルの連鎖として表します。短距離相関を持つノイズ状態には、隣接するテンソル間の小さなボンドだけで十分です。密度行列繰り込み群(DMRG)アルゴリズムと同様に、学習器は連鎖に沿ってスイープし、一度に1つのテンソルを更新して、そのテンソルを中心とする量子ビットのウィンドウでモデルがシャドウに一致するようにします(論文の式4)。これらの更新中、ボンド次元は固定されたままなので、学習器がモデルを切り詰めることはありません。データはこれらのウィンドウを通してのみ入力されるため、必要な設定数は連鎖の長さに応じて増加しません。
設定は訓練セットとテストセットに分割されます。論文では、テストセットでとモデルの間の最大フィデリティを推定します。
を直接測定するには、指数関数的に多くの測定が必要です。そこで論文では近似因数分解条件(AFC)を仮定します。これは、の相関が数量子ビット以内で減衰するため、大域的な重なりと純度が、隣接する量子ビットのブロック上の項に因数分解できるというものです。純度からは、状態がどれだけ混合しているかを表すレニー2エントロピーも得られます。
論文では、深さのキックト・イジング状態を準備します。
ibm_brisbane(Eagleプロセッサー)の96量子ビット上で、に対して1,024ショットの設定を2,048個使用しています。論文の図1(c,d)は、について2つの結果を報告しています。
-
学習したモデルは、の実験状態に対してに達し、理想状態と実験との重なりをはるかに上回ります。
-
エントロピーは線形に増加し()、モデルのエントロピーはテストセットからの独立した推定値と一致します。
このチュートリアルでは、まず正確な答えがわかっている8量子ビットのシミュレーションで、次にHeron r2プロセッサーであるibm_fezでの新しい96量子ビットの実行で、両方の結果を確認します。学習器は、論文とその補遺の式をJuliaで独自に実装したものです。
要件
Qiskit.jlはまだWindowsをサポートしていないため(Qiskit.jl issue #15)、このチュートリアルにはmacOSまたはLinuxが必要です。さらに、次のものが必要です。
-
Julia 1.11(これはJuliaのダウンロードページから、または
juliaup add 1.11で入手できます)と、IJuliaパッケージ:julia -e 'using Pkg; Pkg.add("IJulia")' -
ハードウェアの例には、96量子ビット以上のQPUにアクセスできるIBM Quantum® Platformアカウントと、保存済みの認証情報が必要です。アカウントがなくても、このチュートリアルの結果を生み出した
ibm_fezの実行で保存された測定データから、ハードウェアの例を実行できます。それ以外のセクションはアカウントなしで実行できます。
このノートブックでは、回路の構築と実行にQiskit.jlとQiskitIBMRuntime.jl、ランダム化測定にRandomMeas.jl[4](ITensors.jlとITensorMPS.jlも提供されます)、さらにNPZ.jl、JSON.jl、Plots.jlを使用します。このチュートリアルは、Qiskit.jl 0.6.1、QiskitIBMRuntime.jl 0.3.2、RandomMeas.jl 0.3.1でテストされています。
環境の設定方法は2通りあります。
-
オプション1: 互換性のある最新バージョンのパッケージを一時的な環境にインストールします。次のセルを変更せずに実行してください。
-
オプション2: テスト済みの環境を正確に再現します。次のセルで
download_toml_files = trueを設定してください。このセルは、ドキュメントリポジトリからProject.tomlとManifest.tomlを、このノートブックの隣のenv_tutorial/classical-shadows/フォルダーにダウンロードし、間接的な依存関係を含め、マニフェストに記録されたすべてのパッケージの正確なバージョンをインストールします。詳細については、これらのファイルに関するJuliaのドキュメントを参照してください。
using Pkg
using Downloads

download_toml_files = false

if !download_toml_files
    # Option 1: Install the latest compatible versions into a temporary environment
    Pkg.activate(mktempdir(); io=devnull)
    Pkg.add([
        PackageSpec(name="Qiskit", version="0.6"),
        PackageSpec(name="QiskitIBMRuntime", version="0.3"),
        PackageSpec(name="RandomMeas", version="0.3"),
        PackageSpec(name="NPZ"),
        PackageSpec(name="JSON"),
        PackageSpec(name="Plots"),
    ]; io=devnull)
else
    # Option 2: Install the exact tested versions recorded in Project.toml and Manifest.toml
    base_url = "https://raw.githubusercontent.com/Qiskit/documentation/main/docs/tutorials/assets/classical-shadows/julia"
    env_dir = joinpath(@__DIR__, "env_tutorial", "classical-shadows")
    mkpath(env_dir)
    for file in ("Project.toml", "Manifest.toml")
        Downloads.download("$base_url/$file", joinpath(env_dir, file))
    end
    Pkg.activate(env_dir; io=devnull)
    Pkg.instantiate(; io=devnull)
end
セットアップ
using RandomMeas  # also loads ITensors and ITensorMPS
using Qiskit, QiskitIBMRuntime
using Random, LinearAlgebra, Statistics
using Downloads, SHA, NPZ, JSON, Plots

# Download the helper module that implements the learner, unless a copy exists
docs_url = "https://raw.githubusercontent.com/Qiskit/documentation/main"
helper_file = joinpath(@__DIR__, "env_tutorial", "classical-shadows", "mpo_learning.jl")
if !isfile(helper_file)
    mkpath(dirname(helper_file))
    helper_url = "$docs_url/docs/tutorials/assets/classical-shadows/julia/mpo_learning.jl"
    Downloads.download(helper_url, helper_file)
end
include(helper_file)
using .ShadowMPOLearning
BLAS.set_num_threads(1)  # the learner multiplies many small matrices
ヘルパーモジュールmpo_learning.jlは、セットアップのセルでダウンロードされ、学習器を実装しています。このチュートリアルでは、このモジュールから次の関数を呼び出します。
| 関数 | 目的 |
|---|---|
kicked_ising_reference(N, D; depolarization) | 理想的なキックト・イジング状態、または局所的な脱分極ノイズ後の状態の正確なMPO |
split_settings(group; seed, train_fraction) | 測定設定を訓練セットとテストセットにランダムに割り当てる(デフォルトでは半分ずつ) |
training_marginals(train; ell, prior) | 訓練設定のみからの、すべての学習ウィンドウのシャドウ推定値 |
fitted_prior(ideal, train) | 共通ランダム化測定(CRM)の事前分布。論文と同様に、各ウィンドウの測定された純度にフィットさせたもの |
learn_mpo(marginals, N; ell, maxbond, sweeps) | 最大混合状態から開始し、論文の1サイト更新を連鎖に沿ってスイープする |
max_fidelity(a, b), mpo_overlap(a, b) | 2つのMPO間の正確なと |
afc_estimate, afc_statistics, afc_prefix_curve | テスト設定からのとのAFC推定値(ジャックナイフ誤差棒付き) |
学習器はMPOをパウリ基底で保持します。これによりモデルはエルミートでトレースが1になりますが、半正定値になることは強制されません。そのため、ノートブックでは固有値がどれだけ負になるかを報告します。
小規模なシミュレーターの例
すべてを正確に計算できるほど小さな系から始めます。ハードウェアをモデル化するために12%の局所脱分極ノイズを加えた、8量子ビットの深さ1のキックト・イジング状態です。ノイズのある状態がわかっているので、学習したモデルをそれと直接比較できます。
ステップ1: 古典的な入力を量子問題にマッピングする
関数kicked_ising_referenceは、正確な状態をMPOとして返します。depolarization=0.12の場合、すべての量子ビットのブロッホベクトルは回路の後で12%縮小します。
N = 8
ideal = kicked_ising_reference(N, 1)
rho = kicked_ising_reference(N, 1; depolarization=0.12)
println("Purity of the noisy state: ", round(mpo_overlap(rho, rho), digits=3))
println("F_max between the noisy and ideal states: ", round(max_fidelity(rho, ideal), digits=3))
Purity of the noisy state: 0.327
F_max between the noisy and ideal states: 0.56
ステップ2: 量子ハードウェアでの実行に向けて問題を最適化する
この例では測定結果を古典的にサンプリングするため、トランスパイルする回路はありません。このステップはハードウェアの例で扱います。
ステップ3: Qiskitプリミティブを使用して実行する
RandomMeas.jlを使って、ハール・ランダムな測定設定を2,048個引き、それぞれから256ショットをサンプリングしてから、設定を訓練セットとテストセットに均等に分割します。ショットではなく設定ごとに分割してください。同じ設定のショットは回転を共有するため、独立ではありません。
Random.seed!(20260921)
sites = siteinds("Qubit", N)
settings = [LocalUnitaryMeasurementSetting(N; site_indices=sites, ensemble=Haar) for _ in 1:2048]
measurements = MeasurementGroup(to_itensor_mpo(rho, sites), settings, 256)
split = split_settings(measurements; seed=20260921)
println(length(split.train_ids), " training settings, ", length(split.test_ids), " testing settings")
1024 training settings,
1024 testing settings
ステップ4: 後処理を行い、望ましい古典的形式で結果を返す
論文の深さ1のパラメーターでモデルを学習します。更新するテンソルの両側に量子ビット広がるウィンドウ、ボンド次元4、最大混合状態から開始する20回のスイープです。最初のスイープでは隣接するテンソルのペアを更新し、これによってボンド次元が1から4に増加します。それ以降のスイープでは、その固定されたボンド次元で一度に1つのテンソルを更新します。
シャドウの統計的ノイズを減らすために、論文では共通ランダム化測定(CRM)[5]を使用します。各設定について、状態の事前の推測が同じ設定で生み出す平均シャドウを差し引き、その後で事前分布の正確な値を加え戻します。この補正の平均はゼロになるため、事前分布は統計誤差の大きさを変えますが、推定されるものは変えません。ここでの事前分布は、10%の局所脱分極を伴う理想状態で、真の12%に近い値です。ハードウェアではノイズレベルが未知のため、ハードウェアの例では、論文と同様に、代わりに測定された純度に事前分布をフィットさせます。
prior = kicked_ising_reference(N, 1; depolarization=0.10)
marginals = training_marginals(split.train; ell=2, prior)
fit = learn_mpo(marginals, N; ell=2, maxbond=4, sweeps=20)
sigma = fit.model
plot([h.sweep for h in fit.history], [h.local_loss for h in fit.history];
    xlabel="sweep", ylabel="mean squared residual", label="training windows",
    size=(680, 320), left_margin=5Plots.mm, bottom_margin=5Plots.mm)
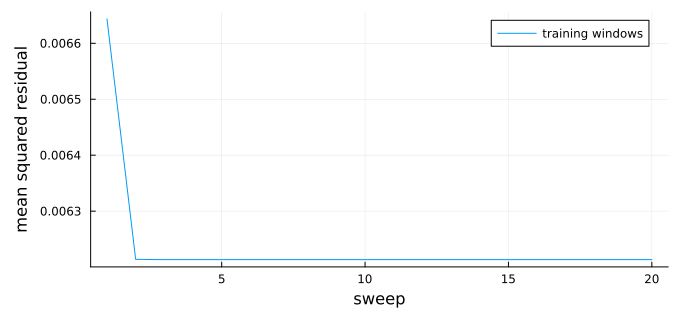
残差は、モデルのウィンドウが訓練シャドウからどれだけ離れているかを測ります。1サイト更新が始まる2回目のスイープで減少し、その後はゼロに達せず、ほぼ一定のままになります。これは、シャドウに統計的ノイズが含まれており、小さなボンド次元のモデルではそれを再現できないためです。
この状態はわかっているので、学習したモデルをそれと正確に比較でき、さらに最も単純な2つの推測、つまりCRMの事前分布と理想状態もそれと比較できます。
eigenvalues = eigvals(Hermitian(dense_operator(sigma)))
println("F_max with the noisy state")
println("  learned model: ", round(max_fidelity(rho, sigma), digits=3))
println("  CRM prior:     ", round(max_fidelity(rho, prior), digits=3))
println("  ideal state:   ", round(max_fidelity(rho, ideal), digits=3))
println("Most negative eigenvalue of the model: ", round(minimum(eigenvalues), digits=4))
println("Total negative eigenvalue weight:      ", round(-sum(min.(eigenvalues, 0)), digits=4))
F_max with the noisy state
learned model: 0.993
  CRM prior:     0.911
  ideal state:   0.56
Most negative eigenvalue of the model: -0.0076
Total negative eigenvalue weight:      0.0348
学習したモデルは、事前分布や理想状態のどちらよりもノイズのある状態に近く、データからノイズを学習したことがわかります。小さな負の固有値は、測定回数が有限であることに由来します。
ハードウェアでは状態が未知なので、代わりにテスト設定からを推定します。AFCは連鎖を量子ビットのブロックに分割し、純度を次のように近似します。
また、を局所的な重なりの同じ比で近似します。の場合、2つのブロックが8量子ビットすべてをカバーするため、式は厳密です。の場合は、因数分解の仮定に依存します。一度に1つのテスト設定を除外するジャックナイフ誤差棒は、テストデータの統計誤差のみをカバーし、訓練のランダム性やAFC近似はカバーしません。
for k in (2, 4)
    estimate = afc_estimate(sigma, split.test; k, statistics=afc_statistics(split.test, k; prior))
    println("k = $k: held-out F_max = ", round(estimate.fidelity, digits=3), " ± ",
        round(estimate.fidelity_sem, digits=3))
end
println("Exact F_max:              ", round(max_fidelity(rho, sigma), digits=3))
k = 2: held-out F_max = 0.966
± 0.036
k = 4: held-out F_max =
0.958 ± 0.049
Exact F_max:              0.993
保留した2つの推定値はどちらも、誤差棒の範囲内で正確な値と一致します。
大規模なハードウェアの例
次に、Heron r2プロセッサーであるibm_fezの96量子ビットの連鎖で実験を実行します。ibm_brisbaneと同様に、ヘビーヘックス結合マップを持ち、ノイズレベルも同程度です。
データの収集には、1,024個のSampler jobと約34分のQPU時間がかかります。96量子ビット以上のQPUにアクセスできない場合や、キューが長い場合は、2026年9月27日にibm_fezで記録された測定データからハードウェアの例を実行してください。これは、このチュートリアルに示された結果を生み出したものです。use_saved_data = trueにすると、ノートブックはステップ1でこれらの測定データ(15 MB)をZenodo[6]からダウンロードし、ステップ3でのjobの送信をスキップします。ご自身のデータを収集するには、falseに設定してください。
use_saved_data = true; # set to false to collect new measurements on hardware
ステップ1: 古典的な入力を量子問題にマッピングする
各設定には1つの回路が必要です。キックト・イジング回路、のための各量子ビットへのゲート、そしてすべての量子ビットの測定です。をサンプリングし、、、をで一様にすると、はハール・ランダムになります。u3_matrix関数はの行列を返し、ステップ4で使用します。
予算は、1,024ショットの設定を1,024個で、これは論文の設定数の半分であり、訓練とテストに均等に分割されます。保存済みデータを使う場合、このセルは記録された角度を読み込みます。そうでない場合は、新しい角度を引き、何かを送信する前にそれらを保存します。角度がなければ結果を分析できないためです。ファイルがすでに存在する場合、セルはそれを読み込むため、セッションを再起動した後でも、角度は保存された結果と一致します。
"Matrix of the U(θ, ϕ, λ) gate, as used by `qc.u` in Qiskit."
u3_matrix(θ, ϕ, λ) = [cos(θ/2)              -exp(im*λ)*sin(θ/2);
                      exp(im*ϕ)*sin(θ/2)    exp(im*(ϕ + λ))*cos(θ/2)]

"Angles (θ, ϕ, λ) for which `u3_matrix(θ, ϕ, λ)` is a Haar-random unitary."
random_u3_angles() = (2asin(sqrt(rand())), 2π*rand(), 2π*rand())

N_hw, NU_hw, NM_hw = 96, 1024, 1024
data_directory = joinpath(@__DIR__, "classical-shadows-data")
saved_file = joinpath(data_directory, "ibm-fez-run.npz")
run_directory = joinpath(data_directory, "new-run")
settings_file = joinpath(run_directory, "settings.npz")
if use_saved_data
    saved_url = "https://zenodo.org/records/24116174/files/ibm-fez-run.npz?download=1"
    saved_sha256 = "c42f4d8d42e5083e9e152b4fec0846884ebe3be003e5ab528deebf4f00c9fe50"
    if !isfile(saved_file)
        mkpath(data_directory)
        println("Downloading the saved ibm_fez run (15 MB)...")
        Downloads.download(saved_url, saved_file * ".part")
        mv(saved_file * ".part", saved_file)
    end
    bytes2hex(open(sha256, saved_file)) == saved_sha256 ||
        error("$saved_file is incomplete or corrupted; delete it and run this cell again")
    saved_run = npzread(saved_file)
    angles = saved_run["angles"]
elseif isfile(settings_file)
    angles = npzread(settings_file)["angles"]
else
    mkpath(joinpath(run_directory, "outcomes"))
    Random.seed!(20260927)
    angles = Array{Float64}(undef, NU_hw, N_hw, 3)
    for r in 1:NU_hw, i in 1:N_hw
        angles[r, i, :] .= random_u3_angles()
    end
    npzwrite(settings_file, Dict("angles" => angles))
end
println("Measurement settings: ", size(angles, 1), " × ", size(angles, 2), " qubits")
Measurement settings: 1024
× 96 qubits
ステップ2: 量子ハードウェアでの実行に向けて問題を最適化する
連鎖は最も悪い量子ビットの品質までしか良くならないため、96個の物理量子ビットはご自身で選んでください。Qiskit.jlのtranspile関数はまだ固定された初期レイアウトを受け付けることができず、ibm_phoenixでのテストでは、選ばれたレイアウトに読み出しエラーが51%の量子ビットが含まれていました。次の連鎖は、ibm_fezの結合マップ上の96量子ビットのパスで、2026年9月27日のキャリブレーションデータから、Python Qiskitのtranspile関数(optimization_level=3)のエラーを考慮したレイアウトが選択したものです。平均読み出しエラーは1.6%ですが、ヘビーヘックス格子には96量子ビットのパスが少なく、このパスには読み出しエラーが15%の量子ビット35が含まれています。キャリブレーションは変化するため、別の日や別のQPUで実行する前に、現在のキャリブレーションデータから新しい連鎖を選んでください。
この連鎖を維持するには、回路をトランスパイルする代わりに、ネイティブゲートで直接記述します。ゲートは、大域位相を除いてに等しくなります。この分解は、ランダムな回転と、キックの両方をカバーします。ゲートは、大域位相を除いて、CZゲートの後に両方の量子ビットへを適用したものに等しくなります。これらのゲートは対角なので、CZゲートと可換であり、各量子ビットは、測定回転の前に、ボンドごとに1つのを集めます。
num_device_qubits = 156
# Physical qubits of ibm_fez, in IBM numbering, forming the chain
chain_physical = [
    2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15, 19, 35, 34, 33, 39, 53, 54, 55, 59, 75, 74,
    73, 79, 93, 94, 95, 99, 115, 114, 113, 119, 133, 132, 131, 130, 129, 128, 127, 137, 147, 146,
    145, 144, 143, 136, 123, 124, 125, 117, 105, 106, 107, 108, 109, 110, 111, 98, 91, 90, 89,
    88, 87, 86, 85, 77, 65, 66, 67, 68, 69, 70, 71, 58, 51, 50, 49, 48, 47, 46, 45, 37, 25, 24,
    23, 22, 21, 36, 41, 42, 43, 56, 63]
chain = chain_physical .+ 1  # Qiskit.jl numbers qubits from 1

"Apply U(θ, ϕ, λ) to qubit q with native gates: rz(λ), sx, rz(θ + π), sx, rz(ϕ + π)."
function native_u!(qc, q, θ, ϕ, λ)
    qc.rz(λ, q)
    qc.sx(q)
    qc.rz(θ + π, q)
    qc.sx(q)
    qc.rz(ϕ + π, q)
end

"Kicked-Ising circuit on `chain`, then the rotations of one setting and a measurement."
function native_setting_circuit(chain, angles, num_device_qubits)
    n = length(chain)
    qc = QuantumCircuit(num_device_qubits, n)
    for q in chain
        native_u!(qc, q, π/4, -π/2, π/2)       # e^{-iπ/8 X}
    end
    for i in 1:n-1
        qc.cz(chain[i], chain[i + 1])          # e^{iπ/4 ZZ}, up to the S† gates below
    end
    for (i, q) in enumerate(chain)
        bonds = (i > 1) + (i < n)
        qc.rz(-π/2 * bonds, q)                 # one S† per bond
        native_u!(qc, q, angles[i, 1], angles[i, 2], angles[i, 3])
        qc.measure(q, i)                       # outcome of chain qubit i goes to bit i
    end
    qc
end

circuits = [native_setting_circuit(chain, angles[r, :, :], num_device_qubits) for r in 1:NU_hw]
println(length(circuits), " circuits, each with ", count(inst -> inst.name == "cz", circuits[1].data), " CZ gates")
1024 circuits, each with
95 CZ gates
ステップ3: Qiskitプリミティブを使用して実行する
QiskitIBMRuntime.jlは、1つのSampler jobにつき1つの回路を実行するため、データの収集には1,024個のjobが必要です。次のセルは、キューに最大32個のjobを保持し、各設定の結果をそのjobが完了し次第保存します。各ショットはビットのベクトルとして返され、要素は連鎖の量子ビットの結果です。
QiskitIBMRuntime.jlはまだjobをIDで検索できないため(qiskit-ibm-runtime-c issue #28)、jobを送信したのと同じセッションで結果を取得する必要があります。jobが失敗した場合、セルは警告を出して続行します。セッションが停止した場合は、ステップ1から3をもう一度実行してください。セルを再実行すると、結果が欠けている設定のみが送信されます。use_saved_data = trueの場合、セルは何も送信しません。
outcome_file(r) = joinpath(run_directory, "outcomes", "setting_$(lpad(r, 4, '0')).npz")

"Save the outcomes of setting `r` as a (shots × N) matrix of 0/1 values."
function save_outcomes(r, job)
    try
        samples = get_sampler_job_results(job, service)
        bits = UInt8.(permutedims(reduce(hcat, samples)))
        npzwrite(outcome_file(r), Dict("bits" => bits))
    catch err
        @warn "Setting $r failed and was not saved; run this cell again to resubmit it" err
    end
end

if use_saved_data
    println("Using the saved ibm_fez measurements; no jobs submitted")
else
    backend_name = "ibm_fez"
    service = Service()  # uses the credentials saved on this computer
    backend = only(b for b in backend_search(service) if b.name == backend_name)
    open(joinpath(run_directory, "metadata.json"), "w") do io
        JSON.print(io, Dict("backend" => backend_name, "N" => N_hw, "depth" => 1, "settings" => NU_hw,
                            "shots" => NM_hw, "chain" => chain_physical), 2)
    end
    in_flight = []
    for r in 1:NU_hw
        isfile(outcome_file(r)) && continue
        push!(in_flight, (r, run_sampler_job(service, backend, circuits[r], NM_hw)))
        length(in_flight) >= 32 && save_outcomes(popfirst!(in_flight)...)
    end
    foreach(job -> save_outcomes(job...), in_flight)
    println("Saved outcomes: ", count(r -> isfile(outcome_file(r)), 1:NU_hw), " of ", NU_hw, " settings")
end
Using the saved ibm_fez measurements; no jobs submitted
ステップ4: 後処理を行い、望ましい古典的形式で結果を返す
このステップは保存されたデータのみを読み込みます。use_saved_dataがtrueの場合はダウンロードしたibm_fezの実行、そうでない場合はステップ3が書き込んだファイルです。そのため、jobを送信せずに新しいセッションで実行できます(最初にセットアップのセル、use_saved_dataのセル、ステップ1を実行してください)。ダウンロードしたファイルは、各ショットの96個の結果を、最上位ビットを先頭にして12バイトに詰めて保存しているため、ローダーがそれを展開します。RandomMeas.jlは結果を1と2でラベル付けするため、ローダーはすべてのビットに1も加えます。
"Build a `MeasurementGroup` from the angles and a function `outcomes(r)` that returns
the (shots × N) 0/1 outcomes of setting `r`."
function measurement_group(angles, outcomes)
    settings_count, n = size(angles, 1), size(angles, 2)
    sites = siteinds("Qubit", n)
    data = map(1:settings_count) do r
        rotations = Array{ComplexF64}(undef, n, 2, 2)
        for i in 1:n
            rotations[i, :, :] = u3_matrix(angles[r, i, :]...)
        end
        MeasurementData(Int.(outcomes(r)) .+ 1;
            measurement_setting=LocalUnitaryMeasurementSetting(rotations; site_indices=sites))
    end
    MeasurementGroup(data)
end

if use_saved_data
    packed = saved_run["outcomes"]  # settings × shots × 12 bytes
    # Bit i of a shot is in byte (i - 1) ÷ 8 + 1, most significant bit first
    unpack(r) = [(packed[r, s, (i - 1) ÷ 8 + 1] >> (7 - (i - 1) % 8)) & 0x01
                 for s in 1:size(packed, 2), i in 1:N_hw]
    group_hw = measurement_group(angles, unpack)
else
    group_hw = measurement_group(angles, r -> npzread(outcome_file(r))["bits"])
end
println(group_hw.NU, " settings × ", group_hw.NM, " shots on ", group_hw.N, " qubits")
1024 settings ×
1024 shots on 96 qubits
学習の前に、データを確認します。壊れた量子ビットや不適切にキャリブレーションされたゲートは、その周辺の測定状態をはるかに混合させ、学習器を発散させる可能性があります。隣接する数量子ビットの純度は、このノイズのモデルに依存しないベンチマークです。RandomMeas.jlの関数get_purityは、同じ設定のショットのペアを比較することで、部分系のを推定します。隣接する6量子ビットのすべてのウィンドウについてレニー2エントロピーを計算し、理想状態の同じウィンドウと比較します。各ウィンドウは連鎖の残りの部分ともエンタングルしているため、理想的な値はゼロではありません。ノイズはこれを増加させ、壊れた量子ビットは、それを含むすべてのウィンドウを最大値の6に近づけます。
ideal_hw = kicked_ising_reference(N_hw, 1)
width = 6
starts = 1:N_hw - width + 1
window_entropy(rho, w) = -log2(mpo_overlap(segment_mpo(rho, w), segment_mpo(rho, w)))
measured_entropy = [-log2(get_purity(group_hw, collect(j:j + width - 1))) for j in starts]
ideal_entropy = [window_entropy(ideal_hw, j:j + width - 1) for j in starts]
worst = argmax(measured_entropy)
println("S₂ of six-qubit windows: median ", round(median(measured_entropy), digits=2), "; highest ",
    round(measured_entropy[worst], digits=2), " (chain positions ", worst, " to ", worst + width - 1, ")")
println("Ideal state: ", round(minimum(ideal_entropy), digits=2), " to ", round(maximum(ideal_entropy), digits=2))
plot(starts, measured_entropy; marker=:circle, markersize=2, label="measured",
    xlabel="first chain position of the window", ylabel="S₂ of six qubits", ylims=(0, width),
    legend=:topright, size=(800, 280), left_margin=5Plots.mm, bottom_margin=5Plots.mm)
plot!(starts, ideal_entropy; linestyle=:dash, label="ideal state")
S₂ of six-qubit windows: median 0.9
; highest 1.43 (chain positions 30 to 35)
Ideal state: 0.19 to 0.39
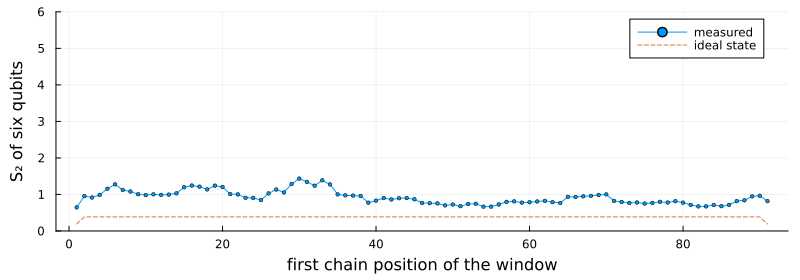
すべてのウィンドウは理想状態よりも約0.5ビットから1ビット多く混合しており、最もノイズの多い範囲は連鎖位置30から35付近です。最大値の6に近いウィンドウはないため、壊れた量子ビットはなく、分析では96量子ビットの連鎖全体を使用します。エントロピーが6に近いウィンドウがあった場合は、それらのウィンドウが共有する量子ビットを取り除き、それを除いた連鎖の最も長い部分を学習します。
同じ純度が、CRMの事前分布も決定します。各ウィンドウについて、fitted_priorは理想状態を取り、論文と同様に、その純度が訓練設定で測定された純度と一致するように、局所脱分極の強さをフィットさせます。
次のセルのlearn_and_validate関数が、残りの分析を実行します。訓練設定からモデルを学習し、連鎖の最初の量子ビットについて、12刻みでテスト設定上のとを推定します。これらは論文の図1(c,d)の量Pです。理想状態は、ベースラインとして同じテストデータで評価されます。
このセルは、で関数を実行し、その後とで繰り返して、学習ウィンドウのサイズがどれだけ重要かを調べます。ボンド次元は最大でもなので、は積状態、つまり量子ビット間の相関がなく、各量子ビットが独立した状態を学習します。
function learn_and_validate(group; ideal, ell=2, k=3, sizes=12:12:group.N, seed=20260921, train_fraction=0.5)
    split = split_settings(group; seed, train_fraction)
    prior = fitted_prior(ideal, split.train)
    marginals = training_marginals(split.train; ell, prior)
    fit = learn_mpo(marginals, group.N; ell, maxbond=min(4, 4^ell), sweeps=20)
    last(fit.history).purity <= 1 ||
        @warn "The model has purity above one, so the fit diverged. Collect more settings or shots."
    statistics = afc_statistics(split.test, k; prior)
    learned = afc_prefix_curve(fit.model, statistics, split.test.NU; k, sizes)
    baseline = afc_prefix_curve(ideal, statistics, split.test.NU; k, sizes)
    model_entropy = [-log2(mpo_overlap(prefix_mpo(fit.model, n), prefix_mpo(fit.model, n))) for n in sizes]
    (; ell, fit, split, learned, baseline, model_entropy)
end

function plot_validation(results, title)
    n = [r.n for r in first(results).learned]
    # Marker, size, and line style per ℓ. The ℓ = 1 squares are small enough to sit inside the
    # ℓ = 2 circles, so both stay visible where the two curves overlap.
    style = Dict(2 => (:circle, 7, :solid), 1 => (:rect, 3.5, :dash), 0 => (:utriangle, 5, :dot))
    fidelity = plot(yscale=:log10, ylims=(1e-6, 1.5), legend=:bottomleft, xlabel="number of qubits N",
        ylabel="held-out F_max", title=title)
    entropy = plot(xlabel="number of qubits N", ylabel="Rényi-2 entropy S₂", legend=:topleft)
    held_out = first(results).learned
    # Draw every error bar before any marker, so the bars stay behind the symbols
    for (color, result) in enumerate(results)
        scatter!(fidelity, n, [r.fidelity for r in result.learned]; yerror=[r.fidelity_sem for r in result.learned],
            markersize=0, markerstrokecolor=color, label="")
    end
    scatter!(entropy, n, [r.entropy for r in held_out]; yerror=[r.entropy_sem for r in held_out],
        markersize=0, markerstrokecolor=:black, label="")
    for (color, result) in enumerate(results)
        marker, markersize, linestyle = style[result.ell]
        label = "learned model, ℓ = $(result.ell)"
        plot!(fidelity, n, [r.fidelity for r in result.learned]; color, marker, markersize, linestyle,
            markerstrokewidth=0, label)
        plot!(entropy, n, result.model_entropy; color, linestyle, linewidth=2, label)
    end
    plot!(fidelity, n, [r.fidelity for r in first(results).baseline]; marker=:diamond, markersize=5,
        linestyle=:dashdot, color=:black, label="ideal state")
    scatter!(entropy, n, [r.entropy for r in held_out]; marker=:circle, markersize=4, color=:black,
        label="held-out AFC estimate")
    plot(fidelity, entropy; layout=(1, 2), size=(1000, 400), left_margin=7Plots.mm, bottom_margin=7Plots.mm)
end

function summarize(result)
    final = last(result.learned)
    println("ℓ = ", result.ell, ", N = ", final.n, ": held-out F_max = ", round(final.fidelity, sigdigits=3), " ± ",
        round(final.fidelity_sem, sigdigits=2), " (ideal state: ", round(last(result.baseline).fidelity, sigdigits=2), ")")
    println("  S₂ = ", round(final.entropy, digits=2), " ± ", round(final.entropy_sem, digits=2),
        " held out; ", round(last(result.model_entropy), digits=2), " from the model")
    lowest = minimum(minimum(eigvals(Hermitian(operator_from_coefficients(local_coefficients(result.fit.model, w)))))
                     for w in unique(learning_windows(final.n, max(result.ell, 1))))
    println("  Most negative eigenvalue in any learning window: ", round(lowest, digits=4))
end

results_hw = [learn_and_validate(group_hw; ideal=ideal_hw, ell) for ell in (2, 1, 0)]
foreach(summarize, results_hw)
plot_validation(results_hw, "ibm_fez, 96-qubit chain")
ℓ = 2
, N = 96: held-out F_max = 0.591 ± 0.1 (ideal state: 0.0035)
  S₂ = 10.04 ± 0.28 held out; 10.21 from the model
  Most negative eigenvalue in any learning window: -0.0523
ℓ = 1, N = 96: held-out F_max = 0.554 ± 0.094 (ideal state: 0.0035)
  S₂ = 10.04 ± 0.28 held out; 10.26 from the model
  Most negative eigenvalue in any learning window: -0.0215
ℓ = 0, N = 96: held-out F_max = 6.18e-6 ± 1.1e-6 (ideal state: 0.0035)
  S₂ = 10.04 ± 0.28 held out; 32.01 from the model
  Most negative eigenvalue in any learning window: 0.0012
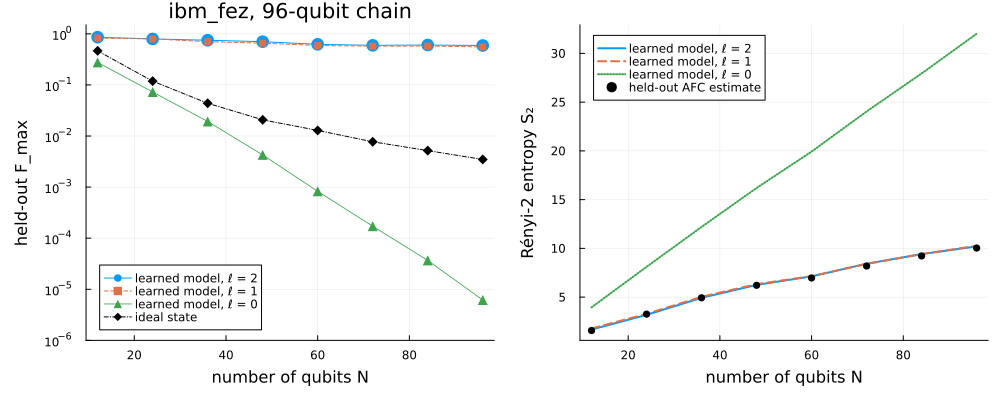
結果は、別のプロセッサー上で論文の両方の主張を再現しています。
-
モデルは、理想状態よりもはるかによくデータを説明します。 において、モデルの保留したは0.59 ± 0.10で、理想状態の0.0035と比べて大きくなっています。論文では
ibm_brisbaneで約0.75と報告されています。 -
モデルのエントロピーは、すべてのでテストデータと一致します。 では、モデルからは10.2、テストデータからは10.0 ± 0.3、つまりで、旧世代の
ibm_brisbaneでの0.14から0.15と比べて小さくなっています。
ウィンドウサイズの比較から、情報がどこにあるかがわかります。でも、モデルはほぼ同程度に良好であり()、これらのデータでは、数量子ビットを超える相関はほとんど寄与しません。では、積状態は隣接する量子ビット間のエンタングルメントを捉えられません。そのエントロピーは10ではなく32まで増加し、は理想状態よりもさらに速く低下して、でになります。
これらの数値を読む際は、次の制限事項に留意してください。
-
訓練の分割。 誤差棒はテストデータの統計誤差のみをカバーします。同じ設定の他のランダムな分割では、のでは0.49から0.59の間になります。
-
最後のスイープ。 学習器は常に最後のスイープのモデルを返すため、テストデータがモデルに影響することはありません。
-
正値性。 モデルは半正定値になるよう制約されていません。学習ウィンドウ内の最も負の固有値は約です。したがって、そのとは、物理的な状態の証明された性質ではなく、演算子を記述するものです。
-
因数分解。 保留したすべての推定値はAFCの仮定に依存しており、測定自体ではそれを証明できません。
次のステップ
-
その深さに対する論文のパラメーター(、最大ボンド次元8)を使って、深さ2で実験を繰り返し、学習器が必要とする測定設定の数を調べてください。
-
代わりに2サイト更新(
training_marginalsとlearn_mpoのupdate=:two_site)で学習します。これは各ステップの後でボンド次元を切り詰めます。訓練設定が少ない場合にどのように動作するかを確認してください。 -
CRMの事前分布なし(
prior=nothing)で学習し、保留したフィデリティを比較してください。 -
同じ分析を、著者らが公開している
ibm_brisbaneの測定データに適用してください。 -
更新とAFC推定量の導出については、論文の補遺を読んでください。
-
RandomMeas.jlの例で、他のランダム化測定プロトコルを探索してください。
参考文献
-
M. Votto, M. Ljubotina, C. Lancien, J. I. Cirac, P. Zoller, M. Serbyn, L. Piroli, and B. Vermersch, "Learning mixed quantum states in large-scale experiments", Phys. Rev. Lett. 136, 090801 (2026). arXiv:2507.12550
-
A. Elben, S. T. Flammia, H.-Y. Huang, R. Kueng, J. Preskill, B. Vermersch, and P. Zoller, "The randomized measurement toolbox", Nat. Rev. Phys. 5, 9 (2023). arXiv:2203.11374
-
H.-Y. Huang, R. Kueng, and J. Preskill, "Predicting many properties of a quantum system from very few measurements", Nat. Phys. 16, 1050 (2020). arXiv:2002.08953
-
A. Elben and B. Vermersch, "RandomMeas.jl: A Julia package for randomized measurements in quantum devices", Quantum 10, 2086 (2026). arXiv:2509.12749
-
B. Vermersch, A. Rath, B. Sundar, C. Branciard, J. Preskill, and A. Elben, "Enhanced estimation of quantum properties with common randomized measurements", PRX Quantum 5, 010352 (2024). arXiv:2304.12292
-
H. Zou, "Randomized measurements of a 96-qubit kicked-Ising state on ibm_fez", Zenodo (2026). doi:10.5281/zenodo.24116174