ノイズと誤り
このレッスンでは、量子ノイズと誤りについて、その多くの原因を含めて紹介し、古典的な誤りとの類似点を示します。発生しうる誤りの種類を理解し、量子チャネルを使ってノイズをモデル化できるようになることは、今後のレッスンを理解するうえで重要です。実際、ほとんどの誤り処理の手法は、削減または訂正しようとするノイズや誤りの種類についてある程度の知識を必要とします。
この動画では、ノイズと誤りの概要を説明し、いくつかの計算結果を紹介します。以下の文章ではさらに詳細を説明し、Qiskitを使っていくつかの種類の誤りを見ていきます。
原因
古典的なノイズと誤り
量子の誤りとノイズを理解するために、まず古典的な類似物から始めましょう。古典コンピュータでは、意図しない電荷蓄積の複数のメカニズム、単発事象アップセット、材料の緩やかな劣化など、さまざまな理由で誤りが発生します。これらのメカニズムの一部(すべてではありません)は量子コンピューティングにも類似物があり、量子の誤りとノイズを理解するうえで役立ちます。ここではそのいくつかを簡単に振り返ってから、量子における類似物に話を進めます。
熱ノイズ:
コンピュータの構成部品が加熱されると、原子や電荷キャリアの熱運動によって材料の抵抗率が変化します(通常は増加します)。これは回路内の抵抗が変動しうることを意味します。まれではありますが、これによりトランジスタで意図しない論理遷移が発生することがあります。わずかな変動は避けられませんが、これらの影響を回避するには構成部品を適切に冷却することが重要です。
熱による損傷と劣化:
材料の加熱と冷却が繰り返されると、導電性元素(金属)の非常にゆっくりとした移動が生じることがあります。良くても、これにより回路要素の抵抗やキャパシタンス(あるいはその両方)が変化し、回路動作のタイミングが不正確になります。最悪の場合は、短絡や重大な故障に至ります。ここでも、この種の劣化を防ぐには適切な温度管理が重要です。
放射線誘起効果(単発事象アップセット、SEU):
高エネルギー粒子がプロセッサ内の原子を電離させ、意図しない電荷を生じさせることがあります。それが誤ったタイミングと場所で起こると、論理誤りにつながる可能性があります。こうした高エネルギー粒子(電磁放射線や中性子を含む)の発生源は、通常、上層大気での高エネルギー相互作用です。そのため、これらのアップセットは宇宙を含む高高度環境でより多く発生します。これらは誤り訂正符号や耐放射線設計によって対処されます。
電磁干渉:
誤りは、スイッチング電源ライン、無線送信機、その他のシステム構成部品からの外部電磁(EM)場によっても引き起こされることがあります。これは前述の高エネルギー放射線とは異なる現象です。ここでは、時間変化する迷走EM場が計算部品全体に電流と電圧を誘起します(1回の事象で特定の原子を電離させるのとは対照的です)。誘起電圧は場の時間依存性によって決まるため、この種の干渉は高周波システムにおいて特に重要です。これらの誤りは、シールドや接地などによって対処できます。
配線間のクロストーク:
特にナノスケールの集積回路において、隣接する導体間の容量性または誘導性結合により、意図しない信号が生じることがあります。これは電磁干渉と関連していますが、問題となる場の発生源がコンピュータ回路内の別の構成部品である点が異なります。非常に近接した2本の配線を考えてみましょう。配線Aに急激な遷移(電圧の変化)が生じると、隣接する配線Bに電流を誘起することがあります。正確な方向と大きさは回路レイアウトに依存し、電荷の一貫した正味の流れになることもあれば、電荷の渦電流に近いものになることもあります。しかし、場合によってはこれが望ましくない論理遷移につながることがあります。こうしたクロストーク効果は、最適なレイアウト間隔、シールド、信号の立ち上がり時間の制御によって軽減できます。
これは完全なリストではありませんが、量子コンピューティングとの類似点を見出し始めるには十分です。上記のすべての種類の意図しない相互作用において、ノイズが論理誤りとして現れる形は、0が1になるか、1が0になるかのいずれかしかない点に注意してください。これは古典ビットの状態空間で許されるすべてです。
量子ノイズと誤り
量子コンピューティングでは、ノイズと誤りはしばしば一緒に議論されますが、両者の違いを認識することが重要です。量子ノイズとは、量子ビットや量子システムに影響を与える根本的な物理的擾乱を指します。これには、環境からの意図しない相互作用や揺らぎ、不完全な制御、あるいはハードウェアの欠陥など、量子状態を理想からずらしてしまうあらゆる形態が含まれます。量子誤りとは、量子ノイズの結果として生じる量子情報の具体的なずれや不具合のことです。量子誤りは、測定や操作の上で観測されるノイズの現れであり、ビット反転、位相反転、振幅減衰などが含まれます。 ノイズと誤りはどちらも連続的な形で生じることがあります。例えば、量子ゲートに使われる場が0.1%、0.15%、あるいは任意の割合だけずれることがあります。これにより、量子ビットの位相も同様に任意の連続量だけ不正確になることがあります。しかし、実際には、特に誤り訂正においては、誤りをあたかも離散的であるかのように扱うのが一般的です。つまり、蓄積された影響を離散的なビット反転や単一の位相回転にまとめてしまうのです。これは誤りの訂正や特性評価には有用ですが、量子ビットに対するノイズの影響が単に離散的な誤りの集合であることを意味するわけではありません。
量子コンピュータに影響を与えるノイズには多くの種類があります。複数の種類の誤りを引き起こすものもあれば、特定の誤りの現れと対応しているものもあります。完全なリストはこのレッスンの目的を超えますが、以下はこのコースの残りの部分に関連する部分的なリストであり、いくつかは古典コンピューティングのノイズと類似しています。
Thermal:
量子ビットの2つの計算基底状態 と は、非常に小さなエネルギーによって隔てられています。正確な値はもちろん量子ハードウェアに依存します。IBM Quantum®が使用しているような固体(固定周波数トランズモン)量子ビットの場合、これらの状態間のエネルギーギャップはおよそ J、つまり数マイクロ電子ボルトのオーダーです。このエネルギースケールは、を通じて周波数に関連付けたり、特徴的な温度に関連付けたりできます。温度は試料内の粒子の平均運動エネルギーと関係しているため、ボルツマン定数を使って、平均的な粒子が遷移を起こすのに十分なエネルギーを持つ温度の推定値を求めることができます。
熱的相互作用によって量子ビットの計算基底状態間で遷移が生じる可能性を減らすためには、量子ビットの温度を100 mKよりも大幅に低く、できれば15-25 mKに近い温度に維持する必要があります。これらの閾値を大きく超える温度上昇があると、状態の占有が完全にランダムになり、量子情報が完全に失われることになります。
これは、両者とも熱に起因するという点で、古典コンピュータで発生しうる熱誤りと類似しています — しかし、温度スケールは明らかに異なり、情報損失のメカニズムも異なります。
クロストークと干渉:
量子コンピューティングにおけるクロストークとは、ある量子ビットを対象とした操作や信号が、意図せず他の量子ビットに影響を与えてしまうような、量子ビットや制御ラインの間の意図しない結合や干渉を指します。これは、本来は独立しているはずの量子ビット間の誤りや相関として現れます。
IBM®が使用しているような超伝導量子ビットアーキテクチャでは、クロストークは、マイクロ波制御信号が隣接する量子ビットに漏れ込むこと、読み出し共振器間の意図しない結合、または量子ビットループ間の磁束クロストークなどから生じることがあります。
クロストークを最小限に抑えるための多くのアプローチは、量子ビットの間隔や隣接する量子ビットの動作周波数を異なるものにするなど、量子コンピュータの設計に組み込まれています。クロストーク誤りを軽減するソフトウェア的なアプローチもあり、これは後のレッスンで扱います。
不完全なゲート操作:
量子ビットに対する操作は、有限の精度を持ち、ノイズやその他の不正確さの原因の影響を受けうるハードウェアを使って実行されます。特に、回転ゲートを実装するために、特定の持続時間と特定の向きを持つマイクロ波パルスが使用されます。例えば、あるマイクロ波パルスが軸周りに0.30ラジアン回転させるものだとします。向きには有限の精度しかないため、回転軸にはある程度の不正確さが生じます。さらに、パルスの周波数とその持続時間の間には常に本質的なトレードオフがあります。非常に長いパルスは、実質的に単一の周波数を持つ正弦波的な振る舞いをします。短いパケットを形成するには、多数の周波数の重ね合わせが必要です。これは、エネルギー・時間の不確定性関係の根底にあるのと同じトレードオフですが、ゲートの精度はまだこれらの基本的な限界に迫ってはおらず、改善の余地があります。
量子固有のノイズ:
この最後の種類のノイズは他とはかなり異なります。これは誤りによるものではなく、量子力学の性質によるものです。量子状態にある量子ビットが測定され、固有状態(または)に収縮するとします。固定周波数トランズモン系では、量子ビットは、その共振周波数が量子ビットの状態にわずかに依存するマイクロ波共振器に分散的に結合しています。マイクロ波プローブパルスが共振器を通して送られ、出力信号は状態に依存した位相シフトと振幅変化を獲得します。この信号はその後、古典的な電子機器を使って増幅・測定されます。
量子レベルでは、測定信号は有限の平均光子数を持つコヒーレントなマイクロ波場によって運ばれます。電磁場の量子的性質のため、場の直交位相成分は本質的な揺らぎを示します。これらの揺らぎは技術的な不完全さとは無関係であり、理想的なコヒーレント状態であっても生じます。平均光子数を増やすと測定信号は大きくなりますが、基本的なノイズレベルは有限のままであるため、結果間の識別性はとしてしか改善しません。
したがって、量子ビットが完璧に準備され、測定チェーンが理想的であったとしても、ある量子ビット状態に対応する読み出し信号は単一の固定値ではなく、結果をどれだけ識別できるかを制限する分布になります。この重なりは、測定プロセス自体に内在する不確実性の根本的な原因を表しています。実際には、増幅器などの構成部品からの技術的ノイズが支配的であることが多いものの、この本質的な量子ノイズが読み出し忠実度の下限を定めています。
不確実性は誤りではない:
これらのノイズの原因は、いずれも量子状態の測定に伴う根本的な不確実性とは異なります。対比のために、次のような量子状態にある量子ビットがあるとしましょう。
この状態は、64%の確率で状態として測定され、36%の確率で状態として測定されます。しかし、1回の測定ではかのどちらかしか得られません — そのため、1回の測定だけでは測定前の状態についてほとんど何も分かりません。状態について詳細な情報を得るには、多くの測定が必要です。10回の測定のうち、6回か7回はになると予想されるかもしれません。しかし、最初の10回の測定がすべてたまたまになったとしても、それほど驚くべきことではありません(公平なコインを投げて10回連続で「表」が出るようなもので、珍しいことではありますが、十分にあり得ることです)。もし測定を1000回繰り返して常にが得られたとしたら、それは確かに驚くべきことでしょう。
したがって、有限回の測定に基づく量子状態についての私たちの知識には不確実性があります。測定を繰り返すにつれて、測定前の量子状態についての知識は向上しますが、決して完璧にはなりません。口語的には、あらゆる量子測定結果には常に何らかの根底にある「誤り」があると言えるかもしれません。しかし、これは「誤り」という言葉の異なる使い方であり、統計的不確実性と表現する方が適切です。多くの測定を通じて量子状態についての知識を高めていくプロセスは、量子状態トモグラフィーと呼ばれます。ただし、量子状態トモグラフィーはZ軸に沿った測定に限定されるものではなく、一般には振幅と相対位相を決定するために(X、Y、Zのような)直交する軸に沿った測定を指します。このプロセスについて詳しくは、John WatrousによるGeneral Formulation of Quantum Informationコースのこのセクションを参照するか、実践的な実装についてはUtility-Scale Quantum Computingコースのこのテレポーテーションのレッスンを参照してください。
誤りとその蓄積の観察
このセクションでは、実際の量子コンピュータを使って、さまざまな条件下での量子誤りとその蓄積を観察します。実際には、多くの量子誤りの原因が同時に存在するのが通常です。異なる種類の誤りをある程度分離した形で観察するためには、その分離のために設計された回路を使用する必要があります。量子コンピューティングの応用で使われる回路は、はるかに複雑に見えるでしょう。
まずはエネルギー緩和誤りから始めましょう。
エネルギー緩和()誤り
熱ノイズについての議論を思い出すと、ゼロでない温度では、量子系がエネルギー固有状態間で遷移する確率が常に存在します。緩和()は自然放出によって駆動される(温度に依存しない)ため支配的であり、一方で低温は競合する励起過程を抑制します。量子ビットがアイドル状態でいる時間が長いほど、そのような遷移を起こす時間が長くなります。状態に準備された量子ビットが、時間後ものままである確率は次式で与えられます。
ここで、時間は実験的に決定される特性時間であり、量子ビットごとに異なり、時間とともにわずかに変化することさえあります。IBM®の量子コンピュータは定期的にベンチマークされているため、IBMの量子コンピュータの量子ビットについて掲載されているの値は正確で最新のものであるはずです。の値が大きいということは、量子ビットが準備された状態に(平均して)より長く留まることを意味します。典型的なの値はアーキテクチャによって異なりますが、IBMの量子コンピュータの量子ビットのは多くの場合200-300 のオーダーであり、最新の値はCompute resourcesページで確認できます。
特性時間は異なるものを測定します。それは位相情報の損失です。これについては後で改めて取り上げます。
エネルギー緩和誤りを観察するために、量子ビットを状態に準備し、意図的に長時間アイドル状態のままにしておきます。これが人為的な部分です。実際の量子ワークフローでは、他の量子ビットで処理が行われている間、一部の量子ビットが長時間アイドル状態になることがあります。したがって、そのようなアイドル時間の例がいくつかあること自体は人為的ではありません。
まず、いくつかのパッケージをインポートし、最も空いているバックエンドを選択することから始めましょう。
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"cycler": "cycler", "matplotlib": "matplotlib", "numpy": "numpy", "qiskit": "qiskit", "qiskit_aer": "qiskit-aer", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit_ibm_runtime import QiskitRuntimeService
import numpy as np
import matplotlib.pyplot as plt

# If your credentials are already saved locally
service = QiskitRuntimeService()

# To load an unsaved instance, uncomment the line below
# service = QiskitRuntimeService(channel = "ibm_quantum_platform", instance = "your crn here")

# To select the least-busy backend:
# backend = service.least_busy(simulator=False, operational=True)

# To specify the backend by name:
backend = service.backend("ibm_boston")

props = backend.properties()
print(backend)
<IBMBackend('ibm_boston')>
次に、作業する量子ビットを選択します。ここでは量子ビット0を選びます。この量子ビットのプロパティを、やを含めて直接インポートできます。
qubit_idx = 0
qubit_props = props.qubit_property(qubit_idx)

t1 = qubit_props["T1"][0]  # * 1e6  # Convert seconds to µs
t2 = qubit_props["T2"][0]  # * 1e6  # Convert seconds to µs

# print(f"Qubit {qubit_idx}: T1={t1} µs, T2={t2} µs")
print(f"Qubit {qubit_idx}: T1={t1} s, T2={t2} s")
Qubit 0: T1=0.0002737016180018049 s, T2=0.00042784777605680494 s
をマイクロ秒単位で知ることは重要ですが、それが何を意味するのか直感的にはつかみにくいかもしれません。結局のところ、量子コンピュータ上のゲート操作は非常に高速です。本当に重要な問いは、その時間の中で量子コンピュータでどれだけのことができるか、ということです。そのためには、を量子コンピューティングで使われる他の時間スケール — 具体的には以下のもの — と関連付けると役立ちます。
-
サンプリング時間 - 量子コンピュータ上で制御プロセスを実装できる最小のクロックティック。
-
単一量子ビットゲート時間 - 1つの量子ビットにゲート操作を実装するのに必要な時間。これは単一の値ではなく、ゲートの種類によって変わる範囲の数値になります。
-
2量子ビットゲート時間 - 隣接する2つの量子ビットにゲート操作を実装するのに必要な時間。これも一定の範囲の値をとりますが、通常は単一量子ビットゲートよりも1桁程度長くなります。
バックエンドのを確認し、ゲート時間について妥当な範囲を表示してみましょう。
print(f"Using backend: {backend.name}")

# Access the backend target
target = backend.target

def get_gate_times(target, gate_name):
    results = []

    if gate_name not in target:
        return results  # gate not supported

    # target[gate_name] is a dict: {(qubits): InstructionProperties}
    for qubits, props in target[gate_name].items():
        if props.duration is not None:
            results.append({"qubits": qubits, "duration_ns": props.duration * 1e9})

    return results

# Query some gates
for gate in ["cz", "x"]:
    times = get_gate_times(target, gate)

    print(f"\nGate: {gate}")
    if times:
        for entry in times[:5]:
            print(f"  Qubits {entry['qubits']}: {entry['duration_ns']:.2f} ns")
    else:
        print("  Not available on this backend")
Using backend: ibm_boston

Gate: cz
  Qubits (0, 1): 68.00 ns
  Qubits (1, 0): 68.00 ns
  Qubits (1, 2): 68.00 ns
  Qubits (2, 1): 68.00 ns
  Qubits (2, 3): 88.00 ns

Gate: x
  Qubits (0,): 32.00 ns
  Qubits (1,): 32.00 ns
  Qubits (2,): 32.00 ns
  Qubits (3,): 32.00 ns
  Qubits (4,): 32.00 ns
これらのゲート時間はバックエンドによって異なります。ここでは、ibm_bostonから得られた68 nsという2量子ビットゲート時間をハードコードします。
dt = backend.configuration().dt
two_q_gate_time = 68e-9
print("The sampling time is : ", dt)
print("dts per T_1 : ", t1 / dt)
print("2-qubit characteristic time : ", two_q_gate_time)
print("The sampling time intervals per two-qubit gate : ", two_q_gate_time / dt)
print("2-qubit gates per T_1 : ", t1 / two_q_gate_time)
The sampling time is :  4e-09
dts per T_1 :  68425.40450045122
2-qubit characteristic time :  6.8e-08
The sampling time intervals per two-qubit gate :  17.0
2-qubit gates per T_1 :  4025.0237941441897
ここでは、他の誤りの原因やその抑制・軽減については一切考慮していないことに注意してください。誤りは量子システムで働いている唯一の誤りではないため、これらの数値についてあまり神経質にならないでください。これは単に、何の抑制もない場合、誤りが支配的になり始めるまでに、おおよそ数千個のオーダーの2量子ビットゲートを実装できる可能性がある、ということを意味します。他の誤りは通常はるかに浅い深さで支配的になり、逆に誤りは、信号を完全に消してしまうのに必要な時間よりもはるかに短い時間でも、抑制する価値がある場合があります。
まず、ノイズモデルを備えたシミュレータを使用し、その後、結果を実機のハードウェアと比較します。
from qiskit_aer import AerSimulator
from qiskit_aer.noise import NoiseModel, thermal_relaxation_error
from qiskit import QuantumCircuit
from qiskit.quantum_info import Pauli
from qiskit.transpiler import generate_preset_pass_manager
from qiskit_aer.primitives import EstimatorV2

pass_manager = generate_preset_pass_manager(backend=backend, optimization_level=0)
2量子ビットゲート時間の上限側の見積もりに対応する測定用のタイムステップを定義しましょう。次に、そのタイムステップの刻みで50個の回路を構築します。こうすることで、80個の2量子ビットゲートを実装するのと同程度の時間スケールで何が起こるかを見ることができます。ここでは精度は重要ではないため、少数のショットのみを使用します。
n_points = 50  # We will show 50 steps
delay_unit = 80  # The delay in units of two-qubit-time from above
shots = 100
熱緩和誤りを明示的に含むノイズモデルをシミュレータ用に構築します。
# Create noise model with thermal relaxation for delays
noise_model = NoiseModel()
error = thermal_relaxation_error(
    t1, t2, two_q_gate_time * delay_unit
)  # error model characterized by times in ns
noise_model.add_all_qubit_quantum_error(error, ["delay"])

sim = AerSimulator(noise_model=noise_model)
次に、回路とオブザーバブルを構築します。これらは非常にシンプルです。回路は単純に、量子ビットをに準備し、上で定義した特性ゲート時間とを使って、徐々に長くなる遅延を実装するだけです。オブザーバブルは単純にとします。知りたいのは、量子ビットがのままであるか、に減衰したかだからです。シミュレータにはトランスパイルが必ずしも必要というわけではありませんが、後で実機のバックエンドで使用するために、ここで回路をトランスパイルしておきます。
observables = [Pauli("Z")] * n_points
circuits = []
obs = []
delay_times_sim = []
for i in range(n_points):
    qc = QuantumCircuit(1, 1)
    qc.x(0)
    if i > 0:
        for j in range(i):
            qc.delay(delay_unit * two_q_gate_time, 0, "s")
            j = j + 1
    qc_opt = pass_manager.run(qc)
    circuits.append(qc_opt)
    delay_times_sim.append(delay_unit * two_q_gate_time * i)
    observables_isa = observables[i].apply_layout(layout=qc_opt.layout)
    obs.append(observables_isa)
シミュレータを使ってジョブを実行します。
pubs = list(zip(circuits, obs))

# Create AerSimulator with noise model as backend
simulator = AerSimulator(noise_model=noise_model)

# Create SamplerV2 from the AerSimulator backend
estimator = EstimatorV2.from_backend(simulator)

# Run the sampler on the circuit, specify shots
job = estimator.run(pubs)
result = job.result()
最後に、出力をプロットします。
# Optional: color palette similar to 'mpl', style = 'clifford'

from cycler import cycler

plt.rcParams["axes.prop_cycle"] = cycler(
    color=[
        "#4C78A8",  # muted blue
        "#72B7B2",  # teal
        "#54A24B",  # green
        "#9C89CC",  # purple
        "#B279A2",  # mauve
    ]
)

# Everything else stays at Matplotlib defaults

# Example data: assume result is a list of objects with structure result[i].data.evs.item()
# and delay_times is already defined as a list of floats.

# Extract y-values
y_sim_values = [(1 - r.data.evs.item()) / 2 for r in result]

# Use delay_times as x-values
x_sim_values = delay_times_sim

# Create the plot
plt.figure(figsize=(8, 5))
plt.plot(x_sim_values, y_sim_values, marker="o", linestyle="-", label="EV Data")

plt.xlabel("Idle Time (s)")
plt.ylabel("Probability of measuring |1>")
plt.title("T1 Decay")
plt.grid(True)
plt.show()
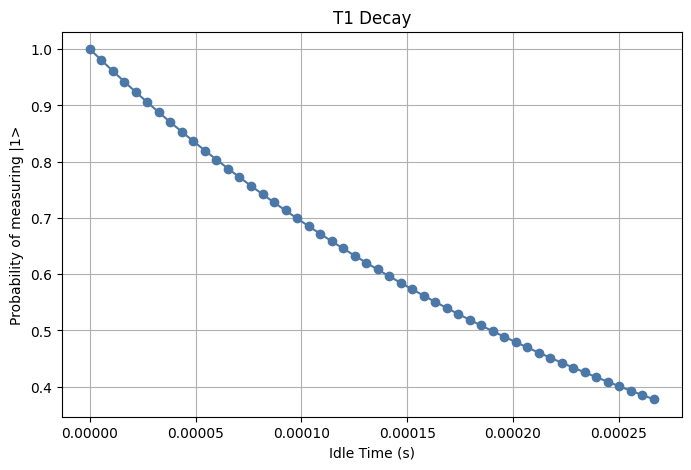
指数関数的減衰がはっきりと確認でき、この時間でにある確率は40%弱まで減衰します。これはモデルと正確に一致していることに注意してください。 において、最大のをと同程度のオーダーに選んでいます。がおよそ60ゲート(あるいはそのオーダー)に相当すると述べたことを思い出してください。ここでは60ゲートに相当します。したがって
それでは、同じ回路を実際の量子コンピュータで実行してみましょう。同じ遅延時間の範囲をより少ないジョブでカバーするために、遅延の単位を大きくし、点の数を減らします。
# This took 27 s on ibm_boston

from qiskit_ibm_runtime import EstimatorV2

# Explicitly use a pass manager with optimization level 0 so that we don't remove the delays
pass_manager = generate_preset_pass_manager(backend=backend, optimization_level=0)

# Use the same time parameters and shots
n_points = 10
delay_unit = 400
shots = 100

# Measure Pauli Z's as your observables
observables = [Pauli("Z")] * n_points
circuits = []
obs = []
delay_times = []
for i in range(n_points):
    qc = QuantumCircuit(1, 1)
    qc.x(0)
    if i > 0:
        qc.delay(delay_unit * two_q_gate_time * i, 0, "s")
    qc_opt = pass_manager.run(qc)
    circuits.append(qc_opt)
    delay_times.append(delay_unit * two_q_gate_time * i)
    observables_isa = observables[i].apply_layout(layout=qc_opt.layout)
    obs.append(observables_isa)

pubs = list(zip(circuits, obs))
estimator = EstimatorV2(mode=backend)
job = estimator.run(pubs=pubs)
result = job.result()

# To print the job id for later retrieval of data
# job_id = job.job_id()
# print(f"Job ID: {job_id}")
ここで結果をプロットします。
fig, ax = plt.subplots()

# Convert from the expectation value of Z to the probability of a transition
y_real_values = [(1 - r.data.evs.item()) / 2 for r in result]

# Use delay_times as x-values
x_real_values = delay_times

# Exponential decay to match theoretical model
t_smooth = np.linspace(0, x_sim_values[19], 100)  # Smooth x-range covering your data
y_decay = np.exp(-t_smooth / (t1))  # y = exp(-t/t1)
ax.plot(t_smooth, y_decay, "k--", linewidth=1, label=f"Perfect Decay (t1={t1:3f} s)")

# Add simulator values
ax.scatter(x_sim_values, y_sim_values, label="Simulator", alpha=0.7)

# Add real QC values
ax.scatter(x_real_values, y_real_values, label="Real", alpha=0.7)

# Add labels and plot
ax.set_xlabel("Idle Time (s)")
ax.set_ylabel("Probability of measuring |1>")
ax.legend()
ax.set_title("T1 Decay")
ax.grid(True)

plt.show()
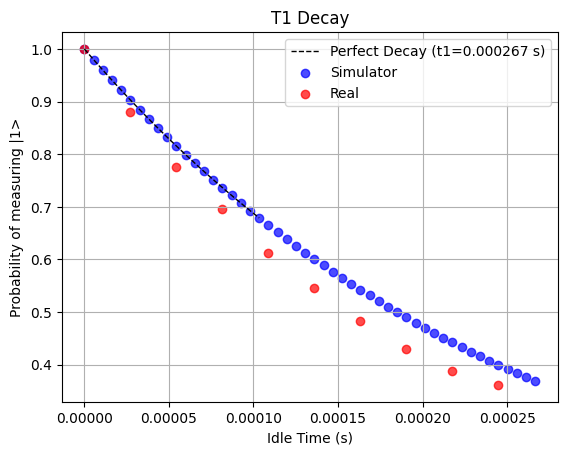
見てわかるように、状態の時間経過に伴う減衰は理論(およびの定義)と一致しています。さらに、この場合、シミュレータは実機の量子コンピュータの挙動をかなりよく再現しています。この状態の減衰について留意すべき点がいくつかあります。
- 私たちは人為的に、非現実的なほど長い時間、測定を遅らせました。これらの遅延は、数千個の2量子ビットゲートから構成されうる非常に深い回路のタイムスケールに相当します。これは、熱ノイズの影響が存在することを示すためだけに行いました。実世界の問題に適用される実際の回路では、一握りの量子ビットがエネルギー緩和誤りが問題になるほど長くアイドル状態になっている間に、他の量子ビットでは操作が行われているでしょう — ただし、完全なに達する前に他の誤りが支配的になるでしょう。
- 誤り軽減や抑制の手法は一切使用していません。このコースで学ぶ手法を使うことで、この減衰曲線を変化させることができます。
- ここでは100ショットしか使用しておらず、これは通常よりかなり少ない数ですが、それはこの効果が存在することを示すことだけを目的としていたためです。実際の応用では1,000ショットを超える数を使用することになるでしょう。
この最初の誤りの可視化では、遅延(を準備するために使用した1つのXゲートを除く)以外のゲートはほとんど必要ありませんでした。次は、ゲート誤りに焦点を当てた別の例を見てみましょう。
ゲート誤りとその蓄積
量子ゲート、例えばゲートを適用すると、理論上そのゲートはブロッホ球上で軸を中心に角度ラジアンだけ量子状態を回転させ、をへ次のように写像します。
しかし、実際のゲートは不完全です。向きがわずかにずれている場合(X軸を中心とした完全な回転にならない)や、意図したよりもわずかに大きい、または小さい回転を引き起こす場合があります。ゲートの誤差を、小さな角度による純粋な過回転・過小回転としてモデル化してみましょう。
不完全なゲートが何度も適用されると、小さな誤差が蓄積することがあります。場合によっては、これらの複数の誤差が毎回同じ方向に状態をシフトさせることもあります(この現象は「コヒーレント蓄積」と呼ばれ、後述します)。それでは、実際のXゲートを量子ビットに何度も適用するとどうなるか見てみましょう。
# This took 78 s on penguino1

from qiskit_ibm_runtime import EstimatorV2

# Explicitly use a pass manager with optimization level 0 so that we don't remove the delays
pass_manager = generate_preset_pass_manager(backend=backend, optimization_level=0)

# Use the same bit flips
max_depth = 60
circuits = []
observables = []

for depth in range(max_depth + 1):
    qc = QuantumCircuit(1)
    # Repeat flipping back and forth depth times
    for _ in range(depth):
        #    qc.x(0)
        qc.x(0)
        qc.barrier()
        qc.x(0)
        qc.barrier()
    circuits.append(qc)
    observables.append(Pauli("Z"))

pubs = list(zip(circuits, observables))

estimator = EstimatorV2(mode=backend)
results = estimator.run(pubs=pubs).result()
real_expectations = [pub_res.data.evs for pub_res in results]
# from qiskit_ibm_runtime import QiskitRuntimeService

# service = QiskitRuntimeService()           # uses stored IBM Quantum account
# job_id = "d5immof67pic7386l8eg"

# job = service.job(job_id)                 # retrieve the job
# results = job.result()                        # this is your .result() object
# Convert from the expectation value of Z to the probability of a transition
# y_real_values = [(1-r.data.evs.item())/2 for r in results]

# Create the plot
plt.figure(figsize=(8, 5))
# plt.plot(range(max_depth + 1), y_real_values, 'o-')
# plt.plot(x_real_values, y_real_values, marker='o', linestyle='-', color='blue', label='EV Data')
plt.plot(
    range(max_depth + 1),
    real_expectations,
    marker="o",
    linestyle="-",
    color="blue",
    label="EV Data",
)

plt.xlabel("Number of Flip-Back Cycles")
plt.ylabel("Expectation ⟨Z⟩")
plt.title("Accumulated Gate Noise Effects on Flips")
plt.grid(True)
plt.show()
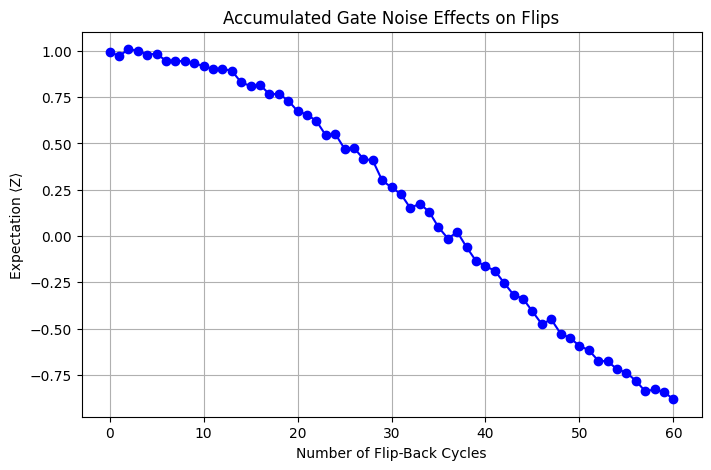
期待値は予想通り1.0付近から始まり、減衰していきますが、単にゼロに減衰するだけではありません。負の値になるのです。もしこれが熱雑音やランダムな相互作用によるものであれば、がよりも測定されやすくなることはないはずです。この誤差は明らかに異なるものです。そして、これは私たちの過回転・過小回転の議論の文脈で理にかなっています。もし本来打ち消し合うはずの各回転のペアが実際には小さな角度だけ余分に回転してしまう場合、そのような繰り返しが多く発生すると、状態はからへとゆっくり回転していくことになります。
ここで示した誤差の蓄積は、実際のワークフローではこれほどきれいには進まない可能性が高いです。まず、私たちはエラー緩和を明示的に無効にし、誤差がコヒーレントに蓄積するように、同じ繰り返しのゲート列を実行しました。これは、こうした誤差が存在することを示すためだけに行われたものです。ノイズ処理技術(例えばPauliツイリング)を用いる場合、誤差の蓄積の仕方に影響を与えることができ、多くの場合、全体としてより小さな誤差を得られます。
この誤差モデルが実験データにどれだけよく適合するかを、明示的にノイズモデルを構築しシミュレータを使うことで正確に確認できます。以下のモデルでは、0.025ラジアンに相当する誤差を明示的に組み込んでいます。これは特別な意味を持つ数字ではなく、実験を適切に説明できるまで単純に誤差を調整すればよいのです。
from qiskit_aer.noise import NoiseModel, coherent_unitary_error
from qiskit_aer import AerSimulator
import numpy as np

# For your SINGLE-QUBIT test on qubit 0, just override X error specifically
noise_model = NoiseModel.from_backend(backend, gate_error=True, thermal_relaxation=True)

theta_error = 0.025  # model over-rotation error around 0.01-0.03 radians
U_over = np.array(
    [
        [np.cos(theta_error / 2), -1j * np.sin(theta_error / 2)],
        [-1j * np.sin(theta_error / 2), np.cos(theta_error / 2)],
    ]
)

unitary_error = coherent_unitary_error(U_over)
# Target ONLY qubit 0 (your circuit) - no warning!
noise_model.add_quantum_error(unitary_error, ["x"], [0])

simulator = AerSimulator(noise_model=noise_model)
WARNING: quantum error already exists for instruction "x" on qubits (0,) , appending additional error.
max_depth = 60
circuits = []
observables = []

for depth in range(max_depth + 1):
    qc = QuantumCircuit(1)
    # Repeat flipping back and forth depth times
    for _ in range(depth):
        #    qc.x(0)
        qc.x(0)
        qc.barrier()
        qc.x(0)
        qc.barrier()
    circuits.append(qc)
    observables.append(Pauli("Z"))

pubs = list(zip(circuits, observables))

estimator = EstimatorV2.from_backend(simulator)
results = estimator.run(pubs).result()
expectations = [pub_res.data.evs for pub_res in results]  # no [0], use value directly
それでは、実際の曲線とシミュレーションの曲線を一緒にプロットしてみましょう。
fig, ax = plt.subplots()

# Add simulator values
ax.scatter(range(max_depth + 1), expectations, c="blue", label="Simulator", alpha=0.7)

# Add real QC values
ax.scatter(range(max_depth + 1), real_expectations, c="red", label="Real", alpha=0.7)

# Add labels and plot
ax.set_xlabel("Number of Flip-Back Cycles")
ax.set_ylabel("Expectation ⟨Z⟩")
ax.set_title("Accumulated Gate Noise Effects on Flips")
ax.legend()
ax.grid(True)

plt.show()
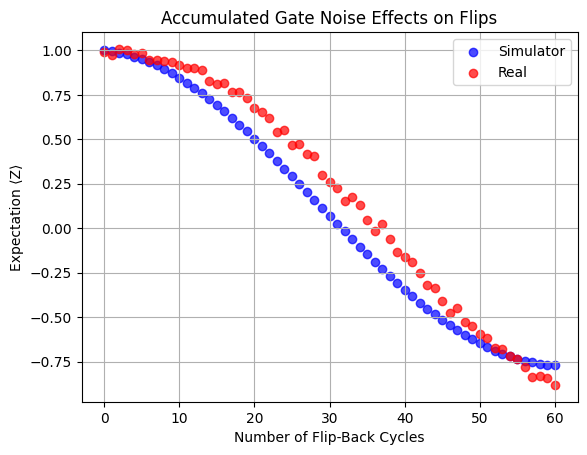
実際の回路における誤差は、過回転・過小回転誤差モデルによってかなりよく説明されました。明らかに、異なる種類のノイズや誤差は異なる形で蓄積し、量子回路の忠実度に大きく異なる影響を及ぼします。したがって、これまで以上に、発生し得る誤差をより形式的に分類し特徴づけることが非常に重要になります。
量子誤差の特徴づけ
これまでに量子ノイズの発生源のいくつかを説明してきましたが、それらを引き起こすノイズのカテゴリーに従って誤差を分類することもできます。しかし、誤り訂正やエラー緩和において有用な量子誤差のカテゴリーには、他にもさまざまなものがあり得ます。例えば、誤差を訂正したり緩和したりしたいのであれば、誤差がどの時点で発生し、どのように蓄積するのかを知る必要があります。誤差がどこで(どのプロセスで)発生するかを特定する上で重要な一般的カテゴリーの一つが、状態準備と測定の誤差(略してSPAM誤差)です。ここで言う「状態準備」とは、測定のために状態を準備するために行われるすべてのことを意味するわけではありません。むしろ、量子ビットの初期化、すなわちアルゴリズム実行のための量子ビットの「準備」を指しており、したがってこのSPAMというカテゴリーには、アルゴリズム実行中のゲート誤差のようなものは含まれません。
もう一つの重要な区別は、誤差がコヒーレントであるかインコヒーレントであるかです。簡単にまとめると(詳しくは後述します)、コヒーレント誤差は通常ユニタリ演算としてモデル化され、状態の純粋性を保ちます。インコヒーレント誤差は非ユニタリな量子チャネルとしてモデル化され、一般に状態の純粋性を低下させます。インコヒーレント誤差は、量子情報の損失を引き起こす熱的な相互作用として視覚化するとわかりやすいですが、実際には環境とのランダムな結合によって引き起こされる可能性があります。コヒーレント誤差の例として、RYゲートを実装する際にパルスの向きに不完全さがあり、ゲートが実際にはを引き起こすとします。このような不完全さは、常に同じ方向にX軸周りの誤った回転を引き起こします。これはコヒーレント誤差です。
SPAM誤差には、系統的な制御の欠陥のようなコヒーレント誤差と、光子損失や熱的効果のようなインコヒーレント誤差の両方が混在していることに注意してください。これは複数のステップと誤差源が関わるため、SPAM誤差はコヒーレント誤差とインコヒーレント誤差の組み合わせとして説明するのが最も適切です。
SPAM誤差
その名前が示すとおり、SPAM誤差は量子実験の2つの異なる段階、すなわち初期準備と読み出し/測定において生じます。 状態準備誤差は、ハードウェアが量子ビットを望ましい初期状態(IBMの量子コンピュータの場合は)に確実に初期化できない場合に発生します。原因には次のようなものがあります。
- 熱励起(実際の量子ビットは完全には冷却されておらず、の代わりにから始まってしまうことがある)
- 超伝導量子ビットの共振器に残留する光子やノイズ
- 量子ビットのリセットの正確さに影響を与えるキャリブレーションのドリフト
測定誤差は、測定装置が量子ビットの状態を誤って識別する読み出しプロセス中に発生します。 発生源には次のようなものがあります。
-
読み出しアンプのノイズにより、との混同が生じる
-
読み出し中の量子ビットの緩和(例えば、にある量子ビットが測定の直前または最中にへ崩壊する)
-
読み出しラインの間のクロストーク: あるひとつの量子ビットの読み出しが、隣接する量子ビットの読み出しにわずかに影響を与える
-
IBMの共振器ベースの測定システムにおける不完全な判別しきい値
SPAM誤差は主にインコヒーレントです。準備誤差は、励起状態と基底状態のランダムな混合のように振る舞います。測定誤差は古典的な混同のように振る舞います。すなわち、確率でがとして、あるいはその逆に報告されます。これらは、系統的な位相シフトを引き起こす誤較正されたゲートのようなコヒーレントなユニタリ誤差とは異なります。SPAM誤差はむしろランダムな古典的ノイズに似ていますが、読み出しにおけるまれなコヒーレントな偏りが存在することもあります。
SPAM誤差は、ランダム化ベンチマークや、状態準備と測定が全体の誤差の大部分を占めるような浅い回路にとっては問題となり得ます。特に多数の2量子ビットゲートを含む非常に深い回路においては、それほど大きな問題にはなりません。
数学的には、SPAM誤差は、行列を通じて理想的な分布と関連付けられるノイズを含む分布を生み出すものとして記述できます。
ここではビット列を測定する確率であり、は状態に準備されるはずだったときに状態が得られる確率です。Samplerからサンプリングされたビット列の文脈で考えてみましょう。測定された状態の分布には多くの正確な測定が含まれますが、状態準備の指示と実際に観測された状態が一致しない測定もいくらか含まれます。これは、確率がわずかにずれることを意味します。
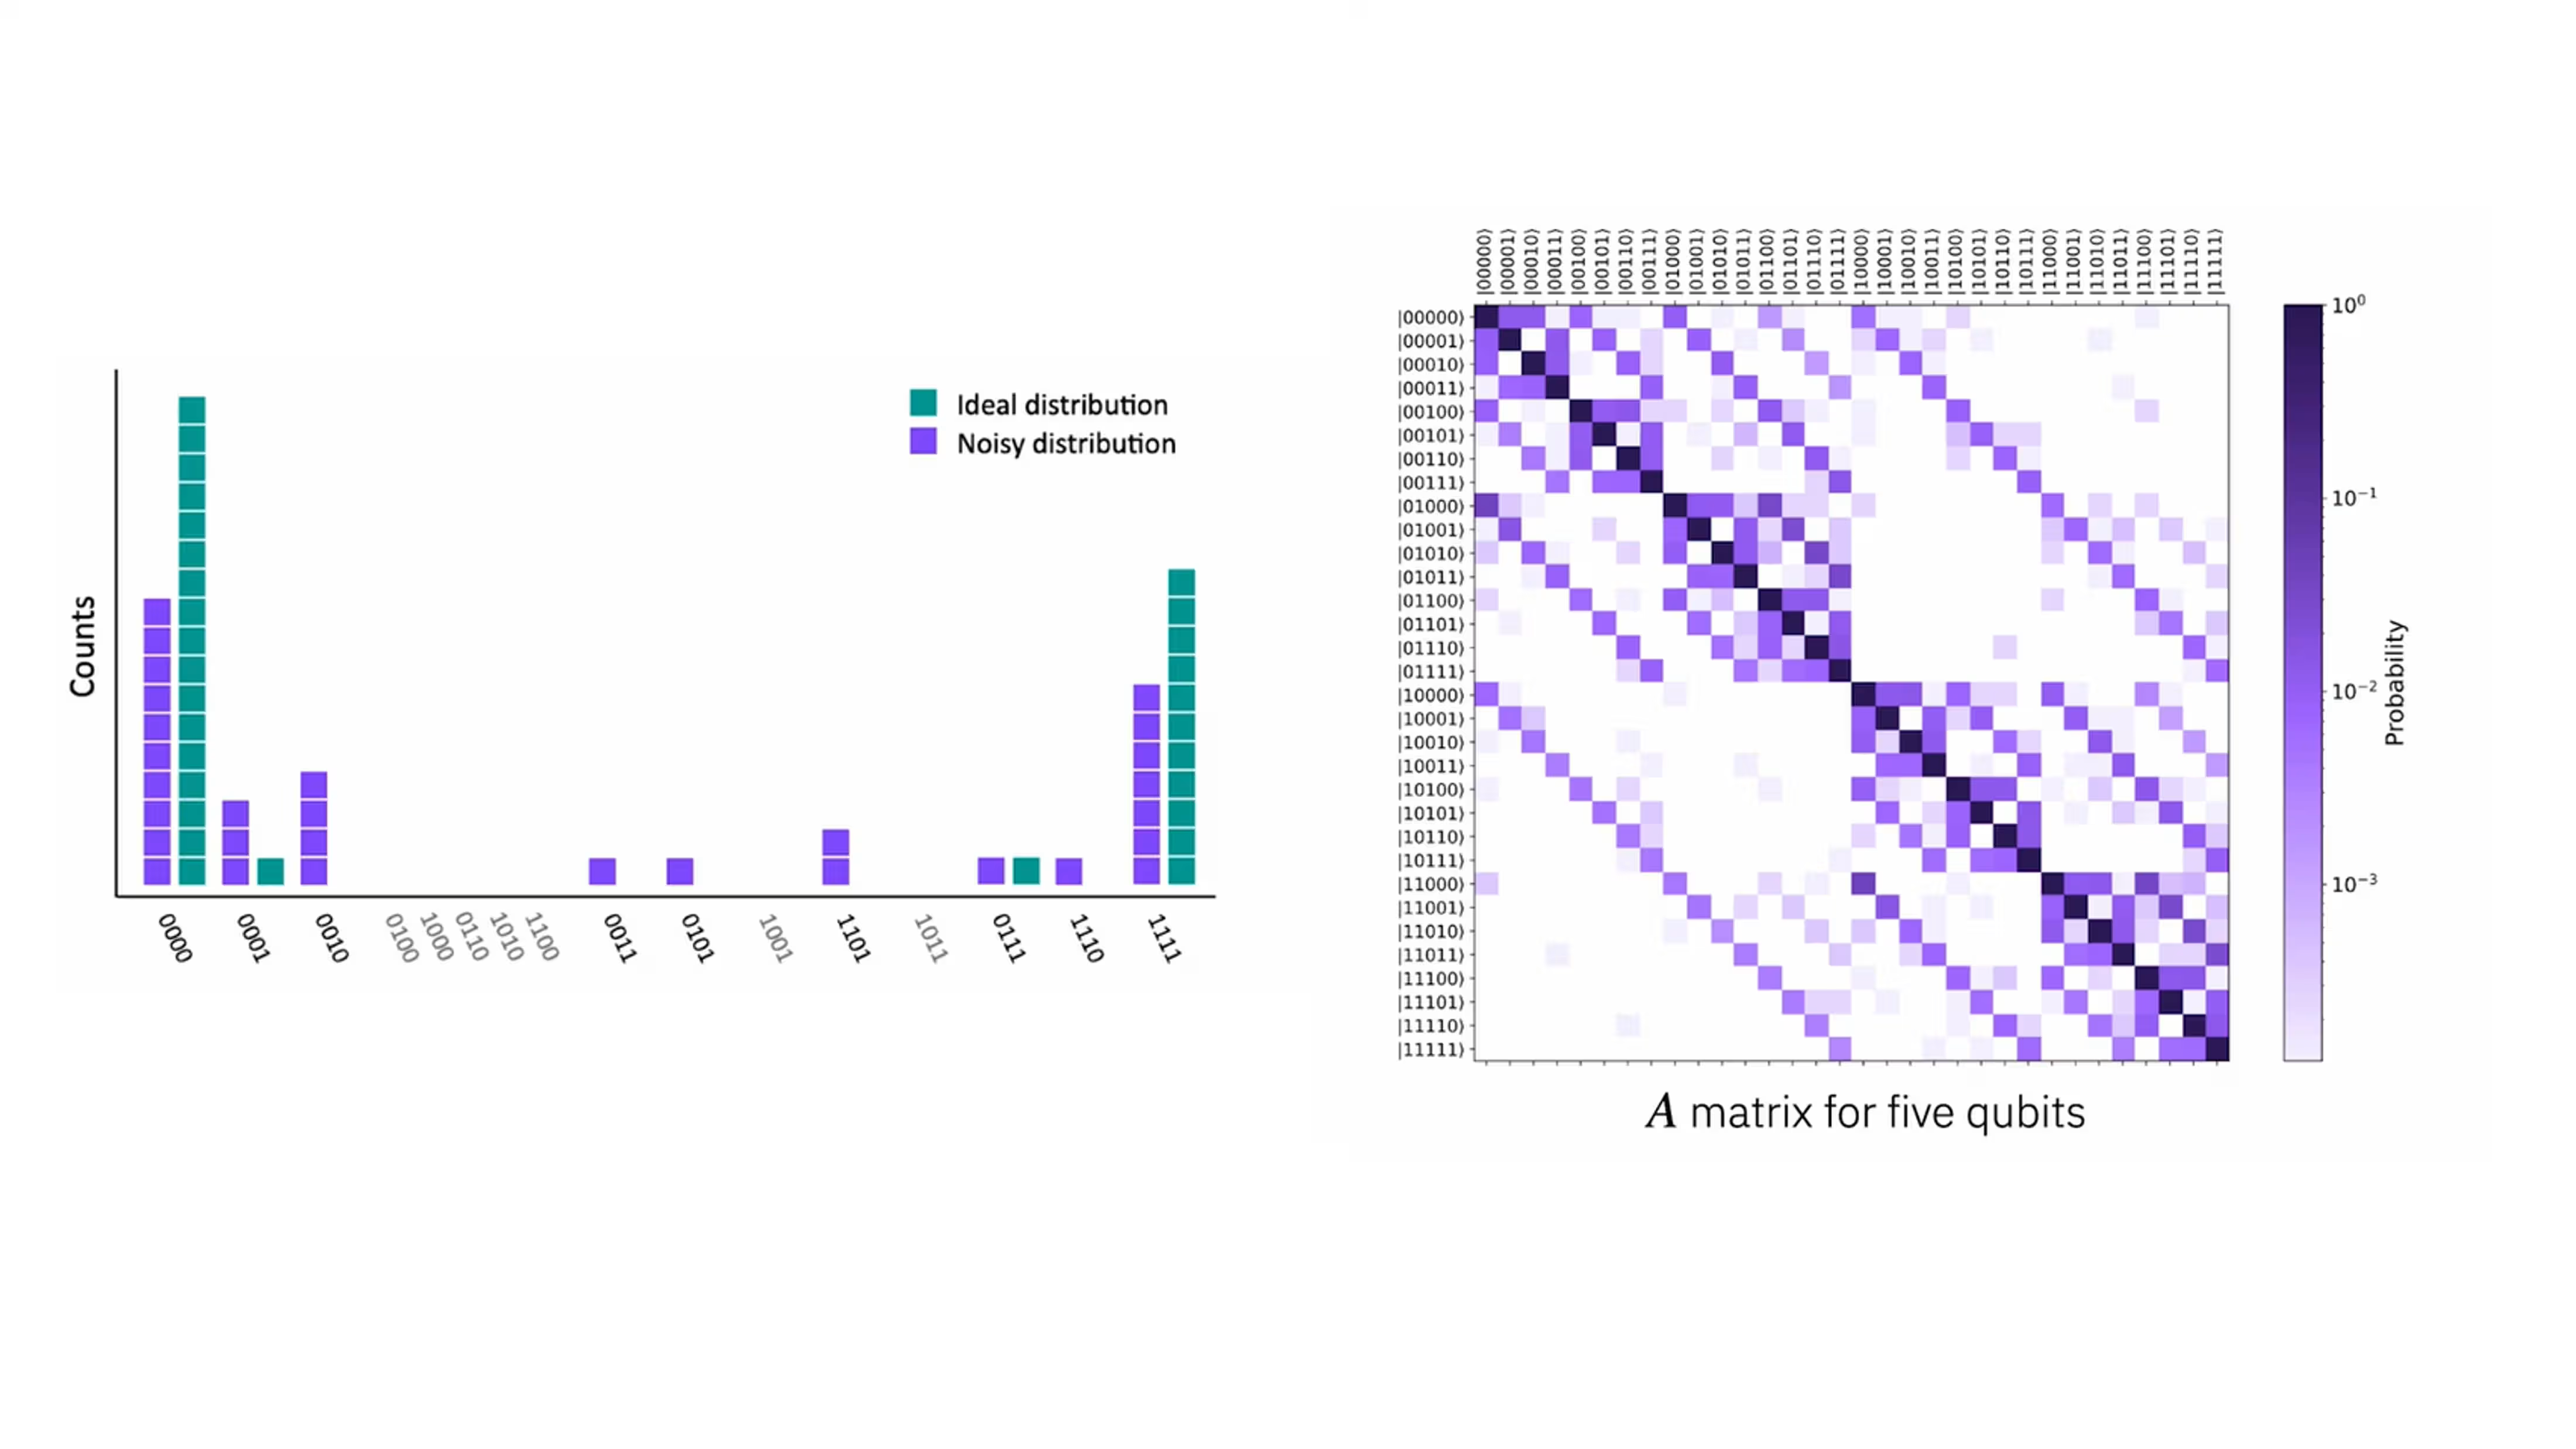
上の図では、(a)は理想的なGHZ状態の分布をティール色で、実際の測定結果を紫色で示しています。(b)では行列の例を示しています。この行列は対角線を挟んで完全には対称ではないことに注意してください。というのも、各量子ビットが誤って0を返す確率と誤って1を返す確率は必ずしも等しいとは限らないからです。 実際には、準備誤差と読み出し誤差を分離するのはしばしば困難であるため、両者は単一の扱い(SPAMという用語が一般に使われる理由)としてまとめられることがよくあります。
これらのSPAM誤差を補正する一つの方法は、理想的な測定結果が既知の単純な回路を用い、それをSPAM誤差が存在する状態で測定された結果と比較することです。これにより、より複雑な回路の理想的な結果を逆算することができます。一般的な高エントロピー状態の場合、これには個の確率からなる行列を構築することが必要になる場合がありますが、それほど極端でない場合には、これらの誤差を緩和することができます。
コヒーレント誤差とインコヒーレント誤差
__コヒーレント誤差__は、量子状態の系統的、決定論的、かつユニタリな誤回転です。これらは、予測可能な形で理想からずれる不完全な量子操作から生じます。例としては、単一量子ビット回転ゲートによって適用される回転のわずかな誤差が挙げられ、キャリブレーションのドリフトによって一貫して過回転あるいは過小回転を引き起こすものも含まれます。数学的には、実際の回転ゲート、例えばは、理想的な回転ゲートに何らかの追加の誤差を加えたものとして書くことができます。
これは、何らかの小さな過小回転または過回転に対応します。他の例としては、2量子ビットゲートが望ましくない小さな位相シフトを加えることや、制御パルスが理想的な形状から系統的に逸脱することが挙げられます。
コヒーレント誤差の重要な特徴の一つは、それらが決定論的であり、ユニタリゲート自体としてモデル化できることです。それに対応して、これらの誤差は量子状態の純度を保存します。すなわち、量子情報が失われるのではなく、単に不完全に処理されるだけです。 もう一つ注意すべき重要な点は、繰り返されるコヒーレント誤差は建設的に干渉し、時にはゲート数に対して二次関数的に増大することです。
これらの誤差は時に予測可能であり、そのためある程度キャリブレーションによって取り除くことができます。しかし、残ったコヒーレント誤差は急速に蓄積し、理想状態からの厄介なずれを引き起こす可能性があります。これは、コヒーレント誤差を意図的に「ランダム化」することが有利な場合があることを意味します。この手順とその有用性については、エラー緩和のレッスンで扱います。
コヒーレント誤差が厄介である理由
コヒーレント誤差は、ランダム化や補正が行われない場合、危険な形で「積み重なり」、正しい状態からの大きなずれを生み出すことがあります。
__インコヒーレント誤差__は確率的、ランダムであり、多くの場合非ユニタリです。これらは環境との相互作用や制御できないノイズ源から生じます。すでにいくつかの例を見てきました。エネルギー緩和/減衰はインコヒーレントです。確率的なゲートノイズ、熱雑音、測定誤差も同様です。
インコヒーレント誤差の重要な特徴は、操作が実行されるたびに同じではないということです。これらは非ユニタリであるため、コヒーレント誤差のように単純なユニタリ量子ゲートとしてモデル化することはできません。インコヒーレントであるため、通常は一貫した過回転のようにではなく、ランダムノイズのように線形に蓄積します。
インコヒーレント誤差は、量子ビットが情報を不可逆的に失う原因となります(純度と位相情報の損失)。
では、どちらがより厄介なのでしょうか。量子コンピューティングの多くの事柄と同様に、それは場合によります。要点は、コヒーレント誤差はより速く、非線形に蓄積するということです(これは悪いことです)。しかしそれらは部分的にキャリブレーションで取り除くことができ、位相情報は依然としてシステムの中に残っています。それを正しく取り出す方法さえわかれば良いのです。インコヒーレント誤差は線形に蓄積しますが、これは2つの理由で好都合です。すなわち、コヒーレントな蓄積よりも遅いことと、ゼロノイズ外挿(ZNE、エラー緩和のレッスンで扱います)のようなプロセスに対するインコヒーレント誤差の影響のスケーリングが比較的容易に把握できることです。しかし、インコヒーレント誤差が生じると、量子情報は単に不明瞭になるのではなく、本当に失われてしまいます。
密度行列と量子チャネル
以降のセクションでは、コヒーレント誤差とインコヒーレント誤差のいくつかの種類についてさらに詳しく見ていき、それらが量子チャネルを用いてどのように数学的にモデル化できるかを見ていきます。まず、密度行列と量子チャネルについて簡単に復習しておきましょう。これらの完全で厳密な扱いについては、IBM Quantum LearningのJohn WatrousによるコースGeneral formulation of quantum informationを参照してください。ここでの扱いは、例に基づいたものであり、形式張らないものにします。
__量子チャネル__は、量子系がどのように発展し、相互作用し、ノイズを受けるかを記述するための最も一般的な方法です。 純粋状態とユニタリ発展に慣れている場合、量子チャネルは自然な次のステップです。
標準的な量子力学では、「純粋」状態はと書かれます。ここで「純粋」とは、その状態の準備に関する情報や知識の純度を指しており、何らかの系の固有状態を意味するものではありません。量子ビットの例として、は、相対振幅と位相について完全な知識を持っているため、純粋状態です。 このような純粋状態の時間発展は、ユニタリ演算子によって支配されます。
これはSchr"odinger方程式に従うもので、ここでであり、は系のハミルトニアン、は換算プランク定数です。これはしばしば「1に等しいとみなされ」たり、より厳密には、すべてのエネルギーがの単位で与えられるようにハミルトニアンに吸収されたりします。
ユニタリ発展は可逆的、決定論的、かつ孤立しています。しかし、これでは実際の量子系を記述するには不十分です。実際の量子系では、
- 測定を行うと、量子状態はその系の固有状態へと収縮します。これは明らかに非ユニタリです。
- 系は環境と相互作用します。これは、系が本当の意味で孤立しているわけではないことを意味し、環境を無限に追跡することはできないため、情報の損失に対応します。
- 実際的に言えば、ノイズが状態を損ないます。 そして、他にもさまざまな要因があります。
ユニタリ発展だけではこれらのプロセスを記述できません。したがって、量子状態とプロセスについて、より一般的な表現が必要になります。混合状態は、量子状態の古典的な分布を記述します。つまり、私たちはすでに、量子状態が、測定される(古典的な情報へと収縮する)と、状態になる確率が50%、状態になる確率が50%であることを知っています。しかし、ここでの主張は、初期の量子状態がまさにである確率が100%だということです。ここで、量子力学的な確率の上に、さらに古典的な確率を加えたいとします。例えば、
初期の量子状態は25%の古典的確率でに準備され、75%の古典的確率でに準備されます(相対位相が異なることに注意してください)。
これは、準備における明示的な古典的確率によることもあれば、私たちが無視している環境の一部とのエンタングルメントによることもあります。いずれにせよ、量子力学的状態のこのような古典的分布を記述するためのツールが必要であることは明らかです。純粋状態だけでは、これらの可能性を表現することはできません。そこで、__密度行列__を導入します。
混合状態は、密度演算子によって記述されます。
ここで、は(必ずしも特定の演算子の固有状態である必要はない)量子状態であり、は系が状態に準備されている古典的確率です。これは、量子状態の既知の古典的分布から密度行列を構築するための良い処方箋です。一方で、量子状態の古典的分布と、異なる測定結果に対する量子力学的な確率の両方が与えられたとき、測定が(より多くの量子ビットが関与する場合には、や、あるいはその他の状態のような)特定の状態を与える確率を知りたい場合もあります。密度行列は、まさにそのような場合に特に有用です。これは、基底を用いて次のように書くこともできます。
ここで、対角要素は確率です。
-
= 量子ビットがにある確率
-
= 量子ビットがにある確率
これらは実数であり、非負であり、合計すると1になります。
非対角要素はコヒーレンス、すなわち位相関係や干渉能力を表しており、一般に、その状態にどれだけの量子力学的情報が含まれているかに対応します。これは形式張らない説明ですが、実際にはどういう意味なのかを見てみましょう。
例
純粋状態を考えます。 (a) 計算をせずに、測定確率と位相情報について何がわかるでしょうか。 (b) 密度行列を構築し、あなたの直感を検証してください。
Solution:
(a) これは純粋状態であるため、との間には唯一の位相、すなわち+1しかあり得ません。これは完全な位相情報であるため、密度行列の非対角要素は大きくなると予想されます。非対角要素についてはこれ以上の直感を持っているかもしれませんが、今はこれで十分です。さらに、2つの基底状態の振幅は等しいため、またはのどちらかを測定する確率は50%になると予想されます。したがって、対角要素は1/2になると予想されます。 (b) 上の定義を用いると、
となるのは状態の場合のみです。したがって、次のように書くことができます。
対角要素はそれぞれ予想通りであり、非対角要素は大きな値になっています(合計すると1になります)。
それでは、良い位相情報を持たない場合に何が起こるかを見てみましょう。
例
よく似たケースを考えますが、今度は状態にある古典的確率が50%、状態にある古典的確率が50%であるとします。同じ2つの質問です。 (a) 計算をせずに、測定確率と位相情報について何がわかるでしょうか。 (b) 密度行列を構築し、あなたの直感を検証してください。
Solution:
(a) 前と同様に、2つの基底状態の振幅は等しいため、またはのどちらかを測定する確率は50%になると予想されます。したがって、対角要素は1/2になると予想されます。しかし今回は、との間の位相について、+1と-1という2つの正反対の可能性があり、それぞれが同じ確率で起こります。2つの等しい確率を持つ正反対の位相があると、位相情報はほとんど、あるいはまったく持たないと予想されるかもしれません。非対角要素は小さくなると予想されるかもしれません。 (b) 再び上の定義を用いると、
となるのは2つの状態との場合のみです。したがって、次のように書くことができます。
予想通り、非対角要素は小さく、実際にはゼロです。対角要素は依然としてそれぞれ50%であり、これは、混合状態を構成する各状態においてとが等しい重みを持っていたことを考えれば理にかなっています。
この構成は、量子ビットの数が増えるにつれてさらに興味深いものになります。以下の問題でこれを探ってみましょう。
理解度チェック
純粋なBell状態の密度行列を書いてください。
答え
となるのは状態の場合のみです。したがって、次のように書くことができます。
の古典的確率25%と、の古典的確率75%についての密度行列を書いてください。
答え
となるのは2つの状態との場合のみです。したがって、次のように書くことができます。
前の問題での作業を修正して、の古典的確率50%と、の古典的確率50%についての密度行列を書いてください。どの位相情報が残ると予想されるか予測してください。
答え
となるのは2つの状態との場合のみです。したがって、次のように書くことができます。
対角項は必ず合計1になります。非対角項は、前の1量子ビットの例のようにはここでは打ち消し合いません。これは数式を見ればその理由がわかりますが、簡単に言えば、今回はヒルベルト空間により多くの状態があるからです。最初のBell状態は正の相対位相を持ち、2番目は負の位相を持っていましたが、これらの位相はそれぞれ異なる基底状態の間のものでした。最初のBell状態はとの間の位相を持ち、2番目はとの間の相対位相を持っていました。
量子チャネル
__量子チャネル__は、量子状態に対して物理的に許される最も一般的な変換です。これは、初期の密度行列を別の密度行列に変換します。
ここでは、密度行列に作用する量子チャネルを意味しており、Bell状態やと混同しないようにしてください。
量子チャネルは非常に一般的なものです。これには次のようなものが含まれます。
-
ユニタリ発展
-
ユニタリの確率的混合
-
Measurements
-
Decoherence
-
振幅減衰(エネルギー損失)
-
デフェージング(位相情報の損失)
-
環境との相互作用 そして他にも多くのものがあります。
量子チャネルとは、ユニタリが純粋状態に対して果たす役割を、密度行列に対して果たすものだと考えることができます。ただし、密度行列は一般性が高いため、それに対応する量子チャネルもはるかに一般的で、より強力なものになります。
量子チャネルに課される唯一の制約は、次の3つを満たさなければならないということです。
- 線形であること 状態の混合は、一貫した形で発展しなければなりません。
- 完全正であること たとえシステムが他の何かと絡み合っていたとしても、負の確率を生じてはなりません。
- トレースを保存すること 確率の合計は1にならなければなりません。 これらは、CPTP(Completely Positive Trace-Preserving maps、完全正かつトレース保存写像)という頭字語でまとめて呼ばれることがあります。
量子チャネルには、Stinespring表現、Kraus表現、Choi表現など、さまざまな表現方法があります。これらについては、General formulation of quantum informationの中の量子チャネルに関するこのレッスンで詳しく扱われており、これらが等価であることもそこで示されています。ここではこれらの異なる表現には立ち入りません。これらは、ベクトルを3つの異なる座標系で記述することに似ていると言えば十分でしょう。それぞれが異なる側面を強調し、異なる形で直感を養うことができますが、いずれも正しい答えを与えてくれます。 __Kraus表現__は、私たちの目的にとって便利です。これは、行列の乗算と加算を通じてチャネルの作用を表現する便利な定型的な方法を提供します。特に、Kraus表現とは、チャネルを次の形で指定するものです。
ここで、はすべて同じ次元を持つ行列であり、その列は入力系の古典的状態に対応し、その行は出力系(それがであれ、別の系であれ)の古典的状態に対応します。 が有効なチャネルであるためには、これらの行列は次の条件を満たさなければなりません。
これらの行列はKraus行列と呼ばれます。この定式化は、ノイズチャネルだけでなく、測定を含む一般的な量子プロセスやチャネルにも適用できます。それでは、これらがノイズと誤差の文脈でチャネルを構築するためにどのように使えるか、例を見てみましょう。
完全デフェージングチャネル
すべての位相情報を破壊するチャネルを考え、これを完全デフェージングチャネルと呼ぶことにします。これは、このチャネルが次の形の任意の密度行列
を、次の形に写像するべきであることを意味します。
密度行列がすでに計算基底で書かれていると仮定すると、をとして表すことができます。これは、このチャネルの作用を実現できる一組のKraus行列を示唆しています。すなわち、です。それでは、この方針を単一量子ビットの例に適用し、必要な通りに機能するかどうかを見てみましょう。
およびと設定します。
は数であるため、ベクトルを単純にその前を通り越して移動させることができます。これは第2項についても同様に当てはまります。以上より、次が得られます。
これらの行列が必要な条件を満たしていることに注意してください。
このKraus行列の選び方は一意ではないことに注意してください。
チャネルとしてノイズを特徴づける
このセクションでは、ブロッホ球のモデルと量子チャネルの数学を用いて、さまざまな種類のノイズとエラーをより深く理解します。
インコヒーレント誤差
インコヒーレントエラーに話を戻し、特にエネルギー緩和エラーについて見ていきましょう。状態は量子ビットの基底状態であり、状態はわずかに高いエネルギーを持つことを思い出してください。量子状態は、より高いエネルギー準位からより低い準位へと自発的に崩壊することがあります。自発放出のプロセスは奥深いトピックであり、量子場理論による扱いなしに真に理解することはできません。しかし、その直感は私たち全員によく馴染みのあるものです。ランダムな摂動は岩を丘の下へ転がり落とすことはあっても、丘の上へ転がり上げることはありません。量子ビットがより高いエネルギー状態にとどまる時間は、時間によって特徴づけられます。より具体的には、状態に準備された量子ビットが時間後もその状態にとどまっている確率はです。あるいは同じことですが、時間後にエネルギー緩和エラーが発生する確率は次のようになります。
これをクラウス表現による量子チャネルで記述するには、次に対応するクラウス行列が必要です。
- 状態をそのまま変化させない
- 状態をある確率pでに変化させる
次のように定義しましょう。
まず、これが密度行列に望ましい効果をもたらすことを確認しましょう。純粋状態にある系を考えます。上記の例で見たように、この場合の密度行列は次のようになります。
クラウス行列を用いてエネルギー緩和チャネルを適用すると、新たにマップされた密度行列が得られます。
これを調べて、私たちの直感と比較してみましょう。
まず、がゼロに近づく極限を確認しましょう。予想どおり、初期の密度行列が復元されます。
時間が経つにつれて、状態を測定する確率は増加し、を測定する確率は減少すると予想されます。これはまさに私たちが目にする通りです。なぜなら
また、とを測定する確率の和が必ず1になることも自明に確認できます。
コヒーレンス(非対角)項の正確なスケーリングは、本稿の範囲を超えます。しかし明らかなのは、私たちが最初は完全な位相情報を持っており、非常に長い時間が経過すると系が完全に状態へ緩和するため位相情報が存在しなくなるということです。したがって、コヒーレンス項は非常に長い時間でゼロへと減衰しなければなりません。実際、
クラウス行列に対する制約の多くは、これらの直感的な考察を通じて暗黙のうちに確認されています。チャネル(特にクラウス行列)に対する制約が満たされていることを厳密に確認すべきですが、それは読者への演習として残しておきます。
グラフィカルには、このタイプのチャネルはブロッホ球を用いて表すことができます。純粋状態はブロッホ球の表面上に位置します。混合状態は球の内部へと移動し、単一の点から広がっていきます。古典的確率が含まれることは、原点から混合状態中の各状態までの絶対距離が縮小することとして現れ、単一の点から領域への広がりは複数の可能な状態が混ざり合っていることを示します。エネルギー緩和チャネルという特殊な場合では、無視できない時間が経過した後の混合状態(密度行列)は下の画像のように見えます。すなわち、ブロッホ球の内部にある領域が、極に向かって上方にシフトし、軸方向にも、平面方向にも(ただし軸方向ほどではないものの)縮小しています。

この領域は、遠近法によるレンダリングで時折見えるような、ブロッホ球の「キャップ」ではないことに注意してください。動画で明確に見て取れるように、それは扁平回転楕円体であり、状態に向かって縮小・シフトしています。ノイズチャネル(そして一般にチャネル)は、もちろん任意のサイズの系に適用可能です。しかし、ヒルベルト空間内で互いに直交する状態の数が増えるにつれて、それらを(ブロッホ球のように)視覚的に表すことは難しくなります。
理解度チェック
上記のエネルギー緩和チャネルで用いたクラウス行列が、恒等条件を満たすことを確認してください。
答え
これからインコヒーレントノイズチャネルをさらに2種類紹介しますが、その解釈と確認の大部分は演習として残します。次は__デフェージングチャネル__で、これは振幅を保存したまま位相情報が失われることを記述します。全体の測定確率には古典的確率と量子力学的確率の両方が依然として関与し得ますが、位相情報の喪失はしばしば量子情報の喪失、あるいは系がより古典的になることとして説明されます。
エネルギー緩和が特徴的な時間で記述されたのとちょうど同じように、デフェージングエラーは2つ目の時間パラメータによって記述されます。時間後にデフェージングエラーが発生する確率は次式で与えられます。
この確率を用いた単一量子ビットのデフェージングチャネルに対するクラウス行列の一組は、次のとおりです。
このデフェージングチャネルの結果は、下の図でブロッホ球を用いて視覚化されています。

振幅は変化しないため、極(または)にちょうど位置する状態は影響を受けず、陰影のついた領域内で球の表面にマップされたままであることに注意してください。しかし位相情報は失われ、これは平面にまたがる陰影領域の縮小に対応します。これを理解する一つの方法は次のとおりです。可能などの量子状態も依然として明確に定義された位相を持ちうるものの、異なる明確な位相を持つ複数の状態が見つかる古典的確率が存在するため、いずれか一つの明確な位相についての全体的な確率は低下します。
理解度チェック
上記で定義したデフェージングチャネルのクラウス行列が、恒等条件を満たすことを確認してください。
答え
との間に明確に定義された位相を持つ、任意の単一量子ビットの純粋状態から始めてください。それを密度行列として書き表してください。上記で示したクラウス演算子を用いてデフェージングチャネルを適用してください。得られたマップ後の密度行列を解釈してください。
答え
状態を選びましょう。対応する密度行列は次のとおりです。
ここで、クラウス演算子を用いてこの密度行列にデフェージングチャネルを適用します。
まず、対角成分の和が必ずそうであるべきとおり1に等しいことに注意してください。次に、非対角成分が最初は大きく、その和が24/25であり、強いコヒーレンスを示していることに注意してください。デフェージングエラーの確率が増加するにつれて、これらの非対角成分が減少することに注意してください。これも私たちの予想と一致します。ここで一つ微妙な点があります。のときに何が起こるかに注目してください。コヒーレンスが再び強くなるのです!これは一見すると直感に反するように思えます。なぜなら、デフェージングエラーの確率が高ければ位相が乱れるはずだからです。しかし実は、位相エラーが100%確実に発生するとわかっているなら、位相について再び強い情報が得られます。位相は単に反転しただけなのです。この洞察から、位相エラーが発生する確率が50-50のときに位相情報が最悪になると予想されますが、実際にそのとおりの結果が得られます。
インコヒーレントエラーを記述するノイズチャネルの最後の例は、__パウリノイズチャネル__です。このチャネルは、独立した確率で発生する3種類のエラーを記述します。
- 確率のビット反転エラー(Xエラー)
- 確率の位相反転エラー(Zエラー)
- 確率のXとZの組み合わせ(Yエラー) ここで、すべてのについてです。系として、エラーが発生しない確率はです。
このチャネルのクラウス演算子は次のとおりです。
パウリノイズチャネルの場合、チャネル自体を書き出すことは有益です。
この形から、パウリノイズチャネルはパウリ行列の作用に対応する1つ以上のエラーを、それぞれ確率で実装していることがわかります。
反転確率のさまざまな組み合わせは、異なる視覚化を生み出します。ここでは、という特殊な場合を視覚化します。これは脱分極チャネルとも呼ばれます。

コヒーレントエラーのモデル化
量子チャネルはコヒーレントエラーとインコヒーレントエラーの両方を表現できますが、実際にはコヒーレントエラーはユニタリな較正ずれとしてモデル化する方が適しており、あるいは解析を容易にするために確率的チャネルへ変換されることが多いため、主にインコヒーレントエラーに対して用いられます。このセクションでは、コヒーレントエラーにより適したアプローチを紹介します。
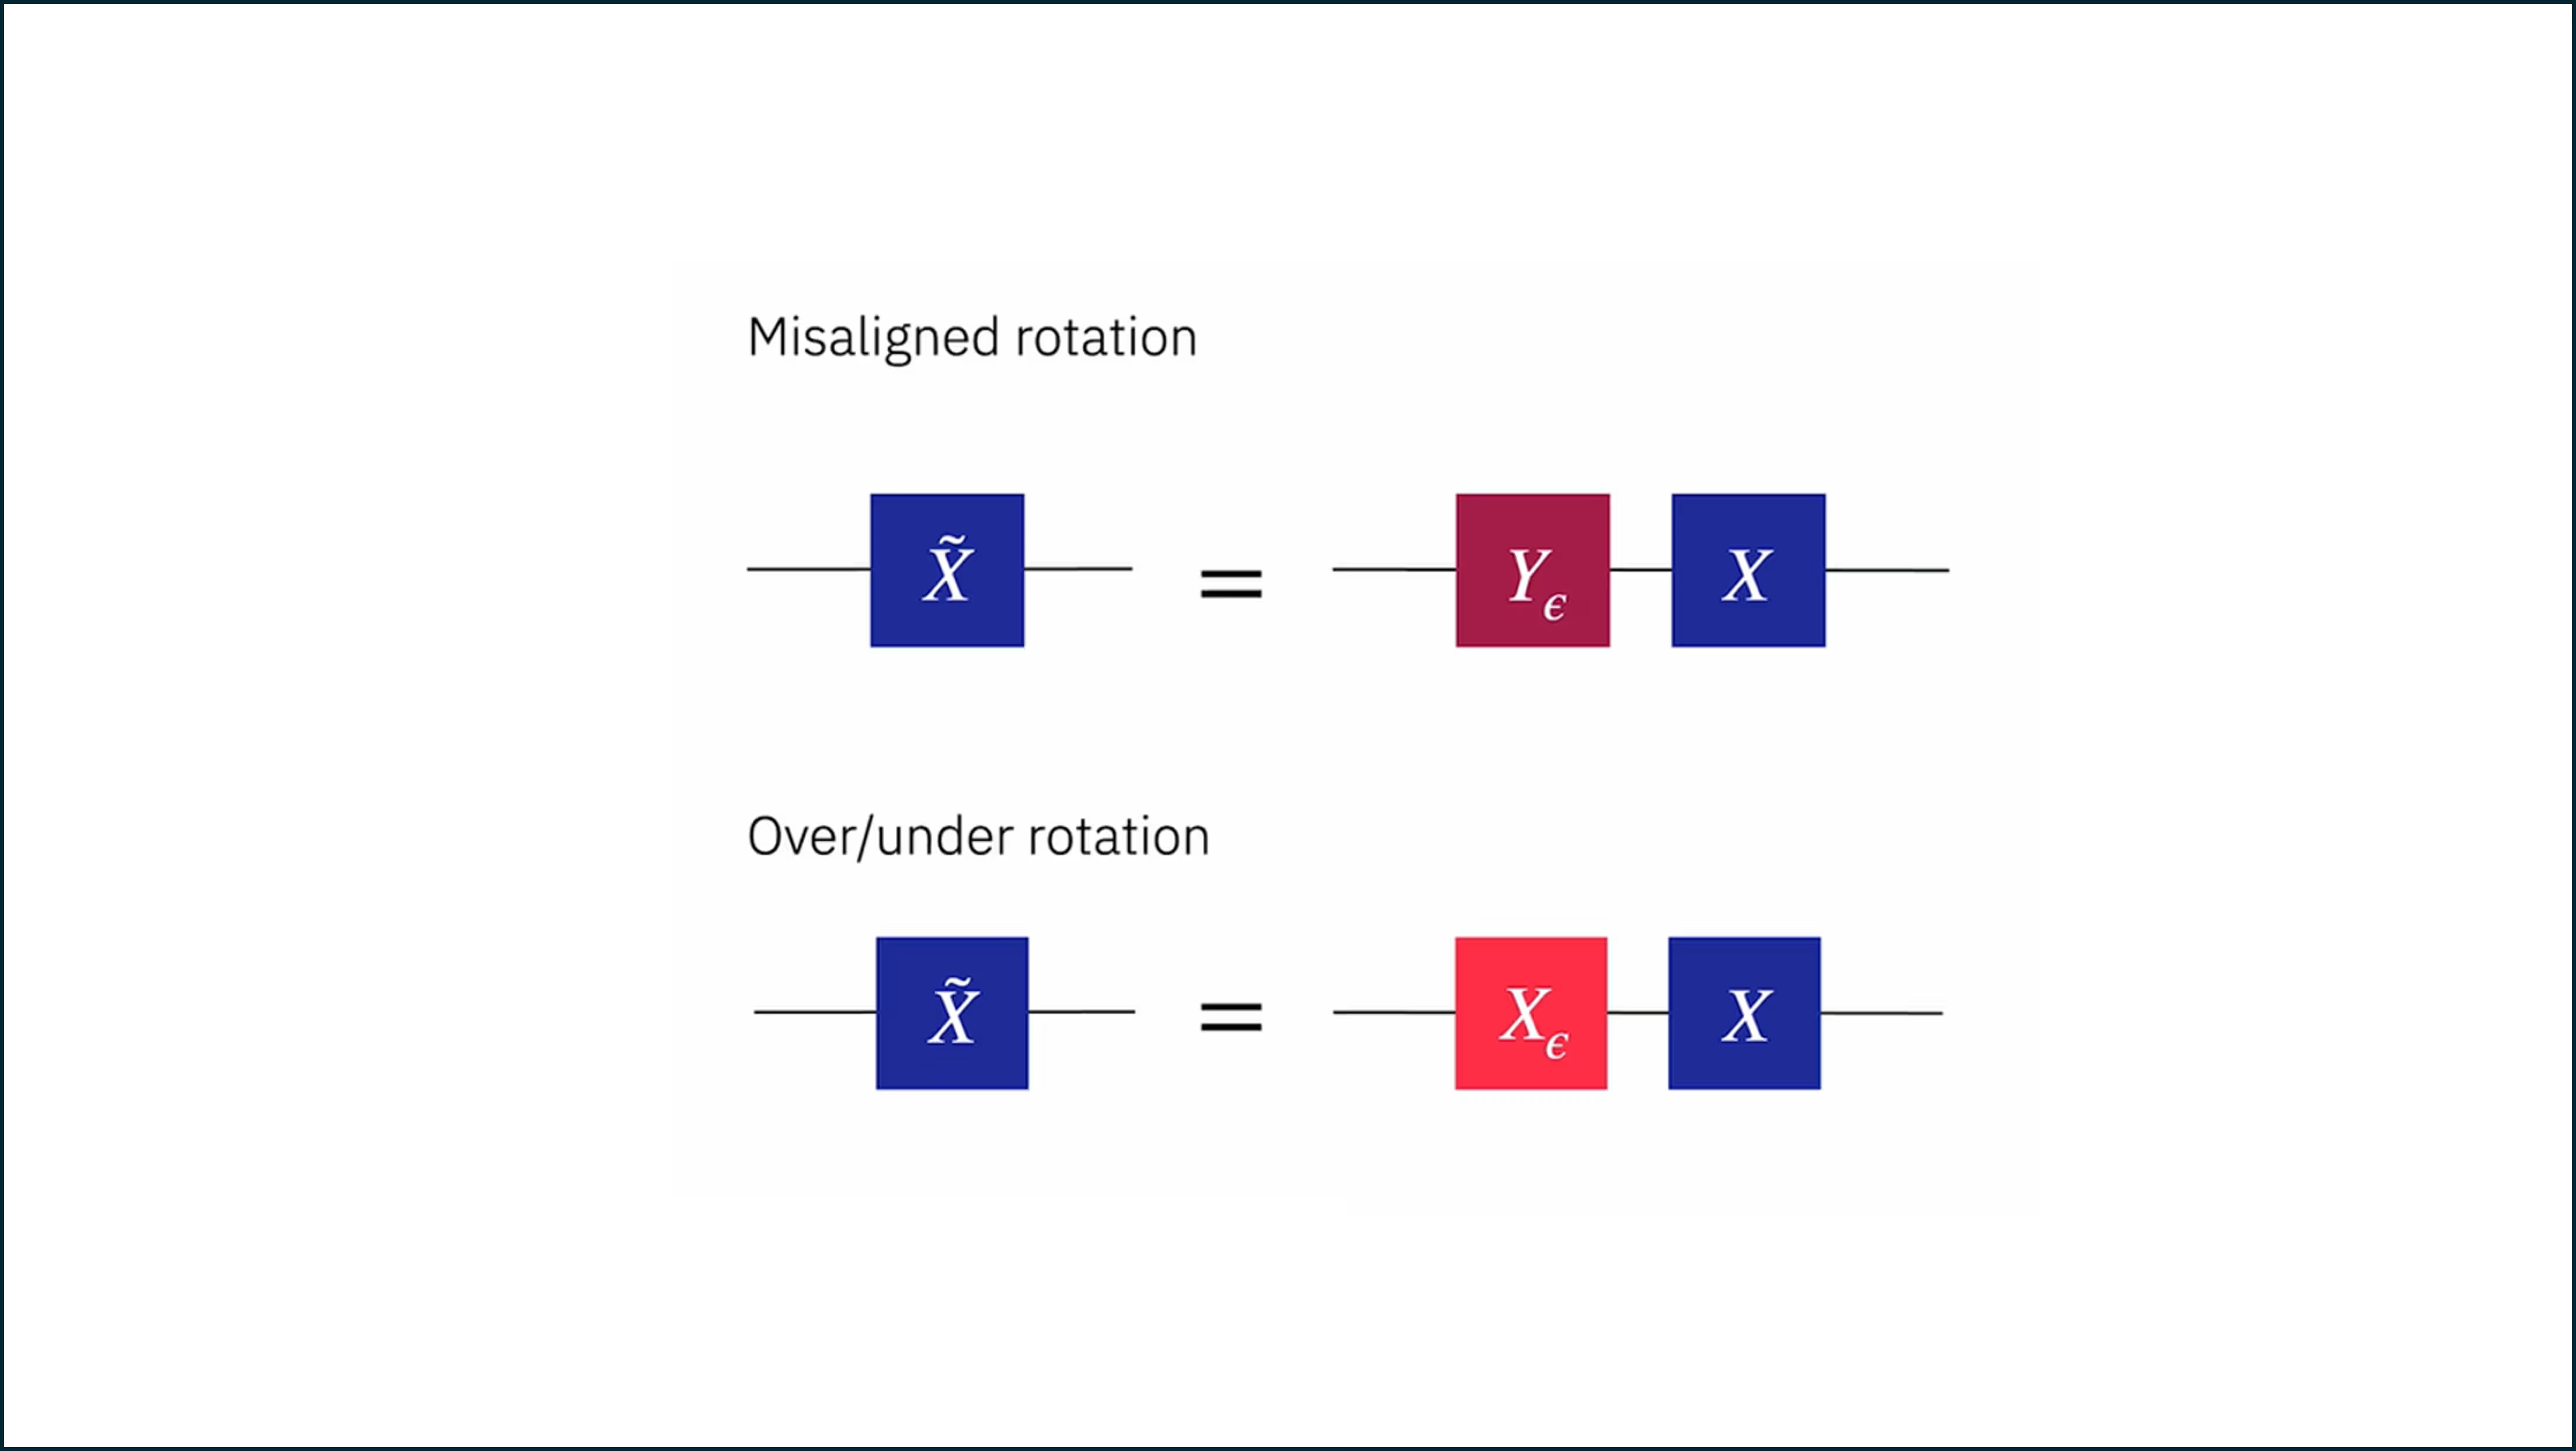
コヒーレントエラーは、望ましくないユニタリゲートによってモデル化できます。単純な例としては、軸ずれ回転や過小/過剰回転が挙げられます。下の画像では、望ましい軸回りの回転に加えて、小さな量だけ余分な回転が加わったものとして軸ずれ回転を示しています。過剰回転は、望ましい回転と同じ軸周りの追加の回転によって記述されます。
2量子ビットエラーと陰影付き光円錐
単一量子ビットゲートは、孤立した量子ビットを回転させます。2量子ビットゲートは2つの量子ビットに依存するロジックを実装しますが、どちらの量子ビットも直接測定することはできません。そのため、量子ビット間の相互作用をオンにする必要があります。この相互作用こそがエンタングルメントを構築できる理由であり、同時にノイズ、クロストーク、較正の難しさの多くもここから生じます。量子ビット間のこの相互作用は、エラーの伝播も可能にします。ある量子ビットにエラーがあり、それが別のターゲット量子ビットに対する制御量子ビットとして機能している場合、そのエラーはターゲットへと伝わる可能性があります。このレッスンでは、2量子ビットゲートがエラー率と、回路内でのエラーの伝播にとって何を意味するかを見ていきます。
エコー付きクロス共鳴ゲート
異なるハードウェアアーキテクチャやゲートファミリーは、この相互作用をそれぞれ異なる方法で実現します。IBMの量子コンピュータは、CZやCXのような抽象的な2量子ビットゲートを、ハードウェアネイティブなエコー付きクロス共鳴(ECR)ゲートを用いて実装します。ECRゲートは、マイクロ波ドライブを用いて実効的な相互作用を生成します。CNOTのような関連ゲートは、単一量子ビット回転を加えることでから構築されます。
異なる量子ビットは異なる共鳴周波数(強く反応する周波数)を持ちます。標準的な操作では、その共鳴周波数を用いて量子ビットの遷移を誘起することがあります。しかし、隣接する量子ビットTの共鳴周波数で量子ビットCをドライブすると何が起こるでしょうか?隣接する量子ビットは、固定された容量結合または共振器を介した相互作用によってつながっています。この結合のため、量子ビットCへのドライブは量子ビットTのハミルトニアンに「漏れ込み」ます。この実効的なドライブの強さと方向は、量子ビットCの状態(または)に依存します。ここで、量子ビットCが制御であり、量子ビットTがターゲットです。
この結果は、制御量子ビットの状態に条件付けられた実効的なターゲット量子ビットの回転です。数式で表すと:
このZX相互作用こそ、CNOTを構築するために必要なものです。しかし、その他の項にはいくつかのエラーが含まれる可能性があり、量子ビットCとTの間の容量結合、すなわちZZ項がほぼ確実に含まれます。
これらの追加の項について、次のように考えることができます。
-
IX = ターゲットが意図せずドライブされる
-
ZI = 制御量子ビットが望ましくないZ回転を獲得する
-
IZ = ターゲット量子ビットが望ましくないZ回転を獲得する
-
ZZ = 静的な状態依存の位相シフト
-
その他 = 小さなXY、XX、高次の相互作用
ECRゲートは、単に制御回転と、制御量子ビットに対する慎重に選ばれたエコーパルスを組み合わせたものです。このエコーは、ZX相互作用を保ったまま、多くの望ましくない項の符号を反転させます。この過程により、IXエラーとZIエラーはかなりよくキャンセルされ、時には一部の高次項もキャンセルされます。 しかし、静的なZZ結合はエコーパルスと交換するため、エコーによってキャンセルすることはできません。 この過程でキャンセルされない他の相互作用もあります。残留する非線形性や傍観量子ビット効果、リーケージや長距離ドライブの汚染、その他いくつか — ですが、特に重要なのはZZ項です。
この過程は、単一量子ビットゲートより1桁長いドライブ時間を必要とすることがよくあります。より長いドライブ時間、ハミルトニアン中に残り続けるZZ項、そして結合の不完全性が組み合わさることで、2量子ビットゲートがゲートエラーの主要な原因となります。また、回路内で隣接していない量子ビット間の相互作用が必要な場合、必要となるSWAPゲートも明らかに2量子ビットゲートであることに注意してください。これが、標準的な深さに関する指標が__2量子ビット、トランスパイル済み深さ__である理由です。私たちが主に2量子ビットゲートを気にかけるのは、それらがゲートエラーを支配するからであり、トランスパイル済みの回路を見る必要があるのは、トランスパイルによってSWAPゲートという形で多くの追加の2量子ビットゲートがしばしば導入されるためです。
理解度チェック
私たちが主に2量子ビットのトランスパイル済み深さを気にかける理由を説明してください。ハードウェアの制約と、単一量子ビットゲートの深さがはるかに大きくなり得るという事実を必ず考慮してください。
答え
2量子ビットゲートは、単一量子ビットゲートよりもはるかに高いエラー率を持ちます。単一量子ビットゲートも完璧ではないため、単一量子ビットの深さも併せて考慮することが有用な場合もあります。しかし、2量子ビットゲートの深さは回路のエラー挙動を支配する傾向があります。トランスパイル済みの回路を考慮する必要があります。現代の量子コンピュータは、すべての量子ビット間が接続されているわけではありません。IBMの量子コンピュータは正方格子または「ヘビーヘックス」格子のいずれかを使用しており、これは量子ビットが2個、3個、または4個の最近接量子ビットを持ち、それらと単一の2量子ビットゲートで直接結合できることを意味します。隣接していない他の量子ビットとのエンタングルメントには、量子コンピュータ上で2量子ビットのSWAPゲートを用いて情報を動かす必要があります。したがって、トランスパイルは2量子ビットゲートの深さを増加させる傾向があります。高度にエンタングルした回路では、この増加は非常に大きくなる可能性があります。
陰影付き光円錐
単一の量子ビットが他のすべての量子ビットからよく孤立していると仮定します。その量子ビット上のエラーは、他のどの量子ビットにもエラーを引き起こしません。しかし、ある量子ビットが別の量子ビットと相互作用すると、エラーは伝播する可能性があります。エラーの伝播の仕方は、量子ビットの相互作用の仕方に依存します。下の回路を考えてみましょう。回路図で隣接している量子ビットは、量子チップ上でも隣接していると仮定します(つまり、記述された相互作用を実現するために、情報を他の量子ビットへスワップして回す必要はありません)。
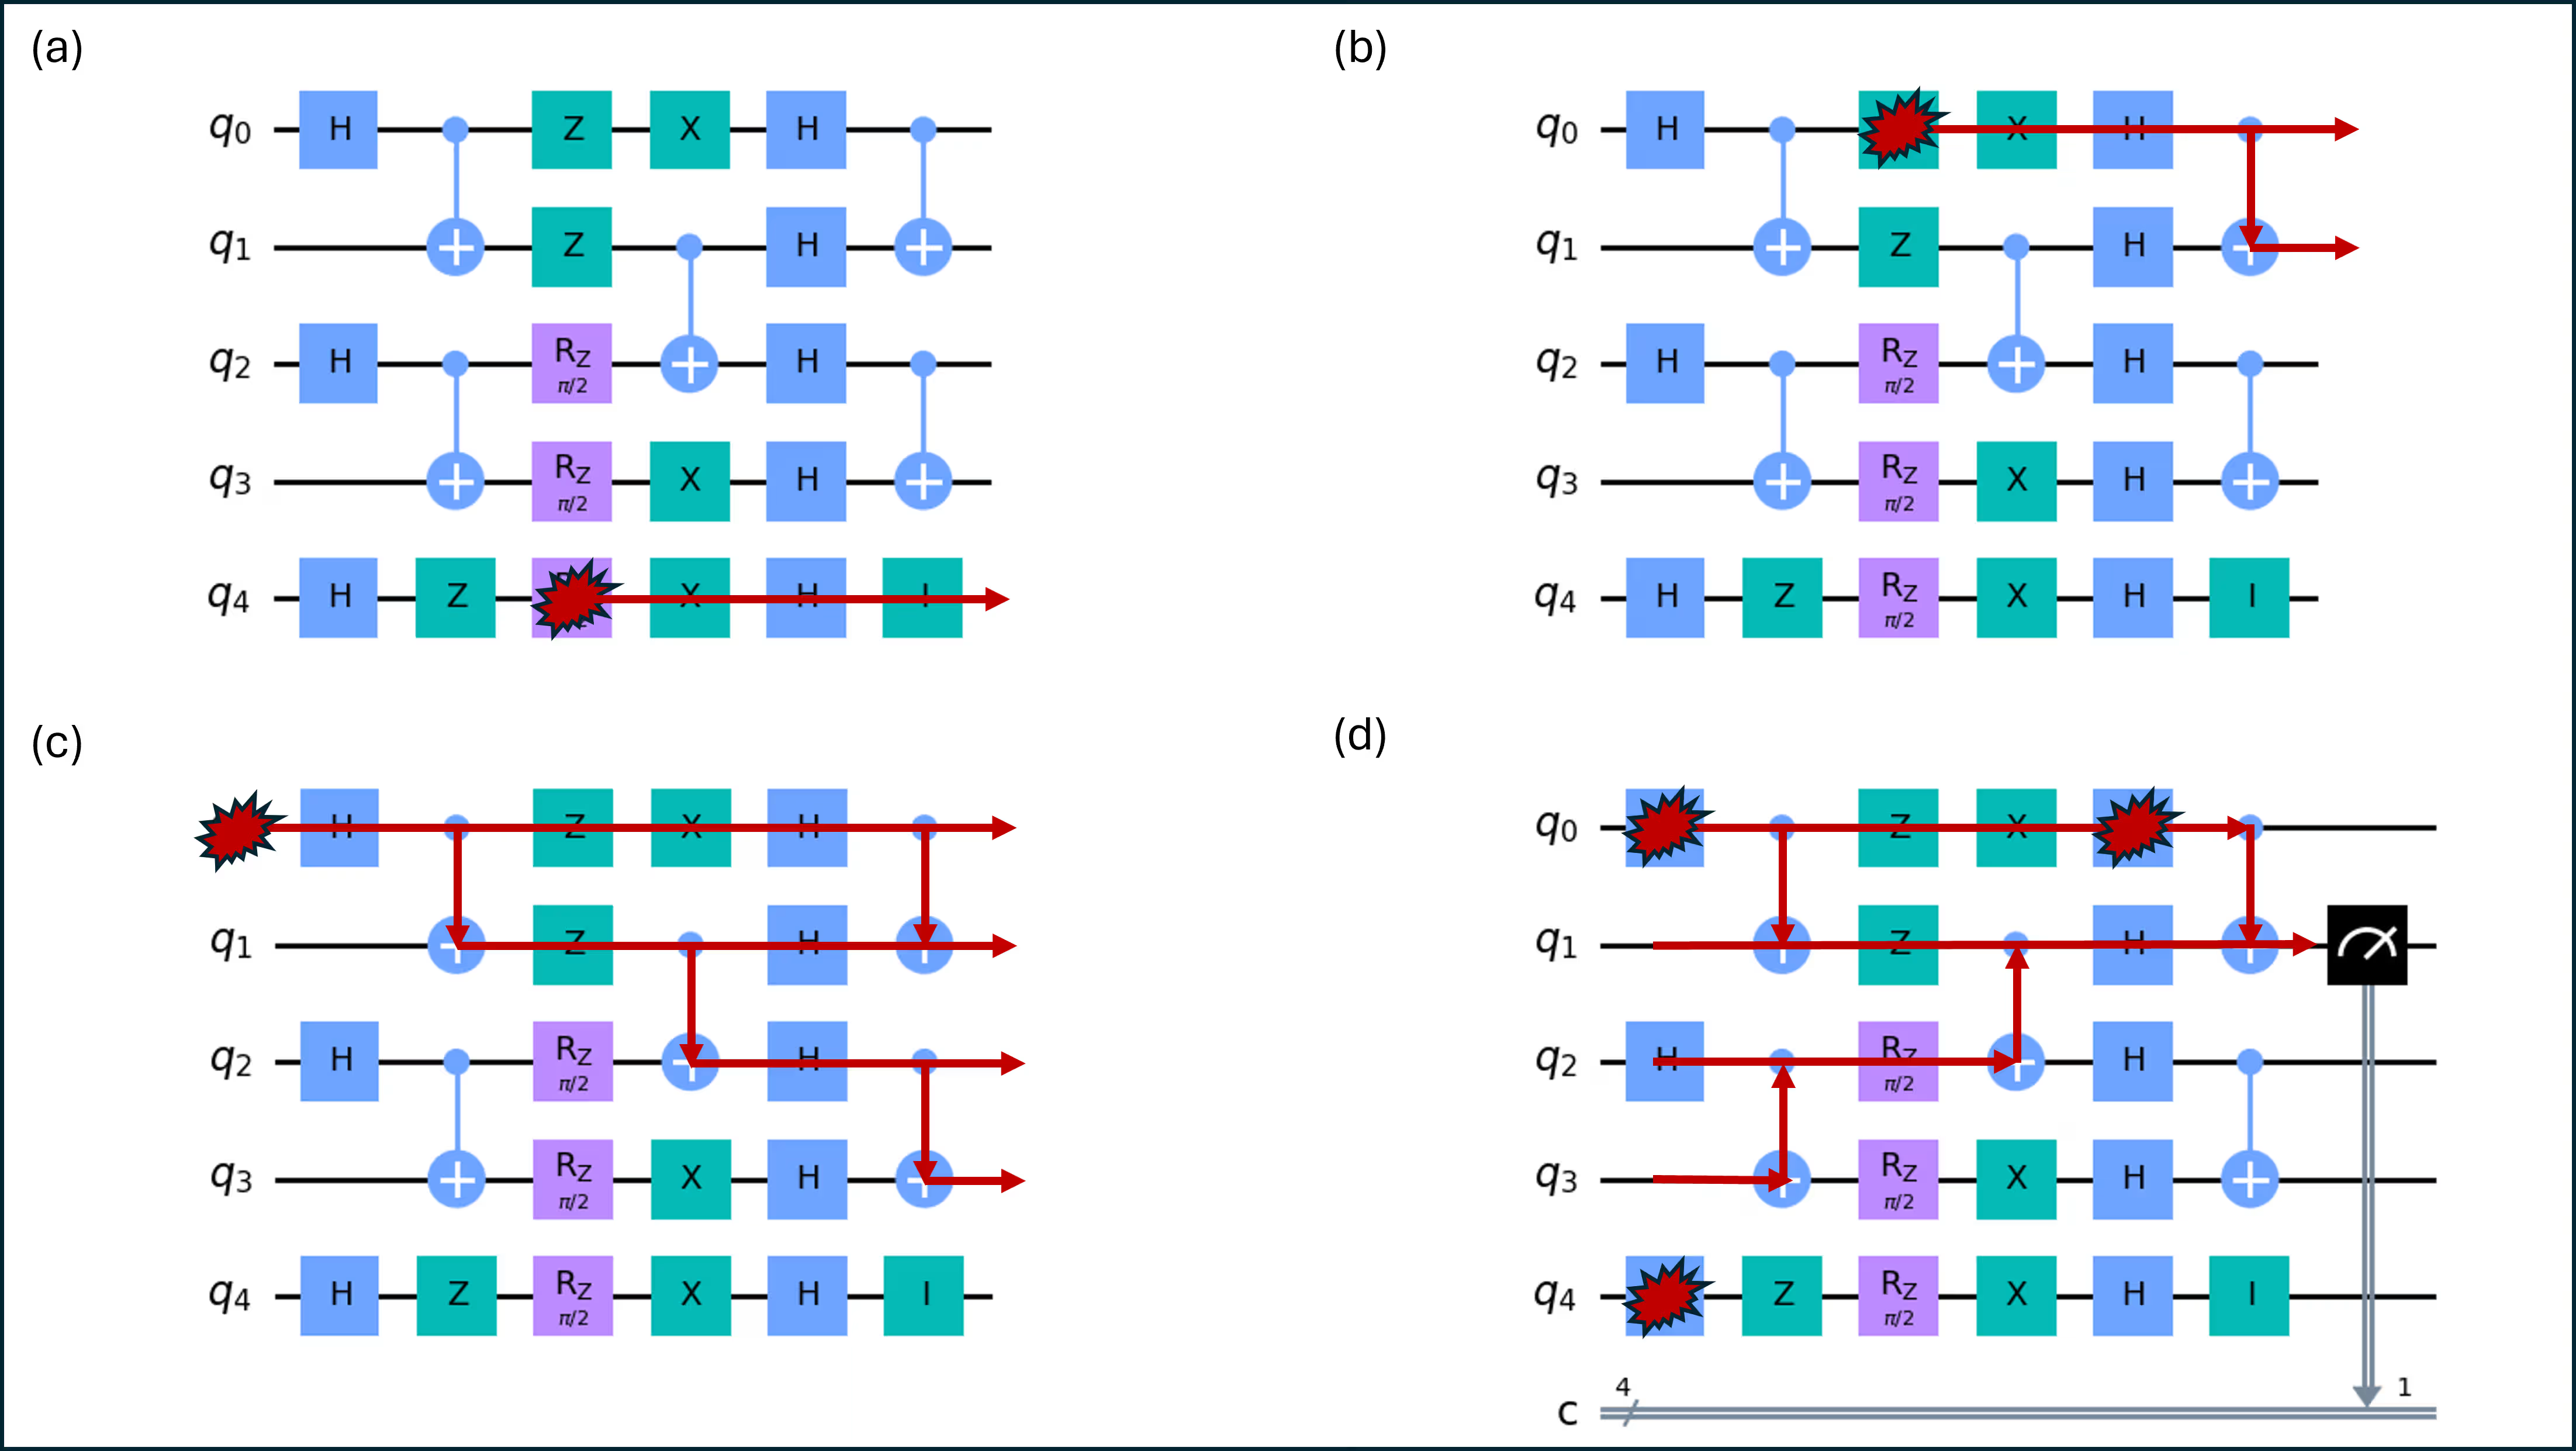
このように考えたことはなかったかもしれませんが、これは一種の時空図です。量子回路の縦軸は、空間に配置された異なる量子ビットを表します。横軸は、一連のゲートが適用される時間を表します。相対性理論の言葉を借りると、光円錐とは、ある点から因果的な相互作用を通じて到達可能な時空の領域を表します。
上の図では、エラーの種類は指定されていません。エラーの種類は、2量子ビットゲートのロジックに影響を与えるものとそうでないものがあるため、光円錐に影響を与えることがわかります。この点については、すぐ後で再び取り上げます。今のところは、黄色い線をあるエラーの種類が潜在的に広がりうる経路と考えてください。例えば、図の(a)の部分で、量子ビット4のRZゲート上の単一量子ビットエラーは、その1つの量子ビット上で時間的に前方にのみ伝播できることに注目してください。量子ビット4は他のどの量子ビットともエンタングルしていないため、他の量子ビットに広がることはできません。ここで、量子ビット4がこの回路においてほぼ無用であること、そして実際にこの回路全体が教育目的のためだけに構築されていることに注意してください。
しかし、量子ビット0のZゲート上のエラー(必ずしもZエラーである必要はなく、その位置での何らかのエラー)は、量子ビット0を制御、量子ビット1をターゲットとする最後のCNOTを介して、別の量子ビットである量子ビット1へ伝播する可能性があります。これは(b)の部分に示されています。予想されるとおり、回路の早い段階のエラーほど、より多くの量子ビットにわたって伝播する機会をしばしば持ちます。(c)の部分は、量子ビット0の初期状態準備でのエラーが、孤立している量子ビット4を除くすべての量子ビットに広がりうることを示しています。
この設定は、エラーが時間的に前方へ伝播して測定に影響を与える様子を示しています。しかし、逆の問いを検討することもできます。ある特定の単一量子ビットの測定について、回路のどの部分がエラーを寄与しえたのでしょうか?その場合、単に測定または他の着目点から出発し、(d)の部分に示されているように、エンタングルする回路をたどりながら回路を(時間的に)逆にさかのぼればよいのです。また、エラーが発生しうるいくつかのランダムに選ばれた点も示されています。
上記の図では、エラーはECRゲートを介して量子ビット間に広がりますが、同様の議論は他の2量子ビットゲートにも適用できます。これらのゲートには制御(コントロール)とターゲットがあります。制御上のエラーがゲートのロジックに影響を与え、その結果ターゲットにエラーが生じることは明らかです。では逆方向はどうでしょうか?ターゲット上のエラーは制御量子ビットに伝播するのでしょうか?ECRゲートにおける制御とターゲットの間の結合は、純粋に理想的なZX型ではなく、望ましくないZZ結合も持っていることを思い出してください。
ターゲット上のエラーがZZ結合と可換であれば、それは制御量子ビットに伝播することはできません。これは、働いている物理的メカニズムを通じて理解できます。手早く理解する方法は、エラーがと可換であれば、それらの順序を入れ替えても結果に影響しないという点です。しかし、結合の直前にが生じることが結合の後に作用することと同じであるならば、それは制御に影響を与えることはできません。なぜなら後者の場合、エラーは時間を遡って移動しなければならないことになるからです。エラーがZZ結合と可換でない場合、それはターゲットから制御へと逆に伝播する可能性があります。したがって、ECRゲートの場合、Zエラーはターゲットから制御へ伝播できませんが、XまたはYエラーは伝播できます。
理解度チェック
上の図の(d)の部分で、量子ビット0と1の間の垂直な線を見てください。一部のエラーがそれらの線を越えて広がりうるというのは正しいでしょうか?繰り返しますが、これはエラーの種類に依存する可能性があり、まだこの点については議論していません。問題は、それらの垂直な線で示されているように伝播しうるエラーが何か存在するかどうかです。説明してください。
答え
はい、正しいです。測定から逆方向に光円錐を描くと、何かがターゲットから制御へ動いていると主張しているように感じられるかもしれません。しかし、図が実際に意味しているのは、着目点でのエラーを引き起こすために、エラーが制御(量子ビット0)からターゲット(量子ビット1)へ動いた可能性があるということです。もしそれがエラーの種類に依存するというのがあなたの直感なら、それはまったく正しいです。この点は次のセクションで部分的に取り上げます。
上の図の回路のエラーのないバージョンから始めて、量子ビット2に作用する最初のアダマールゲートで発生するエラーの潜在的な広がりをたどってください。エラーが(a)位相反転、(b)ビット反転である場合に、回路の終わりまでに影響を受けうるすべての量子ビットを列挙してください。ヒント: 各量子ビット上の情報がどのように使われているかを考えてみてください。
答え
(a) 量子ビット3が影響を受ける可能性があり、当然ながら量子ビット2自体もそうです。それ以外はありません!量子ビット0や1を挙げた場合、量子ビット2は量子ビット1とエンタングルするECRのターゲットであることに注意してください。そのゲートでは量子ビット1に変化はもたらされません。(b) 量子ビット0から3までが影響を受ける可能性があります。ビット反転すなわちXタイプのエラーは、ECRゲート内のZZ結合と交換しないため、ターゲットから制御へと伝播しうるのです。
エラーの伝播
前のセクションでは、正式な定義を与えないままエラーの伝播について議論しました。これからは:
回路の論理的な処理のある部分の前に発生するエラーについて、エラーの伝播とは、の前ではなく後に適用された場合に同じ誤った結果を再現する等価な演算子を見つけることを意味します。
前のセクションのエラー伝播の図は、エラーがCNOTゲートを越えて制御量子ビットからターゲット量子ビットへ広がりうることを示唆していました。これがいつ成り立つかを確認する一つの方法は、エンタングルメント前の制御またはターゲット上のエラーを考え、その演算子がCNOTゲートと交換するかどうかを確認することです。2つの演算子が交換するなら、それらを逆順に適用しても違いはなく、つまりそのエラーは他の量子ビットに何ら影響を与えることなく、単に「CNOTを通り過ぎる」ことができるということです。これはエラー伝播に取り組む最も一般的な方法であり、次の規則が導かれます。
制御を量子ビット0、ターゲットを量子ビット1としましょう。制御およびターゲット量子ビット上のXおよびZエラー(それぞれ、、、)を考えます。これらのエラーをの後ろへ移動させると、エラーは次のようになります。
上記は証明なしに述べています。しかし、もしあなたがこのレッスンの著者のようにシュレーディンガー描像を好むなら、任意の制御およびターゲット状態を書き下し、エラーを適用してからCNOTを適用し、最終状態を調べることもできます。その最終状態をエラーのない場合と比較すれば、CNOTの後に適用するとその誤った状態を生み出すエラーの組み合わせが何かがわかり、特に、エラー操作が一方の量子ビットから他方へ広がったかどうかがわかります。
| 制御の初期状態 | ターゲットの初期状態 | エラー | 最終状態 | CNOT後のエラー等価物 |
|---|---|---|---|---|
| なし | 該当なし | |||
| 制御上のX | ||||
| 制御上のZ | ||||
| ターゲット上のX | ||||
| ターゲット上のZ |
意外に思われるかもしれませんが、ターゲット上のZエラーは実際に制御へと逆伝播するエラーを引き起こします!
ご想像のとおり、このようなエラー演算子の伝播を回路を通じて前方に追跡すること(あるいは同等に、測定される演算子を逆方向に伝播させること)は複雑です。Qiskitにはこれを容易にするツールがあり、最新のワークフローに関するレッスン6でそれについて学びます。
Shaded Lightconesという名前のQiskitアドオンがあります。陰影付き光円錐(SLC)アドオンは、パウリ伝播を用いて回路のどの部分が実際にターゲットのオブザーバブルに影響を与えうるかを特定することで、量子回路内のエラー伝播を解析します。これは主に、特に確率的エラー相殺(PEC)ワークフローにおいて、エラー緩和をより効率的にするために設計されています。ここではこのツールを簡単に紹介するにとどめ、今後のレッスンでエラー緩和技術の文脈でより広く活用します。これはパウリ演算子伝播を用いて、異なる種類のエラーの伝播をマッピングし、X、Y、Z型エラーに対する光円錐を生成します。
陰影付き光円錐 (SLC) はさらに一歩進み、古典シミュレーションを用いて回路全体のエラーに対する感度をより厳密に制限します。これはQPU時間の一部をCPU時間と交換するものであり、バイアスを再正規化するために必要なサンプリングオーバーヘッドを削減します。ハードカットオフの代わりに、回路内の各潜在的なエラーには、そのエラーに対するオブザーバブルの感受性の上限を示す段階的な「陰影」が割り当てられます。この洗練された特性評価により、分散を抑えつつPECのより効率的で的を絞った適用が可能になり、ユーザーはオブザーバブル推定におけるバイアスを制御可能な形で調整できるようになります。詳細については、Lightcone shading for classically accelerated quantum error mitigationを参照してください。
ここでは完全なワークフローは提示しません。このワークフローが回路をどのように処理するかを、図で簡単に示します。

このワークフローは、ノイズの挙動を学習するのに役立つ「ボックス」に回路を分割します。

最後に、演算子伝播とノイズ学習を用いて、回路全体にわたるエラー感受性の陰影マップを生成します。
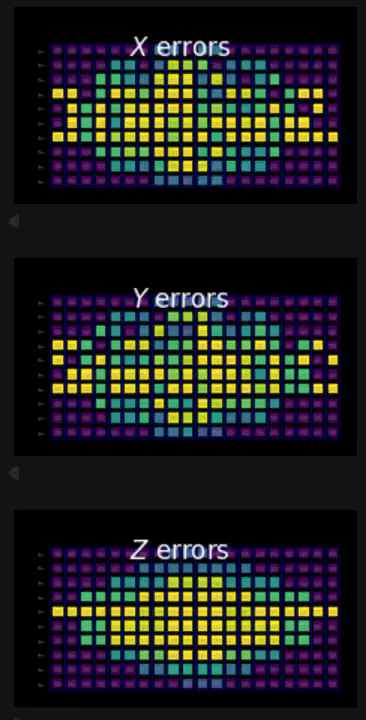
出力内の各色付きボックスは、特定の時刻における特定の量子ビットに対応しています。最も暗い(紫の)ボックスは、エラーが対象の測定に伝播し得ない量子ビットとレイヤーを示します。最も明るい(黄色の)ボックスは、エラーが対象の測定に強い影響を与え得る量子ビットとレイヤーに対応します。
各マップの右側にある紫色の領域に注目してください。測定と同じレイヤーにあるが異なる量子ビット上のエラーは、示されている回路の接続性を通じて測定に影響を与えることはできません。同様に、1レイヤー前(左に1レイヤー)のエラーは、エンタングルレイヤーの構造により、次のステップでは隣接する量子ビットにしか伝播できず、これが繰り返されます。したがって、対象の測定に関与する量子ビットが比較的少ない場合、右側にこのようなコーン形状が現れるのが一般的です。
理解度チェック
陰影付き光円錐マップは、トランスパイル前とトランスパイル後のどちらで作成する方が良いと思いますか?その理由も述べてください。
答え
これはトランスパイル後に行う必要があります。これらの異なるマップを有用なものにするためには、回路内の隣接する量子ビットが量子チップ上の隣接する量子ビットに対応していることを確認する必要があります。そうしなければ、回路図上で隣接する量子ビットに作用するように示されているエンタングルゲートは、結局SWAPゲートとより複雑な回路構造を必要とすることになります。