エラー緩和
このレッスンでは、さまざまなエラー緩和技術の背景を説明し、それらをどのような場面でどのように使うのが最適かを直感的に理解できるようにします。重要な点として、これらの技術の現代的な応用では、Samplomatic、Shaded Lightcones、Executorのようなより高度なツールが活用されます。それらのワークフローは、後のレッスンで扱います。
この動画では、エラー緩和技術の概要を説明します。以下のテキストでは、さらに詳しく解説し、Qiskitを使ってこれらの手法を探ります。
エラー緩和技術の概要
エラー緩和とは、量子計算でエラーが発生した後に、その影響を低減しようとするあらゆるプロセスを指します。これは、エラーの発生を防ごうとするエラー抑制や、多数の物理量子ビットにわたって情報を符号化し、その情報の整合性を確認することで単一の論理量子ビットの情報を保持するエラー訂正とは異なります。このレッスンを通して、エラー緩和技術は、理想的な期待値のより良い推定量、または確率分布のより良いサンプラーを構築する方法として理解するのが最適であり、実行中に量子状態を訂正する方法ではありません。以下でエラー緩和手法を見ていきます。これらはすべてQiskitとそのアドオンで利用でき、量子優位性の追求において有望なツールです。
**ツワールされた読み出しエラー消去(TREX)**は、測定の前にランダムに選んだPauli演算を適用し、その既知の影響を観測されたビット列から古典的に取り除くことで、測定プロセスをランダム化します。適切な測定ノイズの仮定のもとで、読み出しエラーチャネルをより単純で対称的な形に変換し、較正と緩和をしやすくします。
**行列を使わない測定緩和(M3)**は、割り当て行列やその逆行列を明示的に構築することを避ける、スケーラブルな測定エラー緩和技術です。
**ゼロノイズ外挿(ZNE)**は、ノイズを既知の係数で人為的にスケールさせ、ゼロノイズの場合へ外挿して戻すことで、ノイズがない場合にオブザーバブルが持つ値を近似します。これには、ノイズが予測可能な形でスケールする必要があります。その予測可能性を得るために、このレッスンで説明する他の手法(パルス・ストレッチ、ゲート・フォールディング、確率的エラー増幅(PEA))が必要になる場合があります。
**確率的エラーキャンセレーション(PEC)**は、最も強力なエラー緩和技術の一つですが、計算コストも最も高い技術の一つです。システムのノイズの振る舞いを学習し、理想的な計算の不偏推定量を統計的に構築することでノイズを打ち消そうとします。PECが出力するのは統計的に補正されたオブザーバブルであり、エラー訂正された結果ではありません。
それでは、これらの手法を一つずつ詳しく見ていきましょう。
M3
測定エラーは、近い将来の量子デバイスにおいて、最も根強く、かつハードウェア固有のノイズ源の一つです。量子状態が正しく準備され発展した場合でも、最終的な読み出しの段階で、真の計算基底の結果を誤って報告することがあります。これらのエラーは、とに対応する物理状態の不完全な識別、測定中の緩和、測定用電子機器の不完全さから生じます。その結果、観測されたビット列の分布は、真の(理想的な)分布が歪んだものになることが多く、確率が結果間で誤って再配分されます。
測定緩和は、測定結果がどのように誤って割り当てられるかを明示的にモデル化することで、この問題に対処します。標準的な定式化では、この振る舞いは割り当て行列で表されます。その要素は、真の基底状態がであったときに結果が記録される確率を表します。測定ノイズが古典的で定常的であれば、観測された確率ベクトルは、理想的な分布と次の単純な線形関係で結ばれます。
割り当て行列は古典的な確率写像であり、量子チャネルではないことに注意してください。これは古典的な読み出し結果に作用するものであり、その読み出し結果を得るためにサンプリングされた元の量子状態に作用するものではありません。
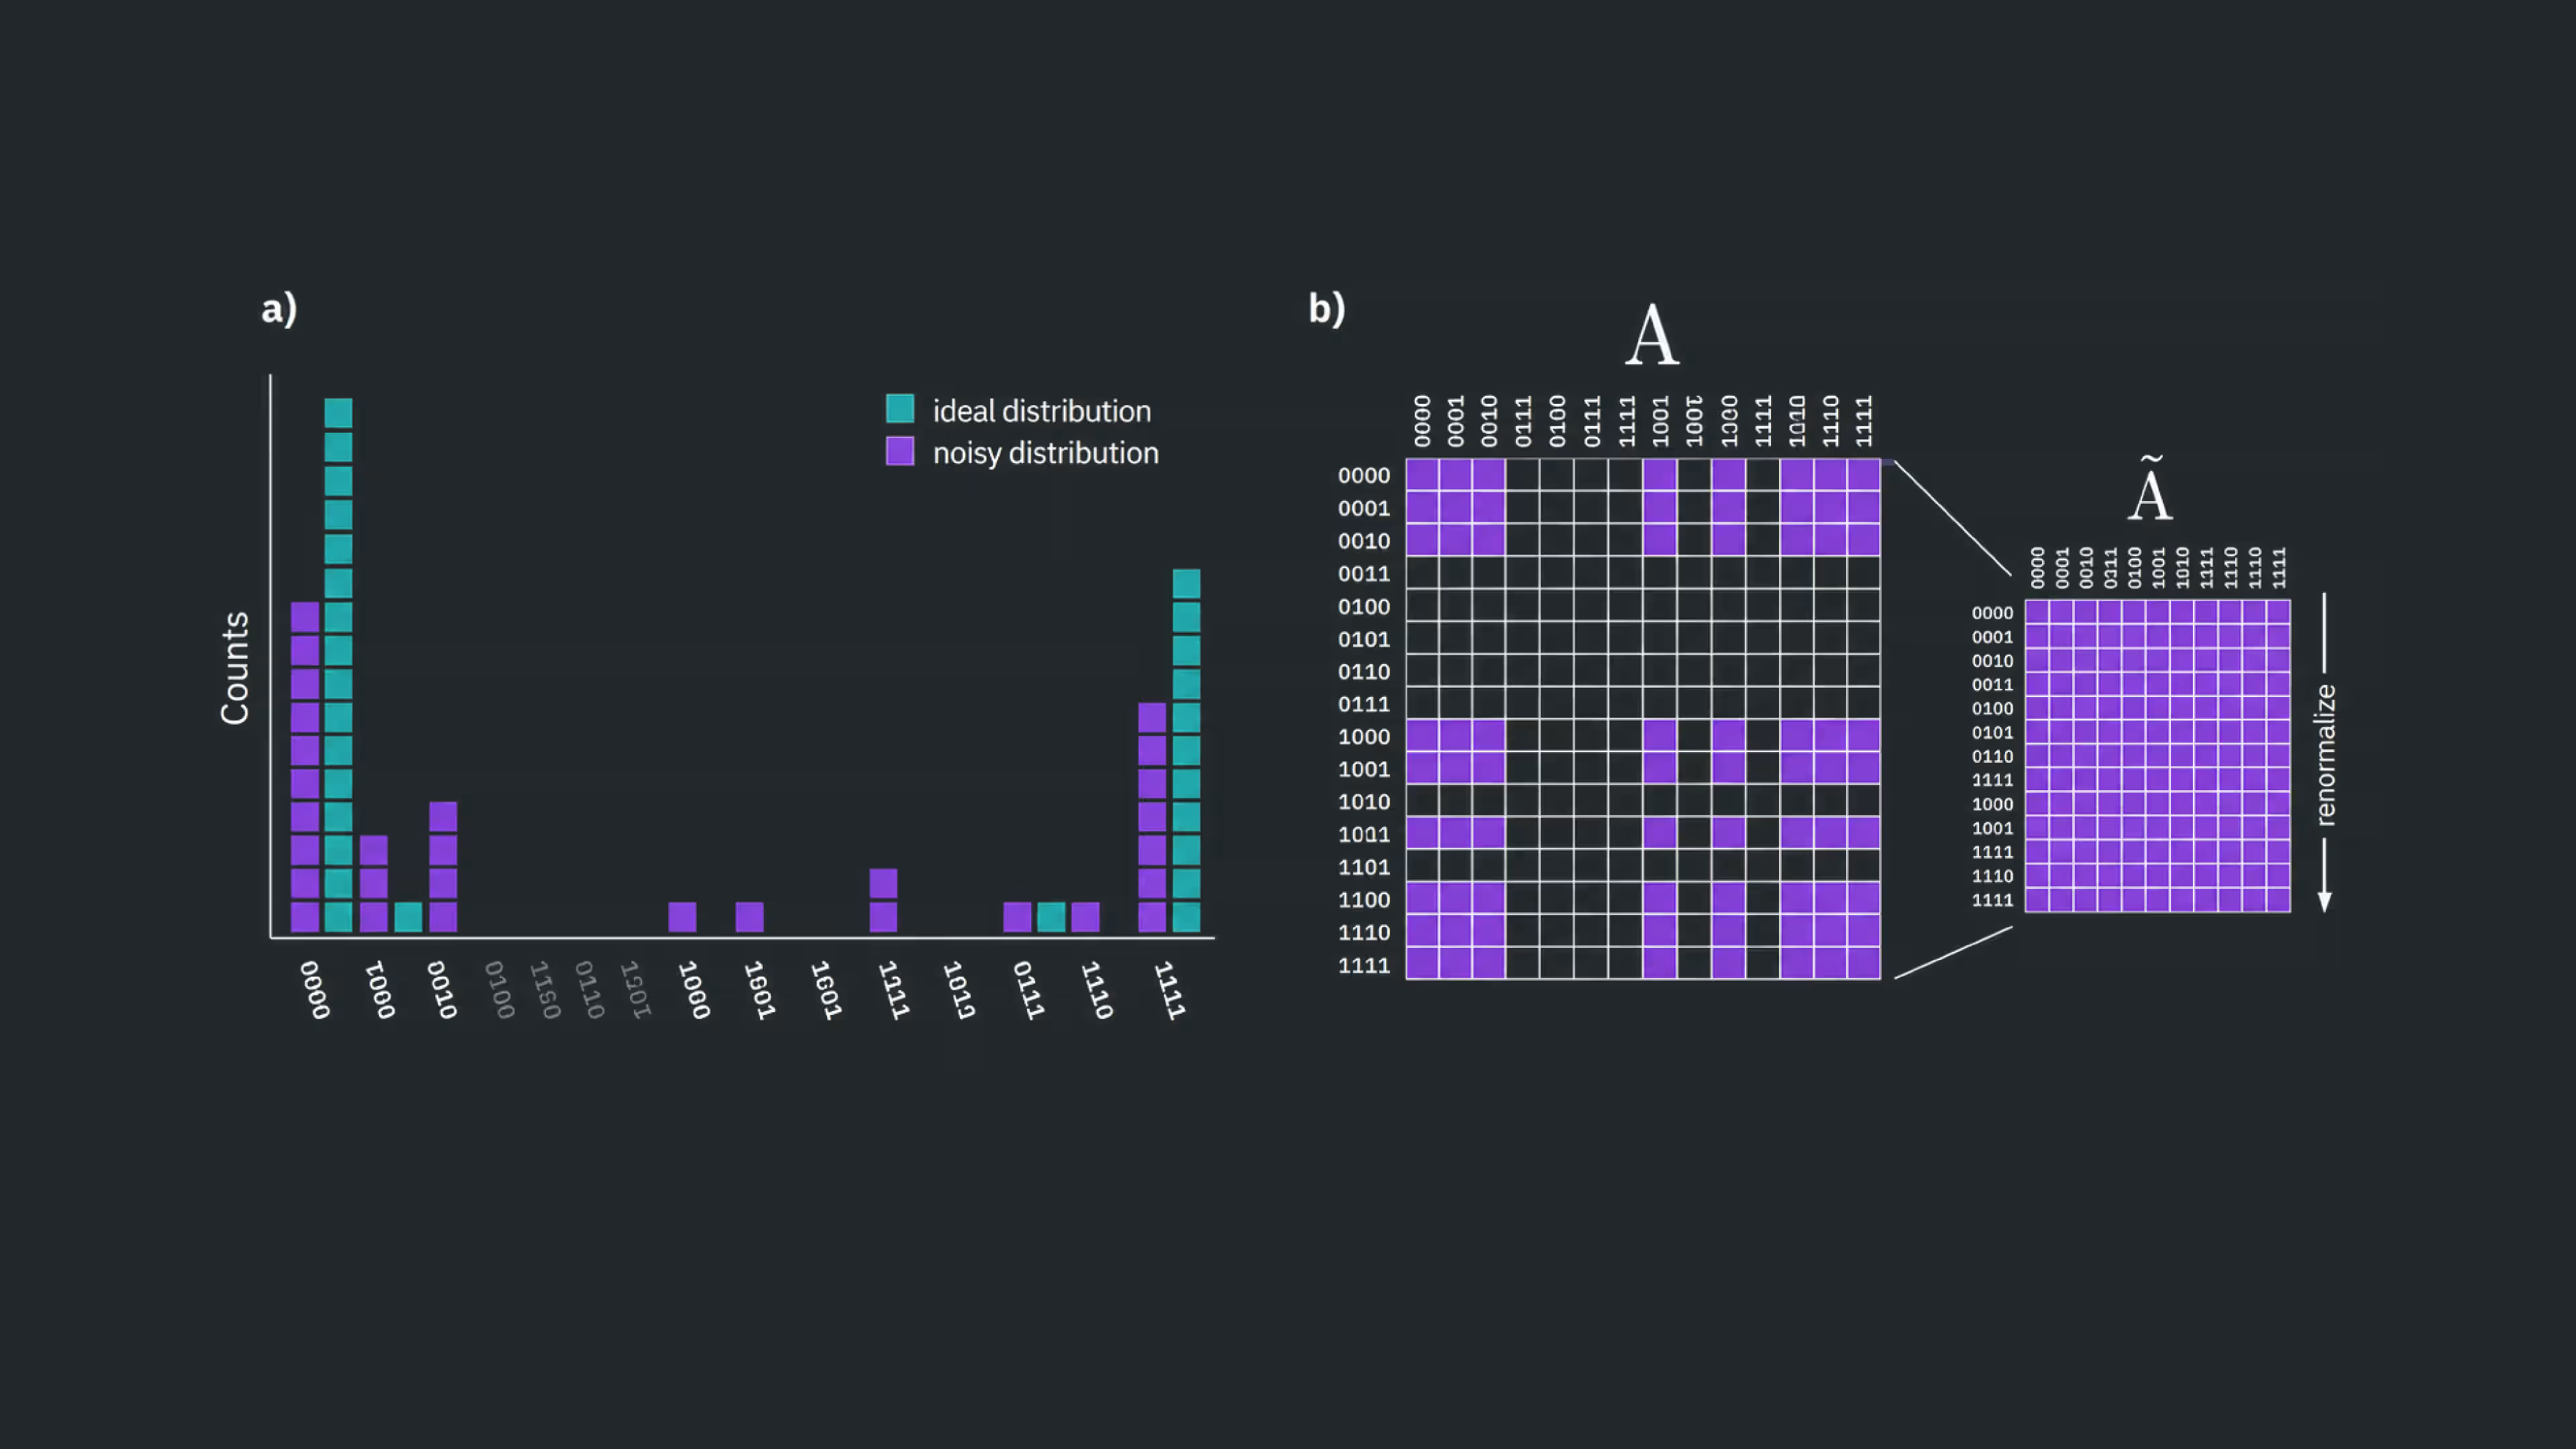
行列を使わない測定緩和(M3)は、この構造を利用して、完全な行列を構築したり反転したりすることなく、の緩和された推定値を構築します。量子ビット数が多い場合、完全な行列は扱えません。代わりにM3は、近い将来の多くの量子ワークロードが、鋭いピークを持つ、あるいはエントロピーの低い分布を生成するという事実を利用し、観測された分布に大きく寄与する結果の部分集合だけに緩和を集中させます。
割り当てモデルを構築するには、量子ハードウェア上で追加の較正実験を実行する必要があります。これには通常、既知の計算基底状態を準備し、それらが測定システムによってどのように報告されるかを記録することが含まれます。較正のオーバーヘッドは測定する量子ビット数に応じてスケールし、緩和の計算コストは観測された分布の構造に依存します。このコストは、の完全な割り当て行列を明示的に特徴づけるのに必要なコストよりはるかに小さくなります。この較正のオーバーヘッドは確かに存在しますが、ゼロノイズ外挿や確率的エラーキャンセレーションのような回路レベルの技術と比べれば軽量であり、M3は近い将来の量子実験における読み出しエラーの緩和に、実用的で広く使われるツールとなっています。
較正が有用なのは、較正実行から対象の実験までの間、測定プロセスが十分に安定している範囲に限られることに注意してください。
まず、その仕組みを示すために簡単なケースを手作業で行い、次にQiskitに組み込まれたツールを使って、より現実的な規模でのM3の使い方を示します。
M3の小さな例
まず、簡単なBell状態を構築します。
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "mthree": "mthree", "numpy": "numpy", "qiskit": "qiskit", "qiskit_aer": "qiskit-aer", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit import QuantumCircuit
import numpy as np

qc = QuantumCircuit(2, 2)
qc.h(0)
qc.cx(0, 1)
qc.measure([0, 1], [0, 1])
<qiskit.circuit.instructionset.InstructionSet at 0x714a5fa4d630>
この例は非常に小さな回路に限定しているため、ノイズモデル付きのシミュレーターを使用できます。ノイズモデルには、次の形の読み出しエラーを明示的に設定します。
if true=0: [95% chance of reading 0, 5% chance of reading 1]
if true=1: [8% chance of reading 0, 92% chance of reading 1]
これらの読み出しエラー率は、実際のIBM®量子コンピューターで見られるものよりはるかに高い値です。M3の効果をはっきりと確認できるよう、教育上の理由から高い値を選んでいます。
from qiskit_aer import AerSimulator
from qiskit_aer.noise import NoiseModel, ReadoutError

ro_error = ReadoutError([[0.95, 0.05], [0.08, 0.92]])

noise_model = NoiseModel()
noise_model.add_readout_error(ro_error, [0])
noise_model.add_readout_error(ro_error, [1])

backend_noisy = AerSimulator(noise_model=noise_model)
この回路をノイズのあるシミュレーターで実行して、読み出しエラーの影響を観察できます。
result = backend_noisy.run(qc, shots=5000, seed_simulator=123).result()
raw_counts = result.get_counts()
raw_counts
{'01': 290, '11': 2165, '10': 304, '00': 2241}
このおもちゃの例では、ノイズモデルの読み出しエラーを私たちが定義しました。しかし実際の量子コンピューターを使う場合、読み出しエラーは事前にはわかりません。代わりに、実験的に推定する必要があります。そのために、既知の計算基底状態またはに量子ビットを準備して測定する回路を作成します。読み出しエラーがなければ、準備した状態がそのまま測定されるはずです。これらの測定から統計を集めることで、読み出しエラーを記述する割り当て行列を構築できます。このおもちゃの例では、私たちが定義したものに近い行列になるはずです。
より現実的なシステムでは、物理量子ビットごとに統計を蓄積する必要があります。トランスパイルは抽象的な回路をハードウェアにマッピングし、量子ビット番号が変わるため、これは簡単でないことがあります。この点は次の例で改めて取り上げます。このシミュレーターの例では、すべての量子ビットに同じ読み出しエラーモデルを割り当てたため、1回の特性評価で十分です。
# Define a function to make a state and measure it.
def measure_state(state):
    qc = QuantumCircuit(1, 1)
    if state == 1:
        qc.x(0)
    qc.measure(0, 0)
    return backend_noisy.run(qc, shots=5000, seed_simulator=123).result().get_counts()
# Use the function to get statistics on readout errors
cal_counts_0 = measure_state(0)  # True state = 0
cal_counts_1 = measure_state(1)  # True state = 1

cal_counts_0, cal_counts_1
({'1': 244, '0': 4756}, {'0': 420, '1': 4580})
# Create the normalized readout error matrix

# def normalize(d):
#    s = sum(d.values())
#    return {k: v/s for k,v in d.items()}
# p0 = normalize(cal_counts_0)
# p1 = normalize(cal_counts_1)

p0 = {k: v / sum(cal_counts_0.values()) for k, v in cal_counts_0.items()}
p1 = {k: v / sum(cal_counts_1.values()) for k, v in cal_counts_1.items()}

A_1q = np.array(
    [
        [p0["0"], p1["0"]],  # row: measured 0, columns true 0/1
        [p0["1"], p1["1"]],
    ]
)
A_1q
array([[0.9512, 0.084 ],
       [0.0488, 0.916 ]])
これは、シミュレーターの構築に使用した読み出しエラー行列に非常に近いことに注意してください。
繰り返しになりますが、実際の量子コンピューターでは、複数の物理量子ビットについてこのような統計を取得します。このシミュレーターでは、2つの量子ビットが同一かつ独立した読み出しエラーを持つと仮定するため、対応する1量子ビット行列のテンソル積として2量子ビットの割り当て行列A_2qを構築できます。また、M3の目的は割り当て行列全体を構築することではない点にも注意してください。M3は、観測された分布に大きく寄与する結果の部分集合に焦点を当てます。ここでは、仕組みを見るために、非常に小さな例について行列全体を構築します。qiskit-ibm-runtimeのM3の実装は、このおもちゃの例よりも洗練されています。異なる読み出し特性を持つ多数の量子ビットを扱いながら、完全な割り当て行列の構築を避ける必要があるためです。
A_2q = np.kron(A_1q, A_1q)
print(A_2q)
[[0.89794576 0.07107    0.07107    0.005625  ]
 [0.04965424 0.87653    0.00393    0.069375  ]
 [0.04965424 0.00393    0.87653    0.069375  ]
 [0.00274576 0.04847    0.04847    0.855625  ]]
この例では、異なる量子ビット上の読み出しエラーは独立であると仮定します。これにより、2量子ビットの割り当て行列を、対応する1量子ビット行列のテンソル積として構築できます。
比較のために、生の結果と緩和後の結果を取得します。
bitstrings = ["00", "01", "10", "11"]
# Normalize raw counts
raw_probs = np.array([raw_counts.get(b, 0) for b in bitstrings], dtype=float)
raw_probs /= raw_probs.sum()
raw_probs
array([0.4482, 0.0592, 0.0598, 0.4328])
ここまでで、測定プロセスが理想的な結果の確率をどのように歪めるかを実験的に特徴づけました。次の目標は、この歪みを元に戻し、得られた補正を生の確率に適用することです。
ここでは物理的な補正ではなく線形逆変換を行っているため、結果として得られる「確率」が常に正になるとは限りません。非常に小さな負の準確率が現れるのは想定どおりであり、測定緩和が物理的な確率分布ではなく推定量を生成することを反映しています。
# Explicit inversion is feasible only for very small systems
# This is why M3 avoids creating the entire A matrix.

A_inv = np.linalg.inv(A_2q)

# Note: mitigated_probs might contain negative values.
# This is expected and reflects estimator, not physical, probabilities.

mitigated_probs = A_inv @ raw_probs
print(mitigated_probs)
[ 4.96000451e-01 -4.69852308e-04 2.17747967e-04 5.04251654e-01]
プロットのために、これらをカウントに変換します。
shots = sum(raw_counts.values())  # e.g., 5000
ideal_probs = [0.50, 0.00, 0.00, 0.50]  # ideal Bell distribution
# Convert probabilities to integer counts for plotting only.
# Not physically meaningful when probabilities are negative

def probs_to_counts(bitstrings, probs, shots):
    """
    Convert a probability vector into a Qiskit-style counts dictionary.
    Ensures integer shot counts and correct normalization.
    """
    counts = {}
    # First convert to raw integer counts
    int_counts = [round(p * shots) for p in probs]
    # Fix rounding error by adjusting the last entry
    diff = shots - sum(int_counts)
    int_counts[-1] += diff
    # Build dict
    for b, c in zip(bitstrings, int_counts):
        if c > 0:
            counts[b] = c
    return counts

mitigated_counts = probs_to_counts(bitstrings, mitigated_probs, shots)
ideal_counts = probs_to_counts(bitstrings, ideal_probs, shots)
最後に、生の分布、緩和後の分布、理想的な分布を見てみます。以下の緩和後の「カウント」は、緩和された準確率を再スケールして得た、可視化のための補助にすぎません。
from qiskit.visualization import plot_histogram

plot_histogram(
    [raw_counts, mitigated_counts, ideal_counts],
    legend=["Raw", "Mitigated", "Ideal"],
    sort="asc",
    title="Raw vs Mitigated vs Ideal",
)
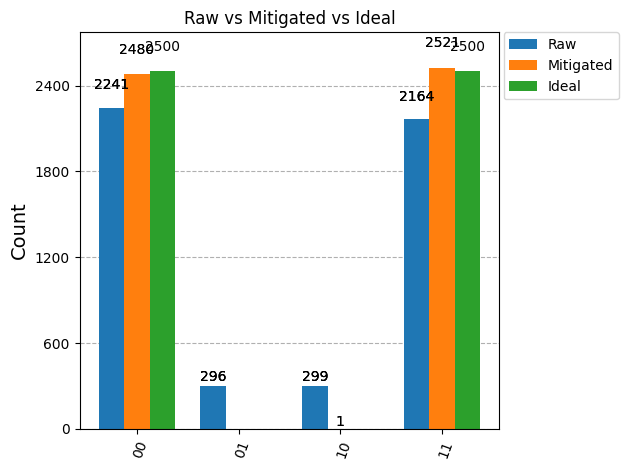
M3で緩和した結果が理想的な分布にはるかに近くなっていることは明らかで、その理由もわかります。
M3をより現実的なワークフローに適用するのは、はるかに複雑です。次の点を考えてみましょう。
- 実際の量子コンピューターには多数の物理量子ビットがあり、それぞれが固有の読み出しエラー特性を持っています。これらのエラーを適切にモデル化して組み合わせる必要があります。
- 完全な割り当て行列は量子ビット数に対して指数的に大きくなり、明示的に構築することはすぐに非現実的になります。これが、M3が割り当て行列全体を構築するのではなく、観測された分布に大きく寄与する結果の部分集合に焦点を当てる理由です。
- 関心のある実際の問題では、理想的な分布がわからないこともあります。
これらすべての理由から、完全な緩和ワークフローはmthreeというQiskitアドオンにまとめられています。
より大きなM3の例
次に、より大きな回路にM3を適用します。関連するの部分空間を手作業で決定するのは面倒ですが、理想的な分布がわかる程度には単純な回路、つまりGHZ状態です。まずmthreeパッケージをインポートし、GHZ量子回路を定義します。
import numpy as np
from qiskit import QuantumCircuit

# from qiskit_ibm_runtime.fake_provider import FakeCasablancaV2
import mthree

num_qubits = 10

qc = QuantumCircuit(num_qubits)
qc.reset(range(num_qubits))
qc.h(0)
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)
qc.measure_all()
qc.draw("mpl")
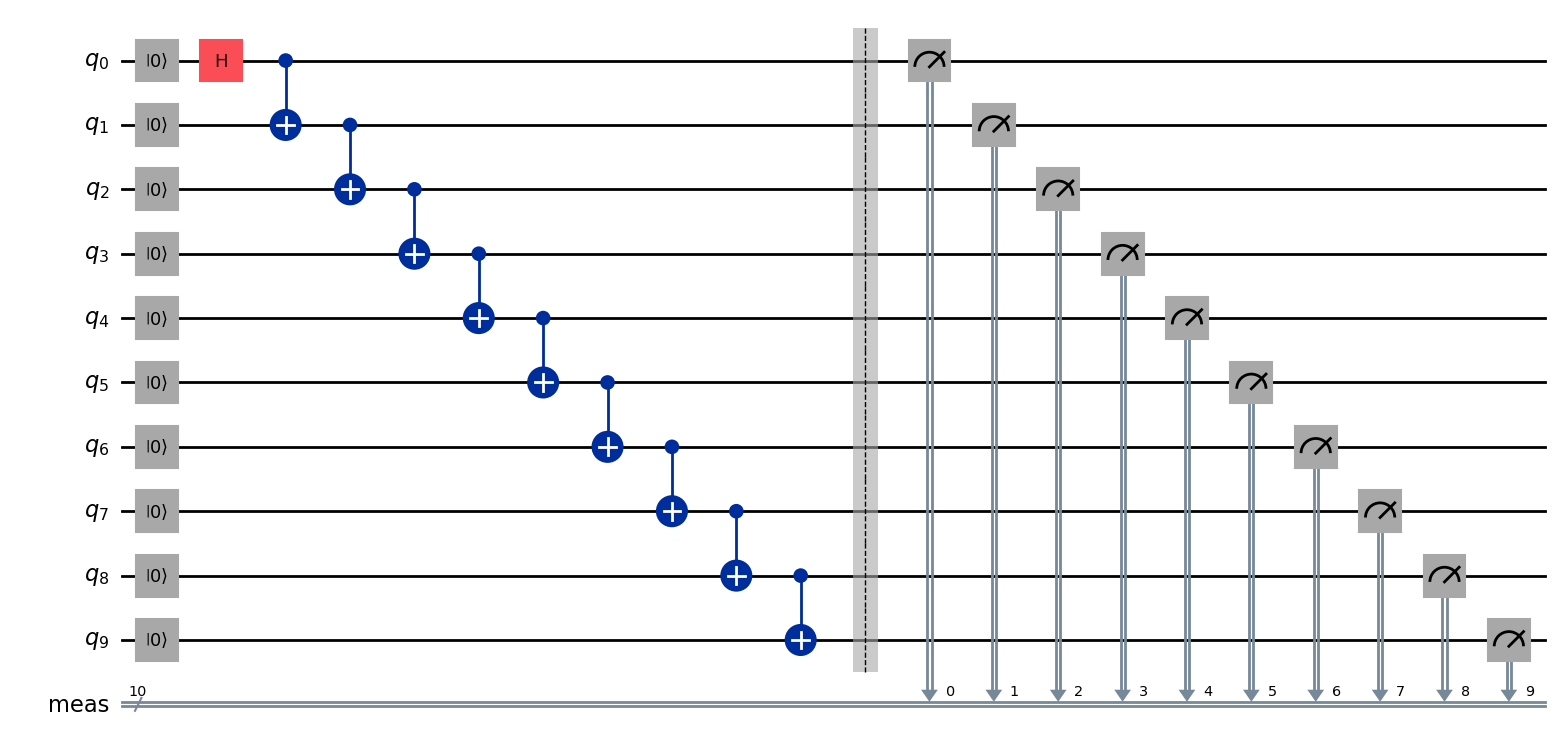
これを実際の量子コンピューターで実行するために、qiskit_ibm_runtimeと必要なその他のパッケージをインポートします。出力の分布を得るためにSamplerV2を使用します。
# Import packages needed for using real quantum computers

from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit_ibm_runtime.executor_sampler import SamplerV2 as Sampler
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

# --------- Configuration ----------
service = QiskitRuntimeService(channel="ibm_quantum_platform", instance="your crn here")

# backend_real = service.backend("ibm_fez")     # adjust if needed
backend_real = service.least_busy(simulator=False, operational=True)
次に、回路をバックエンド向けにトランスパイルします。ここでは、追加のツールを加えずにM3の効果に焦点を当てるため、最適化レベルを0に設定します。これは、最終的な忠実度が、利用可能なツール一式を使ってIBM Quantum®ハードウェアで達成できる値を代表するものではないことを意味しますが、M3の有用性に絞って確認できます。
# Exclude any optimization to focus only on M3 effects
opt_level = 0
pm = generate_preset_pass_manager(optimization_level=opt_level, backend=backend_real)
qc_isa = pm.run(qc)
次にSamplerを設定します。ここでも、動的デカップリングやツワリングなどの追加のエラー抑制技術は無効にします。
shots = 8192

# No twirling
sampler_no_twirl = Sampler(mode=backend_real)
sampler_no_twirl.options.twirling.enable_gates = False
sampler_no_twirl.options.twirling.enable_measure = False
sampler_no_twirl.options.default_shots = shots
sampler_no_twirl.options.dynamical_decoupling.enable = False
最後に、ジョブを実行します。
# This job took 7 seconds on ibm_fez. Your actual execution time can vary.
job = sampler_no_twirl.run([qc_isa])
res_real = job.result()
job_id = job.job_id()
print("job number for real  ", job_id)
job number for real d7ark4e5nvhs73a2fu6g
上の回路から生のカウントを取り出せます。
counts_real = []
for i in range(len(res_real)):
    counts_real.append(res_real[i].data.meas.get_counts())
次に、バックエンド上でmthreeを実行して、測定緩和に使用する割り当てモデルを特徴づけます。その情報を使って生の分布を再スケールします。これにより、ごく小さな負の確率が生じることがある点に注意してください(そのため準確率という用語が使われます)。
# Added 6 sec on ibm_fez, on top of original 7 sec to run circuits. Your time might differ.
mit_real = mthree.M3Mitigation(backend_real)
mappings_real = mthree.utils.final_measurement_mapping(qc_isa)
mit_real.cals_from_system(mappings_real)
quasis_real = mit_real.apply_correction(counts_real, mappings_real)
mthreeによる補正はカウントではなく準確率を生成します。手作業でカウントに再スケールできます。下のヘルパー関数は、カウントに変換して整数値に丸めます。また、大きな回路では、カウントが非常に少ない誤ったビット列が多数現れ、ヒストグラムが煩雑になります。下の2つ目のヘルパー関数は、選んだしきい値より少ないカウントのビット列を取り除き、分布の支配的な項をはっきり見られるようにします。
def quasidistribution_to_counts(quasi_list, shots):
    return [
        {bitstr: int(round(float(prob) * shots)) for bitstr, prob in quasi.items()}
        for quasi in quasi_list
    ]

def filter_counts_by_threshold(counts_list, t):
    filtered = []

    for counts in counts_list:
        new_counts = {}
        for bitstr, val in counts.items():
            c = int(round(float(val)))  # FORCE conversion
            if abs(c) >= t:
                new_counts[bitstr] = c
        filtered.append(new_counts)

    return filtered
quasi_counts = quasidistribution_to_counts(quasis_real, shots)
trim_threshold = 30
trimmed_quasi = filter_counts_by_threshold(quasi_counts, trim_threshold)
trimmed_raw = filter_counts_by_threshold(counts_real, trim_threshold)
比較のために、すべてゼロの状態とすべて1の状態が等確率で、他のすべての結果の確率がゼロとなる、理論上の理想的な分布も簡単に作成できます。
ideal = [
    {
        "0" * num_qubits: int(round(float(shots) / 2)),
        "1" * num_qubits: int(round(float(shots) / 2)),
    }
]
最後に、結果を可視化します。
from qiskit.visualization import plot_histogram

plot_histogram(
    [trimmed_raw[0], trimmed_quasi[0], ideal[0]],
    legend=["Raw", "Mitigated", "Ideal"],
    sort="asc",
    title="Raw vs Mitigated vs Ideal",
)
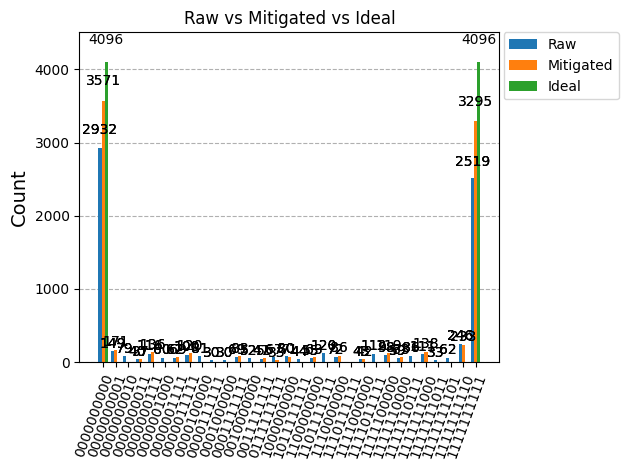
緩和後の結果は、緩和前の結果よりも理想的な分布に近くなっています。理想的なビット列のカウントを使えば、これをより定量的に評価できます。
def extract_all_zero_and_all_one(counts):
    """
    Extract counts for the all-0 and all-1 bitstrings.

    Parameters
    ----------
    counts : dict[str, int]
        Counts dictionary.

    Returns
    -------
    dict[str, int]
        Dictionary containing only 00...0 and 11...1 entries if present.
    """
    n = len(next(iter(counts)))  # infer bitstring length
    zero_state = "0" * n
    one_state = "1" * n

    return {k: counts[k] for k in (zero_state, one_state) if k in counts}

correct_counts_raw = extract_all_zero_and_all_one(trimmed_raw[0])
correct_counts_mitigated = extract_all_zero_and_all_one(trimmed_quasi[0])
keys = ["0" * num_qubits, "1" * num_qubits]
fidelity_raw = (
    correct_counts_raw.get(keys[0]) + correct_counts_raw.get(keys[1])
) / shots
fidelity_mit = (
    correct_counts_mitigated.get(keys[0]) + correct_counts_mitigated.get(keys[1])
) / shots
print("Percent correct raw counts: ", fidelity_raw)
print("Percent correct mitigated counts: ", fidelity_mit)
Percent correct raw counts:  0.6654052734375
Percent correct mitigated counts:  0.838134765625
この簡単なツールにより、比較的低いオーバーヘッドで、緩和前の忠実度に対して忠実度が26%向上しました。M3が非常に価値あるものになり得ることは明らかです。ただし、GHZ回路は2つの出力状態に強いピークを持つため、適した使用例として選ばれています。問題によっては、カウントがより均等に分布する場合(高エントロピー状態)があります。多数の量子ビットを持つ非常に深い回路では、ゲートエラーや測定エラーとは無関係のノイズによって、高エントロピー状態になることがよくあります。そのような場合、M3はかなり大きな状態空間で動作します。これには3つの対処法が考えられます。
(1) これをM3の限界として受け入れる。
(2) M3が形成する行列の空間の上限は、ではなくnum_shots num_shotsであり、量子ビット数が大きい場合は前者のほうがはるかに小さいことに注意してください。
(3) 十分に注意した上でのみ、M3に入力する生のカウントから確率が非常に低いビット列を取り除きます。これはバイアスを生じさせる可能性があり、状態のサポートを制限するとKrylov法のような手法の収束を妨げることがあります。これは、なぜそうするのかを正確に理解し、そのすべての影響を予測できる場合にのみ行ってください。このようなトリミングがM3の組み込み機能ではないのは、そのためです。
mthree Qiskitアドオンの詳細については、そのドキュメントで、例、インストール手順、背景、APIリファレンスを参照してください。
ツワールされた読み出しエラー消去(TREX)
ツワールされた読み出しエラー消去(TREX)は、現代の量子コンピューターで使われる測定エラー緩和技術です。その目的は、測定の割り当て行列の完全な特性評価や反転を必要とせずに、古典的な読み出しエラーによって生じるバイアスを取り除くことです。
TREXはエラー訂正ではなく、状態の忠実度を向上させるものでもありません。代わりに、ランダム化された測定基底にわたって平均を取り、再スケールすることで、期待値の推定量が統計誤差の範囲で読み出しノイズに対して不偏になるようにします。IBM Quantumハードウェアでは、TREXは期待値推定のデフォルトの緩和手法であり、IBM Quantum Estimatorプリミティブのresilience_level = 1に対応します。
超伝導ハードウェアにおける読み出しエラーの性質
IBMの超伝導量子ビットでは、読み出しエラーは主に次の要因によって支配されます。
-
非対称なビット反転確率(たとえば、のほうが逆よりも頻繁に起こる)
-
測定そのものの最中に起こる状態依存の緩和
-
隣接する読み出し共振器間の、軽度ではあるが無視できないクロストーク
重要な点として、これらのエラーは多くの場合、測定結果に作用する古典的な確率過程としてモデル化できます。TREXは、ノイズ・テイラリングの標準的な考え方である、測定手順のランダム化(ツワリング)を利用します。TREXは通常、次の2つの段階で進みます。
-
ツワリングと古典的な「アンツワリング」
-
較正回路を用いた期待値の再スケール
オブザーバブルの期待値が、次のようにノイズを含む推定値と関係しているとします。
ここでは推定値をスケールする固定の係数であり、は上述の要因によるバイアスです。ここでを使っているのは、ここでは読み出しエラーのみを扱っており、ゲートエラーはまだ考慮が必要であることを思い出すためです。
測定の直前に、各量子ビットにPauli演算子(IやXなど)をランダムに共役させます。測定結果は、その後で古典的にアンツワールされます。
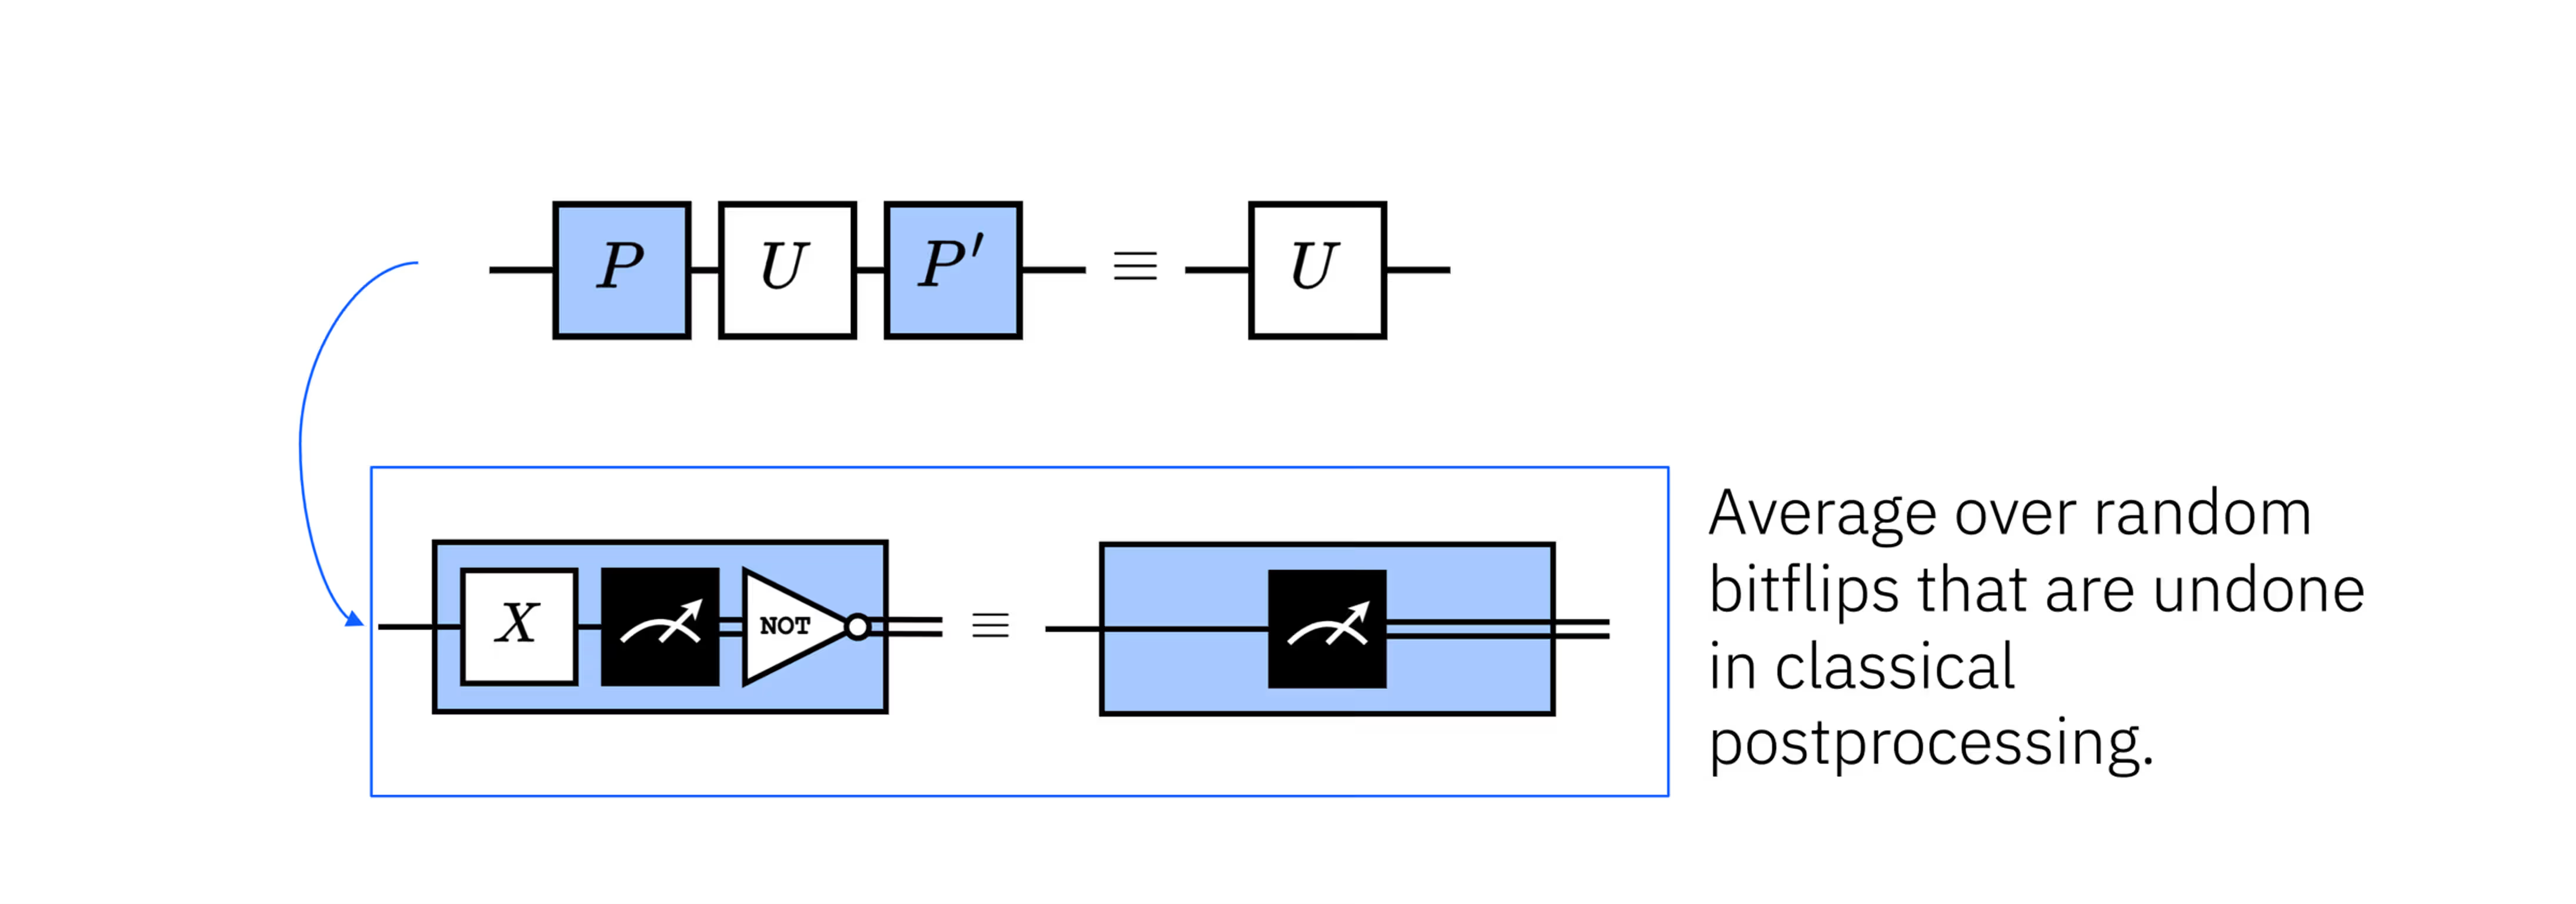
これらのランダム化にわたって平均を取ることで、読み出しチャネルが対称化されます。その結果、読み出しプロセスにおける系統的な非対称性は、より対称的なエラーチャネルに変換され、残る影響は較正と再スケールによって扱えます。簡単に言えば、たとえば状態に偏りがあれば、の測定の一部が失われることになります。測定の前後でツワリングを行うことで、どの論理的な結果が物理的な読み出しプロセスに対応するかをランダムに入れ替え、その後で古典的にその入れ替えを元に戻します。このようなランダム化された測定を多数回平均すると、一方の報告結果を他方より優先する系統的な偏りが取り除かれます。これにより、TREXモデルの仮定のもとで支配的な測定バイアスが除去され、次のようになります。
ただし、期待値は依然として再スケールが必要な場合があります。2つ目の段階では、較正回路(結果が既知の回路)を用いてスケール係数を推定します。これを使うことで、大幅に改善された推定値を得られます。
Pauliオブザーバブルの期待値は、理想値の不偏推定量になります。明示的なノイズモデルを学習したり反転したりしないため、TREXは数値的に安定で、低コストです。繰り返しますが、ここではゲートエラーには対処していません。
オブザーバブルの期待値の推定では、有限サンプリングによる分散、多くの種類のインコヒーレントおよびコヒーレントなエラー、そして読み出しエラーによるバイアスが存在し得ます。このバイアスは、これまで説明してきた非対称な遷移のような要因から生じます。実際には、このバイアスは量子発展の後に作用する古典的な確率チャネルとして、うまくモデル化できるのが一般的です。TREXは実効的な測定チャネルを変換し、の推定量が読み出しエラーに対して不偏になるようにします。これは、ツワリングゲートの最も単純な例であるXを使うと、比較的簡単にわかります。と比べてに非対称性がある場合でも、どちらの状態を読み出すかをランダムに入れ替え(後で古典的に元に戻す)ならば、系統的な非対称性は明らかに取り除かれます(ただし、有限サンプリングのため、測定にわずかな確率的非対称性が残る可能性はあります)。実際には、TREXのツワリングゲートはIとXに限られませんが、説明にはこれで十分です。
TREXにより、読み出しエラーによるバイアスのない期待値の推定値を得られます。コヒーレントな過回転など、他の要因によるバイアスは残る可能性があります。TREXが対象とするのは読み出しだけです。TREXは系統的なバイアスをランダム化された対称化に置き換えるため、一般にバイアスを追加の確率的分散に変換し、サンプリングコストを固定した場合の推定量の分散を増加させます。
理解度チェック
状態を準備した回路に対して、の推定にEstimatorを使うとします。さらに、測定エラーにより、に対応する結果が10%の確率でと報告され、に対応する結果は1%の確率でのみと報告されるとします。これらの報告エラーの非対称性が、測定バイアスを生じさせます。
(a) このような測定エラーがまったくない場合、オブザーバブルの理想的な期待値はいくつですか?
(b) 非対称な測定エラー(読み出しエラー)がある場合、オブザーバブルの期待値はいくつですか?
(c) PauliツワリングゲートをIとXの限られた集合に限定して考えます。IとXは、複数のショットでそれぞれ50%の確率でランダムに適用されるものとします。同じ測定エラー率が引き続き適用されます。その後、Pauliゲート(IまたはX)は古典的に元に戻されます。初期の重ね合わせ、非対称な測定エラー、ランダムに割り当てられたPauliゲートによって生じる、すべての可能な結果とその確率の表を作成してください。
(d) この表を用いて、ツワリング戦略を使った場合の期待値を求めてください。
(e) 期待値を比較してください。理想的な場合、ツワリングなしの場合、ツワリングありの場合です。
(f) この扱いでは、完全なTREXの適用に含まれるどのような要素が省かれていますか?
解答
(a) 直感と対称性から、単純にと言えます。明示的に示すと次のとおりです。
(b) 測定すると、状態はまたはのどちらかに、それぞれ50%の確率で崩壊します。しかし、状態に崩壊した50%のうち、その1%(全体の0.5%)はと誤って報告されます。に崩壊した50%のうち、10%(全体の5%)はと誤って報告されます。その結果、次のようになります。
- 54.5%
- 45.5% 他に起こり得るすべての種類のエラーを無視すると、次の推定値が得られます。
(c)
| Pauli | 理想的な測定結果 | Pauli適用後の結果 | 読み出しエラー | Pauliを元に戻す | 最終的に報告される結果 | 確率 |
|---|---|---|---|---|---|---|
| I | 0 | 0 | None | I | 0 | 50% 50% 99% = 24.75% |
| I | 0 | 0 | I | 1 | 50% 50% 1% = 0.25% | |
| I | 1 | 1 | None | I | 1 | 50% 50% 90% = 22.5% |
| I | 1 | 1 | I | 0 | 50% 50% 10% = 2.5% | |
| X | 0 | 1 | None | X | 0 | 50% 50% 90% = 22.5% |
| X | 0 | 1 | X | 1 | 50% 50% 10% = 2.5% | |
| X | 1 | 0 | None | X | 1 | 50% 50% 99% = 24.75% |
| X | 1 | 0 | X | 0 | 50% 50% 1% = 0.25% |
(d) 前の小問から、各最終状態におけるZの期待値はわかっています。あとは加重平均を取るだけです。
(e) この非常に単純なケースでは、ツワリングの適用によって理想的な期待値を正確に回復できました。これは典型的なことではありません。典型的なのは、ツワリングによって非対称な遷移などが生じさせるバイアスが取り除かれ、理想値により近い期待値が得られることです。
(f) これはおもちゃのモデルへの適用です。欠けているものがいくつかあるかもしれません。特に、ここではスケール係数を推定するための較正回路を実行していません。これは通常、必要になります。
実装の詳細
TREXは、EstimatorV2プリミティブをresilience_level = 1(デフォルト)で使用すると自動的に適用されます。Samplerプリミティブには自動的には適用されないことに注意してください。Samplerは期待値ではなく、完全な確率分布を返すためです。
TREXが有効な場合、ランタイムは測定の直前にランダムな1量子ビットPauliを挿入することで、測定ツワール済みの回路バリアントを生成します。古典的な後処理によって、これらのPauliは元に戻されます。これらの回路バリアントは、ショットごとに、またショット内の量子ビットごとにランダムです。その後、すべての回路バリアントは1つの推定量にまとめられます。
TREXは非常にスケーラブルです。追加の較正回路が必要ですが、サンプリングのオーバーヘッドは通常、小さな定数倍(多くの場合2~4倍)です。 ただし、この緩和はオブザーバブル固有であり、分布を保存するものではありません。
TREXは、次のものを含む、多くのエラー抑制およびエラー緩和手法とうまく統合できるよう設計されています。
-
動的デカップリング(DD) - アイドル時間中に作用し、読み出し緩和とは直交します。
-
ゲートまたはPauliツワリング - 補完的であることが多く、TREXはすでにツワリングに依拠していますが、対象は読み出しノイズのみです。
-
ゼロノイズ外挿(ZNE) - ZNEはゲートノイズを対象とし、TREXは測定バイアスを扱います。この組み合わせはレジリエンスレベル2で使用されます。
-
Estimatorワークフローにおける確率的エラー増幅と確率的エラーキャンセレーション。
ただし、TREXと組み合わせることができない(または組み合わせるべきでない)手法もあります。
-
Samplerレベルの確率補正 - TREXは補正されたビット列の確率を返しません。
-
すでに緩和されたTREXデータに対する事後的な緩和 - 二重の補正はバイアスを再び持ち込む可能性があります。
TREXをM3のような割り当て行列ベースの読み出しエラー緩和と組み合わせるのは難しい作業です。M3は測定チャネルが固定されていることを前提としていますが、TREXは意図的に測定をランダム化するため、M3の前提が成り立たなくなります。その意味で、これらの手法を単純に組み合わせることはできません。ただし、M3で使用するキャリブレーションの際に測定ツワイリングを適用すれば、割り当て行列に近いアプローチとツワイリングによる緩和アプローチの両方を同時に活用できる場合があります(ただし、このツワイリングのアプローチはTREXとまったく同じではありません)。これは、緩和手法と抑制手法を組み合わせる際によく見られるテーマです。やみくもに手法を追加しても失敗しますが、互いを「認識」するように慎重に追加すれば、うまく機能し、大きな効果が得られる可能性があります。
TREXが保証するのは、読み出しエラーによるバイアスを含まない期待値のみです。分散を減らすことはなく、他の種類のバイアスから保護するものでもありません。すべてのエラーを補正するわけではないことは言うまでもありません。しかし、多くの場合は大幅な改善が得られ、完全なノイズモデルの学習を必要とする他の手法よりもはるかに低いオーバーヘッドで実現できます。TREXは、利用可能な読み出しエラー緩和手法の中で、最もコストが低く最も堅牢であることが多く、実験におけるデフォルトとして最適です。
QiskitでのTREX
ここでは単純な2量子ビットの量子回路を作成し、Estimatorを使って非常に単純なオブザーバブル ZX の期待値を推定します。理想的な期待値は1です。TREXを使用した場合と使用しない場合の期待値を比較します。
# Import packages needed for using real quantum computers

from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp
from qiskit_ibm_runtime import QiskitRuntimeService, EstimatorV2, Session
import numpy as np

# --------- Configuration ----------

backend = service.backend("ibm_fez")  # adjust if needed
単純な量子回路を作成します。
qc = QuantumCircuit(2)
qc.x(0)
qc.h(0)
qc.cx(0, 1)
qc.h(0)
qc.barrier()
qc.draw("mpl")

パスマネージャーを使って回路をトランスパイルします。
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

pass_manager = generate_preset_pass_manager(optimization_level=1, backend=backend)

qc_t = pass_manager.run(qc)
トランスパイルで得られた同じレイアウトをオブザーバブルに適用します。
# Observable: X on qubit 0, Z on qubit 1, ideal expectation value is 1.0.
observable = SparsePauliOp("ZX")
observable_t = observable.apply_layout(qc_t.layout)
実際の量子コンピューターで実験を実行します。まず reslience_level = 1 で実行します。これはデフォルトですが、2つのケースを区別するために明示的に指定しています。
# First, we run this on an ideal simulator to confirm the ideal expectation value.

from qiskit.primitives import StatevectorEstimator as Estimator

estimator = Estimator()

job = estimator.run(pubs=[(qc, observable)])

res = job.result()
val = res[0].data.evs

print("⟨ZX⟩ ideal:", val)
⟨Z₀⟩ ideal: 0.9999999999999996
# This took 27 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 1,  # TREX
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observable_t)])

    res = job.result()
    val = res[0].data.evs

print("⟨ZX⟩ with TREX:", val)
⟨Z₀⟩ with TREX: 0.9520029143897996
次に、TREXなしで実行するために resilience_level を0に設定します。
# This took 12 sec on ibm_fez. Your runtime might differ.
with Session(backend=backend) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 0,  # TREX off
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observable_t)])

    res = job.result()
    val = res[0].data.evs

print("⟨ZX⟩ without TREX:", val)
⟨Z₀⟩ without TREX: 0.8651
予想どおり、TREXを使用した場合の期待値は理想値(1)にかなり近くなっています。 もちろん、これは1つの量子ビットに対する単一の期待値でした。次に、非クリフォードゲートと多数の量子ビットを使った回路を準備し、TREXによる改善が別の設定でも堅牢であるかどうかを検証します。
import numpy as np

num_qubits = 20
qc = QuantumCircuit(num_qubits)
for i in range(num_qubits):
    qc.rx(np.pi * 7 / 8, i)
qc.barrier()
CircuitInstruction(operation=Instruction(name='barrier', num_qubits=20, num_clbits=0, params=[]), qubits=(<Qubit register=(20, "q"), index=0>, <Qubit register=(20, "q"), index=1>, <Qubit register=(20, "q"), index=2>, <Qubit register=(20, "q"), index=3>, <Qubit register=(20, "q"), index=4>, <Qubit register=(20, "q"), index=5>, <Qubit register=(20, "q"), index=6>, <Qubit register=(20, "q"), index=7>, <Qubit register=(20, "q"), index=8>, <Qubit register=(20, "q"), index=9>, <Qubit register=(20, "q"), index=10>, <Qubit register=(20, "q"), index=11>, <Qubit register=(20, "q"), index=12>, <Qubit register=(20, "q"), index=13>, <Qubit register=(20, "q"), index=14>, <Qubit register=(20, "q"), index=15>, <Qubit register=(20, "q"), index=16>, <Qubit register=(20, "q"), index=17>, <Qubit register=(20, "q"), index=18>, <Qubit register=(20, "q"), index=19>), clbits=())
ここで、回転角 に特別な意味はありません。非対称なエラー遷移の影響と、TREXがそれらをどのように扱うかを調べるために、 と の不均等な重ね合わせであれば何でもよいので、これを選んだだけです。この状態に対して、エラー(読み出しエラーなど)がない場合の、すべての量子ビットにおけるZの理想的な期待値は次のようになります。
したがって、すべての量子ビットで-0.924に近い期待値が得られることを期待します。TREXが各期待値を個別に改善するかどうか、また全量子ビットの平均を改善するかどうかを確認します。
理解度を確認しましょう
上記の期待値を直接計算して検証してください。
解答
パスマネージャーを使ってトランスパイルします。
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

pass_manager = generate_preset_pass_manager(optimization_level=1, backend=backend_real)

qc_t = pass_manager.run(qc)
次に、20個すべての 期待値を単一のワークフローで推定できるように、量子ビットごとに1つのオブザーバブルを構築します。つまり、 番目の量子ビットについて、 番目の位置だけが で、それ以外はすべて恒等演算子 であるオブザーバブルが必要です。トランスパイルしたレイアウトをオブザーバブルにも適用することを忘れないでください。
# Observables: Z on qubit i for all i.
observables = []
for i in range(num_qubits):
    obs_string = "I" * i + "Z" + "I" * (num_qubits - i - 1)
    obs = SparsePauliOp(obs_string)
    observables.append(obs)
observables_t = [obs.apply_layout(qc_t.layout) for obs in observables]
これで実行できます。以下のコードセルではsession modeを使用しています。セッションにアクセスできない場合は、batch modeに置き換えることで、回路間にキュー待ち時間が発生する可能性はありますが、同じワークフローを実行できます。
# This took 20 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend_real) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 0,  # TREX turned off
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observables_t)])

    res_no_trex = job.result()
    val_no_trex = res_no_trex[0].data.evs

print("⟨Z_i⟩ without TREX:", val_no_trex)
⟨Z_i⟩ without TREX: [-0.90645 -0.89755 -0.89125 -0.9165  -0.87655 -0.91035 -0.8757  -0.87905
 -0.66035 -0.8876  -0.87125 -0.89975 -0.83745 -0.89755 -0.82645 -0.90325
 -0.84385 -0.90195 -0.85865 -0.8884 ]
# This took 36 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend_real) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 1,  # TREX
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observables_t)])

    res_trex = job.result()
    val_trex = res_trex[0].data.evs

print("⟨Z_i⟩ with TREX:", val_trex)
⟨Z_i⟩ with TREX: [-0.92086303 -0.90253698 -0.91688854 -0.93308327 -0.91273953 -0.9221892
 -0.903782   -0.93046052 -0.90348934 -0.90284174 -0.89499677 -0.91630959
 -0.89508481 -0.92233292 -0.90497141 -0.91867138 -0.91421506 -0.91646851
 -0.9268364  -0.91669818]
ここでは、TREXを使用した場合と使用しない場合の平均絶対誤差を比較します。
ideal = np.cos(7 * np.pi / 8)

mean_abs_error_no_trex = np.mean(np.abs(val_no_trex - ideal))
mean_abs_error_trex = np.mean(np.abs(val_trex - ideal))

print("The mean absolute error without TREX is: ", mean_abs_error_no_trex)
print("The mean absolute error with TREX is: ", mean_abs_error_trex)
The mean absolute error without TREX is:  0.05238453251128674
The mean absolute error with TREX is:  0.011980732757900719
zx = list(range(num_qubits))
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values with no DD
ax.scatter(zx, val_no_trex, c="blue", linestyle="-", label="No TREX", alpha=0.7)

## Add values with DD
ax.scatter(zx, val_trex, c="red", linestyle="-", label="With TREX", alpha=0.7)

# Add ideal reference line
ax.axhline(y=-0.924, color="black", linestyle="--", linewidth=2, label="Ideal ⟨Z⟩")

# Add labels and plot
ax.set_xlabel("Qubits")
ax.set_ylabel("<Z>")
ax.legend()
ax.set_title("<Z> in RX(7pi/8)|0> state with and without TREX")
ax.grid(True)

plt.show()
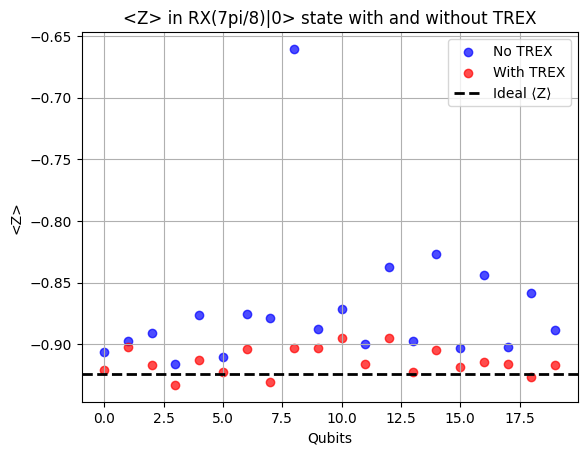
TREXは確かに効果があったようです。量子ビット16だけを除き、すべての量子ビットで期待値が改善しました。このような外れ値が生じるのは想定の範囲内です。平均値を取ることで、回路全体に対するTREXの適用効果を定量化できます。
mean_no_trex = sum(val_no_trex) / num_qubits
mean_trex = sum(val_trex) / num_qubits

print("Mean without TREX", mean_no_trex)
print("Mean with TREX", mean_trex)
Mean without TREX -0.8714950000000001
Mean with TREX -0.9137729590315635
平均すると、TREXによって結果は理想的な結果に約2.9%近づき、理論上の理想値との差は平均でわずか0.4%になりました。これは素晴らしい結果であり、この低オーバーヘッドの改善こそが、TREXがEstimatorのデフォルトのエラー緩和である理由です。ただし、TREXが取り除くのは読み出しエラーのバイアスであり、すべてのエラーを補正するわけではないことを改めて強調しておく必要があります。ここでは、読み出しの非対称性の影響を受けやすい初期状態を選びました。各量子ビットを別の状態で準備していれば、効果は異なっていたでしょう。そうなる理由を簡単に説明すると、各量子ビットを基底状態 のままにした場合を考えてみてください。 と の間の読み出しエラーの非対称性を観測(または補正)する機会がなくなります。
ゼロノイズ外挿(ZNE)
ゼロノイズ外挿(ZNE)は、最も広く使われているエラー緩和手法の1つです。実装の詳細は複雑ですが、全体的な戦略は理解しやすいものです。ZNEは次のように動作します。
-
対象の回路を複数の「ノイズレベル」で実行する — ノイズが予測可能な形でスケールするように回路を変更します
-
ノイズスケールごとに、対象のオブザーバブルを推定する。
-
フィッティングモデル(線形、多項式、指数関数など)を使ってゼロノイズへ外挿する。
その結果は、外挿モデルが示すゼロノイズ極限において、そのオブザーバブルがどのような値になっていたかの推定値です。
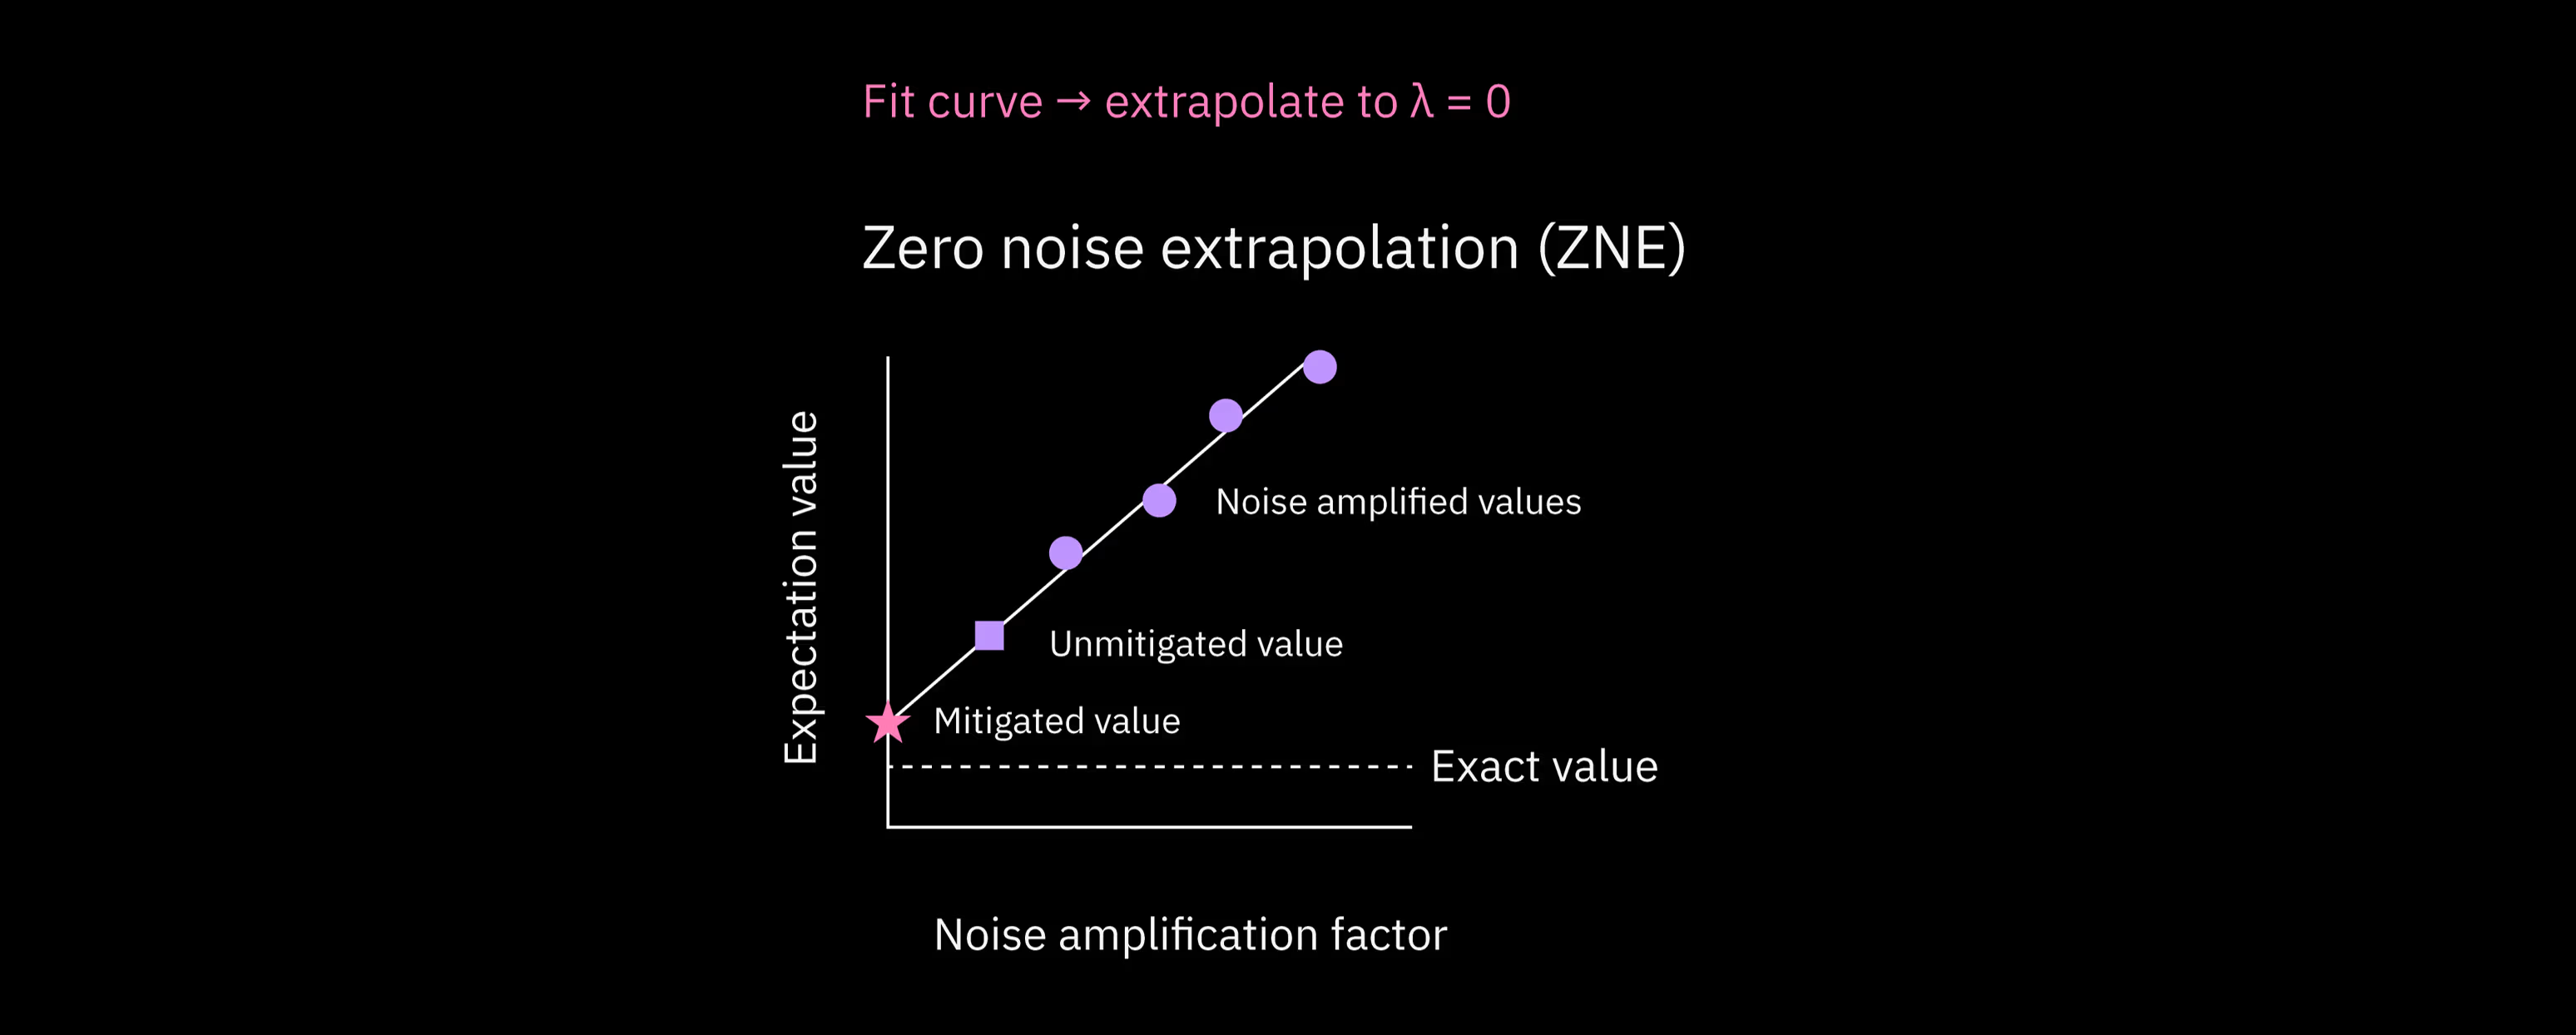
ZNEは、回路を変更してもノイズが滑らかに、あるいは線形に増加することを保証するものではありません。代わりに、ノイズのスケーリングが外挿を可能にするほど十分に良好に振る舞うことを仮定しています。ZNEの複雑さは、この仮定をできるだけ満たすように回路をどのように変更するかにあります。このレッスンでは、いくつかのアプローチを検討します。
ZNEのリソーススケーリング
ZNEでは、オーバーヘッドの大部分は量子オーバーヘッドです。つまり、 個のノイズレベルで期待値を得るには、 個の回路で、それぞれ多数のショットを使って実験を行う必要があります。統計的精度を一定に保つため、ノイズをスケールした回路を追加するにつれて、総サンプル数は一般に増加します。
調べるノイズレベルの数 は、ノイズのスケーリングに使用する手法によって異なります。単純なノイズスケーリング手法の1つ(後述の「ゲートフォールディング」)では、 は通常3から5の間です。別の手法(確率的ノイズ増幅(PNA))では整数以外のノイズ係数が使用でき、通常はゲートフォールディングよりも低いノイズレベルになります。総オーバーヘッドはおおよそ次のようにスケールします。
ここで はベースラインのショット数です。もう1つ留意すべき点として、ノイズのスケーリングにゲートの繰り返しが含まれる場合、回路の深さがノイズスケーリング値に比例した係数で増加する可能性があります。深さの増加に伴ってノイズがスケールすることが目的ですが、全体の深さには注意してください。
ZNEは、次のような点が当てはまる問題に適しています。
-
多くの種類のエラーに有効な、汎用的な緩和手法が必要である。
-
回路の深さが大きすぎない。スケールした回路のノイズが大きくなりすぎると、外挿ができずZNEは失敗します。
-
精度向上のために、ある程度の実行時間オーバーヘッドを許容できる。
実際には、このためZNEは多くの変分回路、期待値推定、その他の近い将来の量子アルゴリズムに最適です。ZNEはEstimatorで resilience_level = 2 を使って実装されています。ZNEは、回路全体のノイズの関数として単一の結果を持つ空間で外挿を行うことに注意してください。つまり、推定問題には適していますが、サンプリング問題には適していません。ビット列の分布に対して機能するようには設計されていません。
ノイズ係数
回路のノイズレベルを正確にはどうやって増やせるのでしょうか。多くのバリエーションがありますが、主な方法は2つあります。
-
ゲートまたはゲートのブロック を に置き換えます。量子コンピューターのゲートはユニタリーなので、 であることがわかっており、論理的には となります。しかし、 または を繰り返すたびに、同程度または同一のエラーが加わるため、ノイズ/エラーレベルをスケールアップできます。上記の置き換えにより、ゲート の元のノイズ(ノイズレベル1)から、 ではその3倍のノイズレベル(ノイズレベル3)になることに注意してください。実際には、最後の2つのゲートを 回繰り返して とすることで、ノイズレベル を得られます。これはゲートフォールディングと呼ばれ、非常に一般的なノイズスケーリング手法です。
-
確率的エラー増幅(PEA)など、ノイズレベルを上げる他の手法もあります。PEAでは、まず回路に適したノイズモデル(通常はパウリチャネルとして表現されます)を学習します。次に、この学習したノイズチャネルを再スケールしたものからサンプリングすることでノイズを増幅します。サンプリングを調整することで、整数以外の値も含め、実効的なノイズ強度を連続的にスケールできます。
実際には、ゲートフォールディングは非常に確実にエラーをスケールできますが、回路が非常に深くなる可能性もあります。必要なノイズレベルが3つ(1、3、5)だけの場合でも、回路の深さを5倍に増やしつつ、妥当な結果を得る必要があることを意味します。したがって、対象の回路のトランスパイル後の2量子ビット深さが60以上であれば、ゲートフォールディングよりもPEAのほうが適している可能性が高くなります。
ゲートは、ローカルにフォールディングする(2量子ビットゲートが現れるたびにすぐ を繰り返す)か、ゲートをブロックにまとめてそのブロックを繰り返す(ゲート のように)ことができます。ZNEの仮定にとっては、ローカルフォールディングのほうが好ましいことが多いですが、どちらも可能です。
ZNEでは、ノイズをスケールした結果の統計的な扱いに多くの微妙な点があります。たとえば、ノイズレベルが5倍になると、結果の分散は確実に大きくなり、信頼性も低くなります。それをノイズの低いデータ点と同じ重みで扱うべきでしょうか。いいえ。しかし、ZNEの動作を確認する目的で、簡易モデルの実験ではこの複雑さの一部を無視します。この実験では、フォールディングした回路を手作業で構築し、重みを均等にした単純な外挿を行って、主要な手順を示します。その後、Qiskitに組み込まれたZNE機能を使った実験を行い、ここで省略している複雑さをそれがはるかにうまく処理することを確認します。
手作業によるZNE
まず、ノイズやエラーがない場合の理想的な期待値を計算できる量子回路とオブザーバブルを選びます。偶数個の量子ビットを持つGHZ状態 を選び、オブザーバブルは とします。これを選ぶ理由はいくつかあります。
- 理想的な場合、期待値 は簡単に計算できます。量子ビット数が偶数なので、すべての から
1が得られてそれらを掛け合わせるか、すべての から-1が得られてそれを偶数回掛け合わせることになります。 - 1つの量子ビットでの単一のエラーが、そのショットの全体の結果を+1から-1に反転させる可能性があるため、エラーやノイズに対してかなり敏感です。
- 期待値が0から大きく離れています。理想的な期待値が0に非常に近い場合、ノイズレベルが高いと結果がランダム化され、正の値と負の値が同じ頻度で現れる傾向があるため、ZNEは困難に直面することがあります。その結果、ノイズ値が高いと理想値に近い値が得られてしまい、外挿が非常に難しくなる可能性があります。
この動機を念頭に置いて、回路を構築しましょう。
from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp
from qiskit.transpiler import generate_preset_pass_manager

from qiskit_ibm_runtime import (
    QiskitRuntimeService,
    Estimator,
    EstimatorOptions,
)
num_qubits = 10  # must be even

# # Noise amplification factors used for folding (2* integer +1 for gate folding)
noise_steps = [1, 3, 5]
ghz_amp = []

for j in noise_steps:
    qc = QuantumCircuit(num_qubits)
    qc.h(0)
    # Since CX^2 = I, odd repetitions implement folded versions of the gate.
    for i in range(num_qubits - 1):
        for gates in range(j):
            qc.cx(i, i + 1)
    qc.barrier()
    ghz_amp.append(qc)
ここで であるという微妙な点に注意してください。ゲートフォールディングは の形の演算子で構成されると説明しましたが、ここでは同じ構造がCNOT CNOT CNOTのように見えます。
番目の回路が確かに通常のGHZ回路であることを確認しましょう。
ghz_amp[0].draw("mpl")
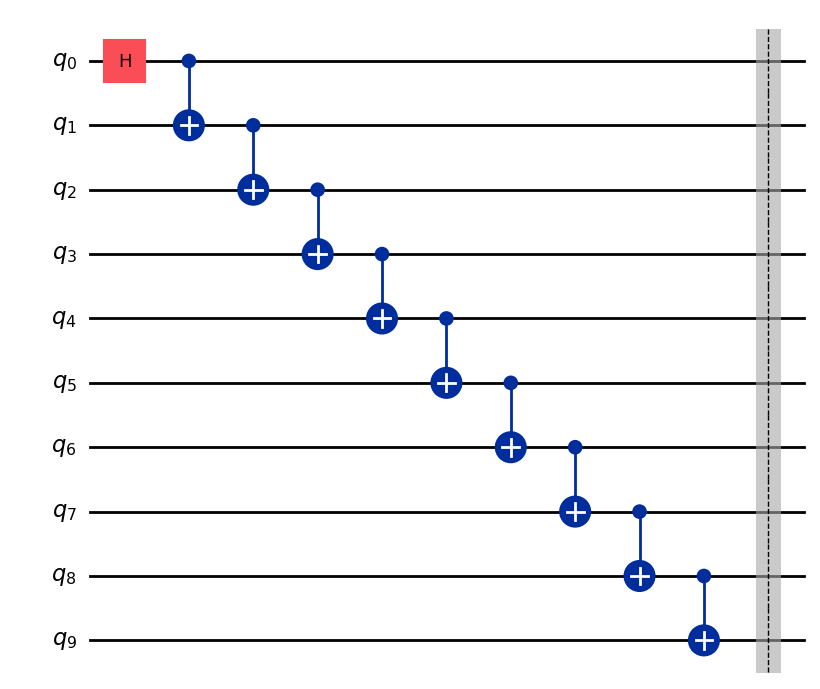
他の回路も見て、期待どおりの構造になっていることを確認できます。
次に、オブザーバブルを構築します。
pauli_string = "Z" * num_qubits
observable = SparsePauliOp(pauli_string)
observables = []
for j in range(len(noise_steps)):
    observables.append(observable)
パスマネージャーを構築して回路に適用します。次に、レイアウトを取得してオブザーバブルに適用します。
pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=0,
)

qcs_transpiled = []
obs_transpiled = []

for j in range(len(ghz_amp)):
    # Transpile the circuit
    qc_pm = pm.run(ghz_amp[j])
    qcs_transpiled.append(qc_pm)
    # Extract the final layout
    layout = qc_pm.layout
    # Apply the layout to the observable
    obs_transpiled.append(observable.apply_layout(layout))
pubs をフォーマットします。
pubs = [(qc, obs) for qc, obs in zip(qcs_transpiled, obs_transpiled)]
次にEstimatorを実行します。ZNEの役割に焦点を当てたいので、ツワイリングの効果とZNEの効果が混ざらないように resilience_level = 0 に設定したいところです。しかし、ツワイリングを含むQiskit組み込みのZNE設定と、「手作業」のZNEを比較したいとも考えています。そのため、ここでは resilience_level = 1 に設定します。resilience_level = 2 に設定するとQiskitのZNE設定が呼び出されます。これは後ほど使用します。
# This took 21 sec on ibm_fez. Your actual runtime might vary.
options = EstimatorOptions(resilience_level=1)

estimator = Estimator(
    mode=backend_real,
    options=options,
)

job = estimator.run(pubs)

res = job.result()
次に、ノイズレベルと期待値を出力します。
# We save this for later comparisons
value_no_zne = res[0].data.evs

# Print all values used for extrapolation
print("Noise level 1: ", res[0].data.evs)
print("Noise level 3: ", res[1].data.evs)
print("Noise level 5: ", res[2].data.evs)
Noise level 1:  0.8327970939283861
Noise level 3:  0.5612869745718734
Noise level 5:  0.3130254281266217
ここが最も大雑把に扱っている部分です。得られた各値の分散にはまったく注意を払わず、フィットが線形であるべきかどうかを理論的に予測することもなく、これらのデータに線形フィットを行っています。繰り返しになりますが、組み込みのZNEは、手作業で行っていることよりもはるかに優れた結果を出します。
# Data
noise_factors = np.array([1, 3, 5])
values = np.array([res[0].data.evs, res[1].data.evs, res[2].data.evs])

# Linear fit: E(lambda) = m * lambda + b
coeffs = np.polyfit(noise_factors, values, deg=1)
slope, intercept = coeffs

print(f"Best-fit slope: {slope}")
print(f"Zero-noise extrapolated value: {intercept}")
Best-fit slope: -0.12994291645044112
Zero-noise extrapolated value: 0.9588652482269501
解釈の前に、これをプロットしてみましょう。
import matplotlib.pyplot as plt

x_fit = np.linspace(0, 5.5, 100)
y_fit = slope * x_fit + intercept
y_ideal = 1.0

plt.figure()
plt.plot(noise_factors, values, "o", label="Measured data")
plt.plot(x_fit, y_fit, "-", label="Linear fit")
plt.axhline(y_ideal, linestyle="--", label="Ideal")
plt.axvline(0, linestyle="--", color="gray")
plt.scatter(0, intercept, color="red", zorder=3, label="Zero-noise estimate")

plt.xlabel("Noise amplification factor")
plt.ylabel(r"$\langle Z^{\otimes N} \rangle$")
plt.legend()
plt.show()
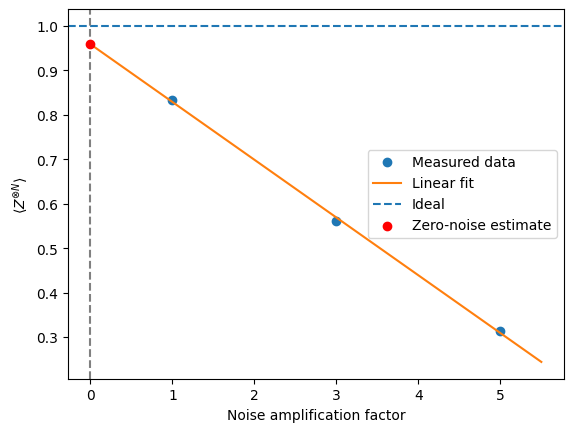
このレッスンの作成時点では、ゼロノイズの場合への外挿から得られた期待値は0.959でした。お使いの値は異なる場合があります。これは、元の回路の期待値0.83よりもかなり良く、理想値に約13%近づいています。しかし、期待値が0.31まで低下したデータ点を1つ使っていることもわかります。このデータ点は明らかに質が低いものです。線形近似でそのデータ点の重みを下げ、直線を最初の2つのデータ点により合わせて当てはめていれば、ゼロへの外挿推定値は(理想値に近い)より高い値になっていたことがわかります。このような考慮は、Estimatorに組み込まれたZNEで自動的に処理されます。
Estimatorに組み込まれたZNE
それでは、Estimatorに組み込まれたZNE機能を使うとどうなるか見てみましょう。まず、ゲートフォールディングなしの単純なGHZ回路を定義します。
num_qubits = 10  # must be even

qc = QuantumCircuit(num_qubits)
qc.h(0)

for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

qc.barrier()
CircuitInstruction(operation=Instruction(name='barrier', num_qubits=10, num_clbits=0, params=[]), qubits=(<Qubit register=(10, "q"), index=0>, <Qubit register=(10, "q"), index=1>, <Qubit register=(10, "q"), index=2>, <Qubit register=(10, "q"), index=3>, <Qubit register=(10, "q"), index=4>, <Qubit register=(10, "q"), index=5>, <Qubit register=(10, "q"), index=6>, <Qubit register=(10, "q"), index=7>, <Qubit register=(10, "q"), index=8>, <Qubit register=(10, "q"), index=9>), clbits=())
先ほどと同じオブザーバブルを定義します。
pauli_string = "Z" * num_qubits
observable = SparsePauliOp(pauli_string)
再びパスマネージャーを定義します。ここでは optimization_level = 1 を使用します。この選択については後ほど改めて取り上げます。
pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)
回路をトランスパイルし、レイアウトをオブザーバブルに適用します。
# Transpile the circuit
qc_transpiled = pm.run(qc)

# Extract the final layout
layout = qc_transpiled.layout

# Apply the layout to the observable
obs_transpiled = observable.apply_layout(layout)
ZNEとツワイリングを使ってEstimatorを実行し、その結果を手作業によるZNEの実装と比較します。特に、ZNEなしの結果(value_no_zne)と比較します。
# This used 18 sec on ibm_fez. Your actual QPU time might vary.

options_zne = {
    "resilience_level": 2,
    "resilience": {
        "zne": {
            "noise_factors": [1, 3, 5],
        }
    },
    "twirling": {
        "enable_gates": True,
        "enable_measure": True,
        "num_randomizations": "auto",
    },
}

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
各ノイズ係数での値は、構文 job_zne.result()[0].data.evs_noise_factors を使って取得できます。先ほどと同様に、これらの結果を単純に使って線形フィットを行い、ゼロノイズの場合に外挿することもできますが、resilience_level = 2 のestimatorは、分散やその他の要素を考慮に入れて、すでにより優れた処理を行っています。以下に、線形外挿で得られる結果と、組み込みのZNEが実際に出した結果を示します。
# Data
noise_factors = np.array([1, 3, 5])
values_qiskit_zne = np.array(job_zne.result()[0].data.evs_noise_factors)

# Linear fit: E(lambda) = m * lambda + b
coeffs = np.polyfit(noise_factors, values_qiskit_zne, deg=1)
slope, intercept = coeffs

print(f"Best-fit slope: {slope}")
print(f"Zero-noise extrapolated value: {intercept}")
Best-fit slope: -0.11745451044574956
Zero-noise extrapolated value: 0.9045922788100509
print("Exp val ideal: 1.0")
print("Exp val with no ZNE: ", value_no_zne)
print("Exp val with ZNE: ", value_zne)
print("Fractional improvement: ", (value_zne - value_no_zne) * 100 / 1.0, "%")
Exp val ideal: 1.0
Exp val with no ZNE:  0.8327970939283861
Exp val with ZNE:  0.9877508802932561
Fractional improvement:  15.495378636487 %
import matplotlib.pyplot as plt

x_fit = np.linspace(0, 5.5, 100)
y_fit = slope * x_fit + intercept
y_ideal = 1.0

plt.figure()
plt.plot(noise_factors, values, "o", label="Measured data")
plt.plot(x_fit, y_fit, "-", label="Linear fit")
plt.axhline(y_ideal, linestyle="--", label="Ideal")
plt.axvline(0, linestyle="--", color="gray")
plt.scatter(0, intercept, color="red", zorder=3, label="Linear")
plt.scatter(0, value_zne, color="black", zorder=3, label="Proper ZNE")

plt.xlabel("Noise amplification factor")
plt.ylabel(r"$\langle Z^{\otimes N} \rangle$")
plt.legend()
plt.show()
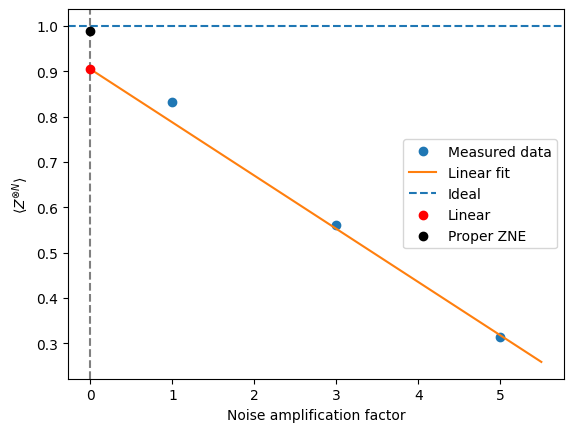
組み込みのZNEによって推定値が15%以上改善され、手作業による試みよりもかなり良い結果が得られたことがわかります。
先に進む前に、このZNEの検討全体を通して、パスマネージャーで optimization_level = 1 に設定していたことに注意してください。最適化レベルを上げるとエラーは減りますが、エラーの減少によってエラーのスケールが予測しにくくなることもあります。よくあることですが、ここにはバランスがあります。エラーは減らしたいものの、既知の係数で意図的にエラーを増やしている場合は別です。
手法の組み合わせ
ZNEは次のことに依存しています。
-
明確に定義されたノイズスケーリングパラメーター
-
に対する期待値の十分に滑らかで予測可能なスケーリング
-
強度の異なる、同じ実効ノイズチャネル
-
に応じてスケールしないバイアスが導入されないこと
ZNEは、スケールしないバイアスを取り除く手法(M3など)やノイズをより規則的にする手法(ツワイリングなど)とはうまく組み合わせられますが、ノイズを完全に打ち消そうとする手法(PEC)やノイズを動的に再形成する手法(DD)とは競合します。
特にM3が対処するのは測定/読み出しエラーのみであり、実際にはこれをゲートエラー(ZNEのエラースケーリング処理の焦点)とは別のものとして扱えます。M3はゲートフォールディングからほぼ独立しており、ZNEと問題なく組み合わせられます。TREXも非常によく似ており、ZNEと組み合わせられます。
M3やTREXとは異なり、パウリ・ツワイリングはゲートに焦点を当てています。ただし、パウリ・ツワイリングはエラー/ノイズを直接緩和するのではなく、予測しやすくなるように変化させるものであることを思い出してください。パウリ・ツワイリングは、ゲートエラーのスケーリングをより線形にして外挿の精度を高めるという点で、実際にZNEのプロセスにとって有益となる可能性があります。
動的デカップリング(DD)はより微妙です。DDは、ゲートシーケンスを追加することで特定のエラーを部分的に打ち消し、ノイズの挙動を動的に変化させます。ゲートやブロックをフォールディングしてもDDが同じように動作するように回路を構築できるのであれば、原理的にはZNEとDDを組み合わせることができますが、実際にはDDがスケーリングに干渉することがあります。両者を組み合わせたい場合は、次のような点を考慮してください。
- すべてのノイズレベルでDDが一貫して適用されているか。
- フォールディングによってDDの構造が保たれているか。
- 結果として得られるノイズのスケーリングが、依然として単調に振る舞うか。
単独のアプローチとして取り上げる最後のエラー緩和手法は、ZNEとは両立しません。それは確率的エラーキャンセレーションです。
確率的エラーキャンセレーション(PEC)
ZNEや測定エラー緩和とは異なり、PECは期待値において理想的なチャネルを再構成することで、ゲートレベルでノイズを打ち消そうとします。確率的エラーキャンセレーション(PEC)は、このレッスンで扱うエラー緩和手法の中で最も強力で、最もコストがかかる手法です。PECは、ノイズチャネルを物理的ではなく統計的に逆変換することを中心に構築されています。PECは次のように動作します。
-
「エラー演算」の基底を用いてノイズモデルを特徴付ける。
-
ノイズチャネルの逆を、物理的な演算に対する準確率分布として表現する。
-
回路の実行中にこの分布からサンプリングし、理想的な計算の不偏推定値を統計的に構築する。
概念的には、PECは仮想的なエラー訂正のようなものです — ノイズのある演算を、慎重に重み付けしたランダムなパターンで組み合わせることで、ノイズを「元に戻し」ます。しかし手順としては、PECはエラー訂正やエラー検出符号とは密接に関連していません。PECが理想的でノイズのない期待値の不偏推定を得る代償として、非常に大きなサンプリングオーバーヘッドと、正確なノイズ特性評価への強い依存が生じます。
IBMの量子コンピューターでは、PECは汎用的な緩和レイヤーというより、精密なツールとして捉えるのが最適です。小規模な回路や大規模な回路の小さな部分、ベンチマークタスク、高い量子オーバーヘッドが許容される高精度の研究に最も適しています。
ノイズチャネルの特性評価
PECでは、量子回路内の各理想ゲートを、理想的なユニタリーチャネルとそれに続くノイズ過程としてモデル化します。 を量子状態の密度行列とします。理想的なゲートはユニタリー行列 で表され、次の量子チャネルを誘導します。
実際のハードウェアでは、この理想的な時間発展はノイズによって損なわれます。ゲートの物理的な実装を実効的なノイズチャネルとしてモデル化します。
ここで は、ゲートに関連する確率的エラーを捉えるノイズチャネルです。この議論全体を通して、、、 は密度演算子に作用する線形写像です。理想的なチャネル はユニタリーで可逆ですが、ノイズチャネル (したがって も)は完全正値かつトレース保存(CPTP)の写像です。
PECでは、ノイズチャネル が既知、またはおおよそ既知であると仮定します。IBM Quantumのハードウェアでは、この情報は通常、デバイスのキャリブレーションデータ、ベンチマーク実験から推定されたエラー率、および小さなゲートセットに対するパウリ近似や脱分極近似などの簡略化されたノイズモデルから得られます。PECは完全に正確なノイズモデルを必要としませんが、仮定したノイズチャネルが実際のハードウェアの挙動から乖離するにつれて、性能は急速に低下します。
逆ノイズチャネルの準確率分解
PECの中心的な考え方は、ノイズチャネルの逆に対する確率的な近似を構築することで、期待値においてノイズの影響を打ち消すことです。形式的には、 をおおよそ元に戻す線形写像を適用して、次のようにすることが目標です。
これは、多数の回路実行にわたる期待値において成り立ちます。
ここで逆 は、演算子に作用する線形超演算子として扱った の代数的な逆として定義されます。この逆が存在するのは がフルランクの場合のみです。逆を持たないノイズ過程は、PECでは厳密には緩和できません。
逆変換が可能な場合、PECは逆ノイズチャネルを物理的に実装可能な演算の線形結合として表現します。
ここで、各 はハードウェア上で実行可能なノイズのある演算(通常はネイティブゲートまたは短いゲートシーケンス)であり、実数係数 は準確率分布を形成します。通常の確率とは異なり、係数 は負になったり1を超えたりすることがあります。
準確率ノルム:
は、ノイズ逆変換のコストを定量化します。自明でないノイズチャネルでは、 となります。IBM Quantumのハードウェアでは、この分解は通常、次のように行われます。
- ゲートごと、または小さなゲートセットごとに、
- 制限されたノイズモデル(多くの場合はパウリ対角近似)を仮定して、
- バックエンド固有のネイティブ演算とスケジューリング制約を使用して。
理想的な回路のモンテカルロ再構成
オブザーバブル の期待値を推定するために、PECは上記の分解に基づくモンテカルロサンプリングを使用します。回路内のノイズのあるゲートが現れるたびに、次の手順が適用されます。
-
次の確率で演算 をランダムに選択する。
-
古典的な重みを割り当てる。
-
結果として得られたランダム化されたノイズのある回路を、量子バックエンドで実行する。
-
測定結果に、蓄積されたすべての重みの積を掛ける。
-
重み付けされた結果を、多数の回路実行にわたって平均する。
結果として得られる推定量 は、次を満たします。
ただし、ノイズモデル がハードウェアを正確に記述していることが条件です。したがって、PECは期待値において系統的なバイアスを生じませんが、バイアスを大きな統計的分散に置き換えます。各実行はノイズを含むものの重み付けされた推定値を生成し、そのような実行を多数回平均して初めて、理想的な期待値が現れます。
概念的な解釈
PECは仮想的なエラー訂正と説明されることがあります。この表現は完全に間違いというわけではありませんが、真の量子エラー訂正と混同しないようにしてください。PECには、論理符号化も、シンドローム抽出も、リアルタイムのフィードバックもありません。回路の実行中にエラーが防止されたり訂正されたりすることはありません。
代わりにPECは、多数のノイズのある回路の実現値を符号付きの古典的な重みで組み合わせることで、統計的にノイズを打ち消します。そのため、エラーは古典的な後処理の後で初めて打ち消されます。情報は実行中に保護されるわけではなく、理想的な結果は事後的に再構成されます。
リソースのスケーリングとコスト
PECの主なコストは、分散の増幅に由来します。PEC推定量の分散は次のようにスケールします。
これは次のことを意味します。
このスケーリングは本質的なものであり、古典的な後処理では改善できません。
ノイズのあるゲートを多数含む回路では、各ゲートが係数 を寄与するため、準確率ノルムの合計はおおよそ乗算的に増加します。
ここで は回路の深さです。IBM Quantumのハードウェアでは、これは通常、回路の深さに応じたサンプリングコストの指数関数的な増加につながり、特に2量子ビットゲートのエラーに対する感度が高くなります。このスケーリングにより、PECの適用可能性には現実的な限界があります。
PECが現在実用的なのは、次の条件の1つ、またはすべてが満たされる場合のみです。
-
回路が非常に小さい、または浅い(多くの場合 ゲート)。
-
ノイズモデルが単純で、十分に検証されている(たとえばパウリノイズ)。
-
高い統計的コストを許容できる。
-
目標がスループットではなく精度である。
このため、PECは次のような対象に適用されることがよくあります。
-
より大きなワークフロー内の独立したサブ回路。
-
短時間の時間発展ステップ。
-
状態準備または測定のルーチン。
-
ベンチマークおよび検証の実験。
IBMのソフトウェアスタック(IBM Quantum Computeとエラー緩和ツール)は、PECをデフォルトの緩和レイヤーではなく、特殊なオプションとして扱うことで、これを反映しています。
PECの典型的なユースケースには、次のようなものがあります。
-
量子ハードウェアの精密なベンチマーク、
-
小規模な量子アルゴリズムの検証、
-
縮約された系における高精度な量子化学計算、
-
ZNEやその他の緩和手法のクロスチェック。
PECと他のエラー軽減手法との関係
他の多くのエラー軽減手法は、スケーラビリティのために精度を犠牲にしますが、PECはその正反対で、何よりも精度を重視します。
PECはサブサーキットにのみ使用される場合があるため、他のどのエラー軽減手法を組み合わせられるかを考えることが特に重要です。PECとの互換性を明確に考えるには、各手法がノイズに対して何を行うかで分類すると役立ちます。次の一般的なカテゴリを考えてみましょう。
-
ノイズのキャンセル - エラーチャネルの逆変換を試みる
-
ノイズのスケーリング - 外挿のために意図的にノイズを増加させる
-
ノイズの再形成 - ノイズの構造やスペクトルを変更する
-
バイアスの除去 - ゲートノイズに比例しない誤差を補正する
PECはカテゴリ(1)に明確に属します。ノイズチャネルを変更または再スケーリングする手法は、慎重に検討する必要があります。
概要表(高レベル)
| 手法 | PECとの互換性 | 備考 |
|---|---|---|
| ZNE | 不可 | 誤差の打ち消しとスケーリングの違い、場合によっては誤差の調整 |
| Pauliツワイリング | 可(注意が必要) | 誤差の挙動に影響するが、学習しやすくなる場合がある |
| TREX | 可 | ワークフローに重複なし。完全に互換。 |
| 動的デカップリング | 通常は不可 | エラーチャネルを変更する |
PECとZNEは同じ誤差源(ゲートエラー)を扱いますが、互いに両立しない仮定やワークストリーム、あるいはその両方に基づいています。たとえばZNEでは、誤差をパラメータ で展開できると仮定します。
さらに、この展開をモデル化するために誤差を効果的にスケーリングできると仮定します。PECは、スケーリングに利用するその誤差自体を打ち消してしまいます。そのためパラメータ は意味を失います。別の見方をすると、次のようになります。
-
PECの前にZNEを適用すると、逆変換しようとしているノイズチャネルが変わってしまいます。
-
ZNEの前にPECを適用すると、ZNEが外挿に利用するノイズそのものが除去されてしまいます。
PECとZNEは、組み合わせ可能な層ではなく、互いに代替となるエラー軽減のパラダイムと考えるべきです。両者を並べて比較することは有益ですが、組み合わせることは有益ではありません。
PECとPauliツワイリングは一般に互換性があり、多くの場合に有益です。 ツワイリングは、コヒーレントエラーを確率的なPauliエラーに変換することでPECを助ける場合があります。これによりノイズチャネルが単純になり、表現と逆変換が容易になります。PECにとってこれは非常に価値があり、その理由は次のとおりです。
-
準確率分解はPauliチャネルのほうがはるかに単純になる
-
準確率ノルム が大幅に小さくなることが多い
-
サンプリング分散が低減される
多くのPECのデモンストレーションでは、Pauliツワイリングされたノイズを仮定するか、あらかじめ組み込んでいます。 Pauliツワイリング自体はエラーを軽減するものではなく、確率的エラーキャンセレーションがより効率的に扱える形にノイズを再形成するものであることを明確にしておくことが重要です。
PECはTREXと組み合わせることができ、また組み合わせるべきです。これらの手法は完全に互換性があり、互いに直交した役割を果たします。TREXは測定時にのみ作用し、測定チャネルのランダム化されたツワイルによって読み出しバイアスを除去し、ゲートノイズや回路のダイナミクスには影響しません。PECはゲートノイズに作用します。測定エラーは合成的ではなく加法的であるため、ゲート列とは独立です。PECと併せてTREXを適用することは安全であり、多くの場合望ましいといえます。
これらの手法の順序は、おそらく想像どおりのものです。
- PECでランダム化した回路を実行する
- TREXを適用して読み出しエラーを軽減する
- PECの重み付けと平均化を適用する
PECとDDは、PECに用いるノイズの特性評価をDDを有効にして行わない限り、一般に互換性がありません。PECは、 が定常的で再現可能であり、正確に特性評価できると仮定します。DDは、系と環境の相互作用を変調し、自明でないパルスタイミングの効果をもたらすことで、ノイズチャネルを時間的に明示的に再形成します。その結果、DDを用いた場合の実効ノイズは、DDなしの場合と同じチャネルではありません。さらに、ノイズチャネルが回路のスケジューリングに敏感に依存しうるため、状況は一層複雑になります。最終的に、ノイズの逆変換は不定または無効になります。
理論的には、DDを有効にした状態でノイズを特性評価し、それに応じてPECモデルを構築することは可能ですが、これは非常に高度であり、現時点では推奨されるワークフローではありません。
PECを手作業で適用する
PECは複雑であり、手作業で実装することは推奨されません。それでも、この処理にどのような手順が含まれるかを理解するため、1つのQubitに対する基本的な適用例の数学を順に確認します。数値的な効果がはっきり分かるよう、混合状態でありながら自明でない状態を選びます。
本来は次の純粋状態にあるべきQubitを考えます。
理想的な密度行列は次のとおりです。
この密度行列を選んだのは、対角行列ではなく、かつ1Qubitのみなので「手作業」で調べやすいためです。
次に、非常に単純でありながら現実的なノイズモデルを適用します。弱い強度 をもつ1Qubitの脱分極チャネルです。
計算を扱いやすくするため、 とします。このチャネルは、当然ながら完全正値でトレース保存(CPTP)です。実際のハードウェアに対する現実的なノイズチャネル、少なくともノイズの一部を記述する上で現実的なものです。さらに、このノイズチャネルは線形写像として解析的に逆変換可能です。つまり逆行列は存在しますが、その行列がCPTPな物理チャネルに対応するとは限らず、ハードウェア上で実装できるユニタリに対応しないことは確実です。
ここで、この脱分極ノイズチャネルを1Qubitの密度行列に適用すると、次が得られます。
のとき、、 です。
So:
これを状態に適用すると次のようになります。
明示的に計算すると次のようになります。
これは依然として物理的な密度行列であり、トレースも1のままです — ただし、より混合した状態になっています。
次に理想的な逆チャネルを計算しますが、それが物理的でない可能性に十分備えておきます。物理的かどうかは後で確認します。数学的には、逆の線形写像は次のとおりです。
この逆作用がそれ自体で有効な物理チャネルであれば、それを正確に実装したくなるでしょう。もちろん、ユニタリ演算と古典的なステップを用いてどう実装するかを考える必要はありますが、それが目標になります。しかし、これはCPTPではないことが分かります。また一般に、このような逆写像がCPTPになる保証はありません。これが、PECが存在する理由であるため、今回の議論において決定的に重要です。
CPTPでないことは、見ただけで分かるかもしれません。確実な確認方法は、密度行列に適用して物理的な結果が返るかどうかを調べることです。これは理解度の確認のための演習として残しておきます。
理解度の確認
上で求めた逆写像 がCPTPかどうかを、新しい密度行列に適用して確認してください。
結果が物理的か非物理的かを解釈してください。
解答
物理的な密度行列として見ると、これは系が状態 にある古典的な確率が1より大きく、状態 にある確率が負であることに相当します。明らかに、この写像は無意味な密度行列を生み出す可能性があります。さらに、結果の密度行列の固有値は1.0625と-0.0625であることが見て取れ、すべての固有値が正ではありません。したがってこの写像は、CPTPの「CP」である「完全正値」ではありません。
理解度の確認
上の逆演算 がノイズチャネルを打ち消し、ノイズのない状態を返すことを、明示的な計算で確認してください。
解答
ノイズのある状態に適用します。
これは(丸めの範囲で)元の状態と完全に一致します。
念のため明確に述べておきます。ノイズチャネルを厳密に逆変換することはできません。その逆はCPTPではなく、有効な物理チャネルでもありません。しかし、物理チャネルの線形結合として、そのチャネルを実効的に逆変換することはできます。
脱分極チャネルについては次のとおりです。
ここで、 などです。
逆は次のように書けます。
with:
-
= 物理的に実装可能なClifford チャネル
-
= 準確率
-
Some
これがPECの中核となる考え方です。
-
∣ に従ってチャネルをサンプリングする
-
測定結果に符号を付ける
-
期待値がノイズのない値に収束する
密度行列 を用いて の推定にPECを「手作業」で適用し、 の結果を回復できるか確認します。 については次が期待されます。
また、ノイズのある密度行列については次が得られることにも注意してください。
桁数は妥当ですが、理想的な場合からは大きくずれています。
次に、PECの処理によって、ノイズのある密度行列から不偏な期待値をどのように再構成できるかを順に見ていきます。実際のワークフローでは、これは確率的であり自動化されます。この「手作業」のワークフローでは、現実的でありながら説明に都合のよい確率的な値を選びます。これはPECが完全であるという主張と受け取るべきではありません。PECのパッケージ内部で起こりうる、もっともらしいシナリオを示しているにすぎません。
ノイズチャネルは次の形であったことを思い出してください。
逆は(厳密に)次のように書けます。
based on symmetry of the transformation and the completeness of the Pauli operators. Inverting the noise channel somehow in the estimation process should yield an estimator that is unbiased and normalized. To do this, we must at least determine the coefficents and and then think about how to implement the inverse transformation. When done by a noise learner, the inversion of this noise channel would be done at the channel level, independent of a specific case like our density matrix. The coefficients and would come from this inversion.
この導入では、チャネルが密度行列に与える影響に焦点を当てるほうが簡単です。これにより、密度行列や期待値といった身近な対象を扱えます。そのために、この逆演算が推定プロセスに与える影響について何が成り立つ必要があるかを考えます。PECが生成する推定量は、正規化されていて不偏でなければなりません。これは次の2つの条件に対応します。
-
正規化: この演算が観測量のスケールを変えないように、 を要求します。これが成り立つ理由を理解するには、密度行列に対する逆演算の作用を考えるか、 自体のような自明なものの期待値に対する作用を考えればよいでしょう。
-
較正: 実際のワークフローでは、較正用の回路を使ってゲートレベルのノイズの挙動を学習します。次に、ノイズの挙動に関するゲートレベルの知識と期待値の線形性を利用して、学習したノイズモデルをより大きな回路に適用します。今回の例では、理想的な期待値 であるという人為的な知識から出発しました。しかし、理論的にこれが理想値であると分かっている状態を考え出し、実際の測定を較正に用いることも容易にできます。重要な点は、PECでは通常、回路全体の完全なノイズモデルを学習しないということです。代わりに、個々のゲートや回路の層ごとの局所的なノイズモデルを学習し、それらを用いて準確率分解を構成します。
これらの条件を用いて と を決定します。次のアンザッツを考えます。
and apply it to an arbitrary single-qubit density matrix .
Pauliチャネルは共役によって作用することを思い出してください。
を に適用すると次のようになります。
トレースをとると、次が得られます。
各Pauli演算子はユニタリであるため、共役はトレースを保存します。
Therefore,
PECの推定量が正規化されるためには、実効的な逆写像がすべての密度行列のトレースを保存しなければなりません。つまり、次を要求します。
これは次の正規化条件を意味します。
しかし今回の場合、これは次の条件になります。
次に、較正情報を用いて、観測された期待値を既知の理想値に関連付けます。
Or equivalently,
2つの条件を と について解くと、次が得られます。
これらの係数の和は1ですが、そのうちの1つは負です。
回路をランダムに変更し、測定し、結果に符号付きの重みを掛けて平均することで、理想的な期待値を回復できます。特に、密度行列は再構成されず、逆チャネルも物理的に実装されません。
重要なステップ: これがPECです
ノイズ強度 の場合、逆チャネルは次のように書けます。
重要な事実:
-
係数の和は1である
-
1つの係数は負である
-
各項は物理的に実装可能である
-
負の性質は古典的な後処理に移される
重みの絶対値からサンプリング分布を作ります。
(X、Y、Zのそれぞれについて)
総重み:
サンプリング確率を求めるには、Wで割ります。
| 操作 | 確率 | 符号 |
|---|---|---|
| 何もしない () | 1.1875 / 1.375 ≈ 0.864 | + |
| Xを適用 | 0.0625 / 1.375 ≈ 0.045 | - |
| Yを適用 | 0.0625 / 1.375 ≈ 0.045 | - |
| Zを適用 | 0.0625 / 1.375 ≈ 0.045 | - |
符号は確率ではなく、元の係数に由来します。
各ショットは次のステップで構成されます。
-
状態を準備する
-
ハードウェアにノイズのある回路を適用させる
-
上の表から、対応する確率に従って操作をランダムに選ぶ
-
Apply it
-
を測定し、 を得る
-
結果に を掛ける
-
その数値を記録する
ここで、いくつかのショットの例を見ていきます。
ショット1(恒等の場合)
ランダムに選ばれた操作が恒等 (つまり何もしない)だったとします。上の議論と表に基づくと、これは86.4%の確率で起こります。ノイズチャネルの逆における の係数は正なので、符号は を選びます。Zの測定結果は のどちらにもなりえます。ここでは が得られたとしましょう。
このショットによるPECで補正された寄与は次のようになります。
ショット2(再び恒等)
再びランダムな操作として が得られた(したがって項の符号は最初は同じく )が、今回はZの測定結果が だったとします。このときの寄与は次のとおりです。
ショット3(Xが選ばれた場合)
今回のランダムな操作はXです。逆におけるこの項は負なので、符号は のままにします。Xを適用してからZを測定します。ここでもどちらの固有値が得られてもおかしくありませんが、 が得られたとしましょう。この項からの寄与は次のとおりです。
ショット4(Zが選ばれた場合)
ランダムな操作はZです。表から符号は になります。Zを測定して が得られたとします。寄与は次のとおりです。
ショット5(Yが選ばれた場合)
ランダムな操作はYです。表から符号は になります。Zを測定して が得られたとします。寄与は次のとおりです。
結果の平均化
このようなPECで重み付けされた結果を多数集めたと想像してください。
構成上、恒等は86.4%の確率で、その他の各ゲートは4.5%の確率で適用されます。実際のワークフローでは、背後にある正確な状態も、ノイズチャネル全体も分かりません。しかし、上で求めた重み係数 と、各操作を適用する相対的な確率は分かっています。実際のワークフローでは、未知の密度行列が測定結果を与えてくれることに頼ります。ここでは、この手順が正しい結果を与えることを検証します。
測定前にPauli演算子 を適用した場合を含め、重み付けされ符号付けされたすべての測定の平均を計算したいと思います。全ショット数を と呼びます。Pauli が適用されたすべてのショットの集合を とし、これらのショットを で添字付けします。 番目のPauliを適用した下での 番目のショットの測定結果を と呼びます。この平均は次のように書けます。
Pauli演算子 は確率 で確率的に適用されます。ショット数が多い極限では、
これを用いて次のように書けます。
ここで は、 が適用されたショットのアンサンブルのみにわたるZの期待値です。これが有用なのは、そのような各期待値がどうなるべきかを密度行列から知っているためです。繰り返しますが、実際のワークフローでは、これは既知の密度行列からではなく、測定から得られます。
理解度の確認
上の期待値 を、計算または論理的な推論によって検証してください。
解答
YとZも上記とまったく同様に進みます。
これで、全体の期待値を次のように書き直すことができます。
ゲートノイズのパラメーター と (より複雑なノイズチャネルの場合はさらに多くのパラメーター)がわかっていれば、(1)全体の重み係数と、(2)パウリ演算子を適用する確率を決定するのに十分です。上の結果が示しているのは、そのようにすればノイズを緩和し、バイアスのない期待値を回復できるということです。次のような状況にもかかわらず、これらすべてのショットの平均は に収束しました。
-
個々のショットの寄与が±1より大きくなる
-
一部のショットが負の統計的重みを持つ
-
すべての量子演算が物理的に実現可能であった
PECワークフローの概要
PECにおいて、量子コンピューター上で行うすべてのステップは次のとおりです。
-
ノイズ学習
-
対象回路のための状態準備
-
上述のように確率的にパウリゲートを適用する
-
Measurement
実効的な逆ノイズマップは、古典的な後処理において統計的に実現されます。これにより、負の確率のような非物理的なステップが本来必要となるノイズチャネルに対しても、より一般的な逆変換が可能になります。
その代償として支払うのが分散です。 かつて各ショットは、可能な測定結果の大きさ に等しい「大きさ」を持っていました。重み係数 によるスケーリング後は、その大きさは (上記の例では1.375)になります。
これがPECのサンプリングオーバーヘッドの起源です。
組み込みPEC
ここでは、IBM Quantumプリミティブに組み込まれているPECを使用します。ここで重要なのは、完全なゲートレベルのPECと、よりスケーラブルなPECのための局所ノイズ学習モデル(IBM Quantumプリミティブが使用しているもの)を区別することです。完全なPECを使うとオーバーヘッドが大きく、適用できるのは小規模な回路に限られます。それでも問題はありませんが、量子コンピューティングが実世界の問題に対して価値を持つ規模まで拡張できるツールのほうが有用です。そのため、IBM Quantumプリミティブは、学習済みのPauli-Lindbladノイズモデルを用いた層単位のPECを、積極的なスケーラビリティ保護策とともに採用しています。このPECの実装では、ノイズはゲートのインスタンスごとではなく、繰り返される回路の層ごとに学習され、ノイズモデルはパウリツワール化された局所的でマルコフ的なものです。Cliffordゲートはノイズモデルに吸収され、非Cliffordゲートが緩和コストを支配します。指数関数的な増大を避けるため、サンプリングオーバーヘッドには上限が設けられています。
IBM Quantumプリミティブに組み込まれているPECを、小規模(6量子ビット)と中規模(30量子ビット)の2つのスケールで適用し、このバージョンのPECでコストがどのように管理されるかを確認します。それぞれの規模の実験で、PECの結果を、緩和なし、ZNE、および理想値と明示的に比較します。
まず、必要なパッケージをいくつかインポートします。
import numpy as np

from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp, Statevector

# from qiskit_aer import AerSimulator
from qiskit.transpiler import generate_preset_pass_manager

from qiskit_ibm_runtime import (
    # QiskitRuntimeService,
    Estimator,
    EstimatorOptions,
)
推定するオブザーバブルを選びます。以下のオブザーバブルは、相互作用の 成分にのみ最近接結合を持ち、 方向の外部磁場によるかのような単一量子ビット項を に持つ、イジング型スピン鎖のハミルトニアンです。
このハミルトニアンを選んだ特別な理由はありません。エラー緩和が効果を発揮できるよう、自明でない observable と回路の組み合わせがあればよいのです。量子ビット数で割って係数を調整することでハミルトニアンを明示的にスケーリングし、量子ビット数を増やしてもエネルギーが同じオーダーにとどまるようにしています。最初は6量子ビットのみで始めます。
# This cell builds the observable

num_qubits = 6

terms = []
coeffs = []

# XX interactions
for i in range(num_qubits - 1):
    pauli = ["I"] * num_qubits
    pauli[i] = "X"
    pauli[i + 1] = "X"
    terms.append("".join(pauli))
    coeffs.append(1.0 / (num_qubits - 1))

# Z fields
for i in range(num_qubits):
    pauli = ["I"] * num_qubits
    pauli[i] = "Z"
    terms.append("".join(pauli))
    coeffs.append(0.5 / num_qubits)

observable = SparsePauliOp(terms, coeffs)
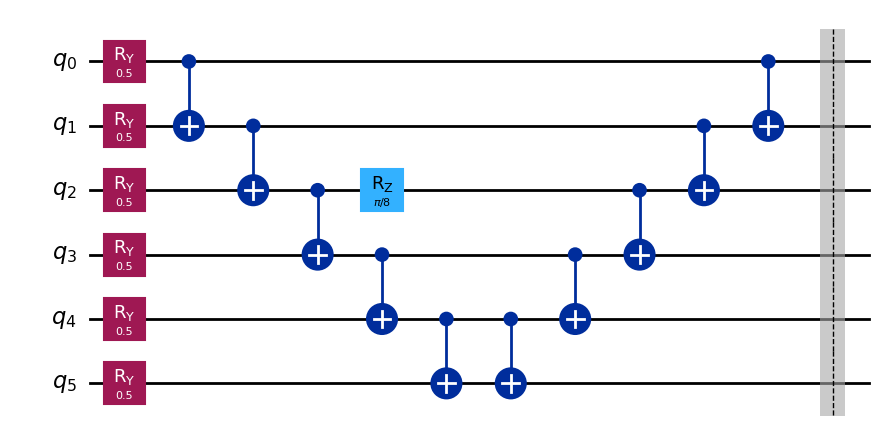
ハミルトニアンの選択と同様に、以下の状態準備回路も物理的な理由で選んだものではありません。PECが有用となるよう、十分な2量子ビット深さと十分な数の非Cliffordゲートを持つように選んでいます。たとえば、この回路がこのスピン鎖の基底状態のよい近似であると考える理由はありません。
qc = QuantumCircuit(num_qubits)

# Clifford preparation
for i in range(num_qubits):
    #    qc.h(i)
    qc.ry(0.5, i)

# Clifford entanglement
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

# --- Non-Clifford "probe" ---
# Small-angle rotation (RZ(pi/8) ~= T gate)
qc.rz(3.141592653589793 / 8, 2)

# More Clifford mixing
for i in reversed(range(num_qubits - 1)):
    qc.cx(i, i + 1)

qc.barrier()

qc.draw("mpl")
回路をトランスパイルし、得られたレイアウトを observable に適用します。
# service = QiskitRuntimeService()

# backend = service.least_busy(
##    operational=True,
#   simulator=False,
#   min_num_qubits=num_qubits,
# )

pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)

qc_transpiled = pm.run(qc)

layout = qc_transpiled.layout
obs_transpiled = observable.apply_layout(layout)
Statevectorシミュレーターを使って理想的な期待値を求めます。
# Compute the ideal final state
state = Statevector.from_instruction(qc)

# Compute expectation value
ideal_value = np.real(state.expectation_value(observable))

print("Ideal (noiseless) expectation value:")
print(ideal_value)
Ideal (noiseless) expectation value:
0.6651408876730361
他の理想値も同程度の大きさになると予想されます。次に、エラー緩和なしで、これを実際のIBM量子コンピューター上で実行します。
# This took 3 sec on ibm_fez. Your actual runtime might vary.

options_none = EstimatorOptions(resilience_level=0)

estimator_none = Estimator(
    mode=backend_real,
    options=options_none,
)

job_none = estimator_none.run([(qc_transpiled, obs_transpiled)])

value_none = job_none.result()[0].data.evs
print("No mitigation:", value_none)
No mitigation: 0.569677734375
次に、同じ問題にZNEを適用します。
# This took 17 sec on ibm_fez. Your actual runtime might vary.

options_zne = EstimatorOptions(resilience_level=2)

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
print("ZNE:", value_zne)
ZNE: 0.6573718927156127
最後に、PECを適用します。
# This took 17 sec on ibm_fez. Your actual runtime might vary.

from qiskit_ibm_runtime.options import EstimatorOptions

options = EstimatorOptions()

# One does not use ZNE with PEC
options.resilience.zne_mitigation = False
options.resilience.pec_mitigation = True
options.resilience.pec.max_overhead = 100

estimator_pec = Estimator(
    mode=backend_real,
    options=options,
)

job_pec = estimator_pec.run([(qc_transpiled, obs_transpiled)])

result = job_pec.result()
value_pec = result[0].data.evs

print("PEC:", value_pec)
PEC: 0.6666196849843695
以下で結果をプロットして比較します。
import matplotlib.pyplot as plt

methods = ["No mitigation", "ZNE", "PEC"]
values = [value_none, value_zne, value_pec]

ideal = ideal_value  # from Aer statevector

plt.figure(figsize=(6, 4))

plt.plot(methods, values, "o", label="Measured", markersize=8)
plt.axhline(ideal, color="black", linestyle="--", label="Ideal (Aer)")

plt.ylabel("Expectation value")
plt.title("Error mitigation comparison")
plt.legend()
plt.grid(axis="y", alpha=0.3)

plt.tight_layout()
plt.show()
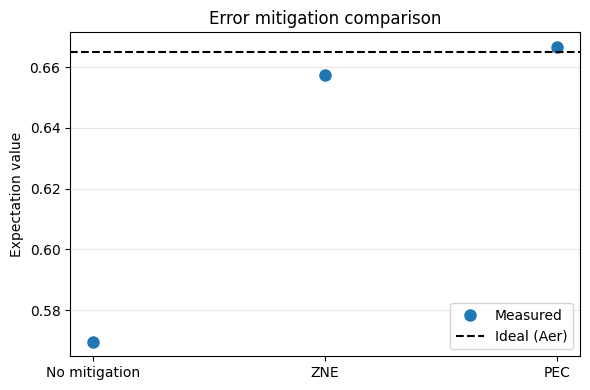
これは非常にうまくいきました。PECによる推定値は、理想値からわずか0.2%の差です。
しかし、量子オーバーヘッドが指数関数的に増大することを思い出してください。ここでは max_overhead = 100 という最大オーバーヘッドを設定しました。所要時間と結果の質から見ると、この上限には達していない可能性があります。しかし、計算規模を拡大してもこの上限を維持すれば、上限に達し、結果が悪化します。
回路を30量子ビットまで拡大するとどうなるかを見てみましょう。興味深いことに、多くのノートPCでは、Statevectorシミュレーターは24〜28量子ビット前後でタイムアウトし始めます。計算上の回避策を見つけることもできるでしょう。しかしここでは、量子コンピューターが、古典コンピューターでは追いつけない規模で一部の問題を解けるようになるという事実を受け入れましょう。それが要点です。では、そのような場合に量子計算の結果をどのように検証できるでしょうか。考えられる答えがいくつかあります。
- 解くのは難しいが確認は容易な問題があります(ショアのアルゴリズムにおける素因数分解など)。
- 複雑さが低減し、古典的に、あるいは解析的にでも解けるパラメーター領域や問題の種類があり、いくつかの点を比較できます。 今回は、示強的な(量子ビット数で割った)ハミルトニアンを選びました。理想的な期待値はかなり安定しているはずです。理想的な期待値が量子ビット数によってどう変化するかを調べ、30量子ビットでの値について古典的な予測ができるかを見てみましょう。
import numpy as np
import matplotlib.pyplot as plt

from qiskit import QuantumCircuit
from qiskit.quantum_info import Statevector, SparsePauliOp

num_qubits_max = 24

qubits = [4, 8, 12, 16, 20, 24]
exp_vals = []
for num_qubits in qubits:
    qc = QuantumCircuit(num_qubits)

    for i in range(num_qubits):
        qc.ry(0.7, i)
    for i in range(num_qubits - 1):
        qc.cx(i, i + 1)
    for i in range(num_qubits):
        qc.rz(np.pi / 5, i)
    for i in reversed(range(num_qubits - 1)):
        qc.cx(i, i + 1)
    qc.barrier()

    terms = []
    coeffs = []

    # XX interactions
    for i in range(num_qubits - 1):
        pauli = ["I"] * num_qubits
        pauli[i] = "X"
        pauli[i + 1] = "X"
        terms.append("".join(pauli))
        coeffs.append(1.0 / (num_qubits - 1))

    # Z fields
    for i in range(num_qubits):
        pauli = ["I"] * num_qubits
        pauli[i] = "Z"
        terms.append("".join(pauli))
        coeffs.append(0.5 / num_qubits)

    observable = SparsePauliOp(terms, coeffs)

    # Compute the ideal final state
    state = Statevector.from_instruction(qc)

    # Compute expectation value
    ideal_value = np.real(state.expectation_value(observable))
    exp_vals.append(ideal_value)

print(exp_vals)

plt.figure()
plt.plot(qubits, exp_vals, "o", label="Statevector")
plt.xlabel("Number of qubits")
plt.ylabel(r"$\langle O^{\otimes N} \rangle$")
plt.legend()
plt.show()
[np.float64(0.7181764372838925), np.float64(0.7181764372838922), np.float64(0.7181764372838931), np.float64(0.7181764372838906), np.float64(0.7181764372838907), np.float64(0.7181764372838709)]
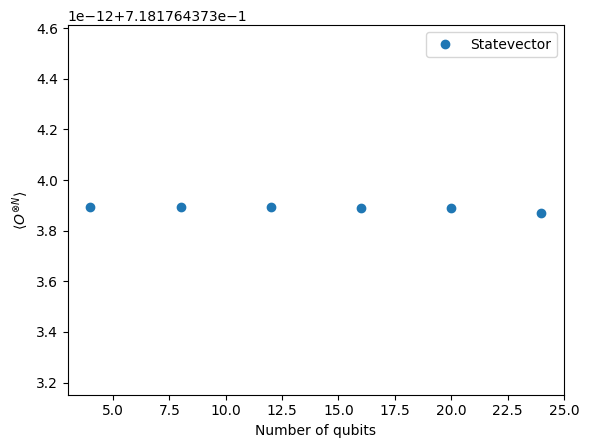
確かに、量子ビット数によって変化しないハミルトニアンと状態を選んでいることがわかります。これは量子コンピューティングの研究用途としては非常に不向きですが、エラー緩和技術のベンチマークとしては優れています。エラー緩和のテストのために量子ビット数を増やしても、この固定された期待値を理想的な結果として自信を持って使用できます。
num_qubits = 30

qc = QuantumCircuit(num_qubits)

# Clifford preparation
for i in range(num_qubits):
    #    qc.h(i)
    qc.ry(0.7, i)

# Clifford entanglement
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

# --- Non-Clifford "probe" ---
# Small-angle rotation (RZ(pi/8) ~= T gate)

for i in range(num_qubits):
    qc.rz(np.pi / 5, i)

# More Clifford mixing
for i in reversed(range(num_qubits - 1)):
    qc.cx(i, i + 1)

qc.barrier()

qc.draw("mpl")

# This cell builds the observable

terms = []
coeffs = []

# XX interactions
for i in range(num_qubits - 1):
    pauli = ["I"] * num_qubits
    pauli[i] = "X"
    pauli[i + 1] = "X"
    terms.append("".join(pauli))
    coeffs.append(1.0 / (num_qubits - 1))

# Z fields
for i in range(num_qubits):
    pauli = ["I"] * num_qubits
    pauli[i] = "Z"
    terms.append("".join(pauli))
    coeffs.append(0.5 / num_qubits)

observable = SparsePauliOp(terms, coeffs)

# service = QiskitRuntimeService()

# backend = service.least_busy(
##    operational=True,
#   simulator=False,
#   min_num_qubits=num_qubits,
# )

pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)

qc_transpiled = pm.run(qc)

layout = qc_transpiled.layout
obs_transpiled = observable.apply_layout(layout)

# Compute the ideal final state
# This might time out above about 26 qubits. The Hamiltonian has been "normalized".
# The same expectation value calculated on the smaller example above is still valid.
# state = Statevector.from_instruction(qc)

# Compute expectation value
# ideal_value = np.real(state.expectation_value(observable))

print("Ideal (noiseless) expectation value:")
print(ideal_value)
Ideal (noiseless) expectation value:
0.7181764372838709
# This took 5 sec on ibm_fez. Your actual runtime might vary.

options_none = EstimatorOptions(resilience_level=0)

estimator_none = Estimator(
    mode=backend_real,
    options=options_none,
)

job_none = estimator_none.run([(qc_transpiled, obs_transpiled)])

value_none = job_none.result()[0].data.evs
print("No mitigation:", value_none)
No mitigation: 0.5869884271731322
次に、この大きな回路をZNEで実行します。
# This took 17 sec on ibm_fez. Your actual runtime might vary.

options_zne = EstimatorOptions(resilience_level=2)

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
print("ZNE:", value_zne)
ZNE: 0.7096089981595511
最後に、30量子ビットの例をPECで実行します。
# This took 4 min 57 sec on ibm_fez. Your actual runtime might vary.

options = EstimatorOptions()

# One does not use ZNE with PEC
options.resilience.zne_mitigation = False
options.resilience.pec_mitigation = True
options.resilience.pec.max_overhead = 100

estimator_pec = Estimator(
    mode=backend_real,
    options=options,
)

job_pec = estimator_pec.run([(qc_transpiled, obs_transpiled)])

value_pec = job_pec.result()[0].data.evs
print("PEC:", value_pec)
PEC: 0.3481257778627795
job_id_none = job_none.job_id()
job_id_zne = job_zne.job_id()
job_id_pec = job_pec.job_id()
print("job number with no mitigation:  ", job_id_none)
print("job number with ZNE  ", job_id_zne)
print("job number with PEC  ", job_id_pec)
job number with no mitigation:   d7uc79back5s73be1cv0
job number with ZNE   d7uc7c3ack5s73be1d40
job number with PEC   d7uc9k4inasc738smhu0
import matplotlib.pyplot as plt

methods = ["No mitigation", "ZNE", "PEC"]
values = [value_none, value_zne, value_pec]

ideal = ideal_value  # from Aer statevector

plt.figure(figsize=(6, 4))

plt.plot(methods, values, "o", label="Measured", markersize=8)
plt.axhline(ideal, color="black", linestyle="--", label="Ideal (Aer)")

plt.ylabel("Expectation value")
plt.title("Error mitigation comparison")
plt.legend()
plt.grid(axis="y", alpha=0.3)

plt.tight_layout()
plt.show()
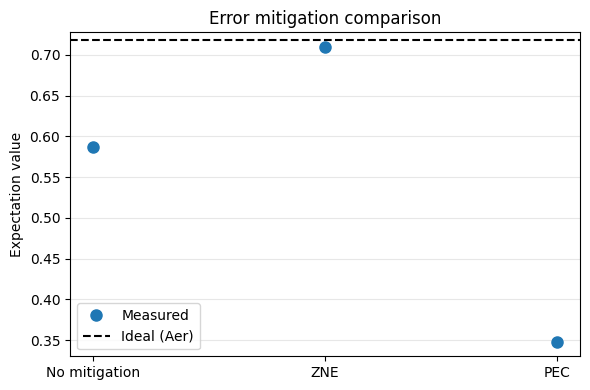
PECは他の選択肢よりも大幅に時間がかかっただけでなく、明らかに最大オーバーヘッドのしきい値に達しました。PECの結果はオーバーヘッドの代償を払いましたが、オーバーヘッドの上限のため、学習したノイズモデルを十分に正確に打ち消すことができませんでした。これは重要な点です。6量子ビットでは、PECを活用し、量子オーバーヘッドのわずかな増加(約5倍)でより良い結果が得られました。30量子ビットでは、はるかに高い代償(約60倍)を払ったにもかかわらず、結果は緩和なしの推定値よりもさらに悪くなりました。これは、30量子ビットでPECが機能しないという意味ではありません。それは回路に依存する可能性があります。要点は、量子オーバーヘッドの指数関数的な増大により、大規模な回路での実行が難しくなるということです。
重要なポイント:
-
測定エラー緩和は多くの場合に有効で、通常はオーバーヘッドも小さく、回路の深さに比例しないバイアスを除去し、ほぼすべての手法ときれいに組み合わせられます。
-
組み合わせられない手法もあります。組み合わせられる場合でも、一方が他方を打ち消してしまわないよう、一貫した方法で組み合わせてください。たとえば、M3と組み合わせる場合は、M3の較正中にツワリングをオンにしておく必要があります。
-
PECとZNEは互いに代替手段と考えるべきです。同じ問題を、反対のトレードオフで解決します。
-
PEC: 指数関数的な分散を代償に、バイアスのない期待値が得られます。
-
ZNEは一般に、外挿モデルに依存する残留バイアスが生じますが、コストは中程度です。
-
-
DDは長いアイドル期間に有効ですが、ノイズモデルを変形させるため、外挿や逆変換の前提を無効にする可能性があります。
-
パウリツワーリングはノイズを減らしません。ノイズの形を変え、他の手法(ZNEやPEC)がより効果的に働くようにすることが多くあります。