最新のワークフロー
このコースでは、量子ノイズとエラーを扱うさまざまな手法を取り上げてきました。これらの手法がどのように機能するかを理解できるよう、あえていくつかのブラックボックス的なソリューションは避けてきました。ここからは、これらの手法を最も現代的な形で使用していきます。具体的には、複雑さの一部を隠してくれる、高度に最適化されたエラー処理ツールを探ります。また、Samplomaticや、シェーデッド・ライトコーン(SLC)などのアドオンも取り上げます。これらを使うと、特定の緩和プロセスをきめ細かく制御できます。
このビデオでは、Chris Porter博士がこれらの最新ツールの概要を説明します。このレッスンには、今後サンプルのワークフローを追加する予定です。ただし、このレッスンには、これらのツールを使用し、バッジ取得試験に合格するために必要な情報がすでにすべて含まれています。
概要
初期のIBM QuantumプリミティブであるEstimatorやSamplerは、少数のプリセットレベルを通じてエラー緩和を提供していました。その後のリリースでは、ゼロノイズ外挿の戦略の選択、Pauliツワーリングの構成、ランダム化パラメータなど、個々の手法をより直接的に制御できるようになりました。しかし、これらの設定は大部分がグローバルであり、回路全体に一様に適用されていました。
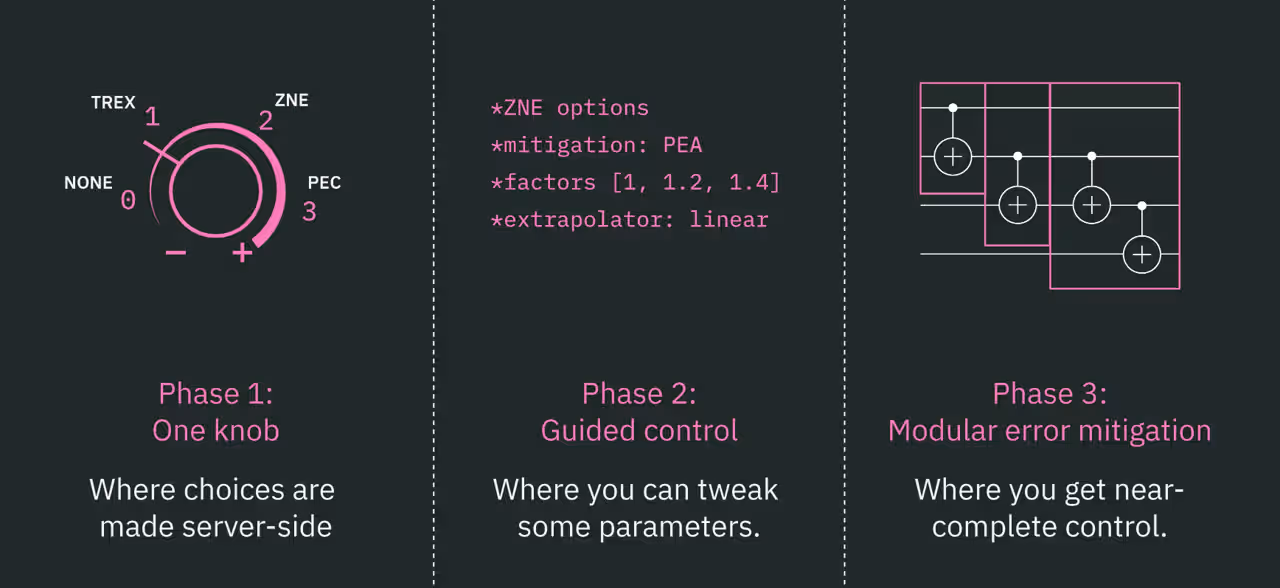
量子ワークロードが高度化するにつれ、開発者には、実行戦略や緩和戦略を回路の特定の領域に合わせて調整する機能がますます必要になっています。次の図は、このレッスンで取り上げるいくつかの主要なツールの概要を示し、一般的なワークフローの中でどこに位置づけられるかを示しています。
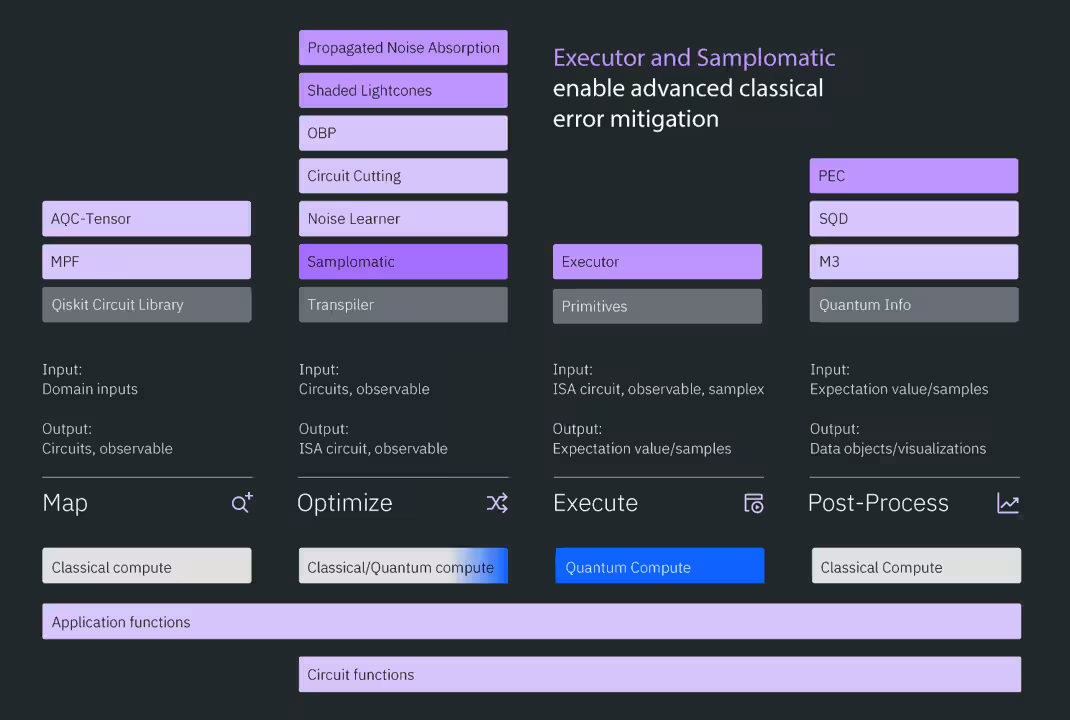
Directed実行モデルは、実行をモジュール単位で制御したいというニーズに対応し、これらのツールの多くを統合します。
Directed実行モデル
Directed実行モデルは、暗黙の実行判断を行うのではなく、ユーザーが指定したディレクティブに従います。このアプローチにより透明性が向上し、複雑なワークフローを検査したりデバッグしたりしやすくなります。このモデルの主な特徴には、次のものがあります。
-
ラベル付けされた回路領域によるレイヤーごとの構成
-
効率的なノイズ学習のための、固有のレイヤーと繰り返されるレイヤーの識別
-
バッチ実行ワークフロー
-
構造化された後処理
-
シェーデッド・ライトコーンなどのアドオンとの緊密な統合
このモデルは、2つの主要コンポーネントを中心に構築されています。
-
Samplomatic: 実行レシピを定義します
-
Executor: それらのレシピを実行し、サンプルを返します
Executorを使用するワークフローの大半は、Samplerでも実装できます。どちらも最終的にはサンプルを生成するためです。Executorの主な利点は効率性です。ツワーリング構成の生成などのタスクは、多くの場合、クライアント上よりもサーバー側のニアタイム環境のほうがはるかに高速です。EstimatorとSamplerは引き続きサポートされており、多くのワークロードにとって依然として最も便利な選択肢となる場合があります。
ただし、実行の前に、回路を構築して準備する必要があります。Qiskitには、回路の生成、シミュレーション、最適化に役立つアドオンがいくつか用意されています。以下のツールの詳細については、リンクをたどってください。
量子回路を構築する
アプリケーションや新しいアプローチによっては、ユーザーが自分の問題を量子回路にどのようにマッピングするかを決定する必要があります。ただし、多くの分野では、Qiskitアドオンがこのプロセスの重要な部分を自動化できます。
最適化マッパー
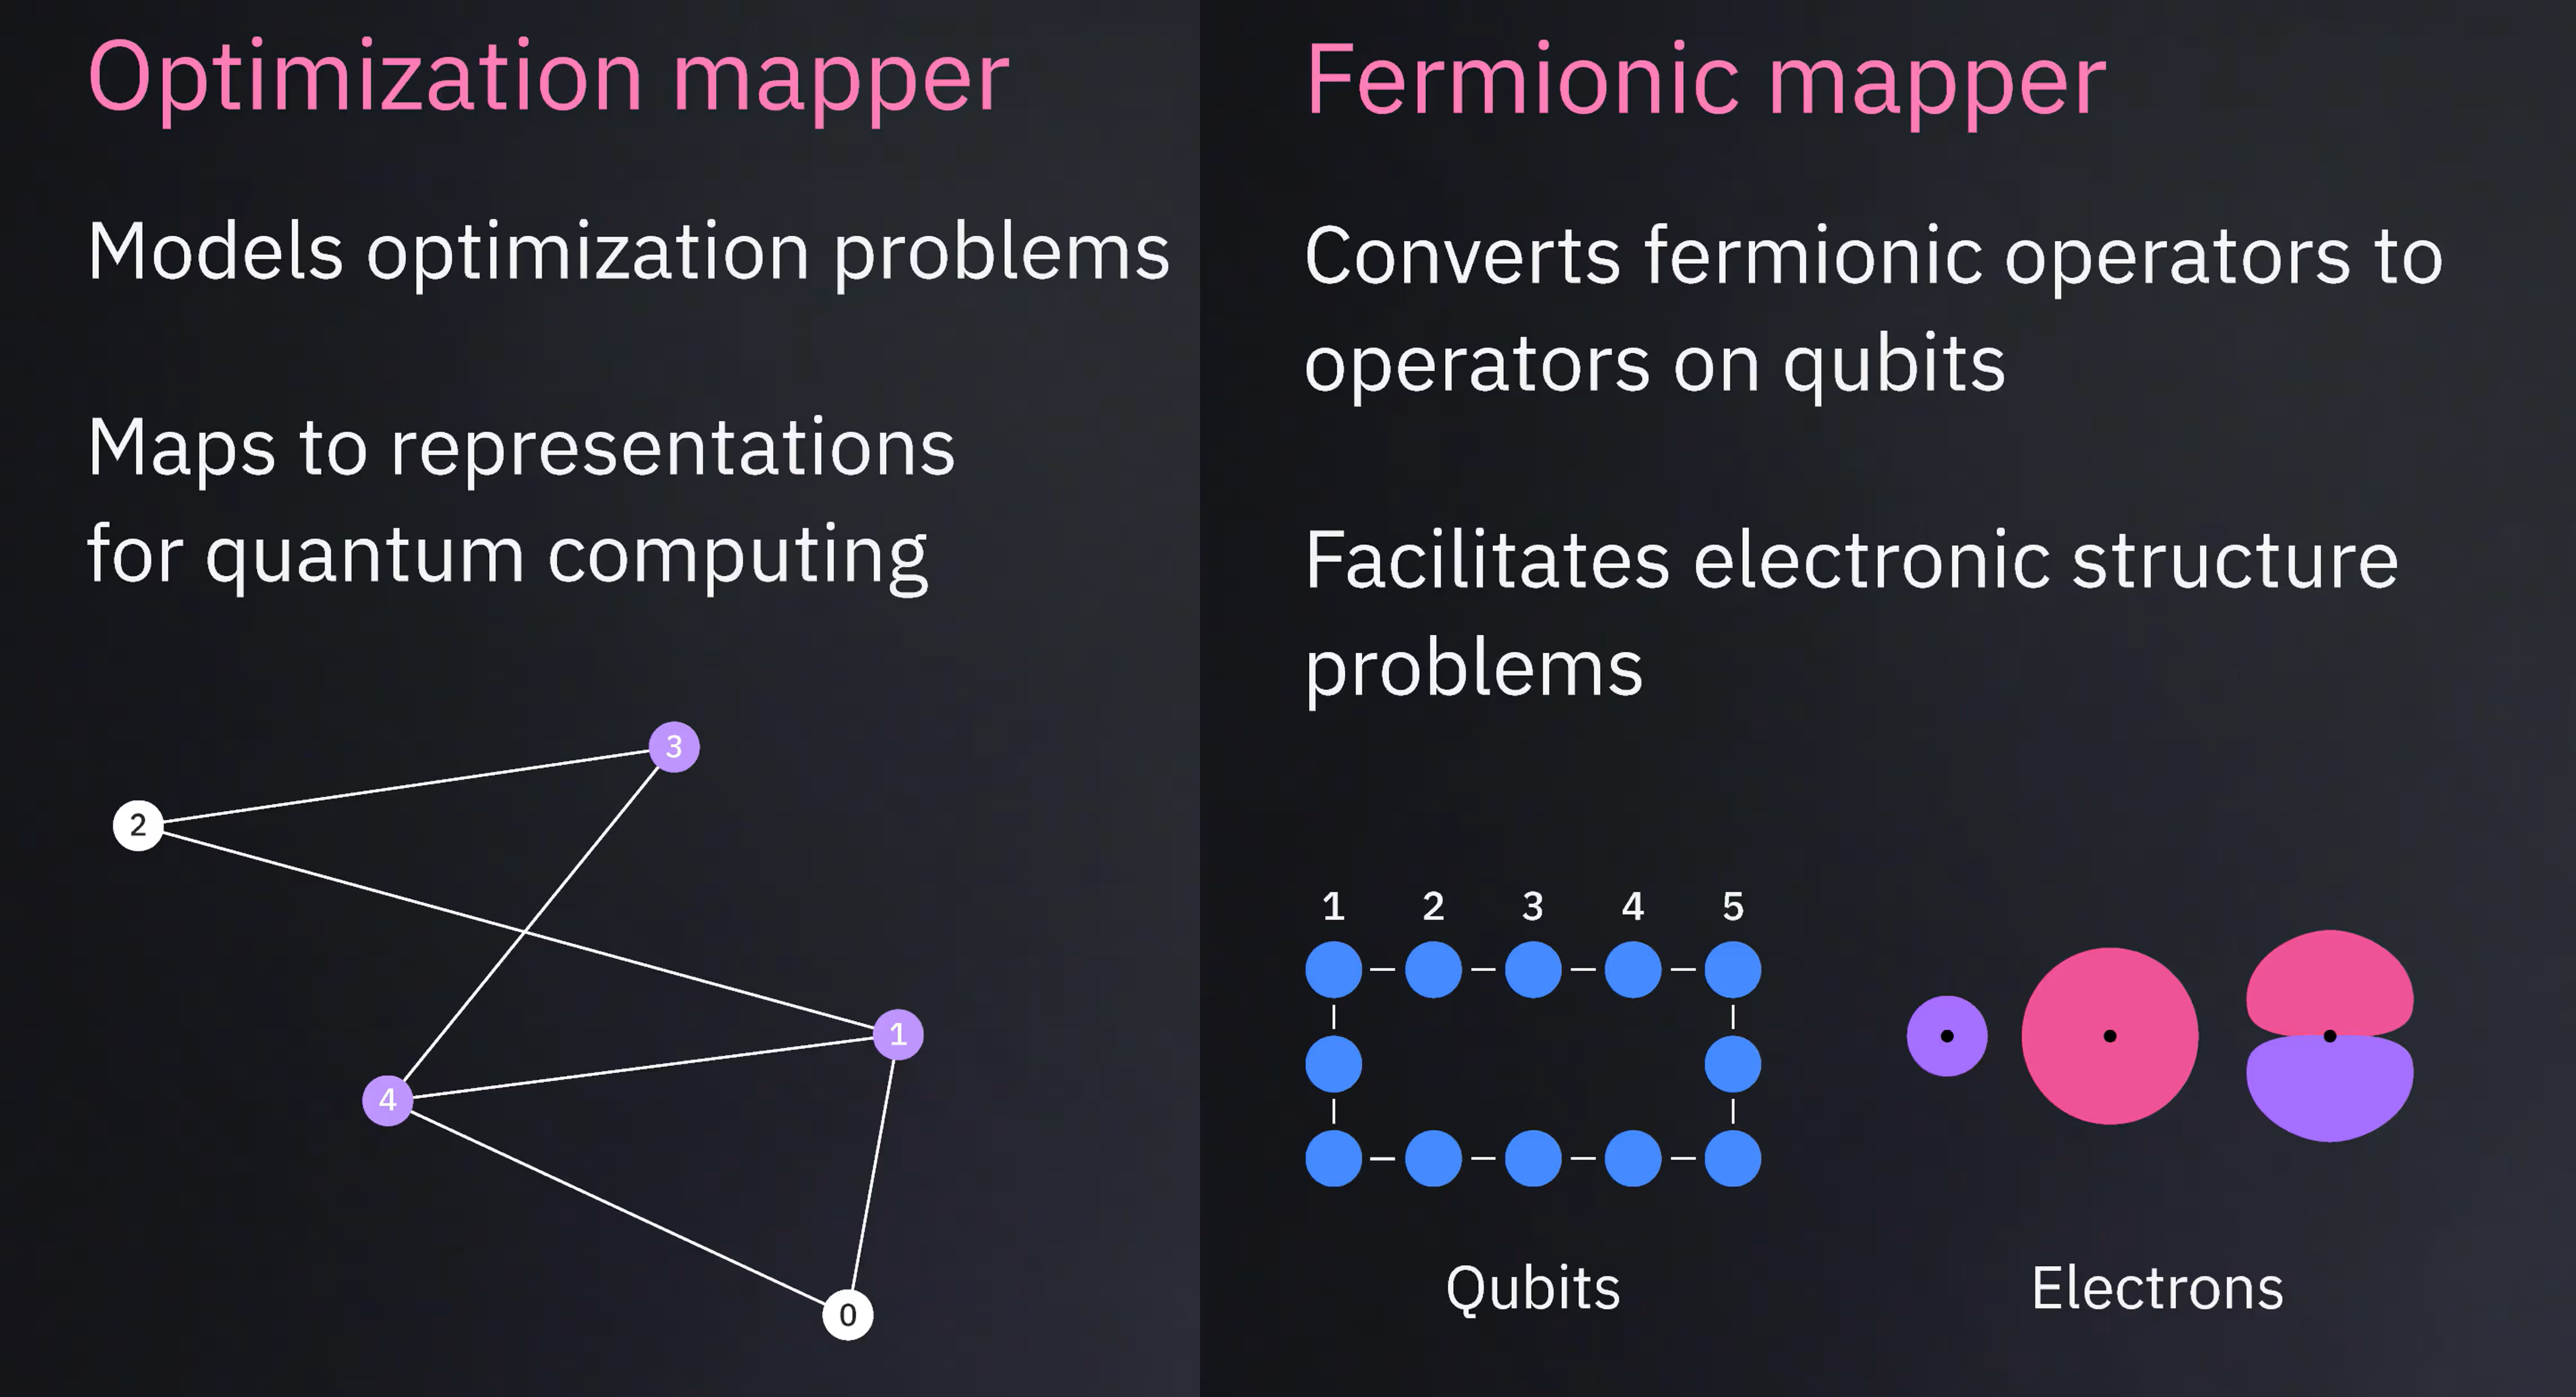
最適化マッパーは、古典的な最適化問題を量子アルゴリズムに適した形式で表現するのに役立ちます。主な機能は次のとおりです。
-
目的関数と制約を構築する
-
問題をQUBO定式化に変換する
-
ハミルトニアンまたは演算子の表現を生成する
フェルミオンマッパー
フェルミオンマッパーは、フェルミオン演算子を量子ハードウェアに適した量子ビット演算子に変換します。Jordan-Wignerなどのマッピングをサポートしており、これは区別できないフェルミオン上の演算子を、フェルミオンの統計を保ったまま、区別できる量子ビット上のPauli演算子に変換します。このアドオンは、量子化学や材料科学のアプリケーションに役立ちます。
前の2つのアドオンは、問題の構造を量子回路に最初にマッピングすることに焦点を当てています。しかし、プロセスの時間発展を量子回路に効率的にマッピングし、深さを減らして回路を最適化することも同様に重要です。次のいくつかのアドオンは、これらのタスクに対応します。
多積公式(MPF)
多積公式は、複数の近似を組み合わせることで、量子時間発展シミュレーションの精度を向上させます。具体的には、Trotterステップ数の異なる回路を作成し、回路結果の重み付き結合を使用できるようにします。目標とする精度が同じであれば、MPFは標準的なTrotter法よりも浅い回路を使用できることが多くあります。その代償として、複数の回路を実行し、その結果を古典的に結合する必要があります。
AQC-Tensor
AQC-Tensorは、テンソルネットワーク手法を用いて近似量子コンパイルを行います。一般的なユースケースは、深い回路の一部を、より浅い変分近似に置き換えることです。結果として得られる回路は、大幅に少ない深さで同程度の精度を達成できます。

トランスパイル
このコースでは、すでに何度もトランスパイルを使用してきました。抽象回路を構築した後は、ハードウェアでの実行に向けて準備する必要があることをご存じでしょう。しかし、トランスパイルの複数のステージについては、まだ詳しく調べていません。
トランスパイルの主なステージは次のとおりです。
-
レイアウト: 論理量子ビットを物理量子ビットにマッピングする
-
変換: バックエンドのネイティブゲートセットを使用して演算を書き換える
-
ルーティング: ハードウェアの接続性に必要なSWAP演算を挿入し、最適化する
これらのプロセスは相互に関連しています。たとえば、レイアウトは、ルーティングを考慮した後でも深さが最小になるようにする必要があります。また、レイアウトは、最もエラーが発生しやすい量子ビットや接続を避ける必要もあります。これらのステージは自動化されていることが多いですが、上級ユーザーは必要に応じて、カスタムレイアウトやその他の制約を指定することもできます。

トランスパイルの詳細については、トランスパイルの紹介ガイドをご覧ください。
理解度を確認しましょう
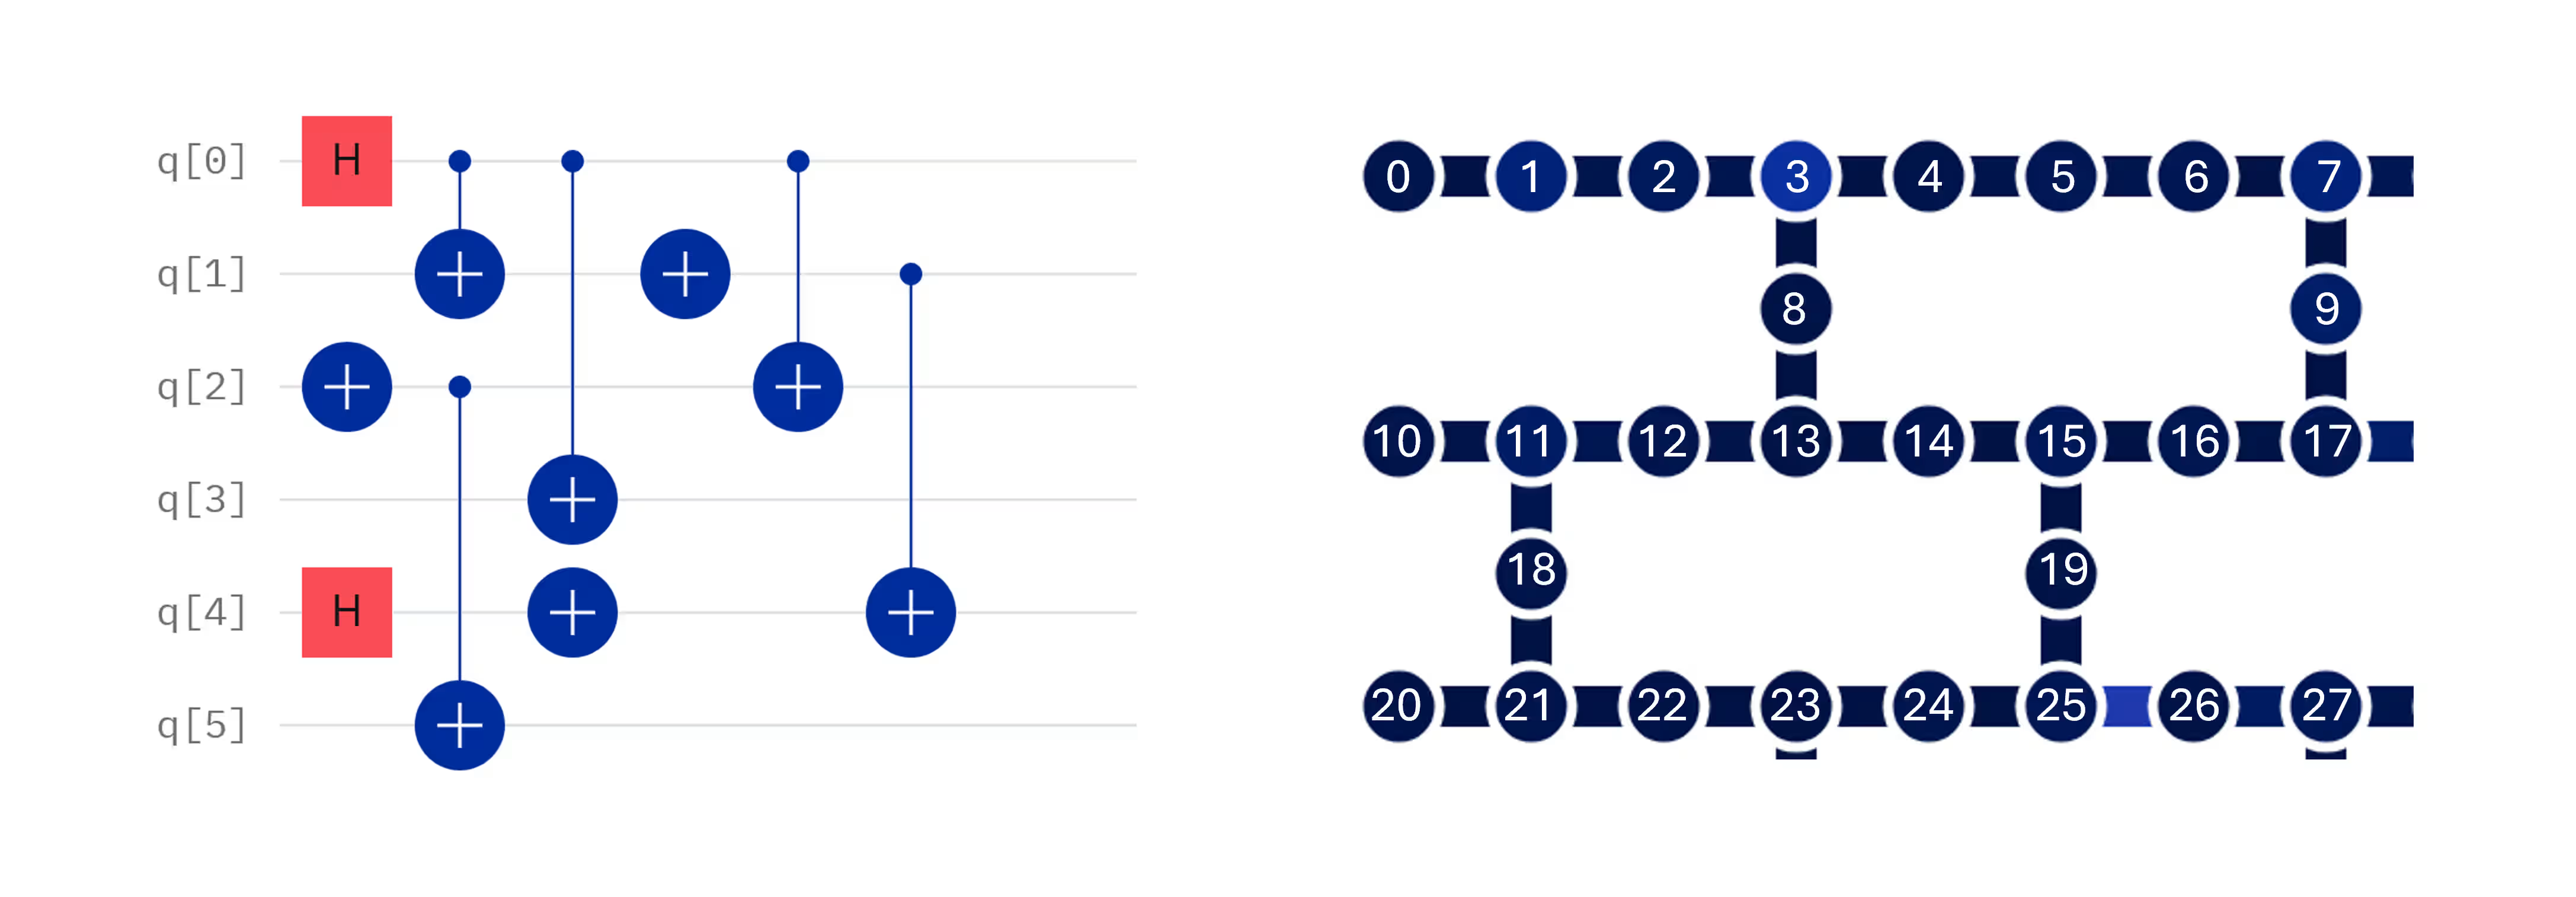
次の量子回路を見て、一部が示されているヘビーヘックス・レイアウトの量子コンピューターでこの回路を実行する必要があると仮定します。(a) 抽象回路の量子ビット番号から物理量子コンピューターの量子ビット番号へのマッピングで、必要なSWAPゲートの数が最小になるものを提案してください。(b) あなたの選択は唯一のものですか、それとも同等に優れた他の選択肢もあるでしょうか。(c) あなたの選択がSWAPゲートを減らす唯一の最適なレイアウトであったとしても、トランスパイラーが別のマッピングを選択する理由にはどのようなものがあるでしょうか。
解答
(a) 正解は多数ありえますが、エンタングルする(2量子ビット)ゲートが3つの隣接量子ビットとの間にあるのは、抽象量子ビット0だけであることに注意してください。それ以外はすべて、2つの隣接量子ビットとのみ2量子ビット演算に関与します。この回路は、SWAPゲートなしでヘビーヘックス・トポロジーにマッピングできます。これを達成するレイアウトであれば、どれでも構いません。抽象量子ビット0を、トランスパイル後の量子ビット0をと表すと、そのようなレイアウトの1つは次のとおりです。
(b) このレイアウトは唯一ではありません。SWAPゲートをまったく使わない他のレイアウトも多数あります。別の例は次のとおりです。
(c) 特定の量子ビットが、チップ上のほとんどの他の量子ビットよりもエラーが発生しやすいことがあります。また、量子ビット間の接続の中にも、他よりエラーが発生しやすいものがあります。トランスパイラーは、不要なSWAPゲートを避けつつ、選択された量子コンピューターで利用可能な最も忠実度の高い量子ビットと接続も使用するレイアウトを見つけようとします。
ノイズとエラーの影響を低減する
いくつかのQiskitアドオンは、ノイズやハードウェアの不完全性の影響を低減することに特に焦点を当てています。
演算子の逆伝播とノイズを考慮した回路変換
コヒーレントなPauliチェックによるエラー訂正の文脈で、演算子の伝播についてはすでに説明しました。しかし、演算子の伝播はより一般的に有用です。量子回路を通じた演算子の伝播を利用する主な方法は2つあります。(1) 量子回路の最後のいくつかのレイヤーを、測定対象の観測量に吸収する。(2) 回路内でエラーが及ぼしそうな影響を考慮し、別の観測量を測定することでそれを補償する。次の2つのツールは、これらのアプローチを使用しています。
演算子の逆伝播
演算子の逆伝播は、回路の末尾にあるゲートを測定対象の観測量に吸収することで、回路の深さを減らします。たとえば、次の回路を考えてみましょう。

この回路には、自明ではなさそうな回転レイヤーとエンタングルメント・レイヤーがあり、その後にCNOTゲートのラダーと、量子ビット5でのZの測定が続きます。この回路の2量子ビット深さは7です。この深さはトランスパイル前のものです。実際には、通常はトランスパイル後に逆伝播を適用しますが、この例は教育目的のものにすぎません。観測量をゲートの手前に伝播させるためのルールがあることを思い出してください。特に、CNOTゲートのターゲットが、制御がの場合、上の観測量は、CNOTゲートを越えて逆方向に伝播するとになります: 。この例の回路で、観測量をCNOTゲートのラダー全体にわたって逆伝播させると、観測量、つまり標準的なQiskit表記では単にが得られます。だけでなくこの観測量を測定すれば、CNOTゲートのラダー全体を取り除くことができ、2量子ビット深さが7から2に減ります。この観測量は、各量子ビットで1つの基底での測定しか必要としないため、必要なshot数は増えません。ただし、常にそうなるとは限りません。一般に、より複雑な観測量にはより多くのshotが必要で、場合によっては異なる基底での測定がさらに必要になります。
演算子の逆伝播の全体的な戦略には、次のステップが含まれます。
-
実行する回路を短くする
-
元の観測量を拡張された観測量に置き換える
-
回路の深さと引き換えに、サンプリング要件を増やす
前の回路は、逆伝播が有利になる分かりやすい例です。しかし一般に、逆伝播から最も恩恵を受ける回路を見分けるのは簡単ではありません。逆伝播を使用するかどうかを判断するには、回路からどれだけ深さを取り除けるかを確認し、その削減量を、増加するサンプリング要件と比較検討してください。
伝播ノイズ吸収(PNA)
伝播ノイズ吸収は、構造的には演算子の逆伝播に似ています。ただし、回路内の理想的なゲートを通じて演算子を逆伝播させる代わりに、PNAは学習済みのノイズモデルを組み込み、ノイズの影響を観測量に直接伝播させます。PNAは次のことを行います。
-
ハードウェアからノイズの挙動を学習する
-
ノイズモデルを回路全体に伝播させる
-
ゲートノイズを補償する、修正された観測量を生成する
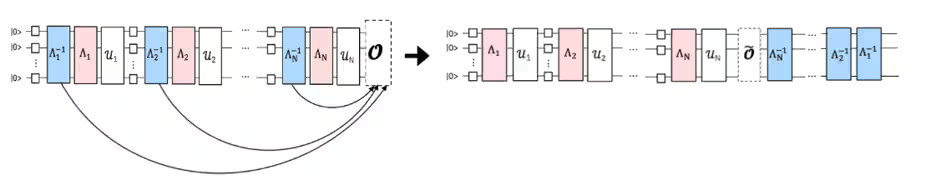
修正された観測量をノイズのあるハードウェアで測定すると、得られる期待値は、理想的なノイズのない結果をより良く近似します。PNAには2種類のオーバーヘッドがあります。1つ目は、ノイズモデルを学習する必要があることで、そのために追加の回路を実行する必要があります。2つ目は、PNAがより複雑な観測量を生成することがあり、サンプリング要件が増える可能性があることです。
回路切断
回路切断は、大きな回路を、独立して実行できるより小さなサブ回路に分割します。その後、結果を再結合するのに十分な測定を行います。回路切断は次のことを行います。
-
ハードウェア要件を低減する
-
利用可能な量子ビット数を超える計算(より幅の広い回路)を可能にする
-
深さと接続性の制限(より深い回路)への対処に役立つ
-
古典的な後処理によって元の結果を再構築する

Samplomatic
前のセクションの手法の多くは、このコース全体で取り上げた他の抑制・緩和手法を補完します。たとえば次のとおりです。
-
動的デカップリング
-
Pauliツワーリング
-
M3
-
TREX
-
ゼロノイズ外挿(ZNE)
-
確率的エラーキャンセル(PEC)
多くのワークフローでは、同じ回路の異なる領域に異なる手法を適用できます。これまで見てきたように、これらの手法の多くには量子オーバーヘッドも伴います。そのため、ノイズ学習、サンプリング、ツワーリング・シーケンスの適用を、細かく詳細に制御する必要がある場合があります。これらが、Samplomaticの背景にある動機の一部です。
Samplomaticは、カスタマイズされたサンプリング、ランダム化、エラー緩和のワークフローを可能にするオープンソースのライブラリです。
最初のタスクは、回路を解析し、ラベル付けされた領域、つまりボックスに分割することです。これらのボックスには2つの目的があります。
-
回路を視覚的に分割する。
-
個別に構成できる、インデックス付きの領域を作成する。
ユーザーは、実行中に各ボックスをどのように扱うかを記述するアノテーションを付けることができます。例としては次のものがあります。
-
すべてのボックスにPauliツワーリングを適用する
-
選択したボックスにのみツワーリングを適用する
-
領域ごとに異なるツワーリング群を使用する
-
学習済みのノイズを特定のレイヤーに注入する
-
緩和戦略をきめ細かなレベルでカスタマイズする
Samplomaticは、繰り返されるボックス化された領域も識別します。同一のレイヤーは通常、似たノイズ特性を示すため、ノイズ学習は固有のレイヤーごとに1回行うだけで済みます。
Samplomaticの出力
Samplomaticは、2つの主要なオブジェクトを生成します。
-
テンプレート回路
-
Samplex
テンプレート回路は、ボックス化され、トランスパイルされ、パラメーター化された、実行可能な回路です。samplexには、回路のバリアントを生成および処理するために必要なすべての情報が含まれています。samplexの内容には次のものがあります。
-
パラメーター化された回路のパラメーター値
-
ランダム化の選択
-
サンプリング分布
-
後処理情報
-
追加の実行メタデータ
形式的には、samplex とは、テンプレート回路のパラメータに関する確率分布であり、実行と後処理に必要な補助情報を伴います。実用上の重要な利点は、テンプレート回路と samplex の両方がクライアント側でローカルに作成されることです。そのため、ハードウェアリソースを使用する前に、それらを調べ、検証し、デバッグできます。
Samplomatic には多くの利点があります。たとえば、適応的なショット配分やランダム化のきめ細かな制御が可能です。また、構造化された後処理ワークフローなど、運用面での利点もあります。最も重要な利点の一つは、同一のレイヤー間で学習済みのノイズ情報を再利用できることで、ノイズ学習中のクォンタム・コンピューティングの時間を大幅に節約できます。
シェーディング・ライトコーン
高コストなエラー緩和手法をどこに適用するかを決める前に、測定対象のオブザーバブルにとって最も重要な回路の領域を特定すると役立ちます。この必要性が、shaded lightcones アドオンの動機となっています。ライトコーンという概念は相対性理論に由来し、そこでは因果関係が、情報が伝わる有限の速度によって制約されます。
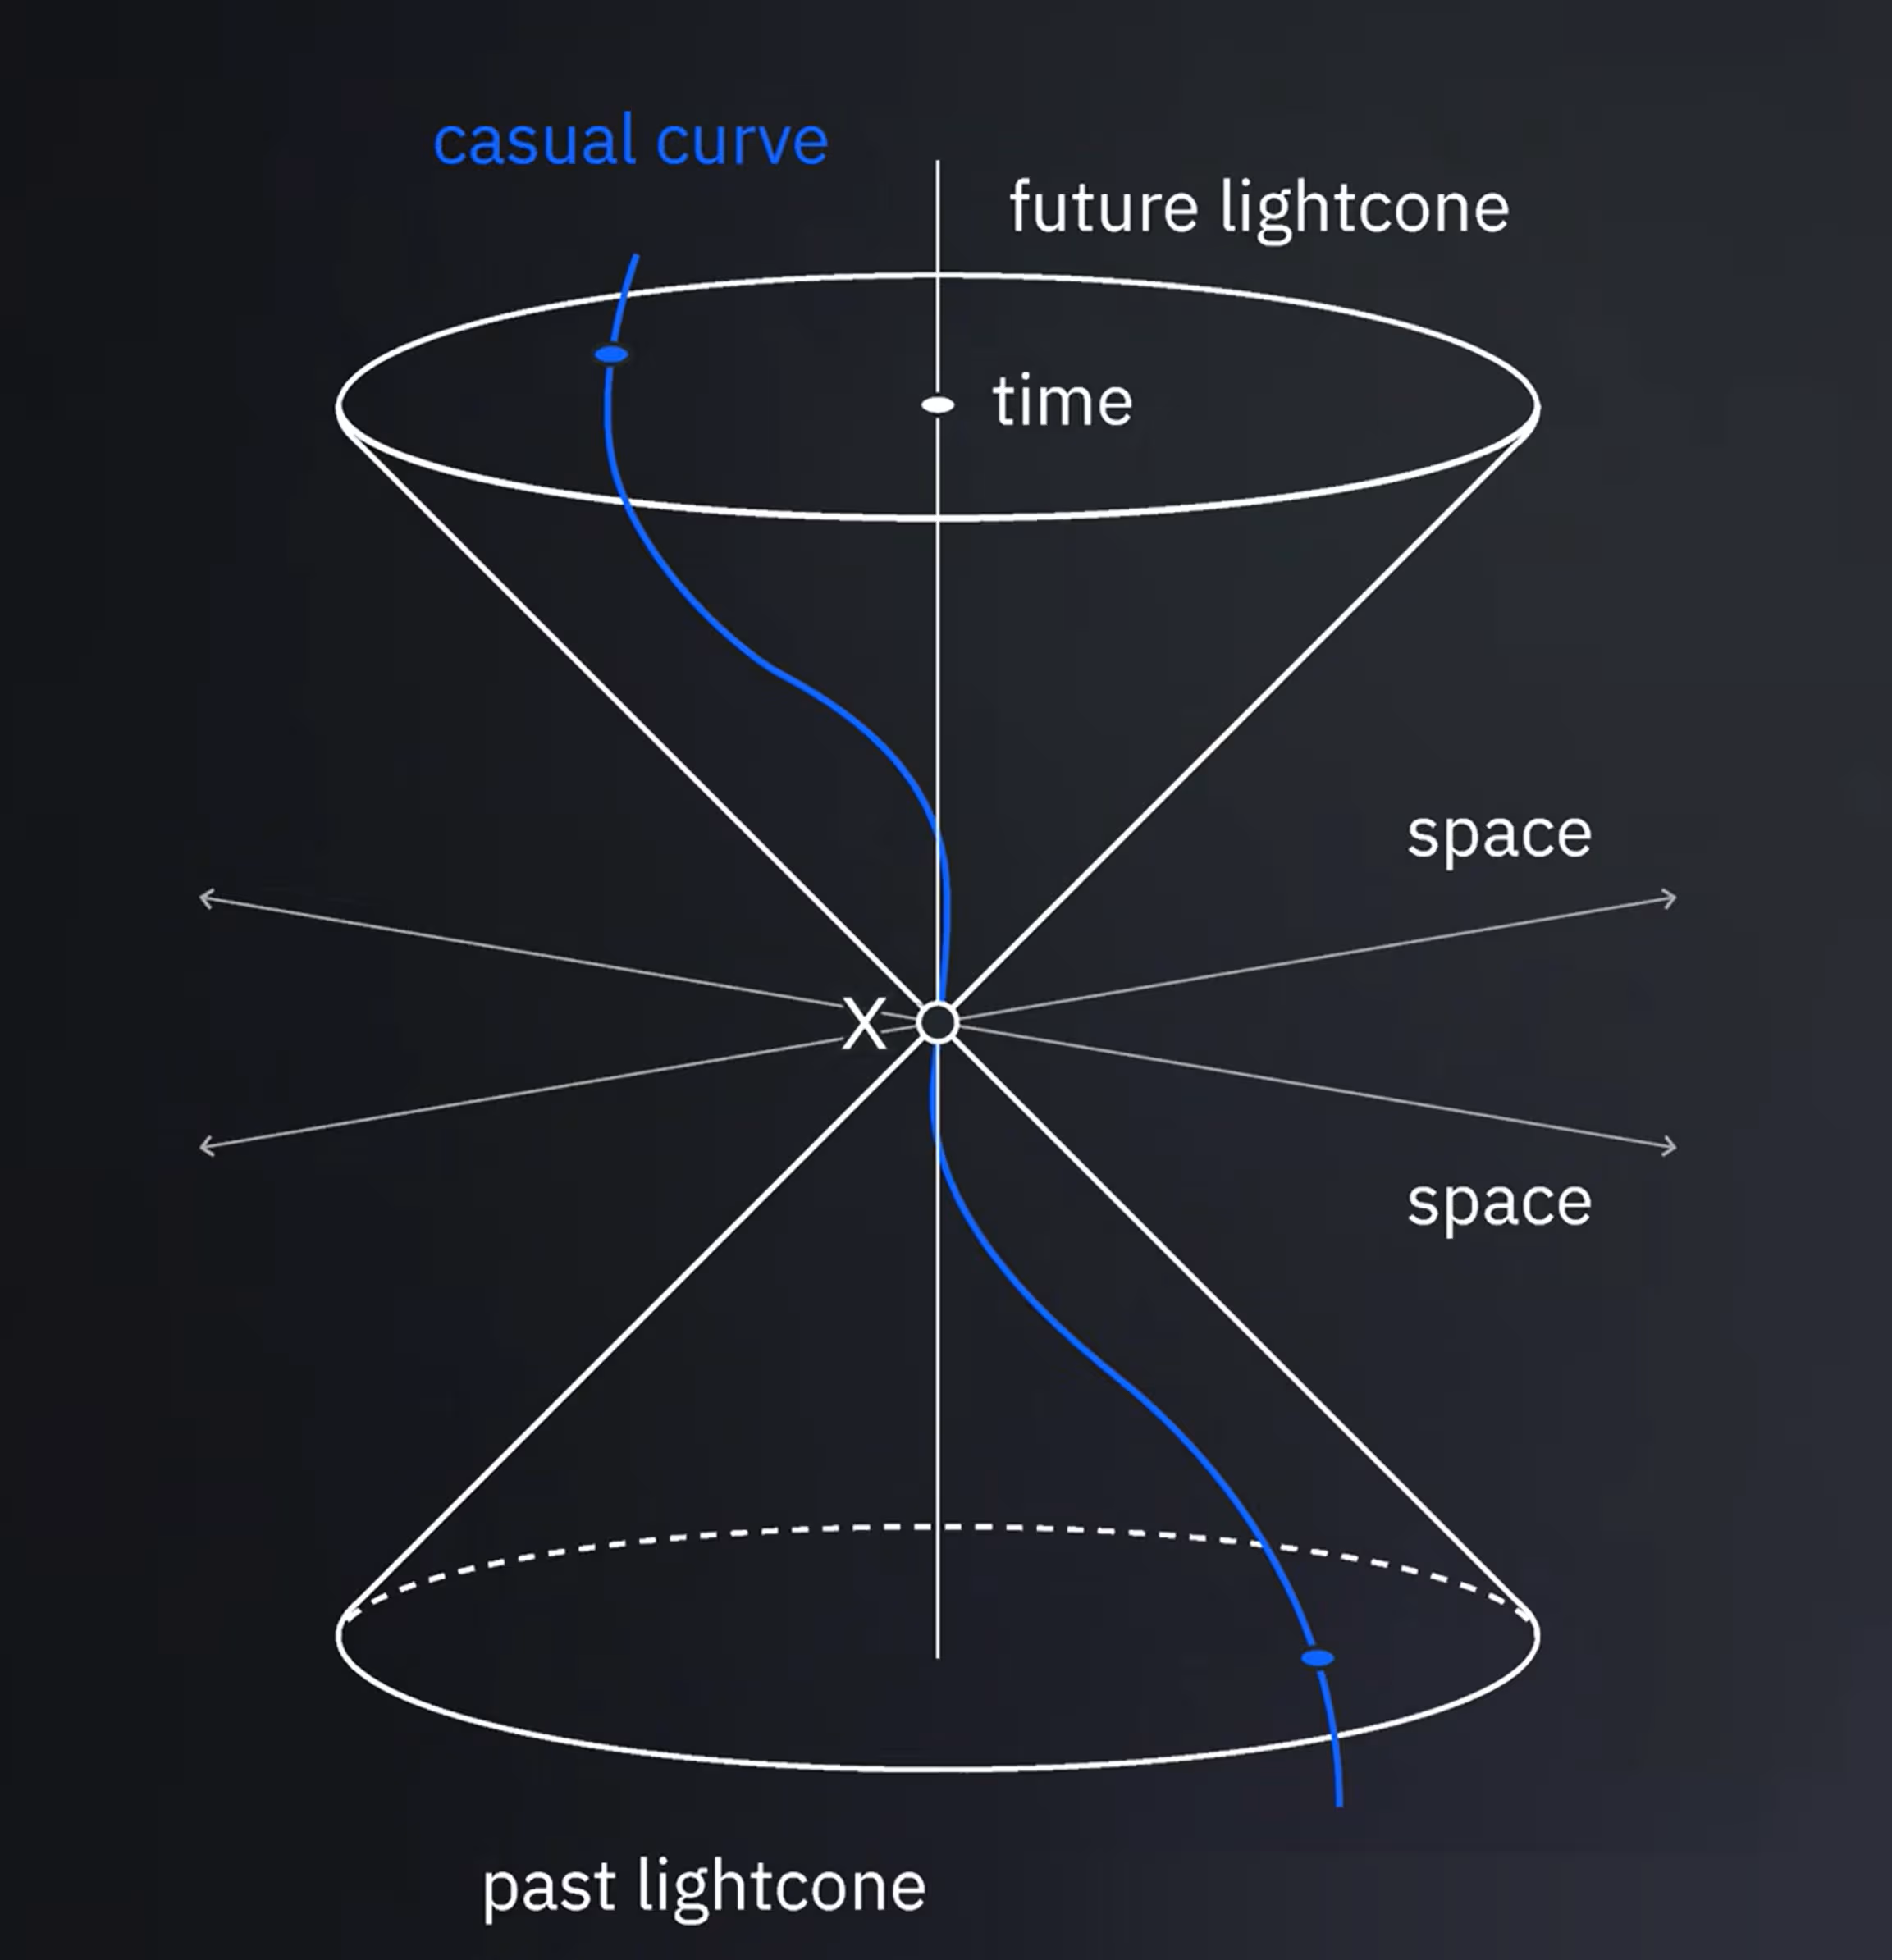
量子回路にも同様の概念が当てはまります。
大規模な回路の中で、低ウェイトのオブザーバブルだけが関心の対象である場合を考えます。低ウェイトのオブザーバブルは、ごく少数のキュービットにのみ非自明に作用します。低ウェイトのオブザーバブルが関心を集める理由は多数あります。たとえば、次のようなものを表すことができます。
-
より大きなハミルトニアンの個々の項
-
局所的な相互作用領域
-
少数のアンシラ・キュービットに集められた情報
-
少数のキュービットのみに関わるその他のオブザーバブル
回路内のすべてのエラーが測定結果に影響を与えるわけではありません。これは特に Pauli エラー、あるいは Pauli 演算の集合としてモデル化できるあらゆるエラーに当てはまります。たとえば、次の回路を見てください。
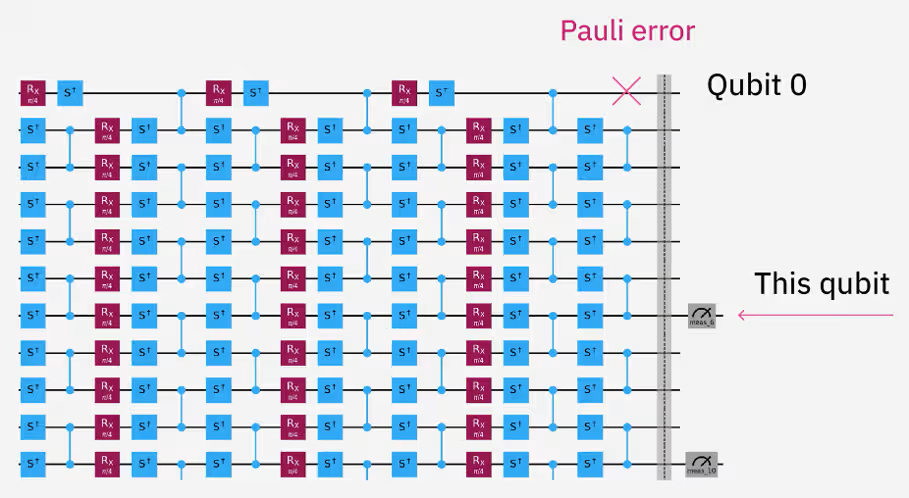
最終レイヤーにおけるキュービット 0 の Pauli エラーは、キュービット 6 の測定に影響を与えません。キュービット 0 からキュービット 6 へエラーを伝播できる接続ゲートがないためです。ただし、この議論は一部の非ユニタリなエラーには当てはまらないことに注意してください。たとえば、キュービット 0 における基底状態への T1 のような遷移は、キュービット 0 を計算基底状態に収縮させます。キュービット 0 と 6 が以前にエンタングルしていた場合(この回路ではそうです)、キュービット 0 の非ユニタリなエラーはキュービット 6 に影響を与えうます。以下の議論では、Pauli 演算として、または Pauli 演算の確率的な混合として表現できるエラーに焦点を当てます。
最後のレイヤーでは、キュービット 5 またはキュービット 6 の Pauli エラーだけが、キュービット 6 の測定に直接影響を与えられます。
その前のエンタングリング・レイヤーでは、キュービット 5 と 6 がそれぞれキュービット 4 と 7 とエンタングルしています。したがって、そのエンタングリング・レイヤー内またはその直前に、これら 4 つのキュービットのいずれかで Pauli エラーが発生すると、後の測定に影響を与えうます。回路を後ろ向きにたどり続けることで、測定と因果的につながっているゲートとキュービットの部分集合を見つけられます。この因果的な集合は、空間(キュービット)と時間(レイヤー)の中で円錐状の領域を形成し、これがライトコーンという用語の由来です。領域の正確な形は回路ごとに異なります。この分析はハードウェアの接続性とゲートの配置に依存するため、トランスパイル、ルーティング、レイアウト最適化の後に最も役立ちます。
因果的な接続性を超えて
シェーディング・ライトコーンは、どの種類のエラーが重要かも考慮することで、この考え方を拡張します。
たとえば、次の点に注意してください。
-
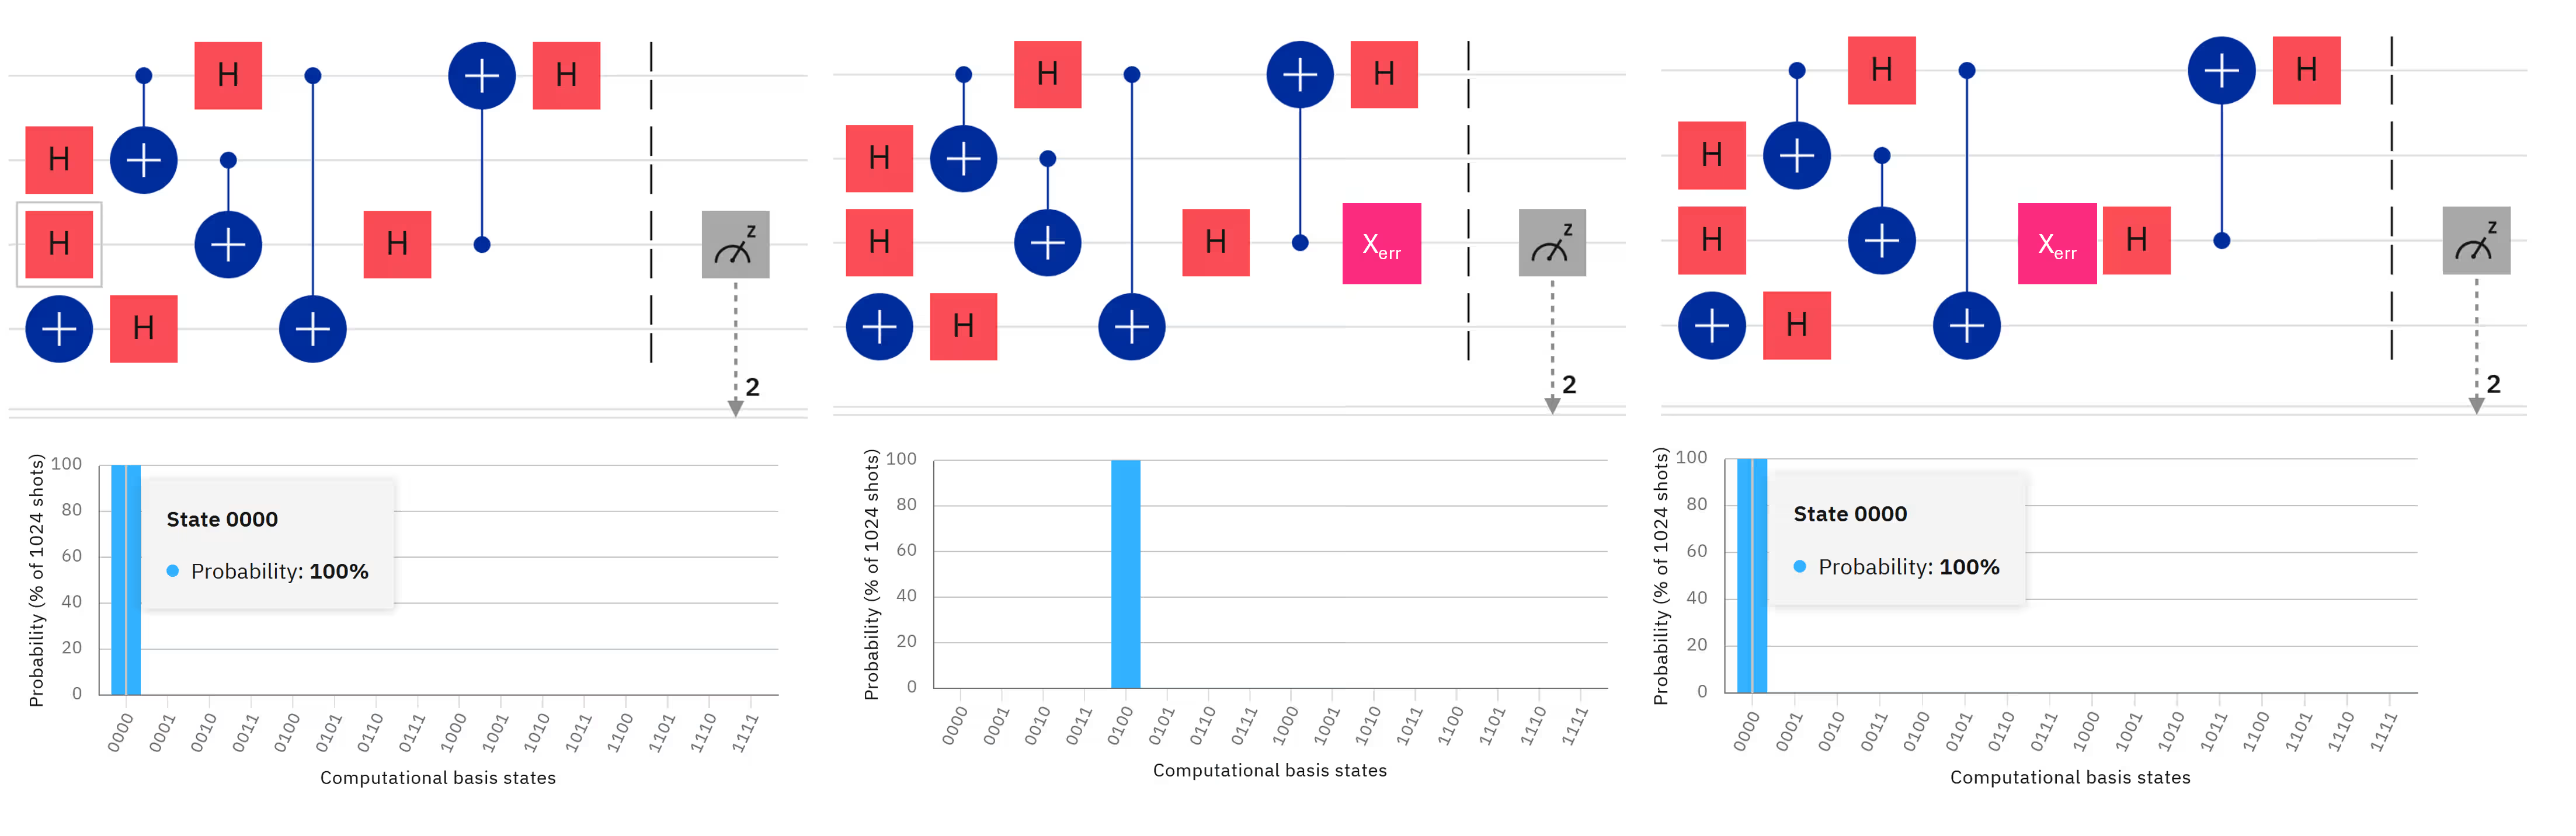
Z 基底測定の直前の Z エラーは、測定結果に影響を与えません。
-
Z 基底測定の直前の X エラーは、結果を劇的に変える可能性があります。
したがって、エラーの種類によっては、他の種類よりも多くの緩和の労力を割く価値があります。この区別によって、PEC などの手法のオーバーヘッドを大幅に削減できます。実際には、アドオンは次の各エラー種別について個別の感度分析を生成します。
-
X errors
-
Z errors
-
Y(または位相を除いて XZ)エラー
このエラー感度は、一般にエラーの種類ごとに異なって見えます。因果的につながった異なるエラーが、測定に異なる影響を与えるためです。また、感度は回路全体を通して変化することにも注意してください。測定の直前の X エラーは大きな損害を与えるかもしれませんが、何レイヤーも前に発生したエラーは、高度にエンタングルした状態を通って伝播した後では影響が小さくなるかもしれません。
シェーディング・ライトコーンは、回路全体の潜在的なエラーに感度の値を割り当てることで、この違いを定量化します。
得られるマップは、次のことを示します。
-
エラーがどこで重要か
-
どの種類のエラーが重要か
-
それらが最終的なオブザーバブルにどれほど強く影響するか
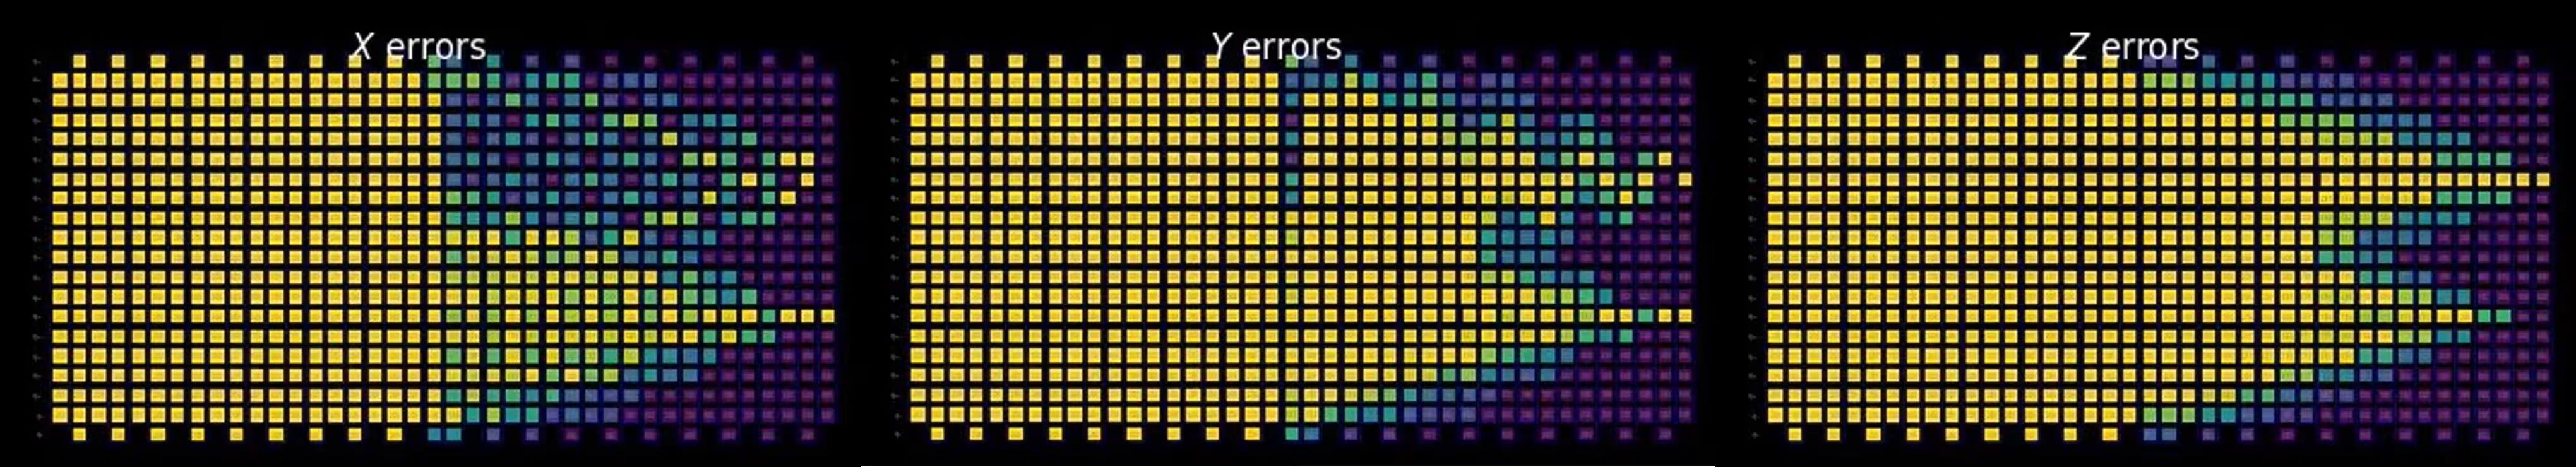
シェーディング・ライトコーン自体はエラーを緩和しませんが、最大の効果が得られる箇所に緩和の労力を集中させる助けになります。
ノイズの学習と注入
回路が構築、最適化、注釈付けされた後には、2 つの補完的なタスクが残ります。ノイズを学習することと、ノイズモデルを使用すること(たとえば、ノイズを注入したり、ノイズの影響を伝播させたりすること)です。
NoiseLearnerV3
NoiseLearnerV3 は、ノイズ学習のための現在のツールです。以前の NoiseLearner インターフェースは回路全体を受け取り、Pauli-Lindblad ノイズモデルを生成していました。NoiseLearnerV3 は代わりに、ボックス化された回路命令に対して直接動作します。要約すると、NoiseLearnerV3 は次のことを行います。
-
ラベル付けされた回路レイヤーのコレクションを受け取ります
-
繰り返されるレイヤーからの情報を再利用します
-
測定ノイズの学習をサポートします
-
学習済みモデルの後処理をサポートします
-
ノイズの注入とスケーリングのワークフローを可能にします
この設計は、Samplomatic のレイヤー指向のワークフローとよく整合しています。特に、NoiseLearnerV3 は各命令セットに対して次の手法を使用します。
-
ゲート操作に対する Pauli-Lindblad 学習
-
測定に対する TREX ベースの学習
学習済みのノイズモデルは、これまでに取り上げた多くの手法で使用できます。たとえば、ゲート・フォールディングを用いたゼロノイズ外挿(ZNE)は、扱いきれないほど深い回路につながりうることを思い出してください。その場合にノイズをスケーリングする代替手法は、既知のノイズモデルからサンプリングすることでした。これにより、整数でない係数でも、実効的にノイズレベルを増やせます。この手法である確率的エラー増幅(PEA)は、ノイズモデルを使ってエラーを緩和する好例です。確率的エラーキャンセル(PEC)や伝播ノイズ吸収(PNA)にも、優れたノイズモデルが必要です。
要するに、高品質なノイズモデルがあれば、ノイズは単なるエラーの原因ではなく、プログラム可能なリソースになります。
シェーディング・ライトコーンと NoiseLearnerV3 の比較
NoiseLearnerV3 と SLC は密接に関連していますが、入力が異なり、答える問いも異なります。SLC は緩和の労力をどこに集中させるかを決定します。NoiseLearnerV3 は、それらの領域に実際に存在するノイズを特徴付けます。これらのプロセスは、オーバーヘッドの種類も異なります。次の表に、これらの違いをまとめます。
| シェーディング・ライトコーン | NoiseLearnerV3 | |
|---|---|---|
| 目的 | 緩和が重要な場所を特定する | エラーの振る舞いを学習する |
| オーバーヘッド | 主に古典的なオーバーヘッド | ハードウェアでの実行が必要 |
| 出力 | 感度マップを生成する | ノイズチャネルの記述を生成する |
| 入力 | 回路構造と演算子の伝播を使用する | 回路構造と実験的なハードウェアデータを使用する |
Executor と Runtime の実行
Executor は最終的な実行ステップを担います。次のいずれの入力に対しても動作できます。
-
Samplomatic によって生成されたテンプレート回路と samplex
-
Samplomatic を使用しない従来の量子回路
この柔軟性により、指示付き実行ワークフローのコンポーネントを、必要に応じて多くでも少なくでも採用できます。
Executor は Samplomatic と緊密に連携します。Samplomatic は、前述のとおり、ランダム化の選択、ショット配分、ノイズ注入の選択、および関連する実行メタデータを管理します。
指示付き実行モデルの実践的な例については、Directed execution model ガイドのほか、IBM Quantum® Platform のチュートリアルと Qiskit アドオンのドキュメントを参照してください。
まとめ
現代の量子ワークフローは、単一の実行プリミティブではなく、補完的なツールの集合にますます依存しています。
これらのツールは、ワークフローのあらゆる段階をサポートします。
-
問題のマッピング
-
回路の構築
-
トランスパイルと最適化
-
エラー抑制
-
エラー緩和
-
ノイズ学習
-
構造化された実行
-
後処理
Samplomatic、Executor、NoiseLearnerV3、シェーディング・ライトコーン、伝播ノイズ吸収、回路切断、AQC-Tensor などのツールを組み合わせることで、従来の実行モデルよりはるかに多くの制御が可能になります。
この分野は急速に進化し続けています。量子プロセッサがより大規模になり、より多く接続されるにつれて、これらの手法は、有用な量子優位性の達成において、そして最終的には耐障害性クォンタム・コンピューティングのワークフローとのシームレスな統合において、ますます重要な役割を果たすでしょう。