エラーの抑制と調整
エラー抑制とは、特定の種類のノイズやエラーを予測し、それを回避しようとするあらゆる手法を指すことがあります。これは具体例を通じて説明するのが最も分かりやすいですが、これらの手法はここで示す例に限定されるものではなく、新しい手法が継続的に研究されていることに留意してください。エラーを抑制することができない場合もありますが、その蓄積の仕方に影響を与えることは可能な場合があります。エラーの蓄積をより遅くできる場合、それを全体的なエラーの抑制と表現することもできますが、より正確にはノイズの調整と見なすべきです。このレッスンでは、エラー抑制の代表的な例(ダイナミカル・デカップリング)と、ノイズの調整/整形の代表的な例(パウリ・ツワリング)を扱います。
このレッスンに付随する動画は数日以内に公開され、ここに埋め込まれる予定です。
ダイナミカル・デカップリング
まず、単一量子ビット上の非常に単純な状態から始め、単純なノイズモデルを導入します。これだけではダイナミカル・デカップリングを完全に説明するには不十分ですが、明確な例を示してくれます。アダマールゲートを使用して重ね合わせ状態に準備された量子ビットがあるとします。
この状態は、下図の左側に示すようにブロッホ球上で可視化されます。ノイズがゼロの理想的な場合、この量子ビットは次の操作が実行されるまでこの状態を維持します。しかし、前回のレッスンで学んだように、実際に観測されるのはそうではありません。ノイズによって量子情報が劣化するのです。
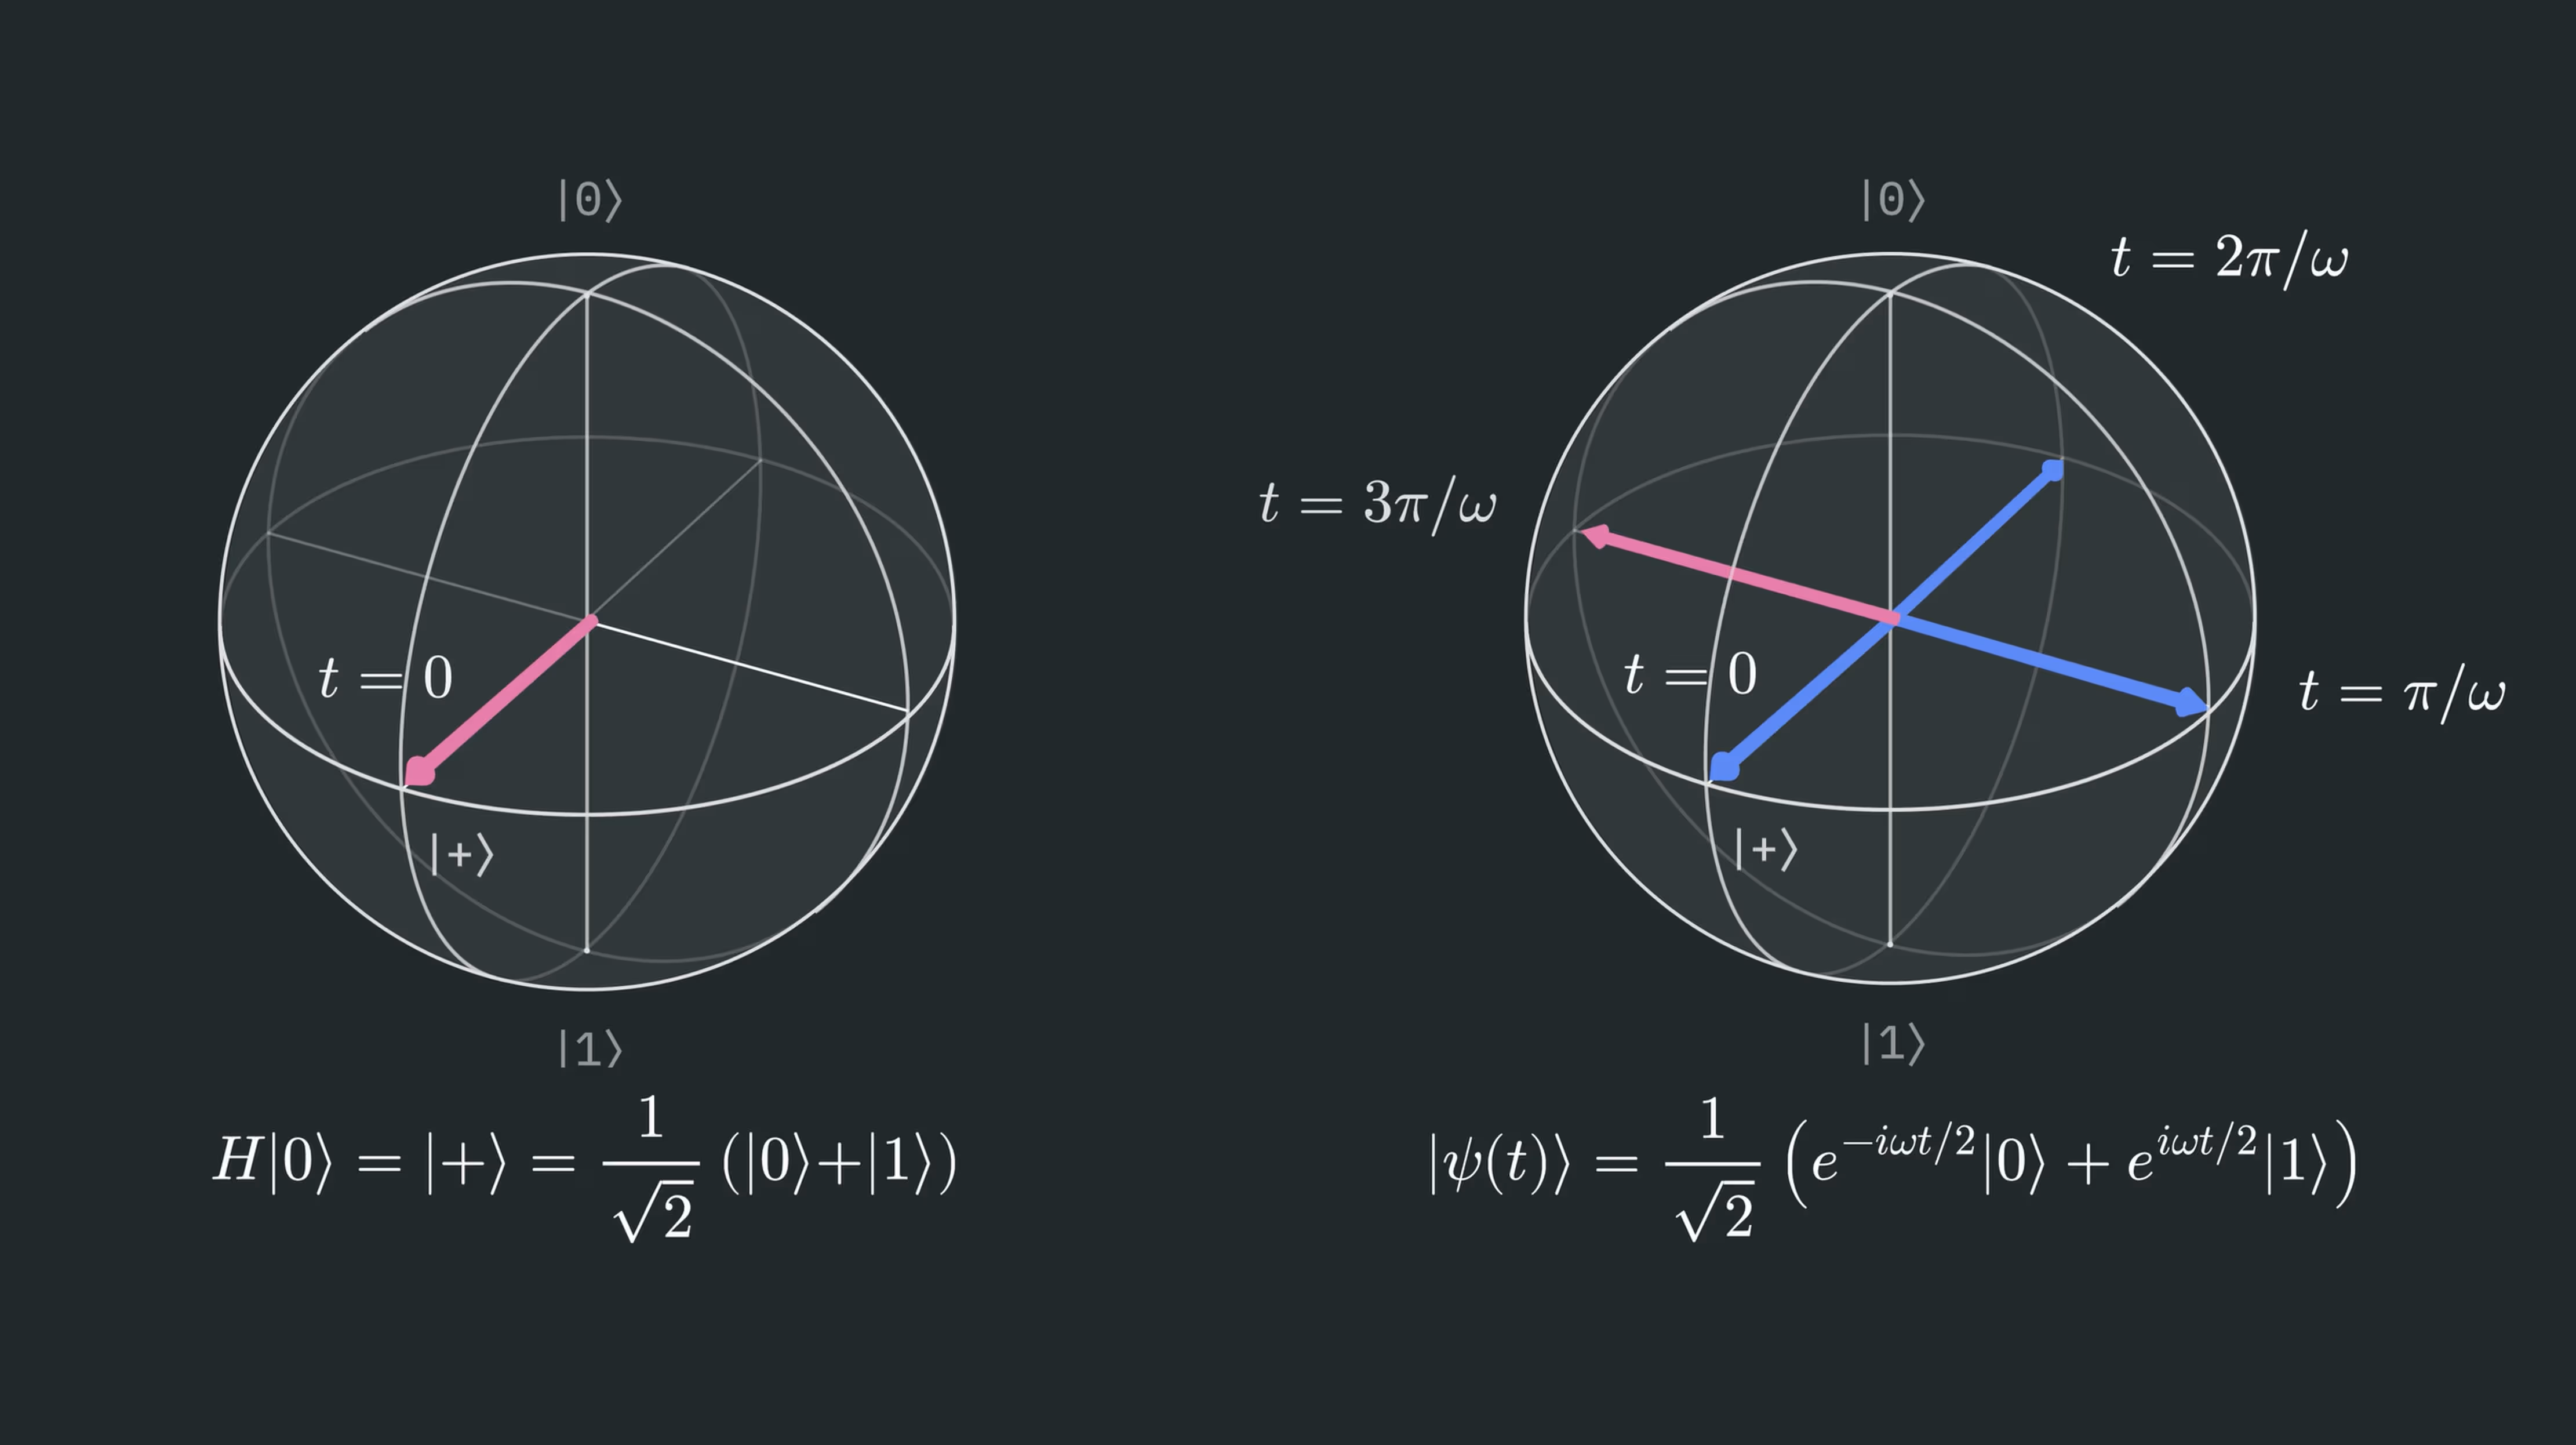
ノイズや環境との結合により、基底状態間の相対位相が変化することがあります。つまり、係数の絶対値は変化しないため、との確率は変化しません。むしろ、振幅の位相が変化し、その実部と虚部が変わります。この議論をより具体的にするために、これを引き起こす可能性のある相互作用の一種、すなわちZ方向を向いた磁場への結合を考えてみましょう:。
時間が経過するにつれて状態に何が起こるかを考えてみましょう:
ここでは、Z方向の磁場が、有効磁気モーメントと磁場強度に依存する周波数でZ軸周りの歳差運動を引き起こすという事実を利用しています。細部よりも重要なのは、この相互作用がZ軸周りの時間発展を引き起こし、2つの計算基底状態に対して互いに逆方向の位相蓄積をもたらすという事実です。この演算子をの各項に適用すると、以下が得られます:
この時間依存の位相は、ブロッホ球描像におけるZ軸周りの歳差運動に対応します。これは上図の右半分に示されています。
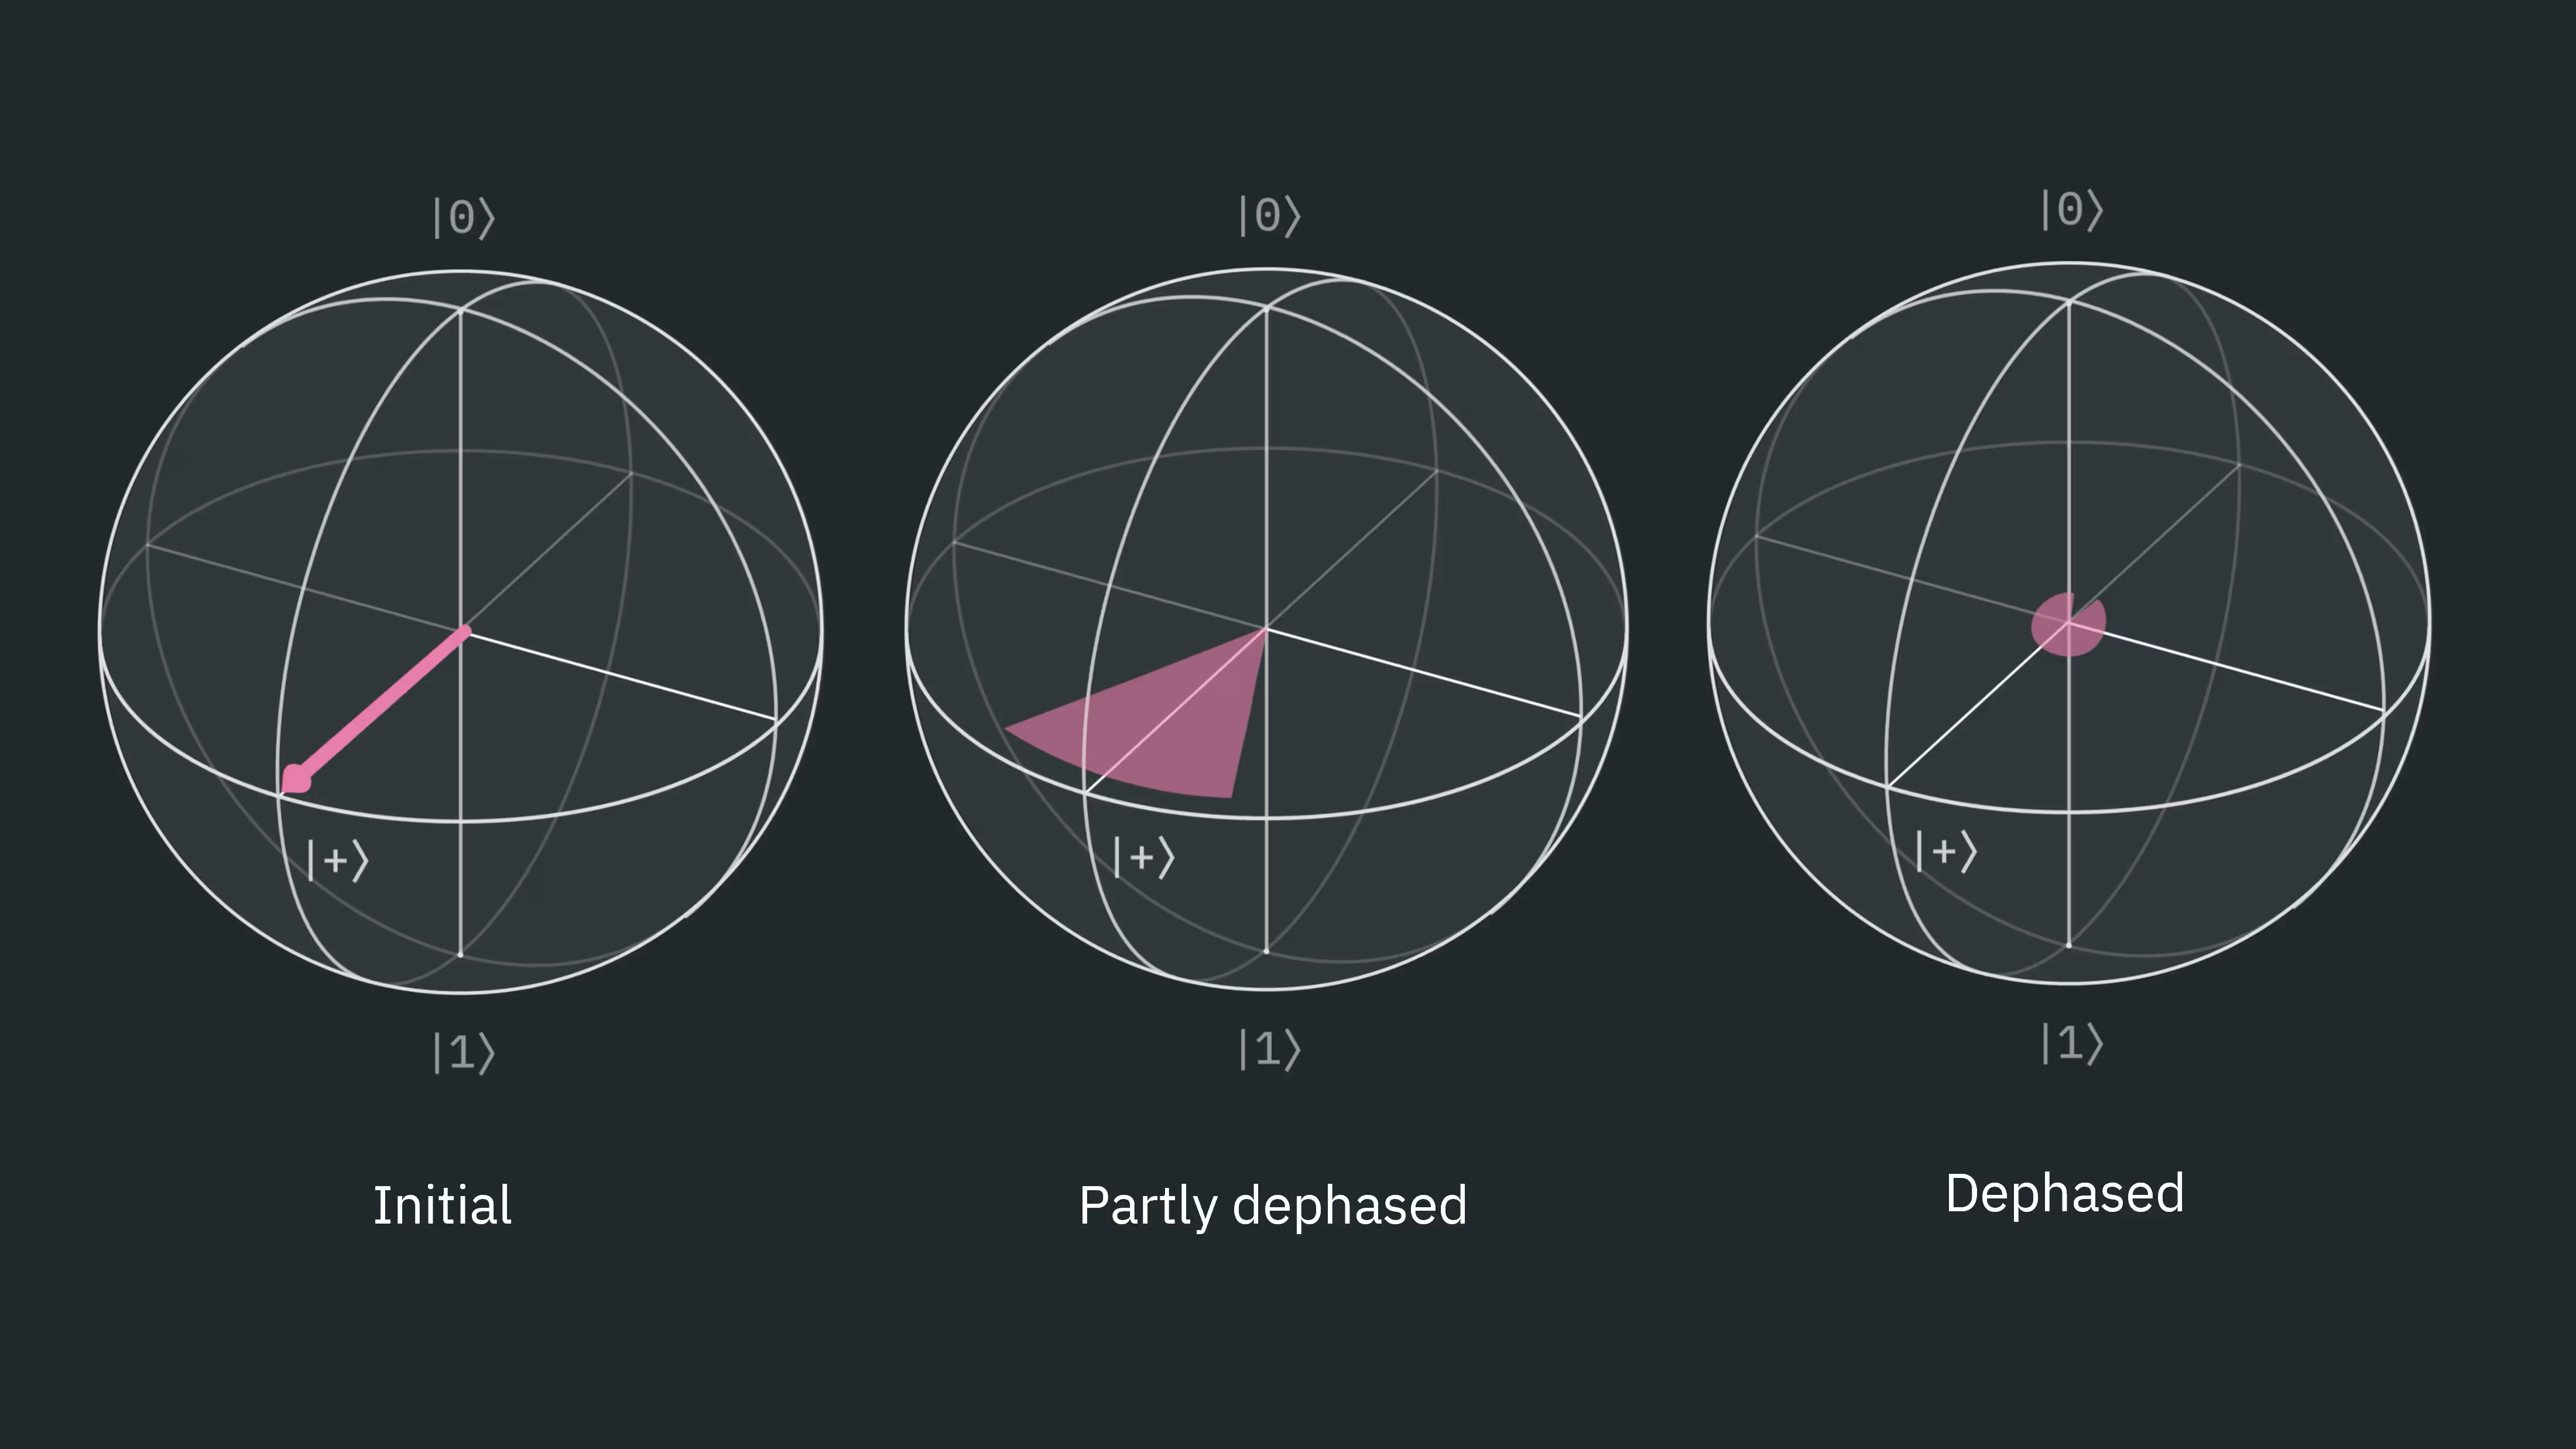
この相互作用が制御された形で起こっていることがわかっていれば、それを予測できるでしょう。この種のノイズをモデル化するために、代わりに、それぞれがある古典的確率で発生する可能性のある磁場強度の分布を考えます(他のノイズ源は異なる方法でモデル化する必要があります)。状態が全く回転していない古典的確率がゼロでない場合や、わずかに、あるいは大きく回転している確率がある場合に何が起こるかを考える必要があります。このような回転の可能性の分布が、下図のブロッホ球描像における状態の広がりの原因です。このようなデフェージングノイズが多いほど、位相の定義はより不明確になります。強いデフェージングの極限では、量子ビットは完全にデフェーズし、状態に蓄えられた量子コヒーレンスの喪失に相当します。
もちろん、実験ではどのようなランダムな結合が発生するかは分かりません。これに対して何ができるでしょうか?
環境との結合が時間間隔の間、ほぼ一定であると仮定します。次の手順に従った場合に何が起こるかを考えてみましょう:
-
時間の間、位相を変化させる
-
量子ビットにXゲートを適用する
-
さらに時間の間、同じ環境結合を発生させる
-
2つ目のXゲートを適用する
最初の時間発展の後、上記の状態がまさに得られます。最初のXゲートを適用すると、次のようになります:
次に、2回目の時間間隔が経過すると、同じ相互作用が起こります。しかし今度は、振幅が逆のZ固有状態に関連付けられているため、Z軸周りの回転の符号が反転しています。系をさらに時間の間発展させると、次の状態が得られます:
そしてを代入すると:
この場合、最後のXゲートを適用しても何も起こりませんが、一般には必要です:
相対位相も含めて、元の量子状態を回復しました。この過程は、ダイナミカル・デカップリングの特に単純な例です。
より一般的には、ダイナミカル・デカップリング(DD)は、量子ビット外部のシステムとの相互作用の影響を減らす(量子ビットを環境から切り離す)ために、いくつかの単一量子ビットゲートを挿入することを意味します。上記のように、あり得るすべての位相履歴が元の状態に完全に収束することはやや理想化されていますが、それでも起こり得るシナリオです。DDがいつ有用か、そしてどのような注意点があるかについて議論しましょう。
理解度を確認しましょう
上記の本文では、初期状態に対するXX DDシーケンスの効果を順を追って説明しました。z方向に沿ってゆっくり変化する磁場という同じ仮定の下で、上記と同じ手順が状態も初期状態に戻すかどうかを確認してください。
回答
最初の時間発展の後、上記の状態がまさに得られます。最初のXゲートを適用すると、次のようになります:
次に、2回目の時間間隔が経過すると、同じ相互作用が起こります。しかし今度は、振幅が逆のZ固有状態に関連付けられているため、Z軸周りの回転の符号が反転しています。系をさらに時間の間発展させると、次の状態が得られます:
そしてを代入すると
最後のXゲートを適用すると、次のようになります:
DDをいつ使うか
最初の、そして最も明白な注意点は、今回の議論では純粋なデフェージングチャネルを仮定したという点です。現実世界の相互作用では、通常デフェージングと他のエラー機構が混在して生じます。上記の議論では、特にXゲートを適用することを選びました。これはダイナミカル・デカップリングにおいてXXシーケンスと呼ばれます。この特定のシーケンスは、純粋なデフェージングエラーに適しています。しかし、下図の回路図に示すXY4や、より複雑なXY8など、より広く適用できる可能性のある他のシーケンスもあります。

もう一つの注意点は、ダイナミカル・デカップリングは単一量子ビットゲートを追加するため、ゲートの不完全性やクロストークによる単一量子ビットエラーが追加される可能性があるという点です。これらの単一量子ビットエラー率は通常、多量子ビットゲートのエラー率よりもはるかに低いため、通常は大きな懸念事項ではありませんが、回路全体で多くの量子ビットが何度もDDを使用している場合には留意しておくべき点です。
DDは、外部結合が量子ビットの状態に影響を与える時間的余裕がある場合に有用です。量子ビットは念入りによく孤立させられており、外部結合は弱いはずなので、この種のノイズは量子ビットが長時間アイドル状態にあるときに最も顕著になります。アイドル時間が短い場合、DDの効果はほとんどノイズを抑制しないまま単一量子ビットゲートエラーを追加することになりかねず、回路の忠実度がかえって低下する可能性があります。
重要なポイント: 量子ビットが十分に長い期間アイドル状態のままである場合にダイナミカル・デカップリングを使用し、使用するDDシーケンスの種類に注意を払ってください。
Qiskitを使用したダイナミカル・デカップリング
状態に準備され、その後長時間アイドル状態のままとなる複数の量子ビットのケースを検討することで、DDの使用について探ってみましょう。エラーがない場合、多量子ビット状態を準備し、測定前にアダマールゲートを適用する(これによりX基底で測定する)と、常に0が得られるはずです。ノイズがある場合、測定結果は100%の確率ではなく、一部の割合でのみ0になります。複数の量子ビットにわたる平均X期待値を計算します。つまり、次のことに関心があります:
ここで、は右から番目の位置にX演算子があることを表し、は系全体の状態です。
この回路には意図的な遅延が含まれており、ベンチマークとしてはやや作為的です。しかし、実際の回路の一部の実行中に量子ビットがアイドル状態になることは非常によくあります。これは、計算の一部で一部の量子ビットがアイドル状態のままとなる、より複雑な回路の簡略化モデルと考えることができます。状態の時間発展に基づくこの種のベンチマークは、しばしば_ラムゼー・ベンチマーキング_と呼ばれます。
まず、必要なパッケージを読み込み、サービスを設定します。
# Added by doQumentation — required packages for this notebook
!pip install -q matplotlib numpy qiskit qiskit-aer qiskit-ibm-runtime
# Load key packages

from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit_ibm_runtime import SamplerV2 as Sampler
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager
from qiskit import QuantumRegister, ClassicalRegister, QuantumCircuit
import numpy as np

# --------- Configuration ----------

service = QiskitRuntimeService()  # assumes credentials are saved
backend = service.backend("ibm_fez")  # adjust if needed
次に、いくつかのヘルパー関数を定義します。まず、長いアイドル時間についての点に取り組みたいと思います。この文脈で「長い」とは正確には何を意味するのでしょうか?アイドル時間をマイクロ秒単位で単純に報告することもできます。しかし、同じ時間間隔で何回の2量子ビットゲートを実行できたかを知ることは有用です。これにより、アイドル時間は同じ期間に実行できたであろう回路の深さをより直接的に示すものになります。最初のヘルパー関数は、バックエンド固有の2量子ビットゲートを取得し、そのゲートの実行時間を求めます。
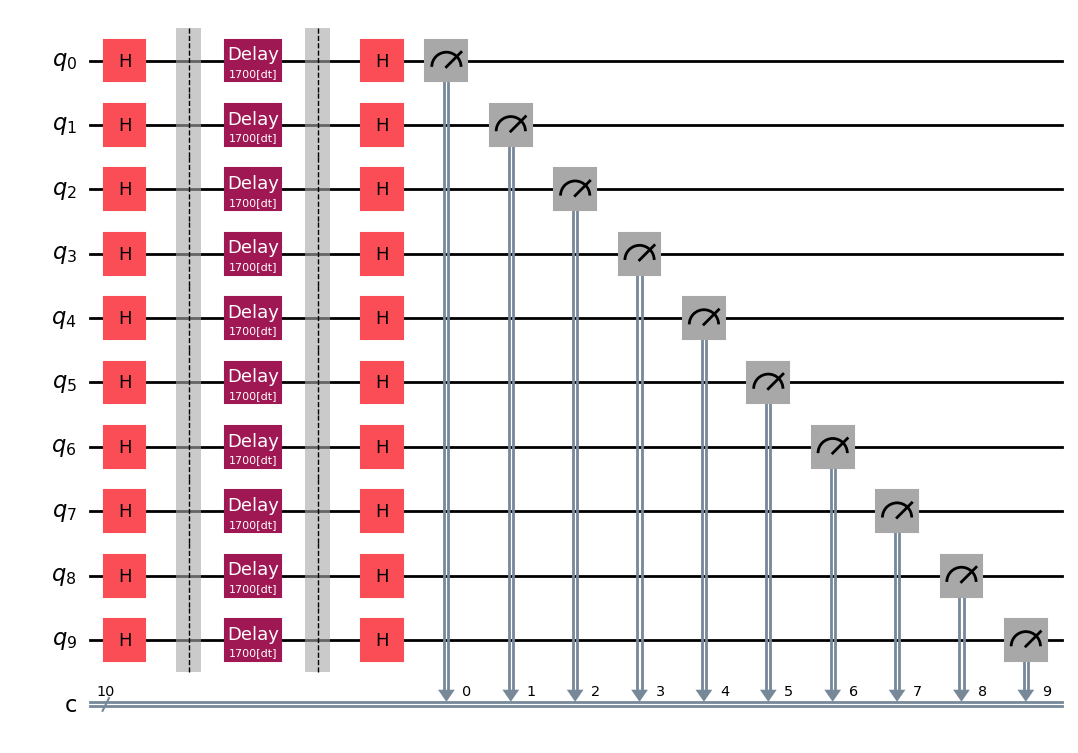
2つ目の関数は、単純にラムゼー回路(量子ビットが状態にあるもの)を作成し、遅延を実装し、Hゲートを使って回転させ、その後測定します。アダマールゲート(H)はをに写像することを思い出してください。そのため、アダマールゲートの後にZ基底でを測定することは、アダマールゲートの直前に量子ビットが状態にあったことに対応します。
最後の関数は、0と1の測定結果の生のカウントをXの期待値に変換します。
from typing import Tuple
from qiskit.providers import Backend
from numpy.typing import NDArray

# --------- Utilities ----------
def detect_twoq_gate_and_duration(
    backend: Backend, pair: tuple[int, int] = (0, 1)
) -> Tuple[str, float]:
    props = backend.properties()
    candidates = ["cx", "ecr", "cz"]
    for name in candidates:
        try:
            dur = props.gate_length(name, list(pair))
            if dur is not None:
                return name, dur
        except Exception:
            pass
    raise RuntimeError(
        "Could not find a two-qubit gate duration among cx/ecr/cz on this backend."
    )

def make_multiqubit_ramsey_circuit(n: int, delay_dt_ticks: int) -> QuantumCircuit:
    q = QuantumRegister(n, "q")
    c = ClassicalRegister(n, "c")
    qc = QuantumCircuit(q, c)

    qc.h(q)
    qc.barrier()

    for i in range(n):
        qc.delay(delay_dt_ticks, q[i], unit="dt")
    qc.barrier()

    qc.h(q)
    qc.measure(q, c)
    return qc

def counts_to_x_expectations(counts: dict[str, int], n: int) -> NDArray[np.float64]:
    total = sum(counts.values())
    if total == 0:
        return np.zeros(n)

    p0 = np.zeros(n, dtype=float)
    for bitstring, cnt in counts.items():
        bits_rev = bitstring[::-1]
        for i in range(n):
            if bits_rev[i] == "0":
                p0[i] += cnt
    p0 /= total
    return 2.0 * p0 - 1.0
次に、量子ビット数やDDで使用するゲートシーケンス(この場合XX)など、テストの詳細を指定します。特に、最適化レベルをゼロに設定していることに注意してください。実際には、より高い最適化レベルを選択することが多いですが、ここではDDが対象とするエラーの効果を可視化し続けるためにレベル0を使用します。最後に、このバックエンドにおける2量子ビットゲートの特性時間を求め、関連する時間をいくつか出力します。
n_qubits = 10  # number of qubits to test in parallel
shots = 4096
opt_level = 0  # we want to ignore optimization for now
num_steps = 6  # number of delay points
gates_per_step = 20  # "equivalent 2q gates" per step
dd_sequence = "XX"  # "XX" for your request; you might try "XY4" too

# --------- Derive timing: dt and 2q gate time ----------
dt = backend.dt  # seconds per dt
twoq_name, t2q = detect_twoq_gate_and_duration(backend, (0, 1))  # seconds
delay_unit_dt = int(round(t2q / dt))  # dt ticks equivalent to one 2q gate

print(f"Backend: {backend.name}")
print(f"dt = {dt*1e9:.3f} ns per tick")
print(f"Using 2q gate '{twoq_name}' with duration ~ {t2q*1e9:.1f} ns")
print(f"One 2q gate ≈ {delay_unit_dt} dt ticks")
Backend: ibm_fez
dt = 4.000 ns per tick
Using 2q gate 'cz' with duration ~ 68.0 ns
One 2q gate ≈ 17 dt ticks
ここで回路を構築し、選択したバックエンド用にトランスパイルします。
# --------- Build circuits for a sweep of delays ----------
pm = generate_preset_pass_manager(optimization_level=opt_level, backend=backend)

equiv_gates_list = [
    j * gates_per_step for j in range(num_steps)
]  # e.g., 0, 100, 200, ...
delay_dt_list = [int(round(delay_unit_dt * m)) for m in equiv_gates_list]
delay_us_list = [(dt * d) * 1e6 for d in delay_dt_list]  # for printing/plotting

circuits = []
for delay_dt in delay_dt_list:
    qc = make_multiqubit_ramsey_circuit(n_qubits, delay_dt)
    qc_isa = pm.run(qc)  # ISA-level scheduling/placement; DD is handled at runtime
    circuits.append(qc_isa)

print("Delay sweep (approx microseconds):", [f"{t:.2f}" for t in delay_us_list])
Delay sweep (approx microseconds): ['0.00', '1.36', '2.72', '4.08', '5.44', '6.80']
少なくとも1つの回路を可視化して、目的の状態と遅延で回路をコーディングできていることを確認する必要があります。トランスパイル前の回路qcを可視化する方が簡単かもしれませんし、トランスパイル後のqc_isaを確認してもよいでしょう。
qc.draw("mpl")
実行
いよいよハードウェア上で実行する準備が整いました。Samplerを使用して各量子ビットの測定を多数回取得し、2回使用します。1回はDDを明示的にオフにした場合、もう1回はDDをオンにしてXXゲートシーケンスを使用した場合です。
# --------- Run: NO DD ----------
sampler = Sampler(mode=backend)
sampler.options.default_shots = shots
sampler.options.dynamical_decoupling.enable = False

job = sampler.run(circuits)
res_nodd = job.result()
job_id = job.job_id()  # job id for dd off/false
print("job number for no dd is ", job_id)

# --------- Run: WITH DD (XX) ----------
sampler = Sampler(mode=backend)
sampler.options.default_shots = shots
sampler.options.dynamical_decoupling.enable = True
sampler.options.dynamical_decoupling.sequence_type = (
    dd_sequence  # "XX" first; you can try "XY4" too
)
sampler.options.dynamical_decoupling.scheduling_method = "alap"
sampler.options.dynamical_decoupling.extra_slack_distribution = "middle"

job = sampler.run(circuits)
res_dd = job.result()
job_id = job.job_id()  # job id for dd on/XX
print("job number for dd using XX is ", job_id)
さまざまな回路からカウントを抽出できます。
# --------- Extract counts per circuit ----------

from typing import Iterable, Any

def extract_counts_list(res: Iterable[Any]) -> list[dict[str, int]]:
    counts_list: list[dict[str, int]] = []

    for r in res:  # each r corresponds to one circuit
        counts: dict[str, int] = r.data.c.get_counts()
        counts_list.append(counts)

    return counts_list

counts_list_nodd = extract_counts_list(res_nodd)
counts_list_dd = extract_counts_list(res_dd)
後処理
測定からのカウントは得られましたが、これをXの期待値に変換し、使用したすべての量子ビットにわたってそれらの期待値を平均することで、位相情報がどの程度保持されているかを調べたいと思います。そのために、先ほど定義したcounts_to_x_expectations関数を使用します。
# --------- Compute X-expectations and a scalar contrast ----------
# For each circuit (each delay), compute per-qubit <X> and average absolute contrast.

xexp_nodd = []
xexp_dd = []
contrast_nodd = []
contrast_dd = []

for counts in counts_list_nodd:
    x_vec = counts_to_x_expectations(counts, n_qubits)
    xexp_nodd.append(x_vec)
    contrast_nodd.append(float(np.mean(np.abs(x_vec))))  # average |<X>| across qubits

for counts in counts_list_dd:
    x_vec = counts_to_x_expectations(counts, n_qubits)
    xexp_dd.append(x_vec)
    contrast_dd.append(float(np.mean(np.abs(x_vec))))

# --------- Print a small summary ----------
print("\n=== Summary (average |<X>| per delay) ===")
for m, d_us, c0, c1 in zip(equiv_gates_list, delay_us_list, contrast_nodd, contrast_dd):
    print(
        f"Delay ~ {m:4d} * {twoq_name}  (~{d_us:7.2f} µs):  NoDD={c0: .3f},  DD({dd_sequence})={c1: .3f}"
    )

# Optionally, inspect per-qubit values for the last delay point
print("\nPer-qubit <X> (abs) at the longest delay:")
print("NoDD:", np.round(np.abs(xexp_nodd[-1]), 3))
print("DD  :", np.round(np.abs(xexp_dd[-1]), 3))
=== Summary (average |<X>| per delay) ===
Delay ~    0 * cz  (~   0.00 µs):  NoDD= 0.954,  DD(XX)= 0.961
Delay ~   20 * cz  (~   1.36 µs):  NoDD= 0.827,  DD(XX)= 0.927
Delay ~   40 * cz  (~   2.72 µs):  NoDD= 0.793,  DD(XX)= 0.900
Delay ~   60 * cz  (~   4.08 µs):  NoDD= 0.729,  DD(XX)= 0.876
Delay ~   80 * cz  (~   5.44 µs):  NoDD= 0.661,  DD(XX)= 0.854
Delay ~  100 * cz  (~   6.80 µs):  NoDD= 0.586,  DD(XX)= 0.826

Per-qubit <X> (abs) at the longest delay:
NoDD: [0.05  0.744 0.712 0.867 0.844 0.234 0.473 0.755 0.59  0.587]
DD  : [0.583 0.89  0.921 0.88  0.908 0.832 0.893 0.773 0.807 0.773]
最後に、結果をプロットしましょう。
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values with no DD
ax.scatter(
    equiv_gates_list, contrast_nodd, c="blue", linestyle="-", label="No DD", alpha=0.7
)

## Add values with DD
ax.scatter(
    equiv_gates_list, contrast_dd, c="red", linestyle="-", label="With DD", alpha=0.7
)

# Add labels and plot
ax.set_xlabel("Idle Time in # of 2-qubit gates")
ax.set_ylabel("<X>")
ax.legend()
ax.set_title("Dephasing and DD")
ax.grid(True)

plt.show()
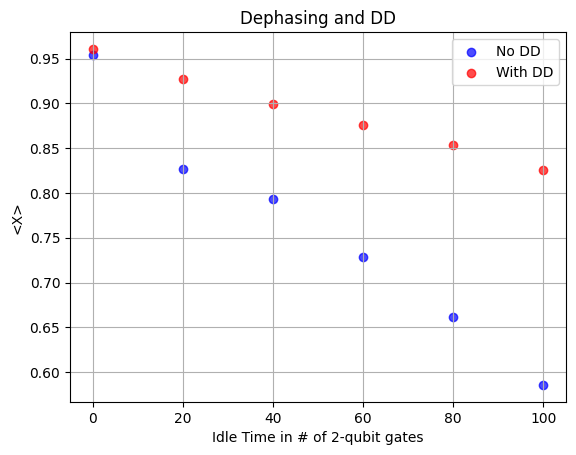
ご覧のとおり、明示的な遅延がない場合、期待値は確かに1に近く、これはすべての位相情報が保持されている場合に期待される結果です。すべての位相情報が失われていれば、最後の回転がではなくを生成することに偏りはなくなり、平均期待値はゼロに近づくでしょう。データを見ると、遅延時間が長くなるにつれてXの平均期待値が減少し、ゼロに近づき始めていることがわかります。ここでDDが非常に効果的であったことに注目してください。DDありの期待値は、DDなしの値よりも通常20%以上良く(1に近く)なっています。ただし、最初の遅延データ点は、おおよそ100回の2量子ビットゲート操作に相当する遅延であることにも注目してください。これは、DDが量子ビットが比較的長期間アイドル状態にある場合に最も有用であるという点を裏付けています。
理解度を確認しましょう
以前と同じ回路にXY4を使ってDDを適用した場合、XXを使ったDDと比べて、はるかに良い結果、はるかに悪い結果、それともほぼ同じ結果になると予想しますか?説明してください。
回答
ほぼ同じ、あるいはやや悪くなるでしょう。使用した回路は、状態をXY平面に回転させたものでした。この状態は情報を主に位相に保持しているため、T1緩和よりもデフェージングエラーに特に敏感です。XY4はより幅広い種類のエラーに対して役立つかもしれませんが、XXは今使っている回路に対してすでに最適化されています。XY4も同程度に良い結果をもたらすかもしれませんが、実質的な向上はもたらさないでしょう。あるいは、XY4がより多くのゲートを含むという事実により、追加のゲートエラーが生じて結果がわずかに悪化するかもしれません。
最後の結果では、最も単純なDDゲートシーケンスXXを使用しました。より複雑なシーケンスXY4を実装する方法を見てみましょう。次のセクションでSamplerを定義します。
# --------- Run: WITH DD (XY4) ----------
dd_sequence = "XY4"

sampler = Sampler(mode=backend)
sampler.options.default_shots = shots
sampler.options.dynamical_decoupling.enable = True
sampler.options.dynamical_decoupling.sequence_type = dd_sequence
sampler.options.dynamical_decoupling.scheduling_method = "alap"
sampler.options.dynamical_decoupling.extra_slack_distribution = "middle"

job = sampler.run(circuits)
res_xy4 = job.result()
job_id = job.job_id()  # job id for dd on/XY4
print("job number for dd using Xy4 is ", job_id)
job number for dd using Xy4 is d6k6ti860irc7395d3hg
# --------- Extract counts per circuit ----------

counts_list_xy4 = extract_counts_list(res_xy4)
# --------- Compute X-expectations and a scalar contrast ----------
# For each circuit (each delay), compute per-qubit <X> and average absolute contrast.
xexp_xy4 = []
contrast_xy4 = []

for counts in counts_list_xy4:
    x_vec = counts_to_x_expectations(counts, n_qubits)
    xexp_xy4.append(x_vec)
    contrast_xy4.append(float(np.mean(np.abs(x_vec))))  # average |<X>| across qubits

# --------- Print a small summary ----------
print("\n=== Summary (average |<X>| per delay) ===")
for m, d_us, c0, c1, c2 in zip(
    equiv_gates_list, delay_us_list, contrast_nodd, contrast_dd, contrast_xy4
):
    print(
        f"Delay ~ {m:4d} * {twoq_name}  (~{d_us:7.2f} µs):  NoDD={c0: .3f},  DD({dd_sequence})={c1: .3f}"
    )

# Optionally, inspect per-qubit values for the last delay point
print("\nPer-qubit <X> (abs) at the longest delay:")
print("NoDD:", np.round(np.abs(xexp_nodd[-1]), 3))
print("DD XX :", np.round(np.abs(xexp_dd[-1]), 3))
print("DD XY4 :", np.round(np.abs(xexp_xy4[-1]), 3))
=== Summary (average |<X>| per delay) ===
Delay ~    0 * cz  (~   0.00 µs):  NoDD= 0.968,  DD(XY4)= 0.968
Delay ~  100 * cz  (~   6.80 µs):  NoDD= 0.612,  DD(XY4)= 0.839
Delay ~  200 * cz  (~  13.60 µs):  NoDD= 0.462,  DD(XY4)= 0.705
Delay ~  300 * cz  (~  20.40 µs):  NoDD= 0.339,  DD(XY4)= 0.580
Delay ~  400 * cz  (~  27.20 µs):  NoDD= 0.225,  DD(XY4)= 0.481
Delay ~  500 * cz  (~  34.00 µs):  NoDD= 0.204,  DD(XY4)= 0.393

Per-qubit <X> (abs) at the longest delay:
NoDD: [0.002 0.208 0.447 0.034 0.286 0.306 0.322 0.044 0.163 0.232]
DD XX : [0.433 0.669 0.526 0.516 0.572 0.284 0.303 0.055 0.365 0.208]
DD XY4 : [0.38  0.662 0.521 0.538 0.621 0.252 0.353 0.038 0.239 0.073]
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values with no DD
ax.scatter(
    equiv_gates_list, contrast_nodd, c="blue", linestyle="-", label="No DD", alpha=0.7
)

## Add values with DD using XX sequence
ax.scatter(
    equiv_gates_list, contrast_dd, c="red", linestyle="-", label="With XX", alpha=0.7
)

## Add values with DD using XY4 sequence
ax.scatter(
    equiv_gates_list,
    contrast_xy4,
    c="black",
    linestyle="-",
    label="With XY4",
    alpha=0.7,
)

# Add labels and plot
ax.set_xlabel("Idle Time in # of 2-qubit gates")
ax.set_ylabel("<X>_av")
ax.legend()
ax.set_title("Dephasing and DD")
ax.grid(True)

plt.show()
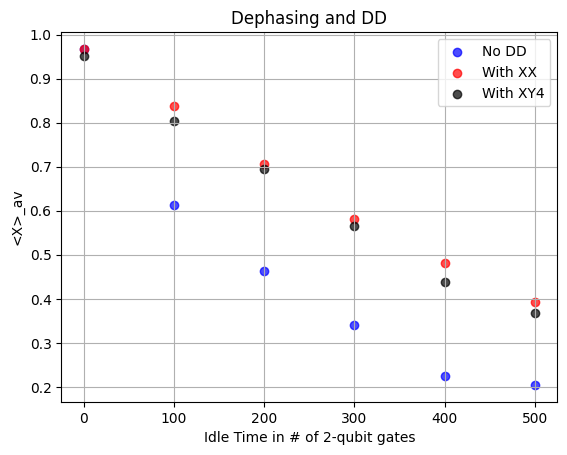
ここでは、XY4がXXと比べて顕著な違いがないことがわかります。XY4シーケンスに含まれる追加のゲートのため、わずかに悪くなる可能性はありますが、より重要なのは、XXがのような状態に対して位相を保持する望ましい効果を持つ理由をすでに説明したことです。このような初期状態に対して、別のシーケンスが結果を改善すると考える理由はありません。
理解度を確認しましょう
XY4シーケンスが、大域的位相を除いて状態を変化させないことを確認してください。
回答
パウリ・ツワリング
まず、パウリ・ツワリングはしばしばエラー抑制手法としてではなく、エラー整形手法として使用されることに注意すべきです。すなわち、ノイズやエラーの振る舞いを変化させ、時にはより予測可能にすることで、他の手法を可能にします。パウリ・ツワリングはエラーを防止するわけではありませんが、それらのコヒーレントな蓄積を防ぐ可能性があります。
量子回路では、複数の異なるエラー源が足し合わされます。エラーはさまざまな方法で加算されますが、特に_コヒーレントに_と_インコヒーレントに_加算される場合があります。エラーのコヒーレントな蓄積とは、ノイズや不完全な実装が、複数の層やゲートにわたって常に同じ方向にエラーを引き起こす傾向があることを意味します。例としては、回転ゲートを適用する際のコヒーレントな過回転が挙げられます。
X軸周りにちょうど回転する、のような理想的な回転ゲートを考えてみましょう。もちろん、ゲートの実装は完璧ではなく、ある実装では実際の回転はになるかもしれません。さらに、は常に同じ符号であり、を多数回適用しても大きさがほぼ同じである場合すらあり得ます。そのため、回転ゲートを繰り返し適用すると、これら多数の過回転(または過小回転)がコヒーレントに蓄積する結果になり得ます。
インコヒーレントなエラーの蓄積はちょうどその逆です。すなわち、ランダムな方向とランダムな符号を持つエラーであり、異なる層のエラーは常に加算的に干渉するわけではなく、時には打ち消し合ったり二乗和的に加算されたりします。明らかに、インコヒーレントなエラーは量子ビットの状態への全体的な影響という点で、より緩やかに蓄積します。この模式図を以下の図に示します。これは単純化したものです。実際の量子エラーは2次元のデカルト空間に限定されず、すべてのエラー寄与が同じ大きさを持つわけでもなく、さらに複雑さがあります。しかし、このような図の直感は有用です。コヒーレントなエラーはインコヒーレントなエラーよりも速く蓄積する傾向があります。
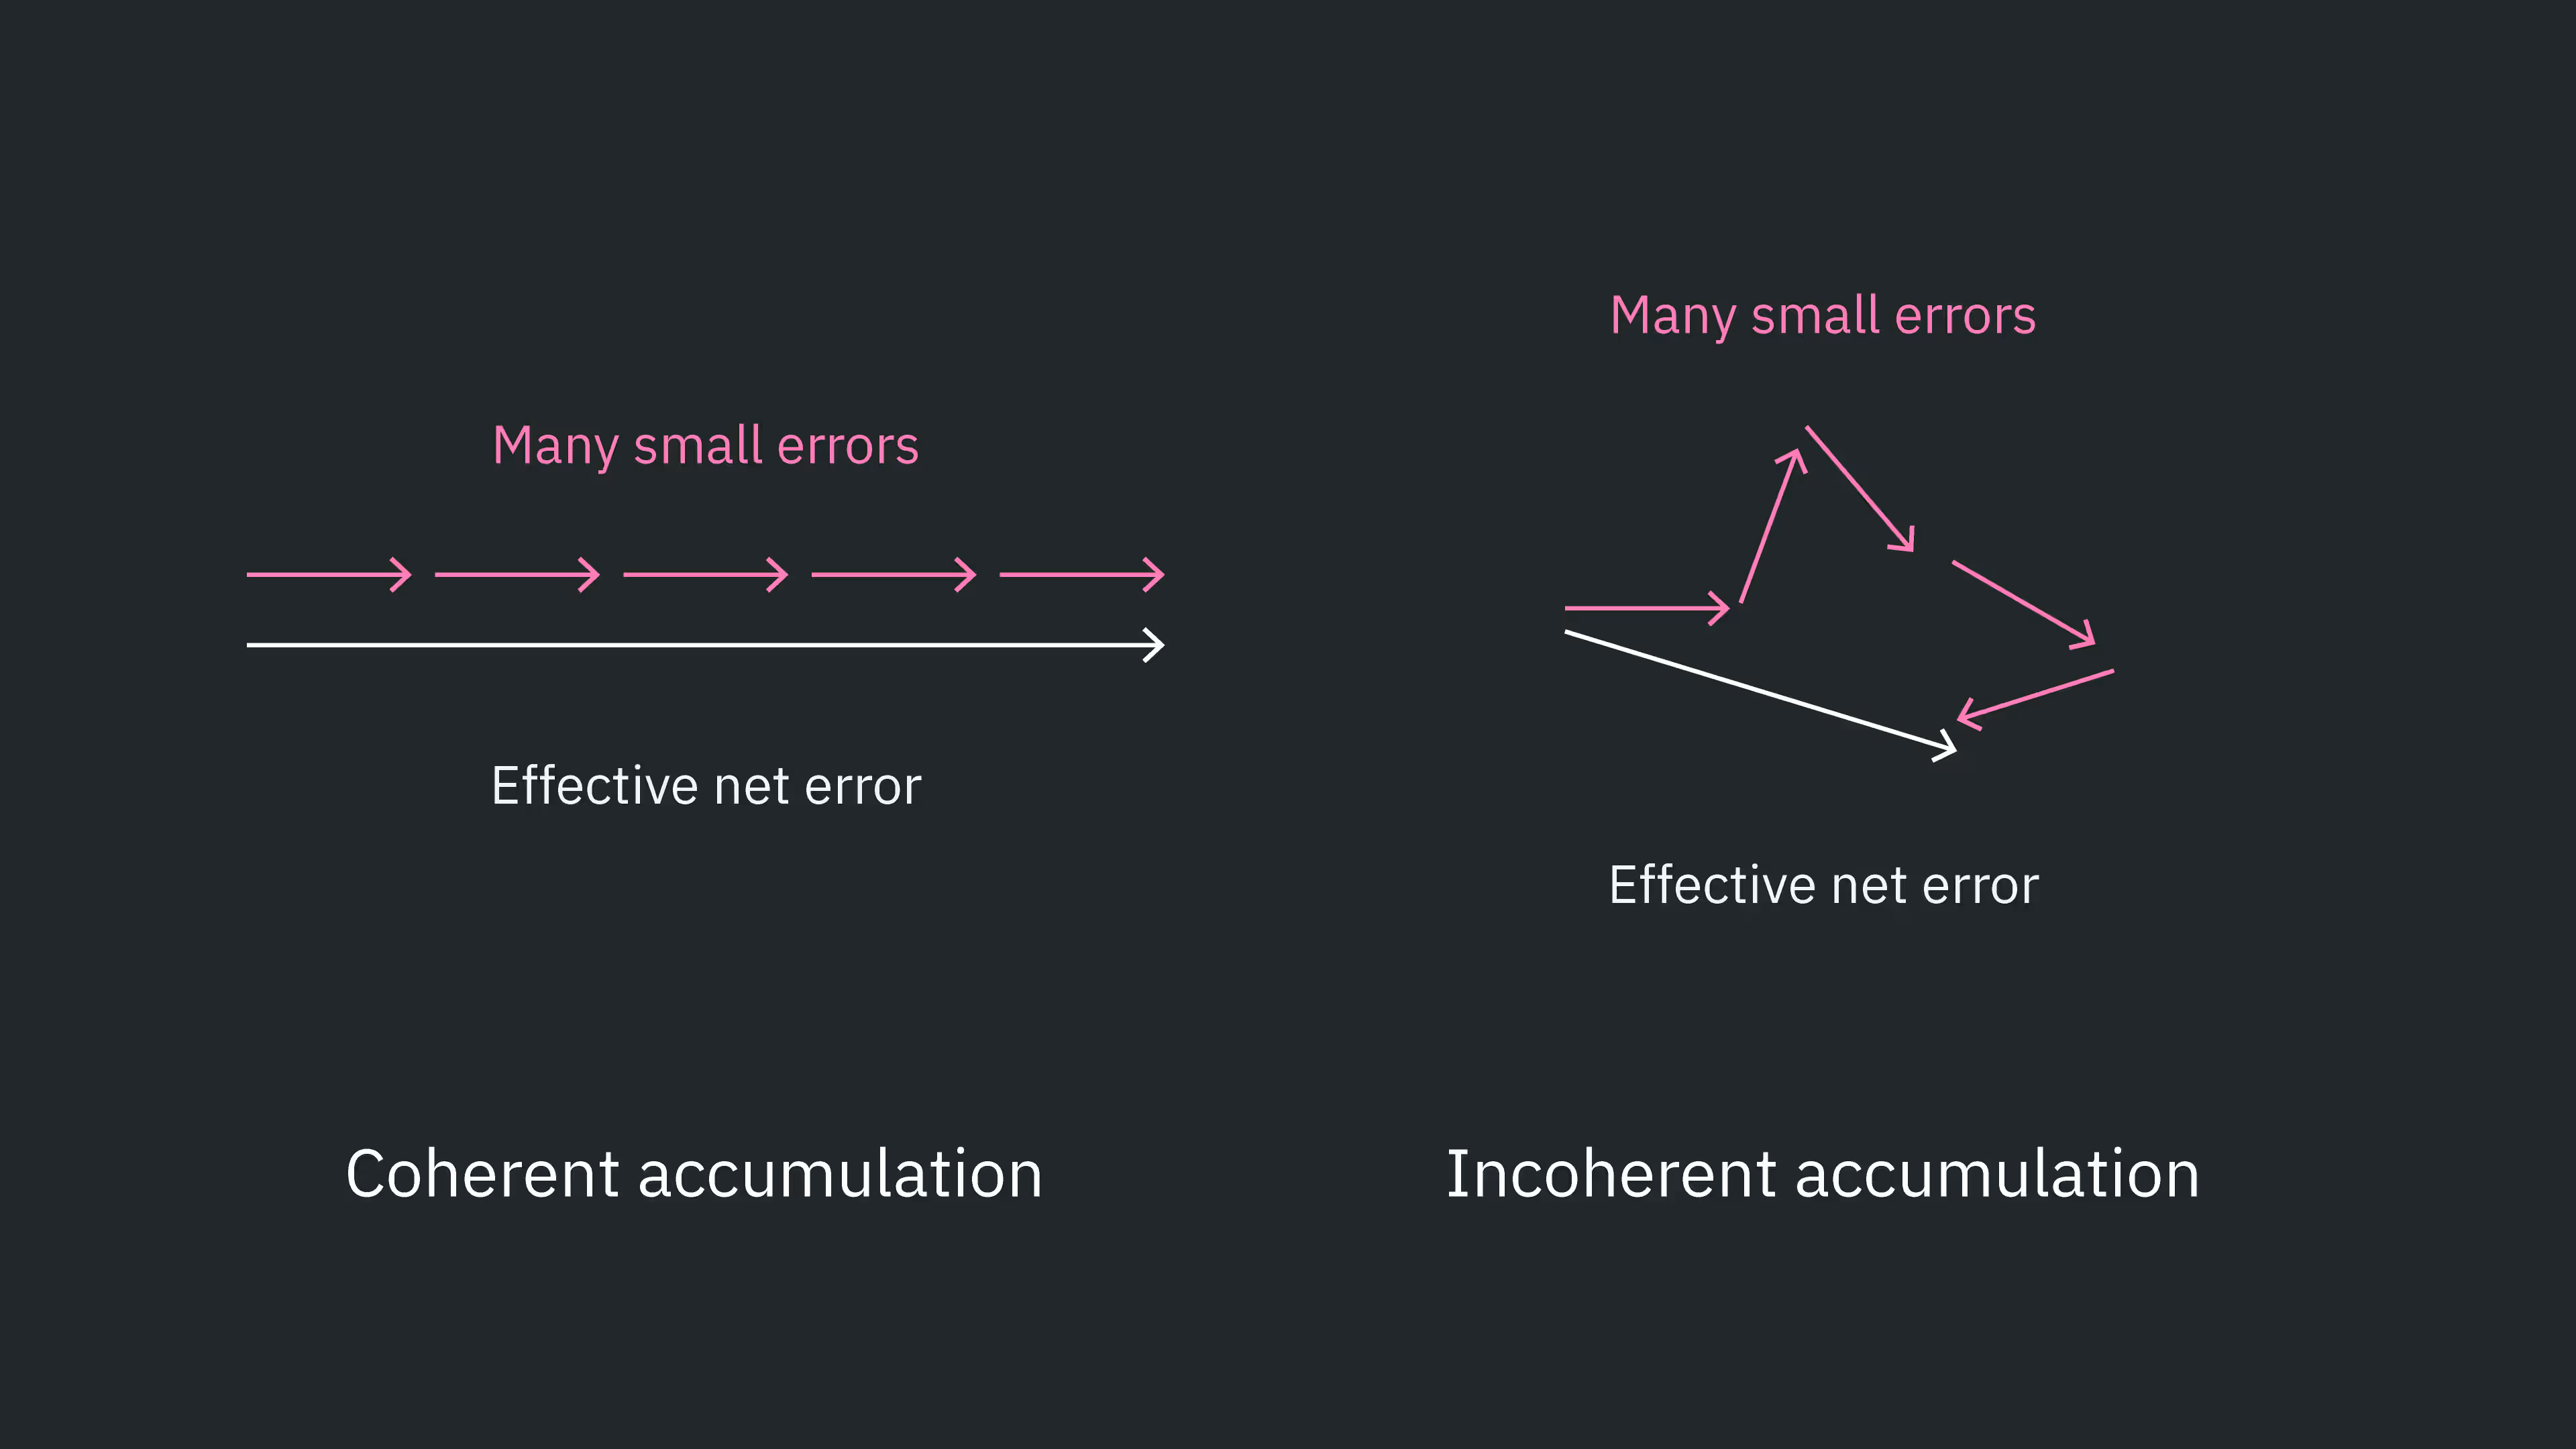
コヒーレントなエラーの蓄積をインコヒーレントなエラーの蓄積に変えることで、しばしばより高い忠実度の結果を得ることができます。これを実現する主要な方法は__パウリ・ツワリング__と呼ばれます。
パウリ・ツワリングとは、目的のゲート操作の前後に、となるようにパウリゲートの組み合わせを追加することを指します。ここで、とは単一のパウリゲートではなく、しばしば複数の量子ビットに作用するパウリ演算子の集まりです。追加のパウリゲートの作用は「恒等演算子に等価」であると表現されることがありますが、これは不正確であり、誤解を招く可能性があります。パウリゲートはによって隔てられており、目標はすべてのゲートの論理的な作用をに等しく保つことです。は、抑制のために追加されたゲートと区別するために「ペイロード」と呼ばれることがあります。CNOTゲートを対象としたパウリ・ツワリングの例をいくつか以下に示します。

ツワリングがペイロードの論理的な効果を変えないことを確認するために、1つの例だけを順を追って見てみましょう。 一般性を失うことなく、とを含む2量子ビットの状態を次のように定義します:
いつものように、量子ビットの順序規則を使用しています。をターゲットとしてCXゲートを適用すると、次が得られます
ここで、パウリ・ツワリングにXゲートを使用した3番目の回路を考えてみましょう。単純に行列を掛け合わせて、それらがCNOT行列を生成することを確認することもできます。あるいは、以下で行うように、回路を通した任意の量子状態に対する操作を追跡することもできます。回路内の異なる時点における状態には、a〜dというラベルが付けられています。

これは、ツワリングなしで以前に得たとまさに一致します。実際、このツワリングされたゲートシーケンスは、ペイロードの論理的な作用を変えません。しかし、層ごとに異なる有効なツワリングシーケンスがランダムに選択される場合、コヒーレントなエラーの蓄積は実質的に確率的な(インコヒーレントな)エラーの蓄積に変換され得ます。明確にしておくと、単一のツワリングパターンを選んで回路全体で使用するわけではありません。代わりに、層ごとに異なる有効なツワリングシーケンスが選択されます。多数のエンタングリング層を持つ例は、次のようになるでしょう。
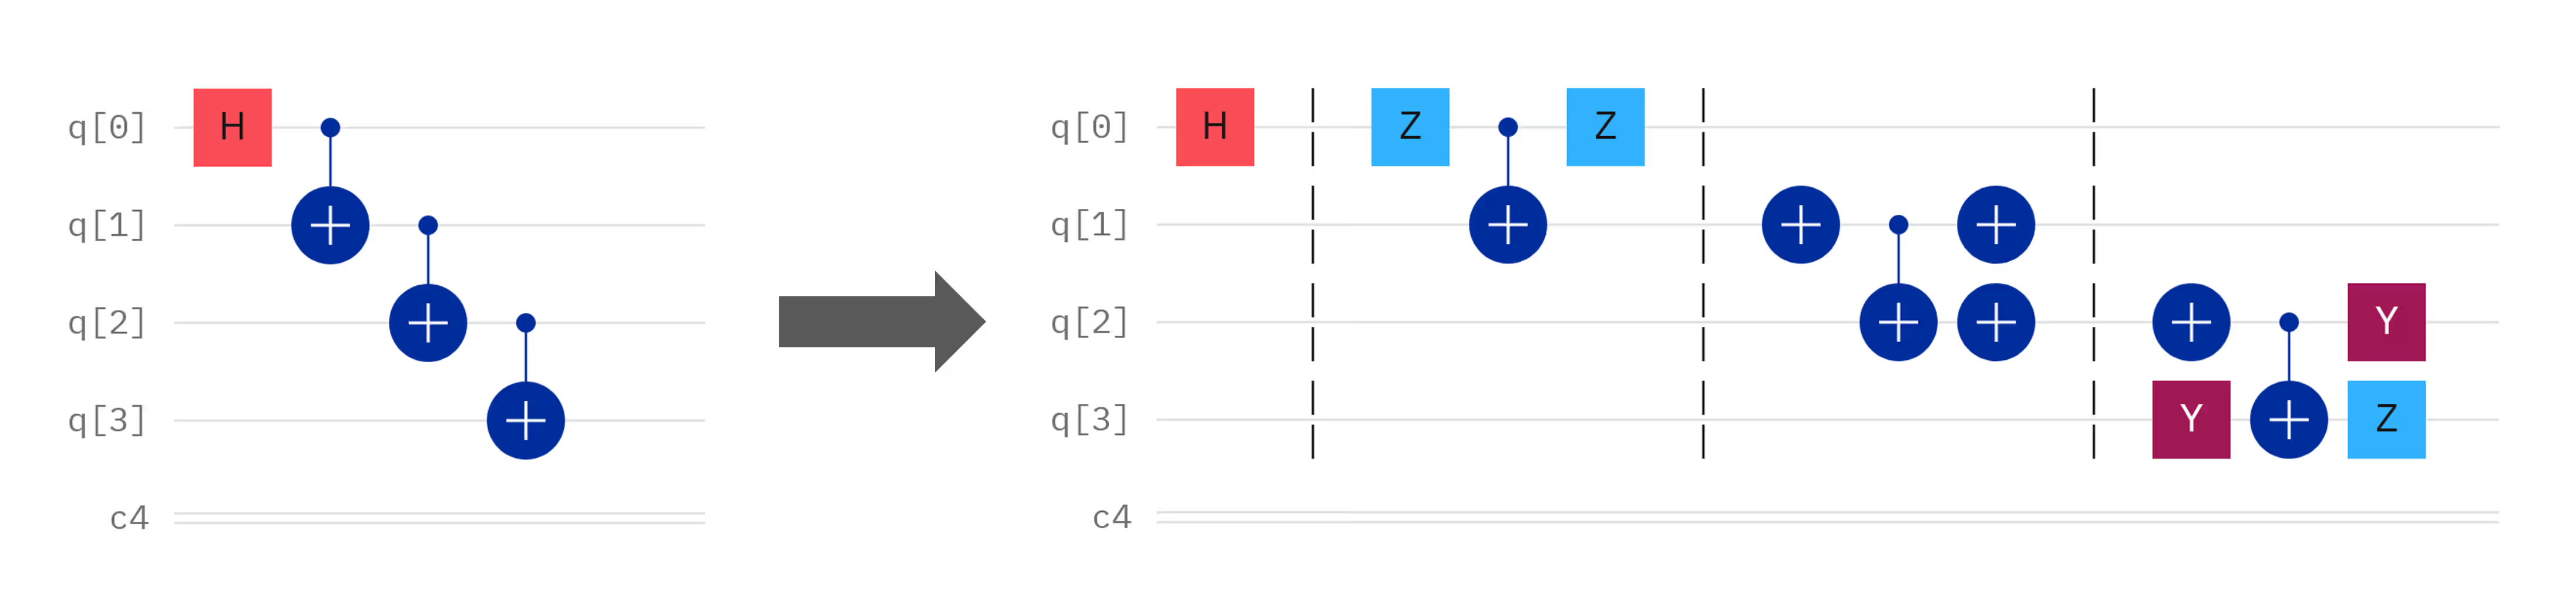
理解度を確認しましょう
上図の4番目のパネルにあるパウリ・ツワリングも、CNOTの論理的な効果を変えないことを確認してください。
回答
上記の例に従い、任意の2量子ビット状態に対する作用がCNOT操作と等価であることを示します。この図中のラベル付けされた点を参照します。

これは、量子ビット0を制御ビット、量子ビット1をターゲットとするCNOTの作用と等価です。
上記に示されていない、CNOTゲート用のパウリ・ツワリングシーケンスを考え出すことができますか?
回答
はい、他にも多くあります。一例として、CNOTの前にを、CNOTの後にとを適用するものがあります。
パウリ・ツワリングをいつ使うか
ここで示したように、パウリ・ツワリングは多量子ビットゲートにのみ適用されます。同様のプロトコルを単一量子ビットゲートに適用するには異なるロジックが必要であり、実際にはあまり有用ではありません。パウリ・ツワリング自体、いくつかの単一量子ビットゲート(パウリゲート)を使用します。追加のパウリゲートは、コヒーレントなエラーの蓄積をランダム化することで得られる利点よりも多くのエラーをもたらす可能性が高いでしょう。2量子ビットゲートに関連するエラー率は、単一量子ビットゲートに関連するエラー率よりもはるかに大きいです。さらに、一部の単一量子ビットゲートは非クリフォードであり、完全にはツワリングできません。これが、Qiskitが単一量子ビットゲートではなく2量子ビットゲートを自動的にツワリングするパウリ・ツワリングオプションを含んでいる理由です。
これは上図に暗に示されていました。パウリ・ツワリングはCXゲートの周りには実装されましたが、アダマールゲートの周りには実装されませんでした。
パウリ・ツワリングが実際に使われている2つの例を見てみましょう。
コヒーレントな蓄積を抑制するパウリ・ツワリング
パウリ・ツワリングがどのようにコヒーレントなエラーの蓄積をより緩やかなインコヒーレントな蓄積に変えるかを観察するために、コヒーレントエラーのストレステストとして機能する回路と観測量が必要です。唯一の目的は、コヒーレントに蓄積する2量子ビットエラーを可視化し、その上でパウリ・ツワリングがそのコヒーレントな蓄積を確率的な減衰に変換する様子を示すことです。
CNOT(またはCZ)ゲートは、コヒーレントなエラーの一般的な原因です。この場合に行える最も単純な実験は、状態(例えば)を初期化し、対になったCNOTゲートの層を適用し(2つのCNOTが恒等演算子になるという事実を利用)、層の数が増えるにつれてエラーがどのように蓄積するかを、パウリ・ツワリングありとなしの両方で確認することです。
関心のある観測量は、単一量子ビットにおけるであり、これをCNOTペアの繰り返し回数の関数としてプロットします。
# --- Imports ---

import numpy as np
from qiskit import QuantumCircuit
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit_ibm_runtime import SamplerV2 as Sampler
# Build the circuit with CX/CX identity per layer

def identity_cx_pairs(layers: int) -> QuantumCircuit:
    q = QuantumRegister(2, "q")
    c = ClassicalRegister(1, "c")  # we only measure q0
    qc = QuantumCircuit(q, c, name=f"N={layers}")

    # |+> on q0
    qc.h(q[0])

    for _ in range(layers):
        qc.barrier()
        qc.cx(q[0], q[1])
        qc.cx(q[0], q[1])

    # Measure in X basis: H then measure q0

    qc.h(q[0])
    qc.measure(q[0], c[0])

    return qc
測定前に基底を回転させているため、の測定は、最後のアダマールゲートの直前に状態がであったことに対応し、とについても同様です。したがって、期待値は、のカウントからのカウントを引くことで単純に計算できます。
# Compute <X> from SamplerV2 counts

def x_expect_from_counts(counts: dict[str, int]) -> float:
    shots = sum(counts.values())
    p0 = counts.get("0", 0) / shots
    p1 = counts.get("1", 0) / shots
    return p0 - p1  # <X> = P(0) - P(1) after H,measure
エラーを蓄積させるための適切な数のCNOT層を選択し、回路を構築してから、トランスパイルします。
# Choose the number of layers for the experiment
N_layers_list = [0, 1, 2, 3, 4, 5]

circuits = [identity_cx_pairs(n) for n in N_layers_list]

# Transpile to backend ISA so that primitives run native instructions
pm = generate_preset_pass_manager(backend=backend, optimization_level=0)
isa_circuits = [pm.run(c) for c in circuits]
各層は複数の2量子ビットゲートで構成されていることに留意してください。以下の関数を使用して、トランスパイル後の2量子ビット深度を監視します。
# We can check the 2-qubit depths of any of our circuits like this:
print(
    "two-qubit depth",
    isa_circuits[5].decompose().depth(lambda instr: len(instr.qubits) > 1),
)
two-qubit depth 15
# Configure two Samplers: (A) no twirling, (B) gate twirling
#    - No DD, no measurement twirling in both (to isolate gate twirling)
# ------------------------------
shots = 8192

# (A) No twirling
sampler_no_twirl = Sampler(mode=backend)
# Ensure no extra suppression/mitigation:
sampler_no_twirl.options.dynamical_decoupling.enable = False
# Be explicit about twirling:
sampler_no_twirl.options.twirling.enable_gates = False
sampler_no_twirl.options.twirling.enable_measure = (
    False  # TREX-style measurement twirling off
)
sampler_no_twirl.options.default_shots = shots  # default shots for this primitive

# (B) Gate twirling ON
sampler_twirl = Sampler(mode=backend)
sampler_twirl.options.dynamical_decoupling.enable = False
sampler_twirl.options.twirling.enable_gates = True  # <-- enable Pauli gate twirling
sampler_twirl.options.twirling.enable_measure = False
sampler_twirl.options.default_shots = shots

# (Optional) Inspect options dicts if you’re curious
# print(asdict(sampler_no_twirl.options))
# print(asdict(sampler_twirl.options))
次にジョブを実行します。
# Run both jobs; extract counts; compute <X>

# Helper to run a sampler and compute <X> per circuit
def run_and_x_expect(sampler: Sampler, circ_list: list[QuantumCircuit]) -> list[float]:
    job = sampler.run(
        circ_list
    )  # shots taken from options.default_shots unless overridden
    result = job.result()
    # For SamplerV2, use join_data().get_counts() to combine registers if needed
    exp_vals = []
    for pub in result:
        counts = pub.join_data().get_counts()
        exp_vals.append(x_expect_from_counts(counts))
    return exp_vals

x_no_twirl = run_and_x_expect(sampler_no_twirl, isa_circuits)
x_twirl = run_and_x_expect(sampler_twirl, isa_circuits)

# ------------------------------
# 6) Print a small table
# ------------------------------
print("\nN_layers   <X> (no twirl)   <X> (gate twirl)")
for n, a, b in zip(N_layers_list, x_no_twirl, x_twirl):
    print(f"{n:7d}   {a:14.6f}   {b:14.6f}")
N_layers   <X> (no twirl)   <X> (gate twirl)
      0         0.984375         0.987549
      1         0.934326         0.936523
      2         0.844238         0.892822
      3         0.712158         0.879395
      4         0.592529         0.844971
      5         0.449463         0.785156
最後に、これらの結果を可視化します。
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values using XX
ax.scatter(
    N_layers_list, x_no_twirl, c="blue", linestyle="-", label="No twirl", alpha=0.7
)

## Add values with XY4
ax.scatter(N_layers_list, x_twirl, c="red", linestyle="-", label="Twirled", alpha=0.7)

# Add labels and plot
ax.set_xlabel("CX layers")
ax.set_ylabel("<X>")
ax.legend()
ax.set_title("Pauli twirling")
ax.grid(True)

plt.show()
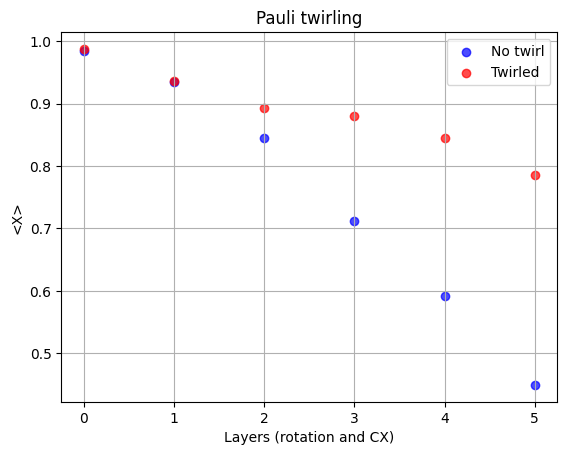
ツワリングされた回路が理想値により近い期待値をもたらすことが明確にわかります。この例はその目的を果たしましたが、より実用的な内容、すなわち高度にエンタングルした状態の生成におけるツワリングに移りましょう。
GHZ状態の準備におけるパウリ・ツワリング
前の例では、CNOTゲートに関連するエラーのコヒーレントな蓄積を破壊する上で、パウリ・ツワリングが説得力のある効果を持つことが示されました。GHZ状態の生成では、多くの量子コンピューティング応用に有用な高度にエンタングルした状態を生成するために、多数のCNOTゲートが使用されます。GHZ状態のサイズを大きくしながら、この文脈でパウリ・ツワリングがどのように役立つかを見てみましょう。
# Imports if not already loaded in previous cells
# from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager
# from qiskit import QuantumRegister, ClassicalRegister, QuantumCircuit

# Define a GHZ circuit building function, so that we can build GHZ states of increasing size.

def ghz_circuit(n: int) -> QuantumCircuit:
    q = QuantumRegister(n, "q")
    c = ClassicalRegister(n, "c")
    qc = QuantumCircuit(q, c)

    qc.h(q[0])
    for i in range(n - 1):
        qc.cx(q[i], q[i + 1])

    qc.barrier()

    qc.measure(q, c)
    return qc

# Build a test state with 10 qubits to remind ourselves of GHZ structure.

num_qubits = 10

qc_ghz = ghz_circuit(num_qubits)
qc_isa = pm.run(qc_ghz)
qc_ghz.draw("mpl")
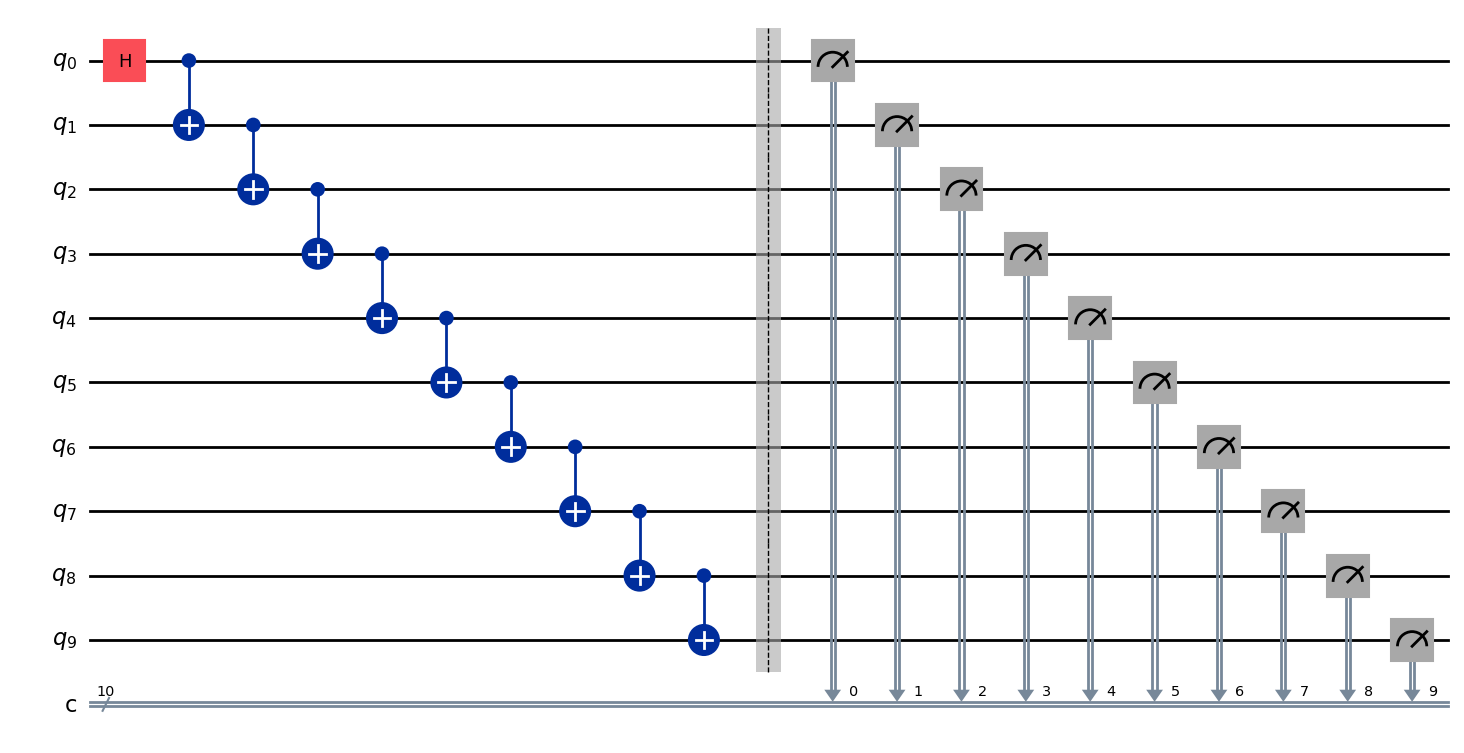
ここで回路を構築し、トランスパイルします。この場合、恒等演算子に帰着するような人為的に繰り返されたゲートはありません。そのため、パスマネージャーにもう少し最適化を任せることができます。レベル3に設定します。
# Set up a pass manager

opt_level = 3
# --------- Build circuits for a sweep of delays ----------
pm = generate_preset_pass_manager(optimization_level=opt_level, backend=backend)

# Build GHZ circuits of increasing size.

nmin = 5
nmax = 15
circuits = []
for n in range(nmin, nmax):
    qc = ghz_circuit(n)
    qc_isa = pm.run(qc)
    circuits.append(qc_isa)
オプティマイザが抽象回路を量子ビット123、124、136、142、143にマッピングしたことがわかります。
circuits[0].draw("mpl")
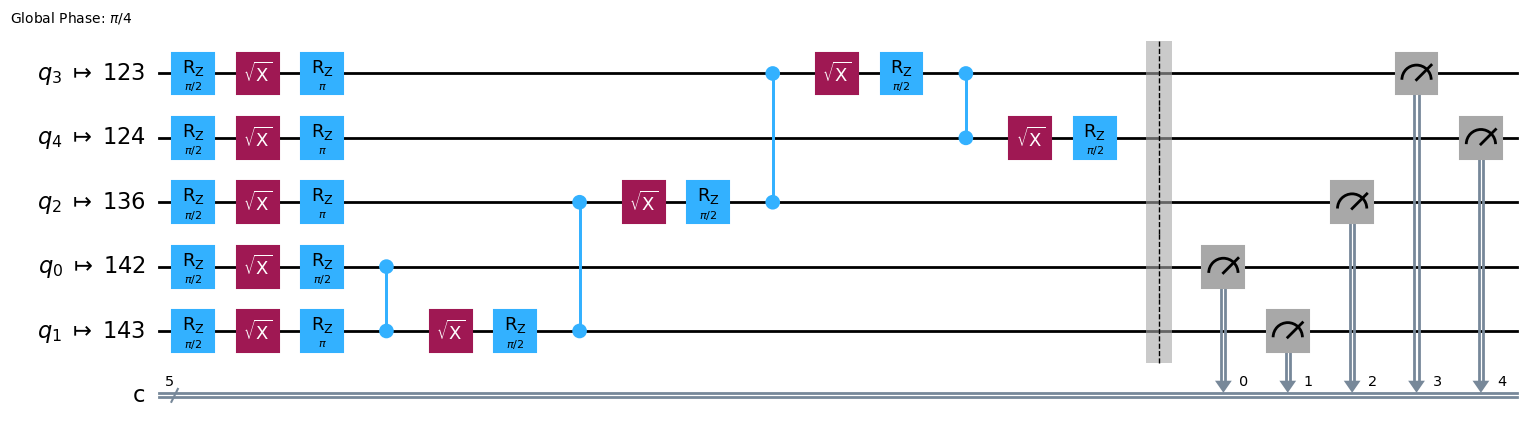
その理由を理解するために、バックエンドのレイアウト図を見てみましょう(この画像ではibm_fezですが、他のどのバックエンドでも同様の分析を行うことができます)。
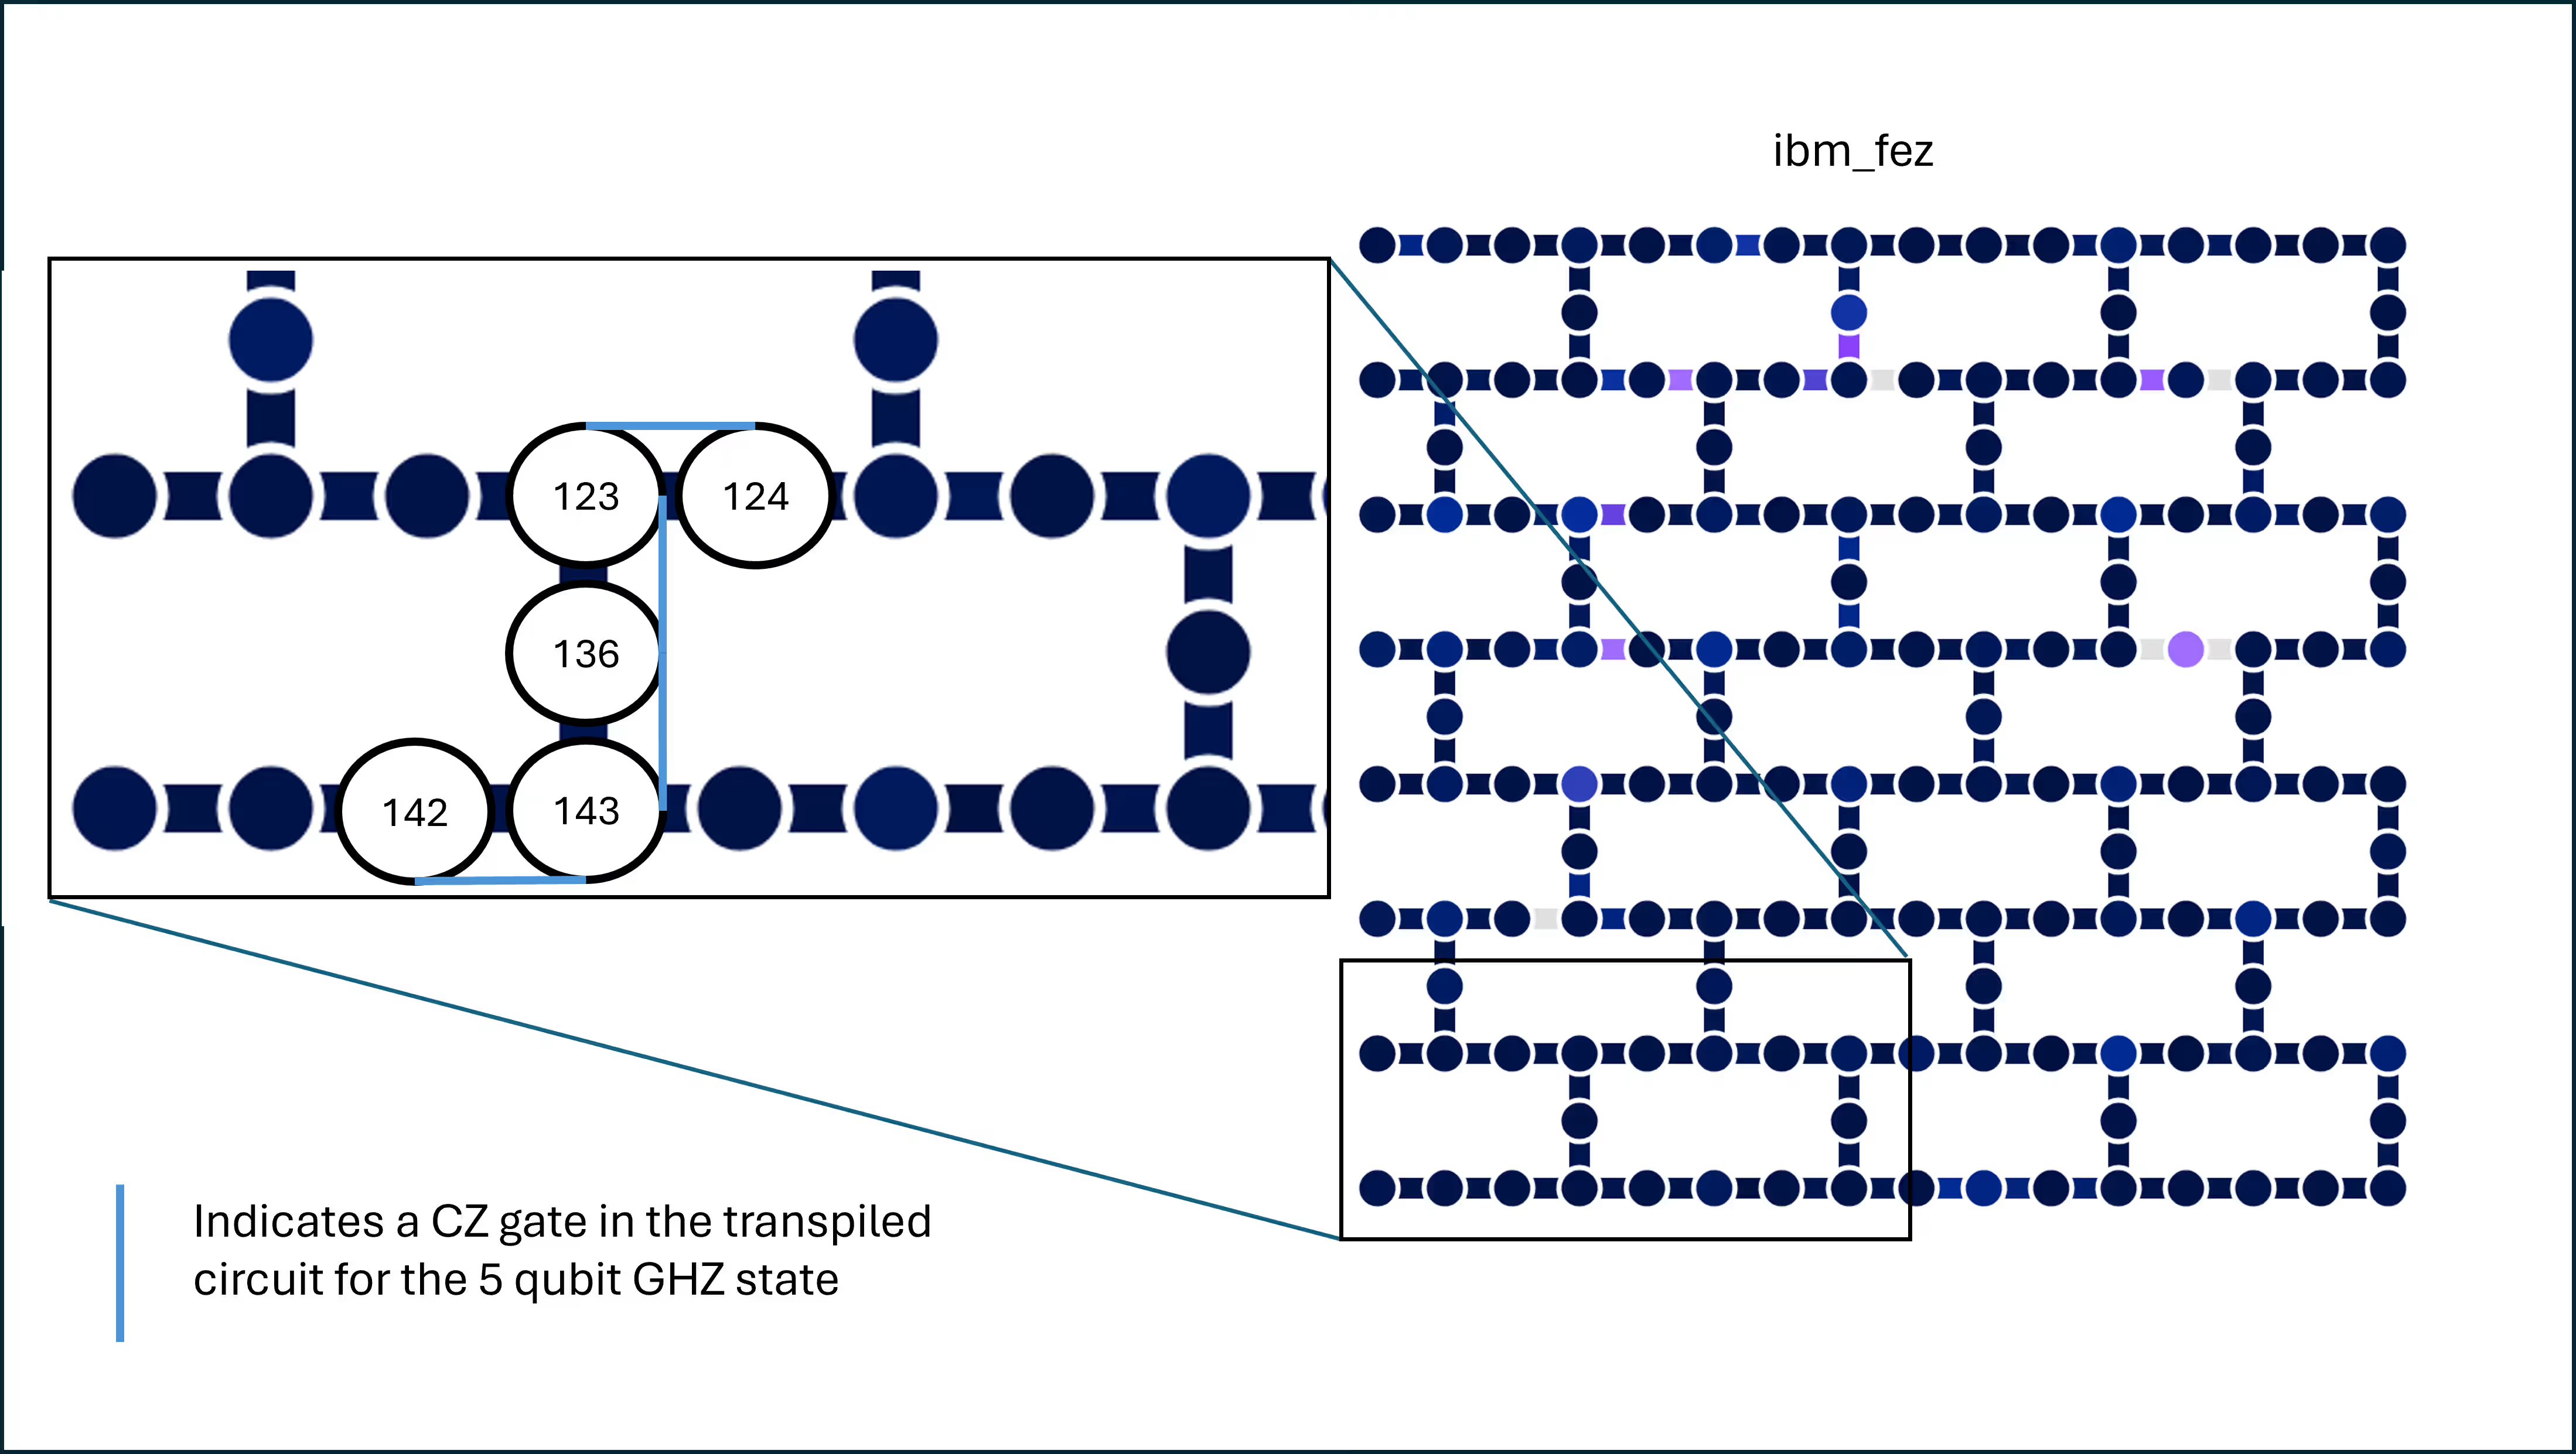
量子ビットは、スワップゲートひいては回路の深さを最小化するように、チェーン状に選択されていることがわかります。さらに、回路内で実装される各CZゲートは隣接する量子ビット間のものです。最後に、5つの量子ビットすべてが、読み出し割り当てエラー率を含め、比較的低いエラー率を持っています。これらのエラー率は、コンピューティングリソースページでどのバックエンドでも確認できます。単純な線形チェーンでこのようなレイアウトを見つけるのは難しくありませんが、問題がより複雑になるにつれて、回路レイアウトの最適化はより難しく、より価値のあるものになります。
次に、Samplerプリミティブを設定します。パウリ・ツワリングに焦点を当てるため、他の抑制/緩和ツールはオフにします。
# Configure two Samplers: (A) no twirling, (B) gate twirling
# No DD, no measurement twirling in both (to isolate gate twirling)

shots = 8192

# (A) No twirling
sampler_no_twirl = Sampler(mode=backend)
# Ensure no extra suppression/mitigation:
sampler_no_twirl.options.dynamical_decoupling.enable = False
# Be explicit about twirling:
sampler_no_twirl.options.twirling.enable_gates = False
sampler_no_twirl.options.twirling.enable_measure = (
    False  # TREX-style measurement twirling off
)
sampler_no_twirl.options.default_shots = shots  # default shots for this primitive

# (B) Gate twirling ON
sampler_twirl = Sampler(mode=backend)
sampler_twirl.options.dynamical_decoupling.enable = False
sampler_twirl.options.twirling.enable_gates = True  # <-- enable Pauli gate twirling
sampler_twirl.options.twirling.enable_measure = False
sampler_twirl.options.default_shots = shots

# (Optional) Inspect options dicts if you’re curious
# print(asdict(sampler_no_twirl.options))
# print(asdict(sampler_twirl.options))
最後に、ジョブを実行します。必要に応じて、後で取得するためにジョブID番号を出力することもできます。
job = sampler_twirl.run(circuits)
res_ghz_twirl = job.result()
job_id = job.job_id()  # job id for twirling on/true
print("job number for twirling the ghz prep is ", job_id)

job = sampler_no_twirl.run(circuits)
res_ghz_no_twirl = job.result()
job_id = job.job_id()  # job id for twirling off/false
print("job number for NO twirling the ghz prep is ", job_id)
job number for twirling the ghz prep is  d7h967bjne2c7393s0b0
job number for NO twirling the ghz prep is  d7h96f7b91ec73aufing
ツワリングありとなしの両方で、すべての回路について測定された各計算基底状態のカウントを抽出します。
# --------- Extract counts per circuit ----------
def extract_counts_list(res):
    counts_list = []
    for r in res:  # each r corresponds to one circuit
        # r.data.<classical_register_name>.get_counts()
        counts = r.data.c.get_counts()
        counts_list.append(counts)
    return counts_list

counts_list_ghz_twirl = extract_counts_list(res_ghz_twirl)
counts_list_ghz_no_twirl = extract_counts_list(res_ghz_no_twirl)
print(counts_list_ghz_twirl[0])
print(counts_list_ghz_twirl[4])
{'11111': 3440, '11101': 87, '00000': 3434, '10111': 87, '00001': 168, '10011': 4, '11000': 102, '00011': 39, '01111': 93, '00111': 111, '01000': 90, '11110': 235, '00110': 6, '00010': 75, '11011': 30, '11100': 42, '10000': 82, '00101': 7, '10001': 2, '11001': 6, '11010': 5, '01010': 3, '01110': 7, '00100': 14, '10101': 1, '10110': 8, '01001': 6, '10100': 1, '01101': 4, '01011': 1, '10010': 2}
{'111111111': 2683, '000000000': 2976, '111000000': 53, '110000000': 74, '111111100': 47, '111011111': 76, '111111110': 195, '111111000': 67, '000000010': 66, '011111110': 10, '011110001': 1, '101110111': 7, '101011111': 9, '111110111': 87, '111100000': 96, '111011000': 2, '010000000': 60, '111111010': 3, '100000000': 110, '111111011': 32, '000000111': 51, '000100000': 84, '000011111': 82, '000000001': 176, '100000010': 6, '111100001': 3, '000000011': 36, '101111111': 98, '100000011': 2, '001111111': 75, '000001000': 60, '000011101': 4, '110111111': 38, '111111101': 72, '111100100': 3, '000100010': 1, '001011101': 1, '000000110': 8, '110000011': 1, '000111111': 48, '000000100': 23, '000001111': 65, '010000101': 2, '000100001': 8, '111110000': 51, '010001111': 1, '111000111': 2, '111000001': 2, '000111100': 1, '011111111': 116, '111110001': 1, '000011110': 10, '000010000': 23, '000101111': 3, '000101110': 1, '011110111': 4, '010000111': 7, '111101111': 36, '001000000': 40, '010100000': 3, '101111110': 8, '110111000': 5, '000000101': 8, '010000010': 4, '000110001': 2, '110111110': 4, '111100010': 2, '111010111': 2, '000001110': 5, '111110101': 3, '001110000': 4, '101100000': 5, '001111110': 8, '100000001': 5, '111011110': 3, '111110100': 5, '110001011': 1, '001110111': 4, '000010110': 2, '111001111': 2, '000011000': 5, '010111110': 1, '000101000': 4, '101000000': 4, '100111111': 4, '111110011': 2, '000101100': 1, '101111100': 2, '111011100': 1, '001111011': 3, '011111011': 3, '110100000': 5, '000001011': 3, '111110110': 5, '111111001': 5, '000001001': 8, '010000001': 5, '011111101': 2, '001010111': 1, '011101110': 1, '110110110': 1, '001111100': 3, '100001000': 3, '001000011': 1, '001011111': 6, '110000010': 2, '110010000': 1, '010011111': 2, '111101101': 3, '101110000': 1, '111100111': 6, '010111111': 5, '110110000': 2, '011011111': 2, '110011111': 1, '110000111': 6, '001000001': 2, '001100000': 3, '101101111': 1, '000111110': 5, '111011101': 2, '100100000': 2, '101111101': 3, '001001111': 1, '001010000': 2, '111001000': 1, '011110000': 2, '011101111': 3, '000001100': 1, '110101000': 1, '011000000': 4, '111101000': 3, '110000001': 4, '000010111': 4, '011111100': 1, '111000010': 1, '101011000': 1, '101111000': 2, '001101111': 1, '010001100': 1, '000100011': 1, '111110010': 1, '111101110': 1, '100001111': 1, '100011011': 1, '010110111': 1, '001110110': 2, '100000100': 1, '001000110': 1, '100011111': 2, '010010001': 1, '111010110': 1, '011110110': 1, '000111000': 2, '000100111': 1, '011010000': 1, '001111000': 2, '100010000': 1, '011111000': 2, '110111100': 2, '110110111': 1, '110001000': 1, '000110111': 1, '000101011': 1, '000110000': 1, '011100000': 3, '001000010': 1, '001001000': 1, '001000111': 1, '001111101': 3, '111101011': 1, '111010000': 1, '100000101': 1, '000010010': 1, '001011110': 1, '000011011': 1, '111101100': 1}
GHZ状態の理想的な分布は、ショットの半分がを返し、残りの半分がを返すものであることがわかっています。比較のためにこれを構築します。
ideal_dist = []
for n in range(nmin, nmax):
    ideal_dist.append({"0" * n: int(shots / 2), "1" * n: int(shots / 2)})
ここでは、最終状態の質を測る指標としてヘリンジャー忠実度を使用します。
from qiskit.quantum_info import hellinger_fidelity

num_qubits = []
fidelities_twirl = []
fidelities_no_twirl = []
for n in range(len(ideal_dist)):
    num_qubits.append(nmin + n)
    fidelities_twirl.append(hellinger_fidelity(counts_list_ghz_twirl[n], ideal_dist[n]))
    fidelities_no_twirl.append(
        hellinger_fidelity(counts_list_ghz_no_twirl[n], ideal_dist[n])
    )
最後に、結果をプロットします。
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values using no twirling
ax.scatter(
    num_qubits,
    fidelities_no_twirl,
    c="blue",
    linestyle="-",
    label="No twirl",
    alpha=0.7,
)

## Add values with twirling
ax.scatter(
    num_qubits, fidelities_twirl, c="red", linestyle="-", label="Twirled", alpha=0.7
)

# Add labels and plot
ax.set_xlabel("Qubits in GHZ state")
ax.set_ylabel("Hellinger fidelity")
ax.legend()
ax.set_title("Pauli twirling in GHZ states")
ax.grid(True)

plt.show()
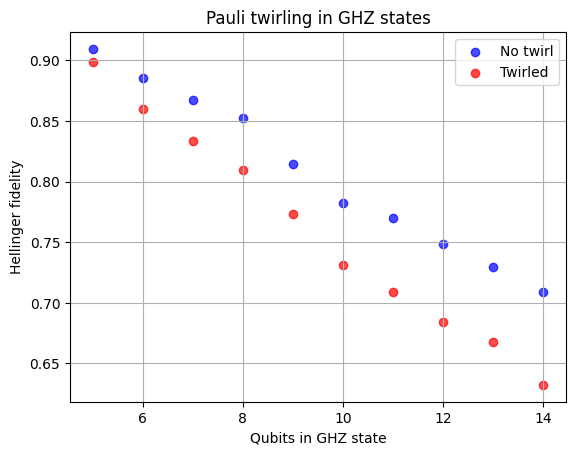
パウリ・ツワリングを使用した結果は、ツワリングなしの結果より良くなっておらず(むしろわずかに悪くなっています)。何が起こったのでしょうか?
2つのことが起こりました。まず、パウリ・ツワリングはノイズの総量を減らすものではありません — むしろ、コヒーレントで系統的なエラーを確率的なパウリ型エラーに整形し直すことで、エラーの増加を予測可能でモデル化可能なものにします。特別な場合を除き、エラーの削減が約束されたことは一度もありません。
第二に、GHZ回路では、GHZ構成の対称性により、一部のコヒーレントなエラーが部分的に打ち消し合ったり、無害な位相シフトのように振る舞ったりすることがあります。ツワリングはこの偶然の保護を取り除き、相関のない確率的なパウリノイズに置き換えるため、ツワリングを行うとGHZ忠実度はわずかに悪化します。
この2つ目の主張には少し説明が必要です。この主張は、GHZ回路が__あらゆる__種類のコヒーレントなエラーの蓄積から保護されているというものではなく、一部の種類からのみ保護されている — そして、そのような場合にその保護がツワリングによって破壊されるというものです。具体的に、CXゲートに関連するコヒーレントな過回転を考えてみましょう。過回転のある実際のCXゲートをと呼ぶことにします:
ここで、 は 、、、 などのパウリ演算子の任意の積です。一般的な状態では、これらのオーバー回転のいずれもが測定統計量(したがって状態忠実度の指標)に影響を与える可能性があります。しかし、これらの一部は、 や などの演算子を含む多くの標準的なGHZ可観測量を変化させないままにします。GHZ状態を準備する文脈では、このタイプの関連するオーバー回転エラーは次のようになります。
量子ビット全体のGHZ状態の準備は次のようになります。
GHZ状態を準備した後、理想的にはその状態は次のようになります。
この状態は、次のものを含む多数のパウリ演算子の同時固有状態です。
固有値は です。その結果、 という形の演算子はGHZ状態に対して位相因子 を乗じるように作用し、これはパリティ、集団的な 、または計算基底の存在確率といった標準的なGHZ可観測量に影響を与えません。 したがって、オーバー回転エラー はコヒーレントかつ系統的であるにもかかわらず、GHZ忠実度を評価するために使用される測定には事実上現れません。この意味で、GHZ回路は偶発的なコヒーレンス保護を享受しています。すなわち、特定のコヒーレントなCXエラーは準備される状態の構造と可換であるため、測定されるパフォーマンスを低下させません。
パウリツイリングはこの状況を根本的に変えます。ツイリングは、コヒーレントなオーバー回転エラーを決定論的な プロセスとして保持しません。代わりに、コヒーレントなエラーチャネルを実効的な確率的パウリチャネルに変換します。その結果、エラーチャネルには 、、、 といった、GHZスタビライザーと可換でない項が含まれるようになります。
これらの確率的パウリエラーが発生すると、個々の量子ビットまたは量子ビットのペアに実際のビット反転およびフェーズ反転の欠陥が生じます。これらのエラーは状態をGHZスタビライザー部分空間の外に押し出し、 と の間の干渉を低下させ、GHZ忠実度と多量子ビットパリティ信号を直接低下させます。言い換えると、パウリツイリングはエラーのコヒーレントな構造を取り除きますが、それまでこれらのエラーを無害にしていた対称性に基づくキャンセルも取り除いてしまいます。その結果、GHZ状態はわずかに悪化します—ツイリングがノイズを加えるからではなく、ほとんど無害だったコヒーレントエラーを、実際に有害な確率的エラーに変換してしまうからです。
この例は重要な教訓を示しています。パウリツイリングは普遍的な改善戦略ではないということです。パウリツイリングが最も有効なのは、コヒーレントエラーが回路全体にわたって、必要な忠実度を損なうような形で蓄積する場合です。GHZ状態の準備のように高度に対称的な回路では、一部のコヒーレントエラーは状態のスタビライザーと自然に整合しており、それらを意図的にランダム化すると、この偶発的な保護が失われてしまうことがあります。
メソッドの組み合わせ
原理的には、パウリツイリングと動的デカップリングを組み合わせることができます。今回このケースでDDを使用しなかった理由は2つあります。まず、この回路には極端に長いアイドル期間はないはずだからです。次に、GHZ状態は、特にビット列のカウントの観点のみで忠実度を観測しており、目的のビット列 と の間の位相の観点で観測していない場合、その情報のほとんどを単一量子ビットの位相コヒーレンスには保存していないからです。
もしGHZの準備を100量子ビット以上に拡張するとしたら、最初/初期の量子ビットを測定するまでの遅延が実際に十分長くなり、DDが有用になる可能性があります。これは特に、回路のトランスパイル後の深さを考慮に入れる場合に当てはまります。
RTZエコー構造におけるパウリツイリング
コヒーレントエラーの蓄積を低減するという文脈でのパウリツイリングの最後の例では、X-CZ-X-CZの組み合わせの層を持つ回路を使用します。これはよく知られたゲート列であり、ツイリングなしでも2量子ビットゲートにおけるコヒーレントなZZエラー項をキャンセルするためによく使われます。しかし、ツイリングを用いることで、他の形のコヒーレントエラーの蓄積を低減またはランダム化することができます。
まず、層の数を変えながらRTZ様の回路を構築する関数を定義するところから始めます。
from qiskit import QuantumCircuit

def rtz_echo_circuit(n_qubits: int, depth: int) -> QuantumCircuit:
    """
    Construct an RTZ echo-style circuit.

    Args:
        n_qubits: Number of qubits in the circuit.
        depth: Number of repeated echo layers.

    Returns:
        A QuantumCircuit implementing the echo sequence with measurements.
    """
    q = QuantumRegister(n_qubits, "q")
    c = ClassicalRegister(n_qubits, "c")
    qc = QuantumCircuit(q, c)

    for _ in range(depth):
        qc.h(q)

        for i in range(0, n_qubits - 1, 2):
            qc.cz(q[i], q[i + 1])

        qc.x(q)

        for i in range(1, n_qubits - 1, 2):
            qc.cz(q[i], q[i + 1])

        qc.h(q)

    qc.measure(q, c)
    return qc
次に、妥当な合計トランスパイル後2量子ビット深さになるまで、層の数を増やしながら回路を構築します。
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

circuits = []
qcs = []
depths = list(range(3, 27, 4))
n_qubits = 10

opt_level = 0
pm = generate_preset_pass_manager(
    optimization_level=opt_level,
    backend=backend,
    initial_layout=[0, 1, 2, 3, 4, 5, 6, 7, 8, 9],
)

for d in depths:
    qc = rtz_echo_circuit(n_qubits, d)
    qcs.append(qc)
    qc_isa = pm.run(qc)
    circuits.append(qc_isa)
# We can check the 2-qubit depths of any of our circuits like this:
two_qubit_depths = []
for n in range(len(circuits)):
    two_qubit_depths.append(
        circuits[n].decompose().depth(lambda instr: len(instr.qubits) > 1)
    )
print(two_qubit_depths)
[6, 14, 22, 30, 38, 46]
qcs[0].draw("mpl")
# circuits[0].draw("mpl")
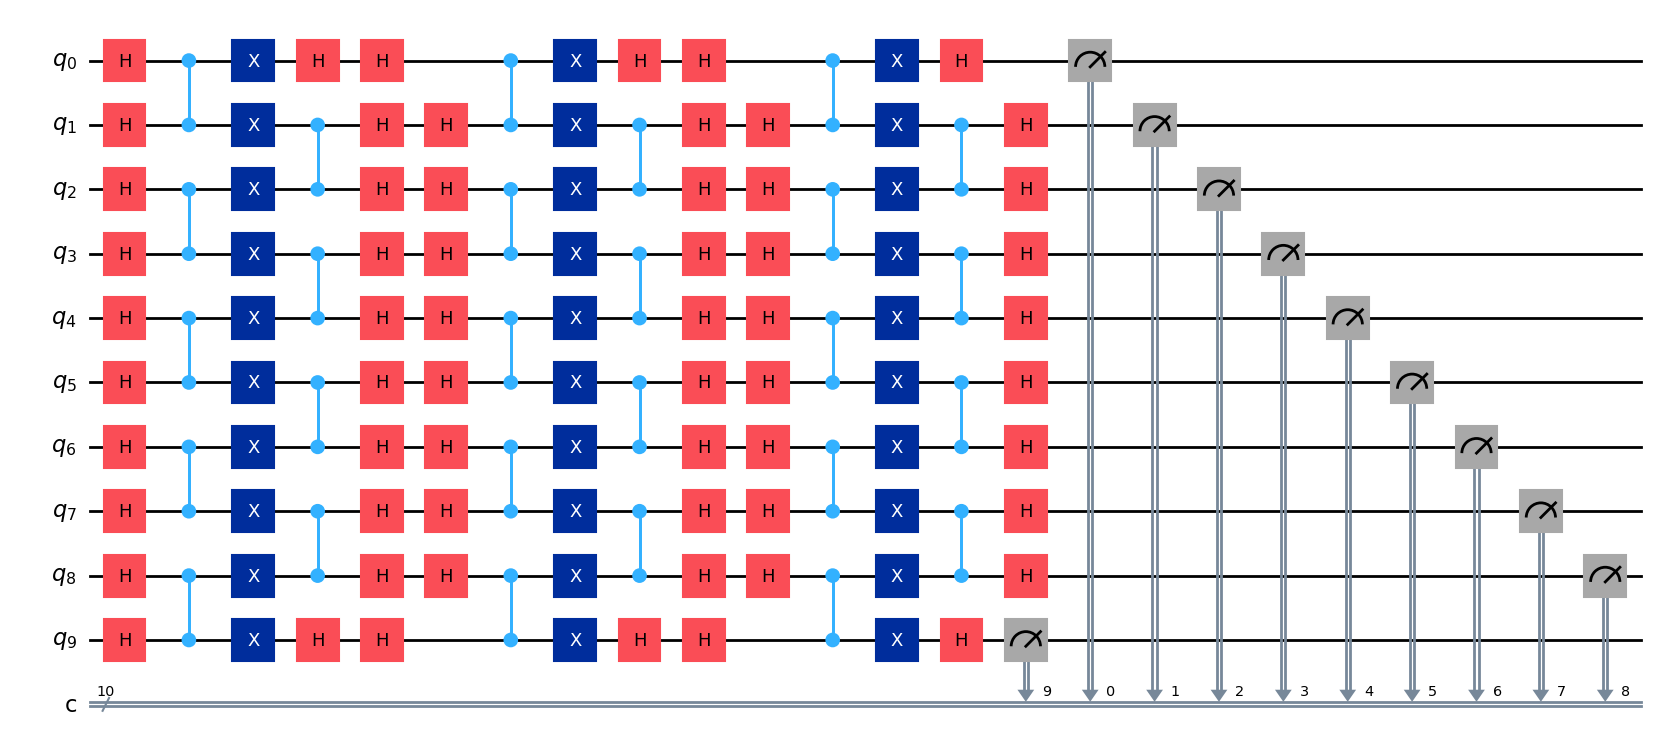
上限に近いものでは、これらの回路はかなり深くなります。ノイズモデルなしのAerSimulatorを使用して、これらの各回路の最後に得られる理想的な状態を求めましょう。そうすることで、実際の量子コンピュータから得た結果をHellinger忠実度を使ってベンチマークできます。
from qiskit_aer import AerSimulator

sim = AerSimulator()
ideal_results = sim.run(circuits, shots=8192).result()
ideal_counts = ideal_results.get_counts()
次に、ツイリングありのSamplerV2と、ツイリングなしのSamplerV2を定義します。
from qiskit_ibm_runtime import SamplerV2 as Sampler

shots = 8192

# --- No Twirling ---
sampler_no = Sampler(mode=backend)
sampler_no.options.twirling.enable_gates = False
sampler_no.options.twirling.enable_measure = False
sampler_no.options.default_shots = shots

# --- With Twirling ---
sampler_tw = Sampler(mode=backend)
sampler_tw.options.twirling.enable_gates = True
sampler_tw.options.twirling.enable_measure = False
# sampler_tw.options.twirling.num_randomizations = "auto"
sampler_tw.options.twirling.num_randomizations = 32
sampler_tw.options.twirling.strategy = "active-circuit"
sampler_tw.options.default_shots = shots
次にジョブを実行します。
# Each job took 17 sec (34 sec total) on ibm_fez. Your times might vary.

job_no = sampler_no.run(circuits)
job_tw = sampler_tw.run(circuits)

res_no = job_no.result()
res_tw = job_tw.result()
実際の量子コンピュータでの各実行からカウントを取得します。
counts_no = [r.data.c.get_counts() for r in res_no]
counts_tw = [r.data.c.get_counts() for r in res_tw]
次に、これらの各実行結果をノイズのないAerSimulatorの結果と比較して、Hellinger忠実度を求めます。
from qiskit.quantum_info import hellinger_fidelity

f_no = [hellinger_fidelity(counts_no[i], ideal_counts[i]) for i in range(len(circuits))]

f_tw = [hellinger_fidelity(counts_tw[i], ideal_counts[i]) for i in range(len(circuits))]
次に結果を可視化します。
import matplotlib.pyplot as plt

plt.figure(figsize=(8, 5))
plt.plot(two_qubit_depths, f_no, "o-", label="No Twirling")
plt.plot(two_qubit_depths, f_tw, "o-", label="With Twirling")
plt.xlabel("Two-qubit transpiled depth")
plt.ylabel("Hellinger Fidelity")
plt.title("RTZ Echo Circuit: Twirling vs No Twirling")
plt.legend()
plt.grid(True)
plt.show()
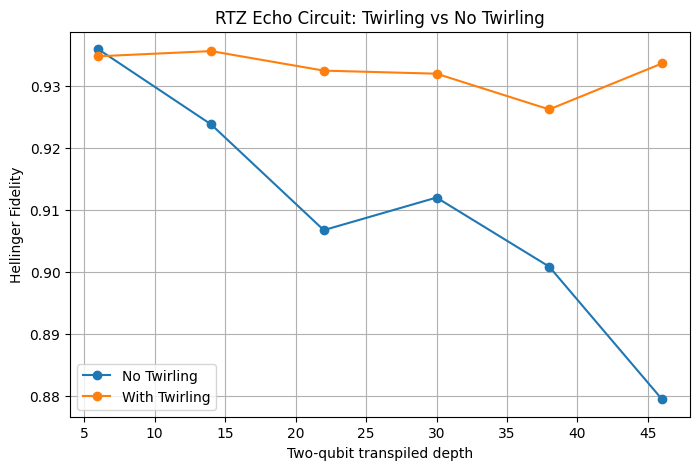
このレッスンでは、コヒーレントエラーの蓄積を抑えるためにパウリツイリングが使われるケースを検討してきました。これはエラー抑制と呼べる文脈です。しかし、パウリツイリングはむしろ、エラーの振る舞いを再形成し、コヒーレントエラーをより予測可能でモデル化しやすい形に変換するためのツールとして有用であることが多いです。この有用性は、ゼロノイズ外挿(ZNE)のような、比較的予測可能なノイズスケーリングに依存するエラー緩和技術の文脈でより明らかになります。これについては次のレッスンで説明します。