分数ゲートを用いた量子カーネル
使用量の目安: Heron r2 プロセッサで30秒未満(注意: これは目安です。実際の実行時間は異なる場合があります。)
学習成果
-
分数ゲートとは何か、そしてそれがIBM® QPU上での回路の深さと実行時間をどのように削減するか
-
分数ゲートを使用する際の制約(特にRZZ角度の範囲)
-
IBM Quantum Compute Serviceを用いて分数ゲートを使用する量子カーネルワークフローを構築する方法
-
分数ゲートあり・なしでのハードウェア実行メトリクス(深さ、実行時間、非局所ゲート数、忠実度)を比較する方法
-
標準のQiskitパターンワークフローを維持しながら分数RXゲートのみを使用する方法
前提条件
-
Qiskitパターンワークフロー
-
分数ゲートガイド
-
量子カーネルトレーニングチュートリアルと、量子機械学習コースにおける量子カーネルレッスン
背景
IBM QPU における分数ゲート
分数ゲートは、パラメータ化された量子ゲートであり、任意の角度の回転(特定の範囲内)を直接実行することを可能にします。 これにより、複数の基底ゲートへの分解が不要になります。 物理量子ビット間のネイティブな相互作用を活用することで、ハードウェア上でより効率的に特定のユニタリ演算を実装できます。
IBM Quantum® Heron QPU は以下の分数ゲートをサポートしています:
- for
- for any real value
これらのゲートは、量子回路の深さと実行時間の両方を大幅に削減できます。 特に と を多用するアプリケーションにおいて有利です。 例えば、ハミルトニアンシミュレーション、量子近似最適化アルゴリズム(QAOA)、量子カーネル法などが挙げられます。 本チュートリアルでは、実践的な例として量子カーネルに焦点を当てます。
制限事項
分数ゲートは現在実験的な機能であり、いくつかの制約があります:
- の角度は の範囲に制限されています。
- 分数ゲートの使用は、動的回路、パウリ・ツイリング、確率的エラーキャンセレーション(PEC)、およびゼロノイズ外挿(ZNE)(確率的エラー増幅(PEA)を使用する場合)ではサポートされていません。
分数ゲートは、標準的なアプローチとは異なるワークフローを必要とします。 本チュートリアルでは、実践的なアプリケーションを通じて分数ゲートの使い方を説明します。
分数ゲートの詳細については、以下を参照してください。
RZZ角度制約に対するワークフローのアプローチ
分数ゲートを使用するワークフローは、一般的にQiskitパターンのワークフローに従います。 主な違いは、すべてのRZZ角度がの制約を満たす必要があることです。 この条件を確保するには2つのアプローチがあり、以下で説明します。2番目のアプローチを推奨し、本チュートリアルでは量子カーネル法にヒントを得た例を通してそれを実演します。 量子カーネルがどこで有用となりそうかをよりよく理解するには、Liu, Arunachalam & Temme (2021)を読むことをお勧めします。
また、量子カーネルトレーニングチュートリアルや、IBM Quantum® Learning の量子機械学習コースにおける量子カーネルレッスンも併せて参照してください。
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "qiskit": "qiskit", "qiskit_aer": "qiskit-aer", "qiskit_basis_constructor": "qiskit-basis-constructor", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
1. RZZ 角度制約を満たすパラメータ値を生成する
すべての RZZ 角度が有効範囲内にあることが確実な場合、標準的な Qiskit パターンのワークフローに従うことができます。 この場合、パラメータ値を PUB の一部として送信するだけです。ワークフローは以下のように進みます。
pm = generate_preset_pass_manager(backend=backend, ...)
t_circuit = pm.run(circuit)
t_observable = observable.apply_layout(t_circuit.layout)
sampler.run([(t_circuit, parameter_values)])
estimator.run([(t_circuit, t_observable, parameter_values)])
有効範囲外の角度を持つ RZZ ゲートを含む PUB を送信しようとすると、以下のようなエラーメッセージが表示されます:
'The instruction rzz is supported only for angles in the range [0, pi/2], but an angle (20.0) outside of this range has been requested; via parameter value(s) γ[0]=10.0, substituted in parameter expression 2.0*γ[0].'
このエラーを回避するには、以下に説明する2番目のアプローチを使用してください。
2. トランスパイル前にパラメータ値を回路に割り当てる
qiskit-ibm-runtime パッケージは、FoldRzzAngleという専用のトランスパイラパスを提供しています。
このパスは、すべての RZZ 角度が RZZ 角度制約に準拠するように量子回路を変換します。
generate_preset_pass_manager または transpile にバックエンドを指定すると、Qiskit は自動的に FoldRzzAngle を量子回路に適用します。
このアプローチでは、トランスパイル前にパラメータ値を量子回路に割り当てる必要があります。
ワークフローは以下のように進みます。
pm = generate_preset_pass_manager(backend=backend, ...)
b_circuit = circuit.assign_parameters(parameter_values)
t_circuit = pm.run(b_circuit)
t_observable = observable.apply_layout(t_circuit.layout)
sampler.run([(t_circuit,)])
estimator.run([(t_circuit, t_observable)])
このワークフローは、Circuitへのパラメータ値の割り当てとパラメータバインド済みCircuitのローカルへの保存を伴うため、最初のアプローチよりも計算コストが高くなることに注意してください。
qiskit-ibm-runtime v0.47.0の既知の問題に注意してください。特定のシナリオでは、トランスパイレーション後でも無効な角度を持つRZZゲートがCircuit内に残ることがあります。
この問題の進捗については、qiskit-ibm-runtime#2441を参照してください。 解決するまでは、以下の回避策を推奨します。
pm = generate_preset_pass_manager(backend=backend, ...)
pm.post_optimization = PassManager(
    [
        FoldRzzAngle(),
        Optimize1qGatesDecomposition(target=backend.target),
        RemoveIdentityEquivalent(target=backend.target),
    ]
)
... = pm.run(...)
必要な環境
本チュートリアルを始める前に、以下がインストールされていることを確認してください:
- Qiskit SDK v2.0 以降、可視化サポート付き
- Qiskit Runtime v0.41 以降(
pip install qiskit-ibm-runtime) - Qiskit Aer v0.17 以降(
pip install qiskit-aer) - Qiskit Basis Constructor(
pip install qiskit_basis_constructor)
セットアップ
import matplotlib.pyplot as plt
import numpy as np
from qiskit import QuantumCircuit, generate_preset_pass_manager
from qiskit.circuit import ParameterVector
from qiskit.circuit.library import UGate, n_local, unitary_overlap
from qiskit.transpiler import Target, PassManager
from qiskit.transpiler.passes import (
    Optimize1qGatesDecomposition,
    RemoveIdentityEquivalent,
)
from qiskit_aer.primitives import SamplerV2 as AerSampler
from qiskit_basis_constructor import DEFAULT_EQUIVALENCE_LIBRARY
from qiskit_ibm_runtime import QiskitRuntimeService, SamplerV2
from qiskit_ibm_runtime.transpiler.passes import FoldRzzAngle
分数ゲートの有効化と基底ゲートの確認
分数ゲートを使用するには、use_fractional_gates=True オプションを設定して、分数ゲートをサポートするバックエンドを取得します。
バックエンドが分数ゲートをサポートしている場合、基底ゲートの一覧に rzz と rx が表示されます。
service = QiskitRuntimeService()
backend = service.least_busy(
    operational=True, simulator=False, min_num_qubits=133
)  # backend should be a heron device or later
backend_name = backend.name
backend_c = service.backend(backend_name)  # w/o fractional gates
backend_f = service.backend(
    backend_name, use_fractional_gates=True
)  # w/ fractional gates
print(f"Backend: {backend_name}")
print(f"No fractional gates: {backend_c.basis_gates}")
print(f"With fractional gates: {backend_f.basis_gates}")
if "rzz" not in backend_f.basis_gates:
    print(f"Backend {backend_name} does not support fractional gates")
Backend: ibm_marrakesh
No fractional gates: ['cz', 'id', 'rz', 'sx', 'x']
With fractional gates: ['cz', 'id', 'rx', 'rz', 'rzz', 'sx', 'x']
小規模シミュレーターの例
このセクションでは、量子カーネルCircuitを実際の例として使用しながら、シミュレーター上でQiskitパターンワークフローの4つのステップを一通り説明します。
ステップ 1: 古典的な入力を量子問題にマッピングする
量子カーネル回路
このセクションでは、RZZ ゲートを使用した量子カーネル回路を探究し、分数ゲートのワークフローを紹介します。
まず、カーネル行列の個々の要素を計算するための量子回路を構築します。 これは、ZZ 特徴マップ回路とユニタリオーバーラップを組み合わせることで行います。 カーネル関数は、特徴マップ空間のベクトルを受け取り、カーネル行列の要素として内積を返します: ここで は特徴マップされた量子状態を表します。
RZZ ゲートを使用して、ZZ 特徴マップ回路を手動で構築します。
Qiskit には組み込みの zz_feature_map が提供されていますが、Qiskit v2.4.1 の時点では RZZ ゲートをサポートしていません(issue を参照)。
次に、同一の入力に対するカーネル関数を計算します。例えば となります。 ノイズのある量子コンピュータでは、ノイズの影響によりこの値が1未満になる場合があります。 1に近い結果ほど、実行時のノイズが少ないことを示します。 本チュートリアルでは、この値を忠実度と呼び、以下のように定義します。
optimization_level = 2
shots = 2000
reps = 3
rng = np.random.default_rng(seed=123)
def my_zz_feature_map(num_qubits: int, reps: int = 1) -> QuantumCircuit:
    x = ParameterVector("x", num_qubits * reps)
    qc = QuantumCircuit(num_qubits)
    qc.h(range(num_qubits))
    for k in range(reps):
        K = k * num_qubits
        for i in range(num_qubits):
            qc.rz(x[i + K], i)
        pairs = [(i, i + 1) for i in range(num_qubits - 1)]
        for i, j in pairs[0::2] + pairs[1::2]:
            qc.rzz((np.pi - x[i + K]) * (np.pi - x[j + K]), i, j)
    return qc

def quantum_kernel(num_qubits: int, reps: int = 1) -> QuantumCircuit:
    qc = my_zz_feature_map(num_qubits, reps=reps)
    inner_product = unitary_overlap(qc, qc, "x", "y", insert_barrier=True)
    inner_product.measure_all()
    return inner_product

def random_parameters(inner_product: QuantumCircuit) -> np.ndarray:
    return np.tile(rng.random(inner_product.num_parameters // 2), 2)

def fidelity(result) -> float:
    ba = result.data.meas
    return ba.get_int_counts().get(0, 0) / ba.num_shots
4量子ビットから40量子ビットまでのシステムに対して、量子カーネル回路とそれに対応するパラメータ値が生成され、その後忠実度が評価されます。
qubits = list(range(4, 12, 2))
circuits = [quantum_kernel(i, reps=reps) for i in qubits]
params = [random_parameters(circ) for circ in circuits]
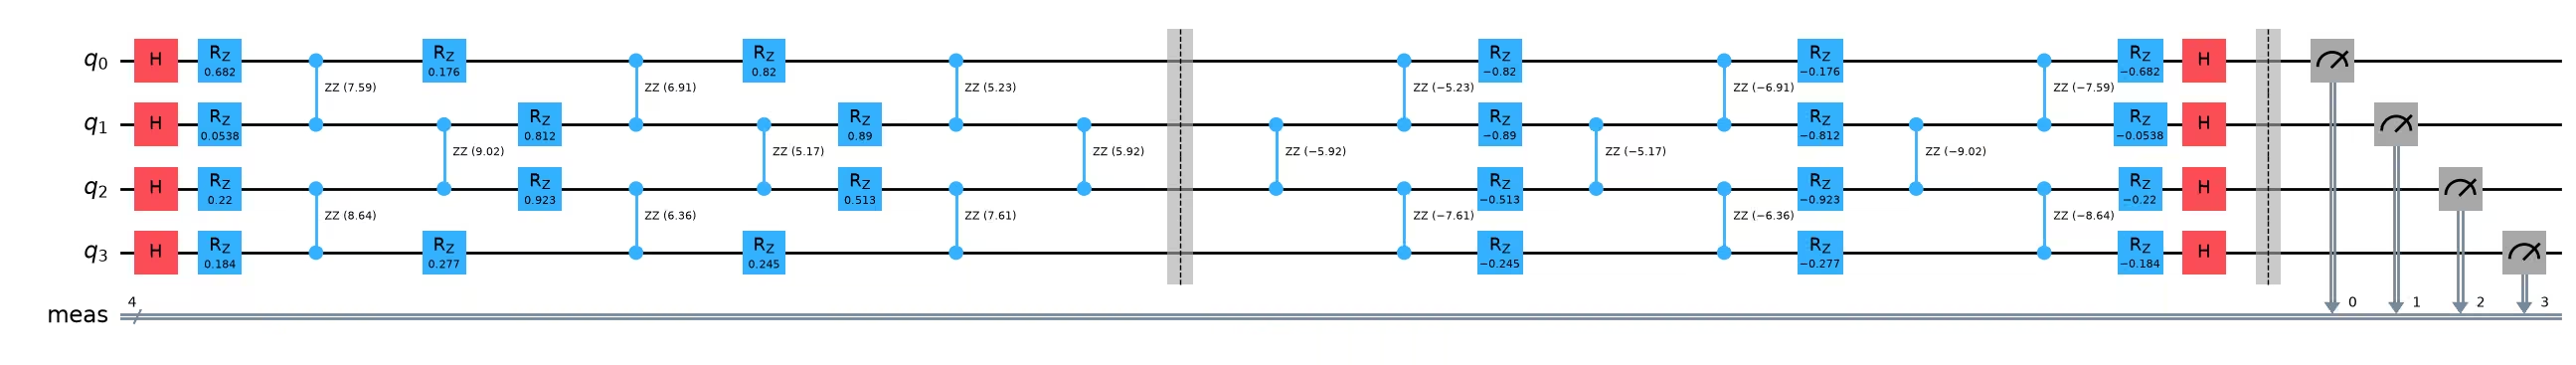
4量子ビットの回路を以下に可視化します。
circuits[0].draw("mpl", fold=-1)

標準的な Qiskit パターンのワークフローでは、パラメータ値は通常 PUB の一部として Sampler または Estimator プリミティブに渡されます。 しかし、分数ゲートをサポートするバックエンドを使用する場合、これらのパラメータ値はトランスパイル前に量子回路に明示的に割り当てる必要があります。
b_qc = [
    circ.assign_parameters(param) for circ, param in zip(circuits, params)
]
b_qc[0].draw("mpl", fold=-1)
ステップ 2: 量子ハードウェア実行のための問題の最適化
次に、標準的な Qiskit パターンに従い、パスマネージャーを使用して回路をトランスパイルします。
分数ゲートをサポートするバックエンドを generate_preset_pass_manager に提供することで、FoldRzzAngle という専用パスが自動的に含まれます。
このパスは、RZZ 角度制約に準拠するように回路を変更します。
その結果、前の図で負の値を持っていた RZZ ゲートは正の値に変換され、いくつかの追加の X ゲートが挿入されます。
backend_f = service.backend(name=backend_name, use_fractional_gates=True)
# pm_f includes `FoldRzzAngle` pass
pm_f = generate_preset_pass_manager(
    optimization_level=optimization_level, backend=backend_f
)
pm_f.post_optimization = PassManager(
    [
        FoldRzzAngle(),
        Optimize1qGatesDecomposition(target=backend_f.target),
        RemoveIdentityEquivalent(target=backend_f.target),
    ]
)
t_qc_f = pm_f.run(b_qc)
print(t_qc_f[0].count_ops())
t_qc_f[0].draw("mpl", fold=-1)
OrderedDict({'rz': 35, 'rzz': 18, 'x': 13, 'rx': 9, 'measure': 4, 'barrier': 2})

分数ゲートの効果を評価するために、非局所ゲートの数(このバックエンドでは CZ と RZZ)、 回路の深さと実行時間を評価し、後ほど標準ワークフローのものと比較します。
nnl_f = [qc.num_nonlocal_gates() for qc in t_qc_f]
depth_f = [qc.depth() for qc in t_qc_f]
duration_f = [
    qc.estimate_duration(backend_f.target, unit="u") for qc in t_qc_f
]
ステップ 3: Qiskit プリミティブを使用して実行する
分数ゲートをサポートするバックエンドでトランスパイル済み回路を実行します。
sampler_f = AerSampler.from_backend(backend_f)
job = sampler_f.run(t_qc_f, shots=shots)
print(job.job_id())
085ce928-767e-4200-93bf-3905e5411cfe
ステップ 4: 後処理と結果の古典的な形式への変換
出力における全ゼロビット列 00...00 の確率を測定することで、カーネル関数の値 を得ることができます。
result = job.result()
fidelity_f = [fidelity(result=res) for res in result]
print(fidelity_f)
[0.929, 0.882, 0.8645, 0.817]
分数ゲートなしのワークフローと回路の比較
このセクションでは、分数ゲートをサポートしないバックエンドを使用した標準的な Qiskit パターンのワークフローを示します。 トランスパイルされた回路を比較すると、分数ゲートを使用したバージョン(前のセクション)の方が、分数ゲートなしのバージョンよりもコンパクトであることがわかります。
# step 1: map classical inputs to quantum problem
# `circuits` and `params` from the previous section are reused here
# step 2: optimize circuits
backend_c = service.backend(backend_name)  # w/o fractional gates
pm_c = generate_preset_pass_manager(
    optimization_level=optimization_level, backend=backend_c
)
t_qc_c = pm_c.run(circuits)
print(t_qc_c[0].count_ops())
t_qc_c[0].draw("mpl", fold=-1)
OrderedDict({'rz': 130, 'sx': 80, 'cz': 36, 'measure': 4, 'barrier': 2})

nnl_c = [qc.num_nonlocal_gates() for qc in t_qc_c]
depth_c = [qc.depth() for qc in t_qc_c]
duration_c = [
    qc.estimate_duration(backend_c.target, unit="u") for qc in t_qc_c
]
# step 3: execute
sampler_c = AerSampler.from_backend(backend_c)
job = sampler_c.run(pubs=zip(t_qc_c, params), shots=shots)
print(job.job_id())
f2cca29d-7263-4976-9e51-13a91b75c3ae
# step 4: post-processing
result = job.result()
fidelity_c = [fidelity(res) for res in result]
print(fidelity_c)
[0.8625, 0.7605, 0.702, 0.671]
深さ、実行時間、忠実度の比較
このセクションでは、分数ゲートを使用した回路と使用しない回路の間で、非局所ゲートの数と忠実度を比較します。 これにより、実行効率と品質の観点から分数ゲートを使用する潜在的なメリットが明らかになります。
plt.plot(qubits, depth_c, "-o", label="no fractional gates")
plt.plot(qubits, depth_f, "-o", label="with fractional gates")
plt.xlabel("number of qubits")
plt.ylabel("depth")
plt.title("Comparison of depths")
plt.grid()
plt.legend()
<matplotlib.legend.Legend at 0x116af3cb0>

plt.plot(qubits, duration_c, "-o", label="no fractional gates")
plt.plot(qubits, duration_f, "-o", label="with fractional gates")
plt.xlabel("number of qubits")
plt.ylabel("duration (µs)")
plt.title("Comparison of durations")
plt.grid()
plt.legend()
<matplotlib.legend.Legend at 0x11ea4f4d0>

plt.plot(qubits, nnl_c, "-o", label="no fractional gates")
plt.plot(qubits, nnl_f, "-o", label="with fractional gates")
plt.xlabel("number of qubits")
plt.ylabel("number of non-local gates")
plt.title("Comparison of numbers of non-local gates")
plt.grid()
plt.legend()
<matplotlib.legend.Legend at 0x1247fc440>

plt.plot(qubits, fidelity_c, "-o", label="no fractional gates")
plt.plot(qubits, fidelity_f, "-o", label="with fractional gates")
plt.xlabel("number of qubits")
plt.ylabel("fidelity")
plt.title("Comparison of fidelities")
plt.grid()
plt.legend()
<matplotlib.legend.Legend at 0x120b792b0>

大規模ハードウェアの例
このセクションでは、最大40Qubitの量子ハードウェア上で、分数ゲートあり・なしの量子カーネルワークフローをベンチマークします。
ステップ1~4を組み合わせる
このワークフローは、小規模な例と同じ構造に従います。分数ゲートあり・なしですべてのCircuitをトランスパイルし、メトリクスを収集した後、Circuitを実際の量子ハードウェアに送信します。
# -------------------------Step 1-------------------------
qubits = list(range(4, 44, 4))
circuits = [quantum_kernel(i, reps=reps) for i in qubits]
params = [random_parameters(circ) for circ in circuits]
b_qc = [
    circ.assign_parameters(param) for circ, param in zip(circuits, params)
]

def benchmark(b_qc, backend):
    # -------------------------Step 2-------------------------
    pm = generate_preset_pass_manager(optimization_level, backend=backend)
    if "rzz" in backend.target.operation_names:
        # workaround until https://github.com/Qiskit/qiskit-ibm-runtime/issues/2441 is resolved
        pm.post_optimization = PassManager(
            [
                FoldRzzAngle(),
                Optimize1qGatesDecomposition(target=backend.target),
                RemoveIdentityEquivalent(target=backend.target),
            ]
        )
    t_qc = pm.run(b_qc)
    nnl = [qc.num_nonlocal_gates() for qc in t_qc]
    depth = [qc.depth() for qc in t_qc]
    duration = [
        qc.estimate_duration(backend_f.target, unit="u") for qc in t_qc
    ]

    # -------------------------Step 3-------------------------
    sampler = SamplerV2(mode=backend)
    sampler.options.dynamical_decoupling.enable = True
    sampler.options.dynamical_decoupling.sequence_type = "XY4"
    sampler.options.dynamical_decoupling.skip_reset_qubits = True
    sampler.options.environment.job_tags = ["TUT_FG"]
    job = sampler.run(t_qc, shots=shots)
    job_id = job.job_id()
    return nnl, depth, duration, job_id

def postprocessing(job_id: str):
    # -------------------------Step 4-------------------------
    job = service.job(job_id)
    result = job.result()
    fidelities = [fidelity(result=res) for res in result]
    usage = job.usage()
    return fidelities, usage

backend_f = service.backend(backend_name, use_fractional_gates=True)
nnl_f, depth_f, duration_f, job_id_f = benchmark(
    b_qc, backend_f
)  # step 2 & 3
print("job id (w/ fractional gates):", job_id_f)
fidelity_f, usage_f = postprocessing(job_id_f)  # step 4
job id (w/ fractional gates): d8uasitbh0os73eqnpig
backend_c = service.backend(backend_name, use_fractional_gates=False)
nnl_c, depth_c, duration_c, job_id_c = benchmark(b_qc, backend_c)
print("job id (w/o fractional gates):", job_id_c)
fidelity_c, usage_c = postprocessing(job_id_c)
job id (w/o fractional gates): d8uav3lposuc738pruug
次に、メトリクスを比較します。
plt.plot(qubits, depth_c, "-o", label="no fractional gates")
plt.plot(qubits, depth_f, "-o", label="with fractional gates")
plt.xlabel("number of qubits")
plt.ylabel("depth")
plt.title("Comparison of depths")
plt.grid()
plt.legend()
<matplotlib.legend.Legend at 0x12461e660>

plt.plot(qubits, duration_c, "-o", label="no fractional gates")
plt.plot(qubits, duration_f, "-o", label="with fractional gates")
plt.xlabel("number of qubits")
plt.ylabel("duration (µs)")
plt.title("Comparison of durations")
plt.grid()
plt.legend()
<matplotlib.legend.Legend at 0x11f2ac980>

plt.plot(qubits, nnl_c, "-o", label="no fractional gates")
plt.plot(qubits, nnl_f, "-o", label="with fractional gates")
plt.xlabel("number of qubits")
plt.ylabel("number of non-local gates")
plt.title("Comparison of numbers of non-local gates")
plt.grid()
plt.legend()
<matplotlib.legend.Legend at 0x125c91be0>

plt.plot(qubits, fidelity_c, "-o", label="no fractional gates")
plt.plot(qubits, fidelity_f, "-o", label="with fractional gates")
plt.xlabel("number of qubits")
plt.ylabel("fidelity")
plt.title("Comparison of fidelities")
plt.grid()
plt.legend()
<matplotlib.legend.Legend at 0x11fcf6e40>

分数ゲートを使用した場合と使用しない場合のQPU使用時間を比較します。以下のセルの結果は、QPU使用時間がほぼ同一であることを示しています。
print(f"no fractional gates: {usage_c} seconds")
print(f"fractional gates: {usage_f} seconds")
no fractional gates: 8 seconds
fractional gates: 8 seconds
応用トピック: フラクショナルRXゲートのみの使用
分数ゲートを使う際に通常とは異なるワークフローが必要になるのは、主にRZZゲートの角度制約のためです。 ただし、分数RXゲートのみを使用し、分数RZZゲートを除外する場合は、標準的なQiskitパターンのワークフローをそのまま使用し続けることができます。 このアプローチでも、特にRXゲートやUゲートを多く含む回路では、全体のゲート数を削減でき、性能向上も期待できるため、十分なメリットがあります。 このセクションでは、RZZゲートを除外しながら、分数RXゲートのみを使用して回路を最適化する方法を示します。
これをサポートするために、Targetオブジェクト内の特定の基底ゲートを無効にするユーティリティ関数を提供します。 ここでは、この関数を使用してRZZゲートを無効にします。
def remove_instruction_from_target(target: Target, gate_name: str) -> Target:
    new_target = Target(
        description=target.description,
        num_qubits=target.num_qubits,
        dt=target.dt,
        granularity=target.granularity,
        min_length=target.min_length,
        pulse_alignment=target.pulse_alignment,
        acquire_alignment=target.acquire_alignment,
        qubit_properties=target.qubit_properties,
        concurrent_measurements=target.concurrent_measurements,
    )

    for name, qarg_map in target.items():
        if name == gate_name:
            continue
        instruction = target.operation_from_name(name)
        if qarg_map == {None: None}:
            qarg_map = None
        new_target.add_instruction(instruction, qarg_map, name=name)
    return new_target
U、CZ、RZZゲートで構成される回路を例として使用します。
qc = n_local(3, "u", "cz", "linear", reps=1)
qc.rzz(1.1, 0, 1)
qc.draw("mpl")

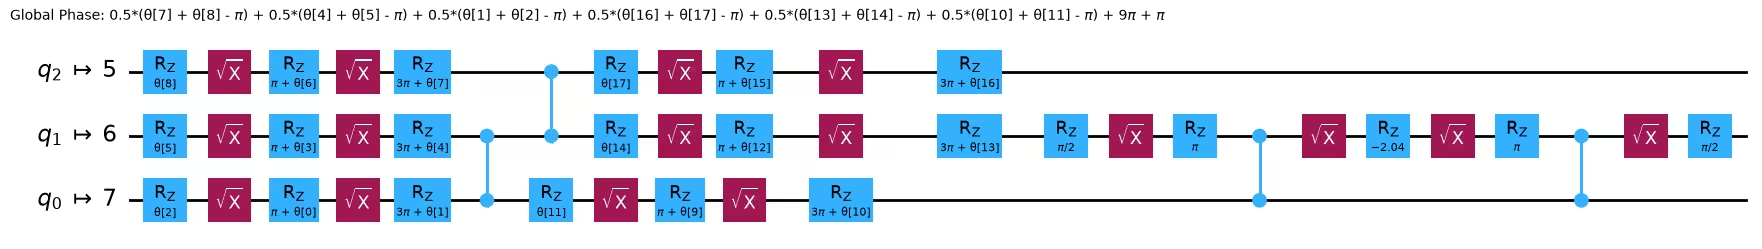
まず、分数ゲートをサポートしないバックエンド向けに回路をトランスパイルします。
pm_c = generate_preset_pass_manager(
    optimization_level=optimization_level, backend=backend_c
)
t_qc = pm_c.run(qc)
print(t_qc.count_ops())
t_qc.draw("mpl")
OrderedDict({'rz': 23, 'sx': 16, 'cz': 4})
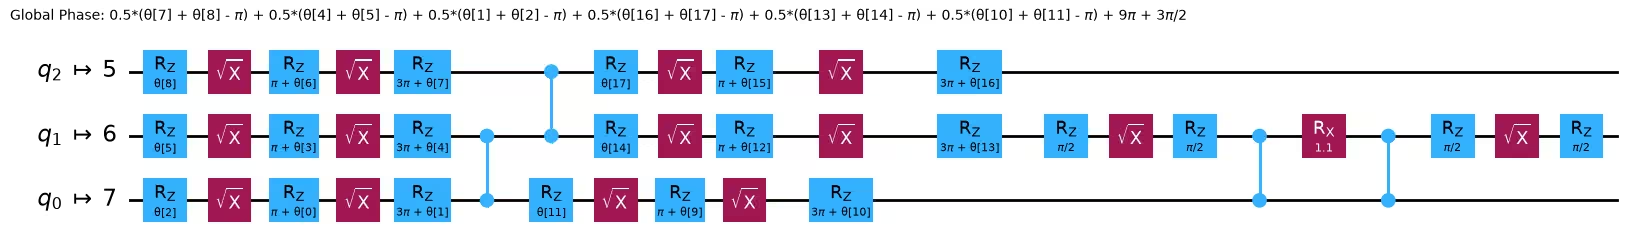
次に、RZZゲートを除外しながら、フラクショナルRXゲートを使用して同じ回路をトランスパイルします。 これにより、RXゲートのより効率的な実装のおかげで、全体的なゲート数がわずかに削減されます。
backend_f = service.backend(backend_name, use_fractional_gates=True)
target = remove_instruction_from_target(backend_f.target, "rzz")
pm_f = generate_preset_pass_manager(
    optimization_level=optimization_level,
    target=target,
)
t_qc = pm_f.run(qc)
print(t_qc.count_ops())
t_qc.draw("mpl")
OrderedDict({'rz': 22, 'sx': 14, 'cz': 4, 'rx': 1})
フラクショナルRXゲートによるUゲートの最適化
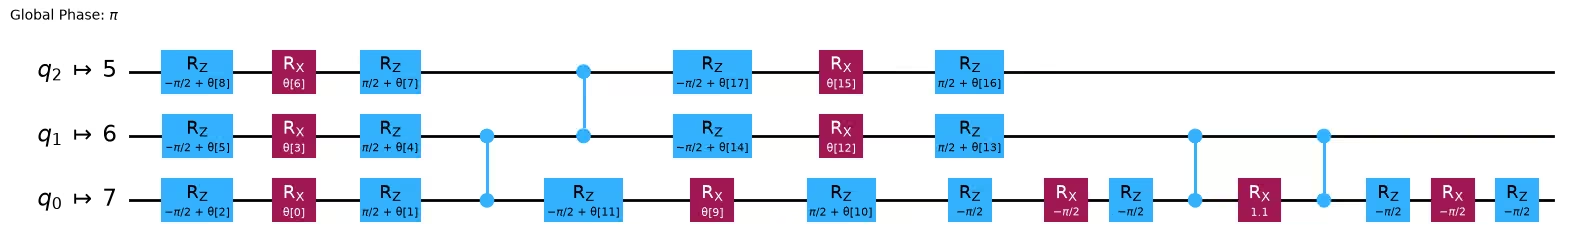
このセクションでは、前のセクションで導入したものと同じCircuitを基にして、分数RXゲートを使ってUゲートを最適化する方法を説明します。 RZZゲートを除外し、分数RXゲートのみを使用してCircuitをトランスパイルします。 以下に示すようにカスタム分解ルールを導入することで、Uゲートの実装に必要な単一Qubitゲートの数を削減できます。
この機能については、現在こちらのGitHubイシューで議論が行われています。
# special decomposition rule for UGate
x = ParameterVector("x", 3)
zxz = QuantumCircuit(1)
zxz.rz(x[2] - np.pi / 2, 0)
zxz.rx(x[0], 0)
zxz.rz(x[1] + np.pi / 2, 0)
DEFAULT_EQUIVALENCE_LIBRARY.add_equivalence(UGate(x[0], x[1], x[2]), zxz)
次に、qiskit-basis-constructorパッケージが提供するconstructor-betaトランスレーションを使用してトランスパイラを適用します。
その結果、前回のトランスパイレーションと比較して、全体的なゲート数が削減されます。
pm_f = generate_preset_pass_manager(
    optimization_level=optimization_level,
    target=target,
    translation_method="constructor-beta",
)
t_qc = pm_f.run(qc)
print(t_qc.count_ops())
t_qc.draw("mpl")
OrderedDict({'rz': 16, 'rx': 9, 'cz': 4})
次のステップ
この内容に興味を持たれた方は、以下の資料にも興味があるかもしれません。
- 分数ゲートガイド
- 分数ゲートを使用すべきでない場合
FoldRzzAngleトランスパイラーパスのAPIリファレンス- 量子カーネルトレーニングチュートリアル
- 量子機械学習コースの量子カーネルレッスン