JIJのSQOA Solverを使って、量子ビット数より多い変数を持つ最大独立集合問題を解く
Qiskit Functionsは実験的な機能であり、IBM Quantum® Premium Plan、Flex Plan、およびOn-Prem(IBM Quantum Platform API経由)Planのユーザーのみが利用できます。プレビューリリースの状態であり、変更される可能性があります。
使用量の目安: Heron r2プロセッサで10秒。(注: これはあくまで目安です。実際の実行時間は異なる場合があります。)
背景
このチュートリアルでは、JIJのQiskit FunctionであるSQOA Solverを使って、選択したQPUの量子ビット数より多くのバイナリ変数を持つ最大独立集合(MIS)問題を解く方法を紹介します。基本的な手順は、Quantum Optimization Benchmarking Library (QOBLIB) [1]からMISのインスタンスを読み込み、qiskit-addon-opt-mapperで二次制約なしバイナリ最適化(QUBO)形式に定式化し、IBM® QPUでの実行のためにSQOA Solverへ送信し、返された解を検証することです。
最大独立集合問題
独立集合とは、グラフのノードの部分集合のうち、選択された2つのノードが辺を共有しないものを指します。最大独立集合(MIS)は、ノード数が可能な限り最大の独立集合です。MISの応用例には、スケジューリング、リソース割り当て、ネットワーク設計などがあります。
MISはNP困難です。全探索では、ノードが1つ増えるごとに検討すべき部分集合の数が2倍になるため、この方法は中程度の大きさのグラフでも現実的ではありません。QOBLIBはMISを10の問題クラスの1つとして含んでおり、実機で量子最適化ワークフローを評価するための有用なベンチマークです。
数学的な定式化
無向グラフ が与えられたとき、各ノード にバイナリ変数 を割り当てます。
-
ノード が選択される場合、 です。
-
otherwise.
バイナリ線形定式化では、選択されるノード数を最大化しつつ、どの辺についても両端点が同時に選択されないようにします。
目的関数は選択されたノードを数えます。辺の制約と合わせて、選択されたノードが独立集合になることが保証されます。
このチュートリアルでは、辺の制約を二次のペナルティに置き換えるQOBLIBのバイナリ制約なし定式化を使用します。
辺の両端点が選択されるたびに、第2項が目的関数から2を引きます。このペナルティにより、競合する選択は、どちらか一方の端点だけを残す場合より不利になります。得られる目的関数はQUBOであり、これはSQOA Solverが受け付ける入力形式です。
なぜSQOA Solverを使うのか
多くの量子最適化アプローチでは、バイナリ変数1つにつき量子ビットを1つ割り当てるため、量子ハードウェアの容量が問題サイズを直接制限する場合があります。SQOA Solverは、この制約を緩和するために、複数の縮約手法とハイブリッド計算手法を組み合わせています。
-
QPUの量子ビット数より多くのバイナリ変数を持つ問題に取り組めます。 プリソルブは、少なくとも1つの最適解を保ちながら、変数を固定し、残りのQUBOを単純化できる縮約ルールを適用します。経験的には、プリソルブによって残りのQUBOがより疎になることもあり、その後のQRACベースのエンコーディングに役立ちます。
次にソルバーは、量子ランダムアクセス最適化(QRAO)[3]に由来するQRACベースのエンコーディングを使い、QUBO上で直接の相互作用を持たない複数(最大3つ)の変数を同じ量子ビット上で表現します。
プリソルブとエンコーディングによる縮約の度合いは、問題の構造に依存します。たとえば、このチュートリアルでは200変数の問題が67量子ビットだけで済みます。
-
ハードウェアノイズの影響を受けにくくなる場合があります。 サンプルベース量子対角化[4]、[5]は、QPUを使ってビット列をサンプリングし、対角化は古典的に実行します。これにより、変分パラメータ更新のためのQPU評価の繰り返しを避けられ、最適化ワークフローに対するノイズの影響を減らせます。
-
プリソルブから後処理までのワークフローを自動化します。 正しい形式のQUBOインスタンスを用意し、バックエンドを選択するだけです。その後、SQOA Solverがワークフロー全体を自動的に実行します。プリソルブの適用、古典変数から緩和された量子問題へのマッピング、サンプリング回路の構築とトランスパイル、量子サンプリングと古典対角化の実行、割り当ての丸めと改良、そして古典解の再構成と評価を行います。
要件
このチュートリアルを始める前に、次のパッケージがインストールされていることを確認してください。
-
Qiskit Functions Catalogクライアント(
pip install qiskit-ibm-catalog)。 -
問題の定式化に使用するQiskit addon optimization mapper(
pip install qiskit-addon-opt-mapper)。 -
グラフの処理とプロットに使用するNetworkXとMatplotlib(
pip install networkx matplotlib)。
Qiskit Functions CatalogのSQOA Solverへのアクセスも必要です。フォームに記入して、この関数へのアクセスを申請してください。
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "networkx": "networkx", "ommx": "ommx", "ommx_quantum_benchmarks": "ommx-quantum-benchmarks", "qiskit_addon_opt_mapper": "qiskit-addon-opt-mapper", "qiskit_ibm_catalog": "qiskit-ibm-catalog"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
# %pip install qiskit-ibm-catalog qiskit-addon-opt-mapper networkx matplotlib
セットアップ
まず、必要なパッケージとツールをインポートします。
import urllib.request

import matplotlib.pyplot as plt
import networkx as nx
from qiskit_addon_opt_mapper import OptimizationProblem
from qiskit_addon_opt_mapper.converters import OptimizationProblemToQubo
from qiskit_ibm_catalog import QiskitFunctionsCatalog
SQOA Solverは、IBM®の最適化関数で使用されるタプル文字列形式の係数辞書として、QUBO問題を受け付けます。OptimizationProblemToQuboが返すQUBOをこの形式に変換するヘルパー関数を定義します。
コンバーターは常に最小化問題を返します。これは、SQOA Solverが辞書形式の問題を扱う方法と一致しています。キーにはQUBOの変数インデックスが使われ、返される解がすべての変数を網羅するように、係数がゼロであってもすべての変数に線形項のエントリが設定されます。
def to_problem_dict(qubo: OptimizationProblem) -> dict[str, float]:
    """Convert a QUBO from OptimizationProblemToQubo to the SQOA Solver dictionary format."""
    objective = qubo.objective
    payload = {"()": objective.constant}
    # Keep every variable in the problem, even with a zero linear coefficient.
    payload.update({f"({i},)": 0.0 for i in range(qubo.get_num_vars())})
    for i, coefficient in objective.linear.to_dict().items():
        payload[f"({i},)"] += coefficient
    for (i, j), coefficient in objective.quadratic.to_dict().items():
        # Fold a binary diagonal term x_i * x_i = x_i into the linear term.
        key = f"({i},)" if i == j else f"({i}, {j})"
        payload[key] = payload.get(key, 0.0) + coefficient
    return {key: float(value) for key, value in payload.items()}
ステップ1: 古典的な入力を量子問題にマッピングする
SQOA Solverは、QUBO問題を受け付け、関数内部で量子マッピングを行います。このチュートリアルでは、QOBLIBからMISのインスタンスをダウンロードし、qiskit-addon-opt-mapperでQUBOとして定式化します。このステップでは、次の内容を扱います。
-
SQOA Solverに接続する。
-
SQOAフレームワークを理解する。
-
問題インスタンスを読み込む。
-
QUBOを定式化し、送信用に変換する。
SQOA Solverに接続する
IBM Quantum Platformの認証情報でQiskit Functions Catalogに接続し、SQOA Solverを読み込みます。次のコードは、すでにアカウントを保存してローカル環境に設定してあることを前提としています。
接続に失敗した場合は、IBM Quantum Platformのアカウント管理者が、選択したサービスインスタンスにSQOA Solverへのアクセスを許可していることを確認してください。
catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")
solver = catalog.load("jij/sqoa-solver")
SQOAフレームワークを理解する
量子緩和を用いたサンプリングベース量子最適化アルゴリズム(SQOA-QR)[2]は、量子ランダムアクセス最適化(QRAO)とサンプルベース量子対角化を組み合わせたものです。
-
量子緩和とエンコーディング: SQOA Solverは、QUBOを (ただし )の形の最小化イジング目的関数に変換します。次にQRAO [3]が、各スピン変数をパウリ観測量にマッピングします。ここで使用する -QRACエンコーディングでは、緩和されたハミルトニアンは次のとおりです。
ここで は恒等演算子、 は変数 を1つの量子ビットと 、、 のいずれか1つに割り当て、 は と同じ量子ビットにマッピングされる変数の数です。関連する2つの量子ビットがどちらも3つの変数を含む場合、線形項と二次項のスケーリング係数はそれぞれ と になります。
量子ビットを共有する変数には、互いに非可換な異なるパウリ観測量が割り当てられます。QUBOで相互作用する変数は異なる量子ビットに置かれ、QUBO上で直接の相互作用がない変数は同じ量子ビットを共有できます。したがって、量子ビット数の削減量は問題の構造に依存します。
-
量子サンプリング: 量子プロセッサが、緩和されたハミルトニアンの低エネルギー状態を探索するように設計された回路からビット列をサンプリングします。
-
サンプルベース対角化: ソルバーは、緩和されたハミルトニアンを、サンプリングされたビット列から得られる基底状態が張る部分空間に射影し、射影されたハミルトニアンを古典的に対角化します [4]、[5]。サンプリングされたビット列の集合を固定したとき、 個の異なる基底状態が張る部分空間を とすると、 です。その推定基底状態エネルギーは次のとおりです。
ここで は、緩和されたハミルトニアン全体の基底状態エネルギーです。したがって、保持する部分空間を大きくしても、推定基底状態エネルギーが増加することはありません。
この順序関係は、同じサンプリング結果を前提とし、丸め前の緩和されたハミルトニアンのエネルギーに関するものです。返される古典解がより良くなることを理論的に保証するものではありません。ただし、QRAOでは、エネルギーが低い状態のほうが、より良い古典解を与えると経験則的に期待されます。
-
丸め: 対角化で得られた緩和状態を、古典的なバイナリの割り当てに変換します。
SQOA Solverは、このフレームワークを古典的な処理で挟み込んでいます。量子マッピングの前に、プリソルブが、少なくとも1つの最適解を保ちながら、変数を固定し、残りのQUBOを単純化できる縮約ルールを適用します。対角化と丸めの後には、古典的な局所探索が割り当てを改良し、OMMXが完全な解を再構成して評価します。
インスタンスを読み込む
QOBLIBは、各MISインスタンスをDIMACSの.gph形式のグラフとして配布しています。これは行ベースの形式で、pで始まる行がノード数と辺の数を示し、eで始まる各行が1本の辺を定義します。
QOBLIBは、各インスタンスについて最適解または既知の最良解も公開しています。次の関数は、QOBLIBリポジトリからその両方をダウンロードします。DIMACSではノードのラベルが1から始まるため、グラフは0から始まるようにラベルを付け直します。
代わりに独自のグラフから始めたい場合は、ダウンロードを省略し、NetworkXのグラフから同じ方法で問題を定式化してください。
QOBLIB_URL = "https://raw.githubusercontent.com/ZIB-AOPT/QOBLIB/refs/heads/main/07-independentset"

def fetch_qoblib_graph(name: str) -> nx.Graph:
    """Download a QOBLIB independent-set instance as a NetworkX graph."""
    with urllib.request.urlopen(
        f"{QOBLIB_URL}/instances/{name}.gph"
    ) as response:
        lines = response.read().decode().splitlines()
    graph = nx.Graph()
    for fields in map(str.split, lines):
        if fields and fields[0] == "p":
            # Header: p edge <number of nodes> <number of edges>
            graph.add_nodes_from(range(int(fields[2])))
        elif fields and fields[0] == "e":
            # DIMACS labels nodes from 1; relabel them to start from 0.
            graph.add_edge(int(fields[1]) - 1, int(fields[2]) - 1)
    return graph

def fetch_reference_objective(name: str) -> float:
    """Read the objective value of the QOBLIB reference solution."""
    with urllib.request.urlopen(
        f"{QOBLIB_URL}/solutions/{name}.opt.sol"
    ) as response:
        for line in response.read().decode().splitlines():
            if line.startswith("# Objective value"):
                return float(line.split("=")[1])
    raise ValueError(f"No objective value found for {name}.")

INSTANCE_NAME = "gen200_p0-9_44"
G = fetch_qoblib_graph(INSTANCE_NAME)
reference_objective = fetch_reference_objective(INSTANCE_NAME)
参照解の目的関数値は、後ほどSQOA Solverの結果を評価するために使用します。このチュートリアルでは、156量子ビットのデバイスでこの問題を解きます。
print(
    f"{INSTANCE_NAME}: {G.number_of_nodes()} nodes, {G.number_of_edges()} edges"
)
print(f"Reference objective: {reference_objective:g}")
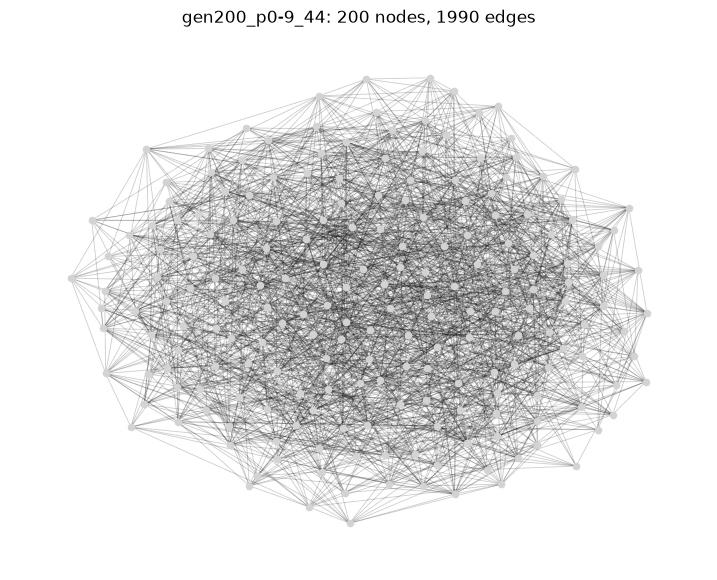
gen200_p0-9_44: 200 nodes, 1990 edges
Reference objective: 44
グラフを可視化します。後ほど、SQOA Solverが返したノードが独立集合を成していることを確認するためにも使用します。
layout = nx.forceatlas2_layout(
    G, max_iter=500, scaling_ratio=3.0, gravity=1.0, seed=7
)
node_size = max(8, min(60, 4000 / max(G.number_of_nodes(), 1)))

fig, ax = plt.subplots(figsize=(9, 7))
nx.draw_networkx_edges(G, layout, ax=ax, alpha=0.2, width=0.6)
nx.draw_networkx_nodes(
    G, layout, node_size=node_size, node_color="lightgray", ax=ax
)
ax.set_title(
    f"{INSTANCE_NAME}: {G.number_of_nodes()} nodes, {G.number_of_edges()} edges"
)
ax.set_axis_off()
plt.show()
QUBOを定式化する
背景のセクションにあるバイナリ線形定式化を、ノードごとに1つのバイナリ変数、選択されたノードを数える目的関数、辺ごとに1つの制約を持つOptimizationProblemとして構築します。次に、OptimizationProblemToQuboで変換します。
ペナルティの重みを2にすると、コンバーターは各辺の制約をペナルティ項 に置き換え、最大化を最小化に変えます。そのため、変換後の問題は、QOBLIBのバイナリ制約なし定式化の符号を反転したものになります。QUBOの変数インデックスはグラフのノードのラベルです。qiskit_addon_opt_mapper.applicationsのIndependentSetアプリケーションクラスは、IndependentSet(G).to_optimization_problem()によって同じ制約付きモデルを構築します。
最後に、to_problem_dict()でQUBOを辞書形式に変換します。この問題はバイナリQUBOなので、ステップ2のリクエストでは変数の定義域を"binary"として宣言します。この関数は、送信後にプリソルブ、量子マッピング、回路構築を実行します。
mis = OptimizationProblem(INSTANCE_NAME)
mis.binary_var_list(G.number_of_nodes(), name="x")
mis.maximize(linear={v: 1 for v in G.nodes})
for u, v in G.edges:
    mis.linear_constraint({u: 1, v: 1}, "<=", 1)

converter = OptimizationProblemToQubo(penalty=2)
qubo = converter.convert(mis)
problem_dict = to_problem_dict(qubo)

print(f"QUBO variables: {qubo.get_num_vars()}")
print(f"Dictionary entries: {len(problem_dict)}")
QUBO variables: 200
Dictionary entries: 2191
ステップ2: 量子ハードウェアでの実行向けに問題を最適化する
SQOA Solverは、関数内部で量子マッピングとハードウェアの準備を行います。まずQUBOにプリソルブを適用し、次にQRACベースのエンコーディングを使って、残りの変数を緩和されたハミルトニアンにマッピングします。
量子サンプリングのために、緩和されたハミルトニアンに基づく回路を構築し、選択したバックエンド向けにトランスパイルします。プリソルブとエンコーディングによる問題サイズと量子ビット数の削減量は問題に依存するため、固定の削減率を仮定せずにソルバーを設定してください。
ソルバーの入力を設定する
SQOA Solverには2つの入力が必要です。
-
problem: ステップ1で作成した辞書。 -
variable_type: このQUBOでは"binary"です。
2つのオプション入力も受け付けます。
-
backend_nameはQPUを選択します。省略した場合やNoneの場合、関数は、お使いのインスタンスからアクセス可能な稼働中のQPUのうち、最も空いているものを選択します。 -
optionsは、サンプリング予算(shots)、古典的なシード(seed)、セッションの使用(session)、古典的な局所探索(postprocessing_level)、ジョブタグ(job_tags)を制御する辞書です。shotsを増やすと、サンプリングの統計が改善する場合があります。
すべての入力、そのデフォルト値、および検証ルールについては、APIリファレンスを参照してください。
このチュートリアルでは、バックエンドを明示的に指定し、shots、session、postprocessing_levelにはデフォルト値を使用し、古典的なシードを設定します。ステップ3でsolver.run()に渡せるように、入力を辞書にまとめます。
# ibm_fez has 156 qubits
backend_name = (
    "ibm_fez"  # Omit this key or pass None for automatic selection.
)

sqoa_input = {
    "problem": problem_dict,
    "variable_type": "binary",
    "backend_name": backend_name,
}
sqoa_input["options"] = {
    "shots": 4096,
    "seed": 42,
    "session": False,
    "postprocessing_level": 1,
}
ステップ3: プリミティブを使用して実行する
ステップ1で作成したSQOA Solverの接続を使って、ジョブを送信します。この関数は、選択したバックエンド上でIBM Quantum Samplerプリミティブを実行し、測定されたビット列を収集して、古典的な対角化と後処理を続けます。操作する対象は単一の関数ジョブです。
job = solver.run(**sqoa_input)
print(f"Job ID: {job.job_id}")
Job ID: dcee8e26-b8ac-4dd7-a76e-5adb5bc388e5
ワークロードのステータスを確認するには、ジョブのステータスを確認するを参照してください。内部的には、この関数はマッピング、ハードウェア最適化、キュー待ち、QPU実行、後処理の各フェーズを順に進みます。
job.status()
'INITIALIZING'
job.result()は、ジョブが完了するまでブロックし、解、その目的関数値と実行可能性、そしてソルバー情報とリソース使用量を保持するメタデータを含む辞書を返します。入力と出力の完全な定義については、APIリファレンスを参照してください。
result = job.result()
ステップ4: 結果を後処理し、古典的な形式に変換する
関数の出力全体を確認し、返された割り当てをグラフに対応付け直し、選択されたノードを検証して、結果を可視化します。
結果を確認する
結果の辞書には、4つのトップレベルのフィールドが含まれています。
-
solutionは、x_iをキーとする完全な変数の割り当てです。ここで i は変数のインデックスです(例:x_17)。このチュートリアルでは、変数のインデックスがノードのラベルです。 -
objective_valueは、その割り当てを、送信した辞書、つまり最小化QUBO上で評価した目的関数値です。 -
feasibleは、辞書に制約がないため、変数の定義域のみを対象とします。 -
metadataにはsolver_infoとresource_usageが含まれます。solver_infoには、実行時に実際に使われたseedが記録されます。古典的な局所探索が実行された場合、solver_infoには、その改良前の丸められた割り当てもsolution_before_postprocessingに記録されます。
solver_info = result["metadata"]["solver_info"]

print(f"Result fields: {list(result)}")
print(f"Solution entries: {len(result['solution'])}")
print(f"First entries: {dict(list(result['solution'].items())[:3])}")
print(f"Objective value: {result['objective_value']}")
print(f"Feasible: {result['feasible']}")
print(f"Solver-info fields: {list(solver_info)}")
print(f"Effective seed: {solver_info['seed']}")
print(f"Resource-usage phases: {list(result['metadata']['resource_usage'])}")
Result fields: ['solution', 'objective_value', 'feasible', 'metadata']
Solution entries: 200
First entries: {'x_0': 0.0, 'x_1': 0.0, 'x_2': 1.0}
Objective value: -35.0
Feasible: True
Solver-info fields: ['seed', 'solution_before_postprocessing']
Effective seed: 42
Resource-usage phases: ['RUNNING: MAPPING', 'RUNNING: OPTIMIZING_FOR_HARDWARE', 'RUNNING: WAITING_FOR_QPU', 'RUNNING: EXECUTING_QPU', 'RUNNING: POST_PROCESSING']
解をグラフに対応付ける
返された値を変数インデックスの順に集め、interpret()で元の問題の変数に対応付け直します。選択されたノードは値が1の変数であり、is_feasible()は、割り当てが元の問題の辺の制約を満たしているかを確認します。
x_qubo = [result["solution"][f"x_{i}"] for i in range(qubo.get_num_vars())]
x = converter.interpret(x_qubo)
selected_nodes = [node for node, value in enumerate(x) if value > 0.5]

print(f"Selected nodes: {len(selected_nodes)}")
print(f"Satisfies every edge constraint: {mis.is_feasible(x)}")
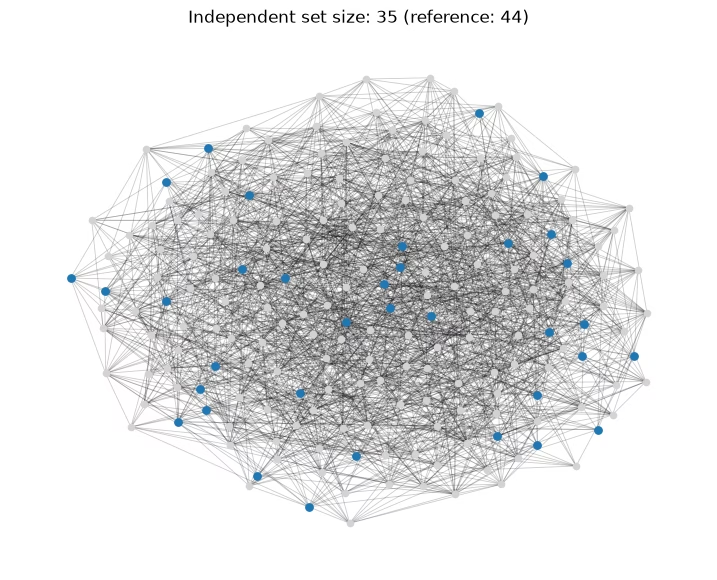
Selected nodes: 35
Satisfies every edge constraint: True
後処理前の解と比較する
postprocessing_levelが1であるため、solver_infoには、古典的な局所探索の前に丸められた割り当てもsolution_before_postprocessingに記録されます。キーはsolutionと同じです。
これをQUBO上で評価すると、改良によって結果がどれだけ向上したかがわかります。どちらの値も送信した最小化QUBOの目的関数値なので、値が低いほど良好です。局所探索が実行されない場合(たとえば、プリソルブがすべての変数を固定した場合)、このフィールドは省略されます。
before = solver_info.get("solution_before_postprocessing")
if before is None:
    print("The classical local search did not run for this problem.")
else:
    x_before = [before[f"x_{i}"] for i in range(qubo.get_num_vars())]
    changed = sum(
        before[key] != value for key, value in result["solution"].items()
    )
    print(
        f"Objective before local search: {qubo.objective.evaluate(x_before)}"
    )
    print(f"Objective after local search: {result['objective_value']}")
    print(f"Variables changed by local search: {changed}")
Objective before local search: -12.0
Objective after local search: -35.0
Variables changed by local search: 19
独立性の制約を検証する
QUBOは隣接関係を明示的な制約ではなくペナルティ項で表現するため、ヒューリスティックな結果が隣接するノードを選択してしまうことがあります。返されたノードをグラフと直接照合して確認してください。以降のセクションでの比較と可視化のために、返された集合をコピーし、検出された各競合の一方の端点を貪欲法で取り除きます。
returned_set = set(selected_nodes)
conflicts = [
    (u, v) for u, v in G.edges if u in returned_set and v in returned_set
]
print(f"Conflicting edges in the returned set: {len(conflicts)}")

independent_set = returned_set.copy()
for u, v in conflicts:
    if u in independent_set and v in independent_set:
        # Drop the endpoint that has more selected neighbors.
        drop = max(
            (u, v),
            key=lambda node: sum(nb in independent_set for nb in G[node]),
        )
        independent_set.remove(drop)

assert all(
    not (u in independent_set and v in independent_set) for u, v in G.edges
)
print(f"Independent set size after repair: {len(independent_set)}")
Conflicting edges in the returned set: 0
Independent set size after repair: 35
参照解と比較する
ステップ1で、QOBLIBの参照解の目的関数値をダウンロードしました。QOBLIBの参照解は、最適解または既知の最良解のいずれかです。そのため、常に最適性が証明されているとは仮定せずに、参照の目的関数値と比較してください。
この最大化問題では、比率が1.0であれば、修復後の結果が参照の目的関数値と一致することを意味します。
ratio_to_reference = len(independent_set) / reference_objective

print(f"Reference objective: {reference_objective:g}")
print(f"Ratio to reference: {ratio_to_reference:.3f}")
Reference objective: 44
Ratio to reference: 0.795
結果を可視化する
修復後の独立集合を強調表示して、グラフをもう一度プロットします。強調表示されたノードのうち、どの2つも辺を共有しません。
fig, ax = plt.subplots(figsize=(9, 7))
nx.draw_networkx_edges(G, layout, ax=ax, alpha=0.2, width=0.6)
nx.draw_networkx_nodes(
    G,
    layout,
    nodelist=[v for v in G if v not in independent_set],
    node_size=node_size,
    node_color="lightgray",
    ax=ax,
)
nx.draw_networkx_nodes(
    G,
    layout,
    nodelist=sorted(independent_set),
    node_size=node_size * 1.4,
    node_color="tab:blue",
    ax=ax,
)
ax.set_title(
    f"Independent set size: {len(independent_set)} "
    f"(reference: {reference_objective:g})"
)
ax.set_axis_off()
plt.show()
リソース使用量を読み取る
結果のメタデータは、RUNNING: EXECUTING_QPU以外のフェーズについて、利用可能な場合にCPU_TIMEを報告します。RUNNING: EXECUTING_QPUフェーズでは、すべてのQuantum Computeジョブについて最終的な使用量が利用可能であれば、Quantum Computeが返すQPU使用量であるQPU_TIMEを報告できます。
usage = result["metadata"]["resource_usage"]

for phase, metrics in usage.items():
    line = f"{phase:36s}"
    if "CPU_TIME" in metrics:
        line += f" CPU {metrics['CPU_TIME']:8.1f} s"
    if "QPU_TIME" in metrics:
        line += f" QPU {metrics['QPU_TIME']:8.1f} s"
    print(line)
RUNNING: MAPPING                     CPU     11.8 s
RUNNING: OPTIMIZING_FOR_HARDWARE     CPU     15.4 s
RUNNING: WAITING_FOR_QPU             CPU     16.5 s
RUNNING: EXECUTING_QPU               QPU      3.0 s
RUNNING: POST_PROCESSING             CPU     55.8 s
まとめ
このチュートリアルでは、QOBLIBからMISのインスタンスをダウンロードし、qiskit-addon-opt-mapperでQUBOとして定式化し、SQOA Solverに接続し、ワークロードを設定して送信し、返された割り当てをグラフに対応付け直して、選択されたノードを元のグラフと照合して確認しました。
また、結果をQOBLIBの参照解と比較し、古典的な後処理の寄与を調べ、各実行フェーズのリソース使用量を確認しました。
SQOA Solverは、プリソルブ、QRACベースのエンコーディングを用いたQRAO、サンプリング回路の構築、ハードウェアを考慮したトランスパイル、サンプルベース対角化、丸め、古典的な改良を組み合わせています。このワークフローでは、変数1つにつき量子ビット1つのエンコーディングで可能な数よりも多くのバイナリ変数をマッピングできます。プリソルブとエンコーディングによる削減量は問題の構造に依存し、解の品質は得られたサンプルに依存します。
shotsとpostprocessing_levelの設定は、送信ワークフローを変えることなく、それぞれ量子サンプリングの予算と古典的な改良を制御します。
付録: 問題をOMMXインスタンスとして送信する
SQOA Solverは、OMMX SDKのommx.v1.Instanceも受け付けます。OMMX Quantum Benchmarksパッケージは、QOBLIBの問題を参照解とともにOMMXインスタンスとして配布しているため、自分で定式化しなくても同じQUBOを読み込めます。
OMMXを入力にした場合、objective_valueはインスタンスの意味で評価され、結果には正規のommx.v1.Solutionも含まれます。OMMX SDKも一緒にインストールされるパッケージをインストールします。
# %pip install ommx-quantum-benchmarks
同じインスタンスのbinary_unconstrainedモデルを読み込みます。データセットローダーは進捗メッセージを出力するため、コードではそれらをキャプチャして出力をコンパクトに保ちます。
%%capture
from ommx_quantum_benchmarks.qoblib import IndependentSet

ommx_instance, _ = IndependentSet()("binary_unconstrained", INSTANCE_NAME)
SQOA Solverは、OMMXインスタンスを標準のパディング付きBase64文字列として受け取り、正規の解を同じ形式で返します。この変換のために、2つのヘルパー関数を定義します。
-
to_problem_payload()は、ommx.v1.Instanceを、problemとして渡す文字列にシリアライズします。 -
to_ommx_solution()は、結果から正規のommx.v1.Solutionをデコードします。
import base64

from ommx.v1 import Instance, Solution

def to_problem_payload(instance: Instance) -> str:
    """Serialize an OMMX instance into the `problem` string for SQOA Solver."""
    return base64.b64encode(instance.to_bytes()).decode()

def to_ommx_solution(result: dict) -> Solution:
    """Decode the canonical OMMX solution from a SQOA Solver result."""
    payload = result["metadata"]["solver_info"]["ommx_solution"]
    return Solution.from_bytes(base64.b64decode(payload, validate=True))
problemのみを置き換え、それ以外は先ほどと同じ入力でインスタンスを送信します。その後、正規の解をデコードし、選択されたノードを変数名で読み取ります。
ommx_job = solver.run(
    **{**sqoa_input, "problem": to_problem_payload(ommx_instance)}
)
ommx_result = ommx_job.result()

ommx_solution = to_ommx_solution(ommx_result)
x_values = ommx_solution.extract_decision_variables("x")
ommx_nodes = sorted(
    node for (node,), value in x_values.items() if value > 0.5
)

print(f"Objective value: {ommx_result['objective_value']}")
print(f"Selected nodes: {len(ommx_nodes)}")
Objective value: 35.0
Selected nodes: 35
次のステップ
- このワークフローをご自身のQUBO問題に適用してみましょう。SQOA Solverガイドに示されているように、
OptimizationProblemを構築します。変換と送信の手順は同じですが、検証は問題の構造に合わせて調整してください。 - 付録に示されているように、問題をOMMXインスタンスとして送信します。受け付けられる問題形式と返されるフィールドについては、APIリファレンスを参照してください。
- QOBLIBリポジトリやOMMX Quantum Benchmarksで、他の独立集合のインスタンスを探索してみましょう。
- qiskit-addon-opt-mapperやJijModelingによるモデリング、およびOMMXによる問題の交換について、さらに学びましょう。
参考文献
[1] Koch, T., Bernal Neira, D. E., Chen, Y., Cortiana, G., Egger, D. J., Heese, R., Hegade, N. N., Gomez Cadavid, A., Huang, R., Itoko, T., et al. (2026). Quantum optimization benchmarking library: The intractable decathlon. Nature Computational Science, 6, 653–671. DOI, arXiv:2504.03832
[2] Matsuyama, H., & Yamashiro, Y. (2025). Sampling-based quantum optimization algorithm with quantum relaxation. 2025 IEEE International Conference on Quantum Computing and Engineering (QCE), 1, 2323–2333. DOI, arXiv:2504.12629
[3] Fuller, B., Hadfield, C., Glick, J. R., Imamichi, T., Itoko, T., Thompson, R. J., Jiao, Y., Kagele, M. M., Blom-Schieber, A. W., Raymond, R., et al. (2024). Approximate solutions of combinatorial problems via quantum relaxations. IEEE Transactions on Quantum Engineering, 5, 1–15. DOI, arXiv:2111.03167
[4] Kanno, K., Kohda, M., Imai, R., Koh, S., Mitarai, K., Mizukami, W., & Nakagawa, Y. O. (2026). Quantum-selected configuration interaction: Classical diagonalization of Hamiltonians in subspaces selected by quantum computers. Physical Review Research, 8(2), 023268. DOI, arXiv:2302.11320
[5] Robledo-Moreno, J., Motta, M., Haas, H., Javadi-Abhari, A., Jurcevic, P., Kirby, W., et al. (2025). Chemistry beyond the scale of exact diagonalization on a quantum-centric supercomputer. Science Advances, 11(25), eadu9991. DOI, arXiv:2405.05068