化学ハミルトニアンのエネルギー推定への SQD の適用
このレッスンでは、SQD を適用して分子の基底状態エネルギーを推定します。
具体的には、 ステップの Qiskit パターンアプローチを用いて、以下のトピックを扱います。
-
ステップ 1: 問題を量子回路と演算子にマッピングする
-
の分子ハミルトニアンを設定する。
-
化学にインスパイアされたハードウェアフレンドリーな局所ユニタリークラスター Jastrow(LUCJ)[1] を説明する。
-
-
ステップ 2: ターゲットハードウェア向けに最適化する
- ハードウェア実行に向けてアンザッツのゲート数とレイアウトを最適化する。
-
ステップ 3: ターゲットハードウェアで実行する
- 最適化した回路を実際の QPU で実行し、部分空間のサンプルを生成する。
-
ステップ 4: 結果を後処理する
-
自己無撞着コンフィギュレーション回復ループ [2] を導入する。
-
粒子数の事前知識と最新のイテレーションで計算された平均軌道占有率を使って、ビットストリングサンプル全体を後処理する。
-
回復されたビットストリングから確率的にサブサンプルのバッチを作成する。
-
各サンプリングされた部分空間上で分子ハミルトニアンを射影し対角化する。
-
全バッチにわたって見つかった最小基底状態エネルギーを保存し、平均軌道占有率を更新する。
-
-
このレッスンでは、以下のソフトウェアパッケージを使用します。
PySCF:分子の定義とハミルトニアンの設定。ffsim:LUCJ アンザッツの構築。Qiskit:ハードウェア実行向けのアンザッツのトランスパイル。Qiskit IBM Runtime:QPU での回路実行とサンプル収集。Qiskit addon SQD:コンフィギュレーション回復と、部分空間射影・行列対角化を用いた基底状態エネルギー推定。
1. 問題を量子回路と演算子にマッピングする
分子ハミルトニアン
分子ハミルトニアンは、一般的に次の形をとります。
/ は、 番目の基底関数と スピン に対応するフェルミオン生成/消滅演算子です。 と は、一体および二体の電子積分です。PySCF を使って分子を定義し、基底関数 6-31g のハミルトニアンの一体・二体積分を計算します。
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"ffsim": "ffsim", "matplotlib": "matplotlib", "numpy": "numpy", "pyscf": "pyscf", "qiskit": "qiskit", "qiskit_addon_sqd": "qiskit-addon-sqd", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import warnings
import pyscf
import pyscf.cc
import pyscf.mcscf

warnings.filterwarnings("ignore")

# Specify molecule properties
open_shell = False
spin_sq = 0

# Build N2 molecule
mol = pyscf.gto.Mole()
mol.build(
    atom=[["N", (0, 0, 0)], ["N", (1.0, 0, 0)]],  # Two N atoms 1 angstrom apart
    basis="6-31g",
    symmetry="Dooh",
)

# Define active space
n_frozen = 2
active_space = range(n_frozen, mol.nao_nr())

# Get molecular integrals
scf = pyscf.scf.RHF(mol).run()
num_orbitals = len(active_space)
n_electrons = int(sum(scf.mo_occ[active_space]))
num_elec_a = (n_electrons + mol.spin) // 2
num_elec_b = (n_electrons - mol.spin) // 2
cas = pyscf.mcscf.CASCI(scf, num_orbitals, (num_elec_a, num_elec_b))
mo = cas.sort_mo(active_space, base=0)
hcore, nuclear_repulsion_energy = cas.get_h1cas(mo)  # hcore: one-body integrals
eri = pyscf.ao2mo.restore(1, cas.get_h2cas(mo), num_orbitals)  # eri: two-body integrals

# Compute exact energy for comparison
exact_energy = cas.run().e_tot
converged SCF energy = -108.835236570774
CASCI E = -109.046671778080  E(CI) = -32.8155692383188  S^2 = 0.0000000
このレッスンでは、Jordan-Wigner(JW)変換を用いてフェルミオンの波動関数を量子ビットの波動関数にマッピングし、量子回路を使って準備できるようにします。JW変換は、M個の空間軌道にあるフェルミオンのFock空間を2M個の量子ビットのヒルベルト空間にマッピングします。つまり、1つの空間軌道は2つの_スピン軌道_に分割され、一方はスピンアップ()電子に、もう一方はスピンダウン()電子に関連付けられます。スピン軌道は占有または非占有のいずれかです。通常、軌道の数と言う場合、_空間_軌道の数を指します。スピン軌道の数はその2倍になります。量子回路では、各スピン軌道を1つの量子ビットで表現します。したがって、ある量子ビットの集合はスピンアップまたは -軌道を表し、別の集合はスピンダウンまたは -軌道を表します。例えば、6-31g 基底関数系を用いた 分子には 個の空間軌道があります(つまり + = スピン軌道)。したがって、量子ビットの量子回路が必要になります(後述するように追加の補助量子ビットが必要になる場合があります)。量子ビットは計算基底で測定され、ビット列が生成されます。これは電子配置または(Slater)行列式を表します。このレッスン全体を通して、ビット列・配置・行列式という用語を互換的に使用します。ビット列は、スピン軌道における電子の占有状況を教えてくれます:ビット位置のは対応するスピン軌道が占有されていることを意味し、はそのスピン軌道が空であることを意味します。電子構造問題は粒子数を保存するため、一定数のスピン軌道のみが占有されている必要があります。 分子には 個のスピンアップ()電子と 個のスピンダウン()電子があります。したがって、 分子について 軌道と 軌道を表すビット列は、それぞれ5個の を持つ必要があります。
1.1 サンプル生成のための量子回路:LUCJ アンザッツ
このレッスンでは、量子状態の準備とその後のサンプリングに、局所ユニタリー結合クラスターJastrow(LUCJ)\[1\] アンザッツを使用します。まず、完全なUCJアンザッツを構成する様々な構成要素と、その局所版で行われる近似について説明します。次に、ffsimパッケージを使用してLUCJアンザッツを構築し、ハードウェア実行のためにQiskitトランスパイラーを使って最適化します。
UCJ アンザッツは次の形をとります(UCJ 演算子の 層または繰り返しの積として)。
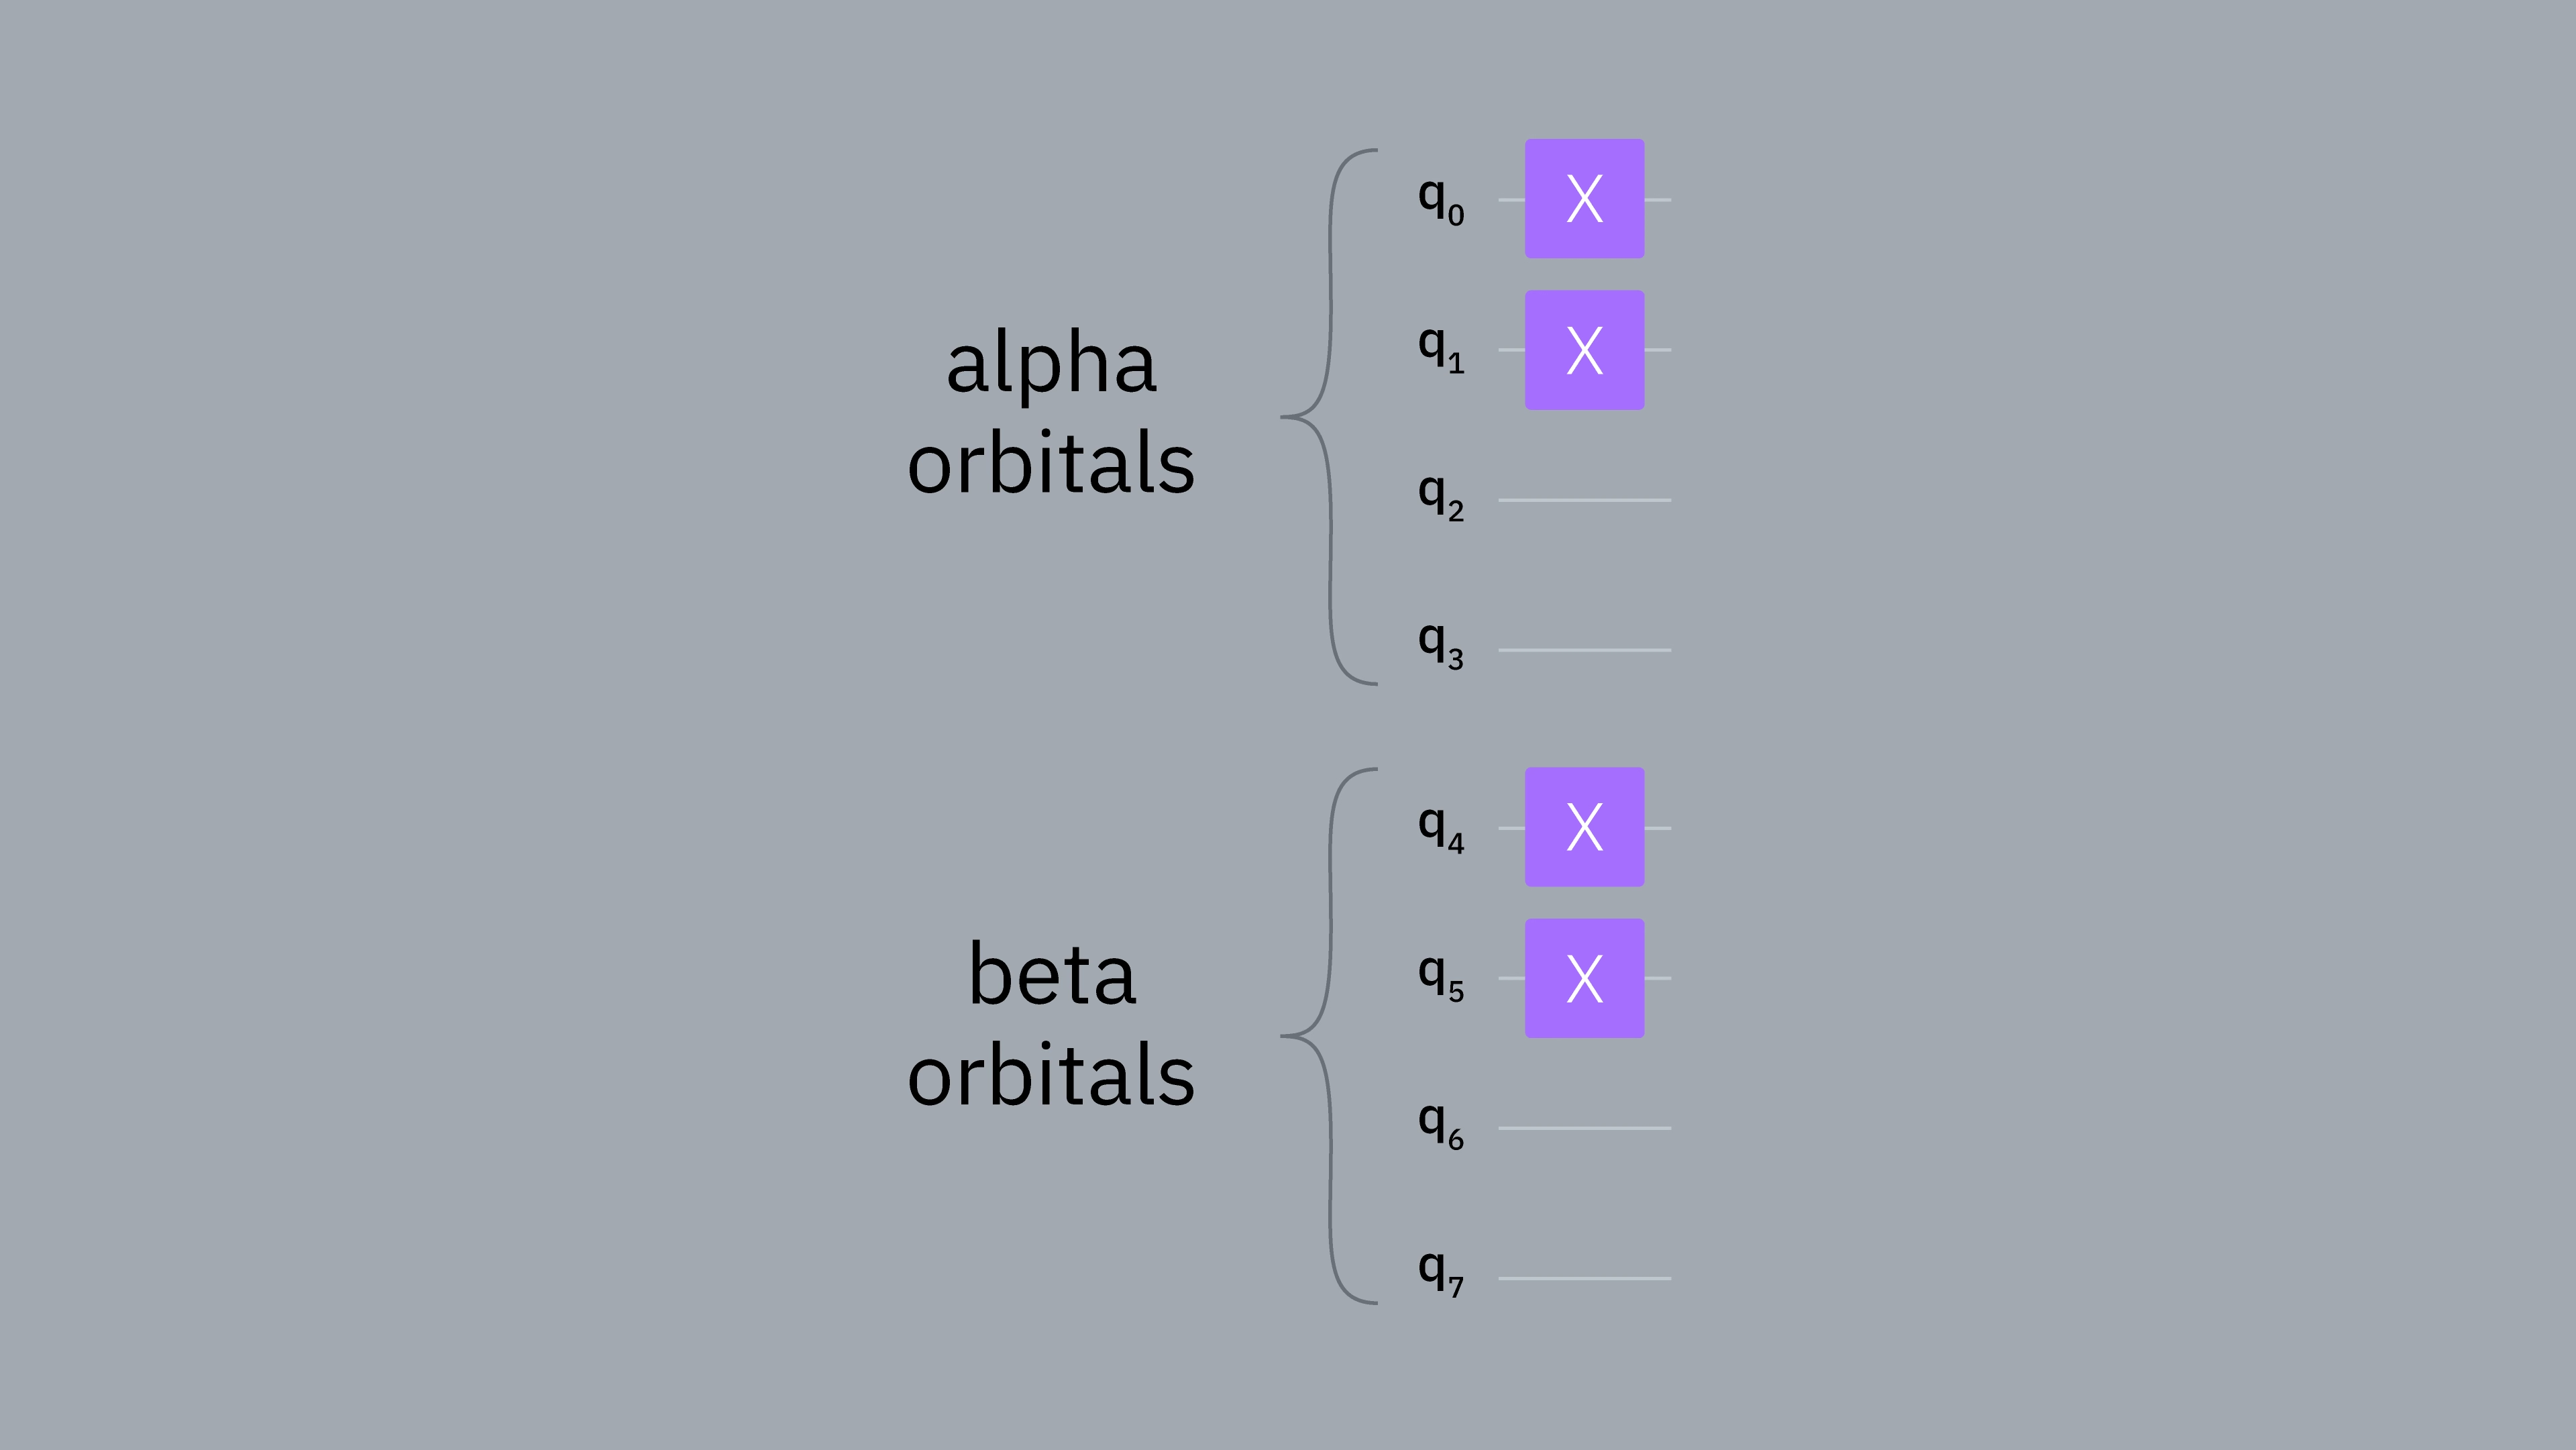
ここで、 は参照状態であり、通常はハートリー-フォック(HF)状態が使われます。ハートリー-フォック状態は最低番号の軌道が占有されていると定義されているため、HF 状態の準備には、占有軌道に対応する量子ビットを 1 に設定するための X ゲートを適用します。例えば、4 つの空間軌道と、スピンアップ電子 2 個・スピンダウン電子 2 個に対する HF 状態準備ブロックは次のようになります。
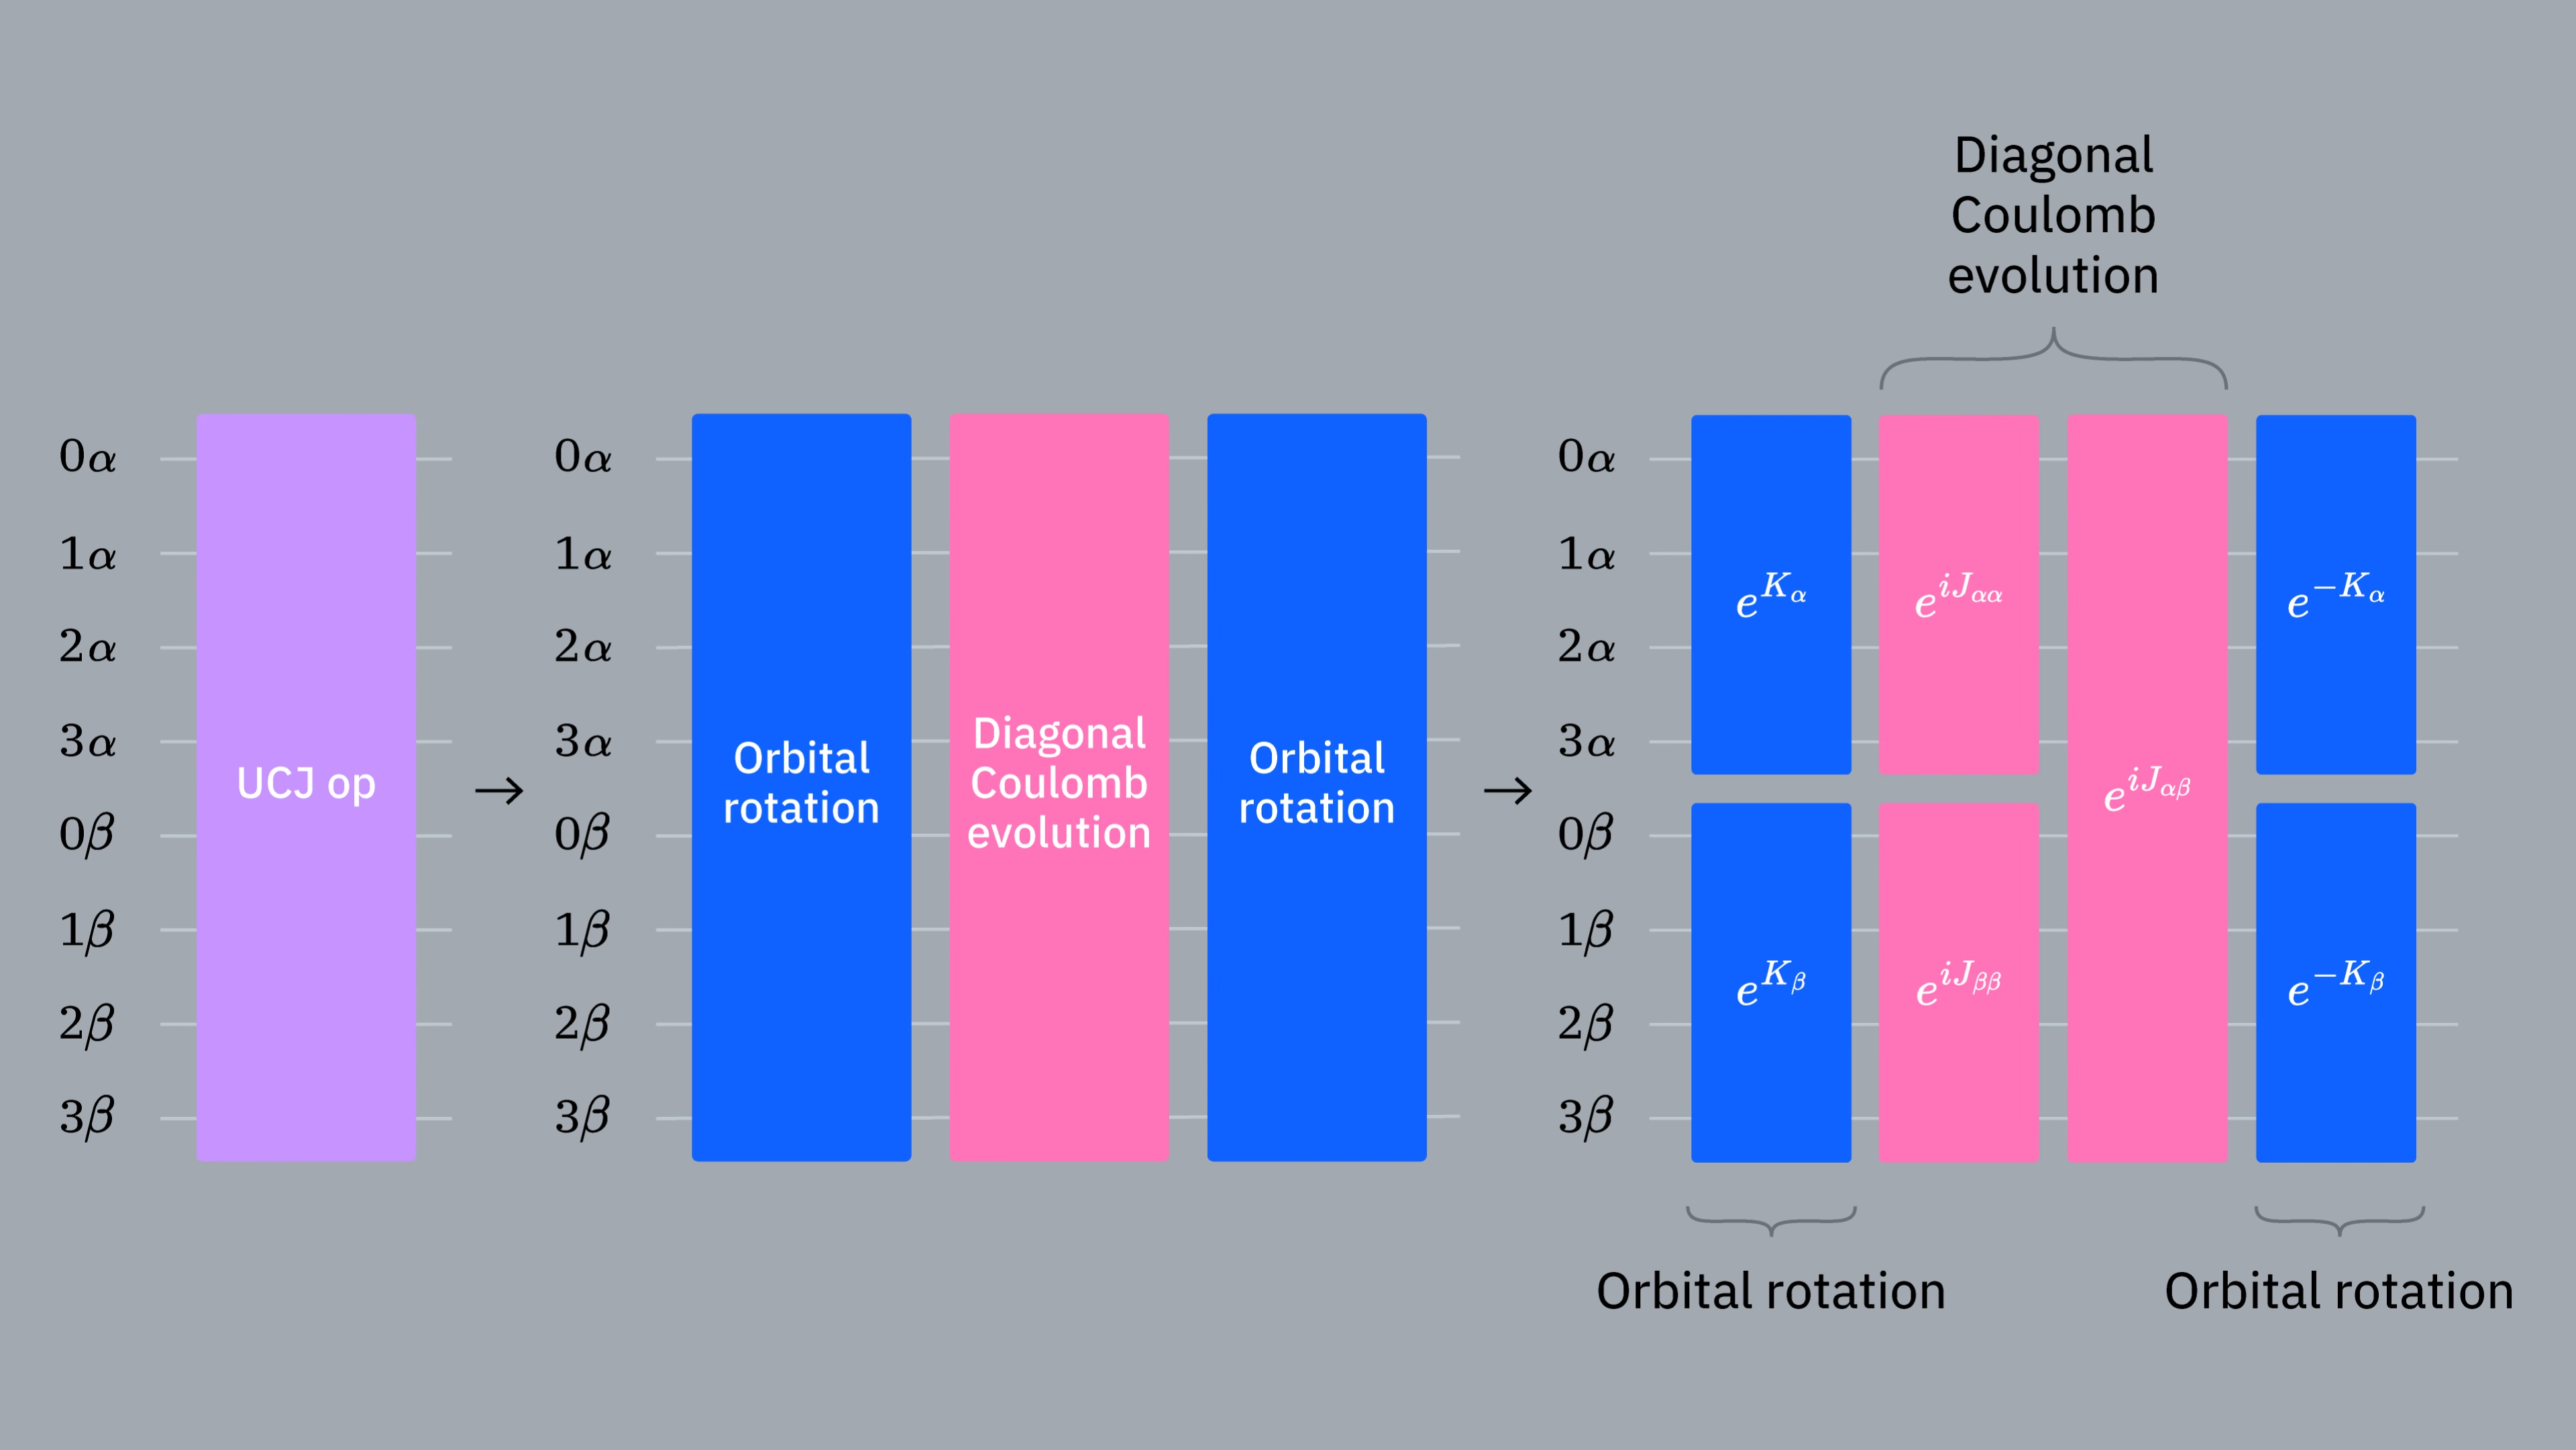
 UCJ 演算子 の1回の繰り返しは、軌道回転( と )によって挟まれた対角クーロン発展()から構成されます。
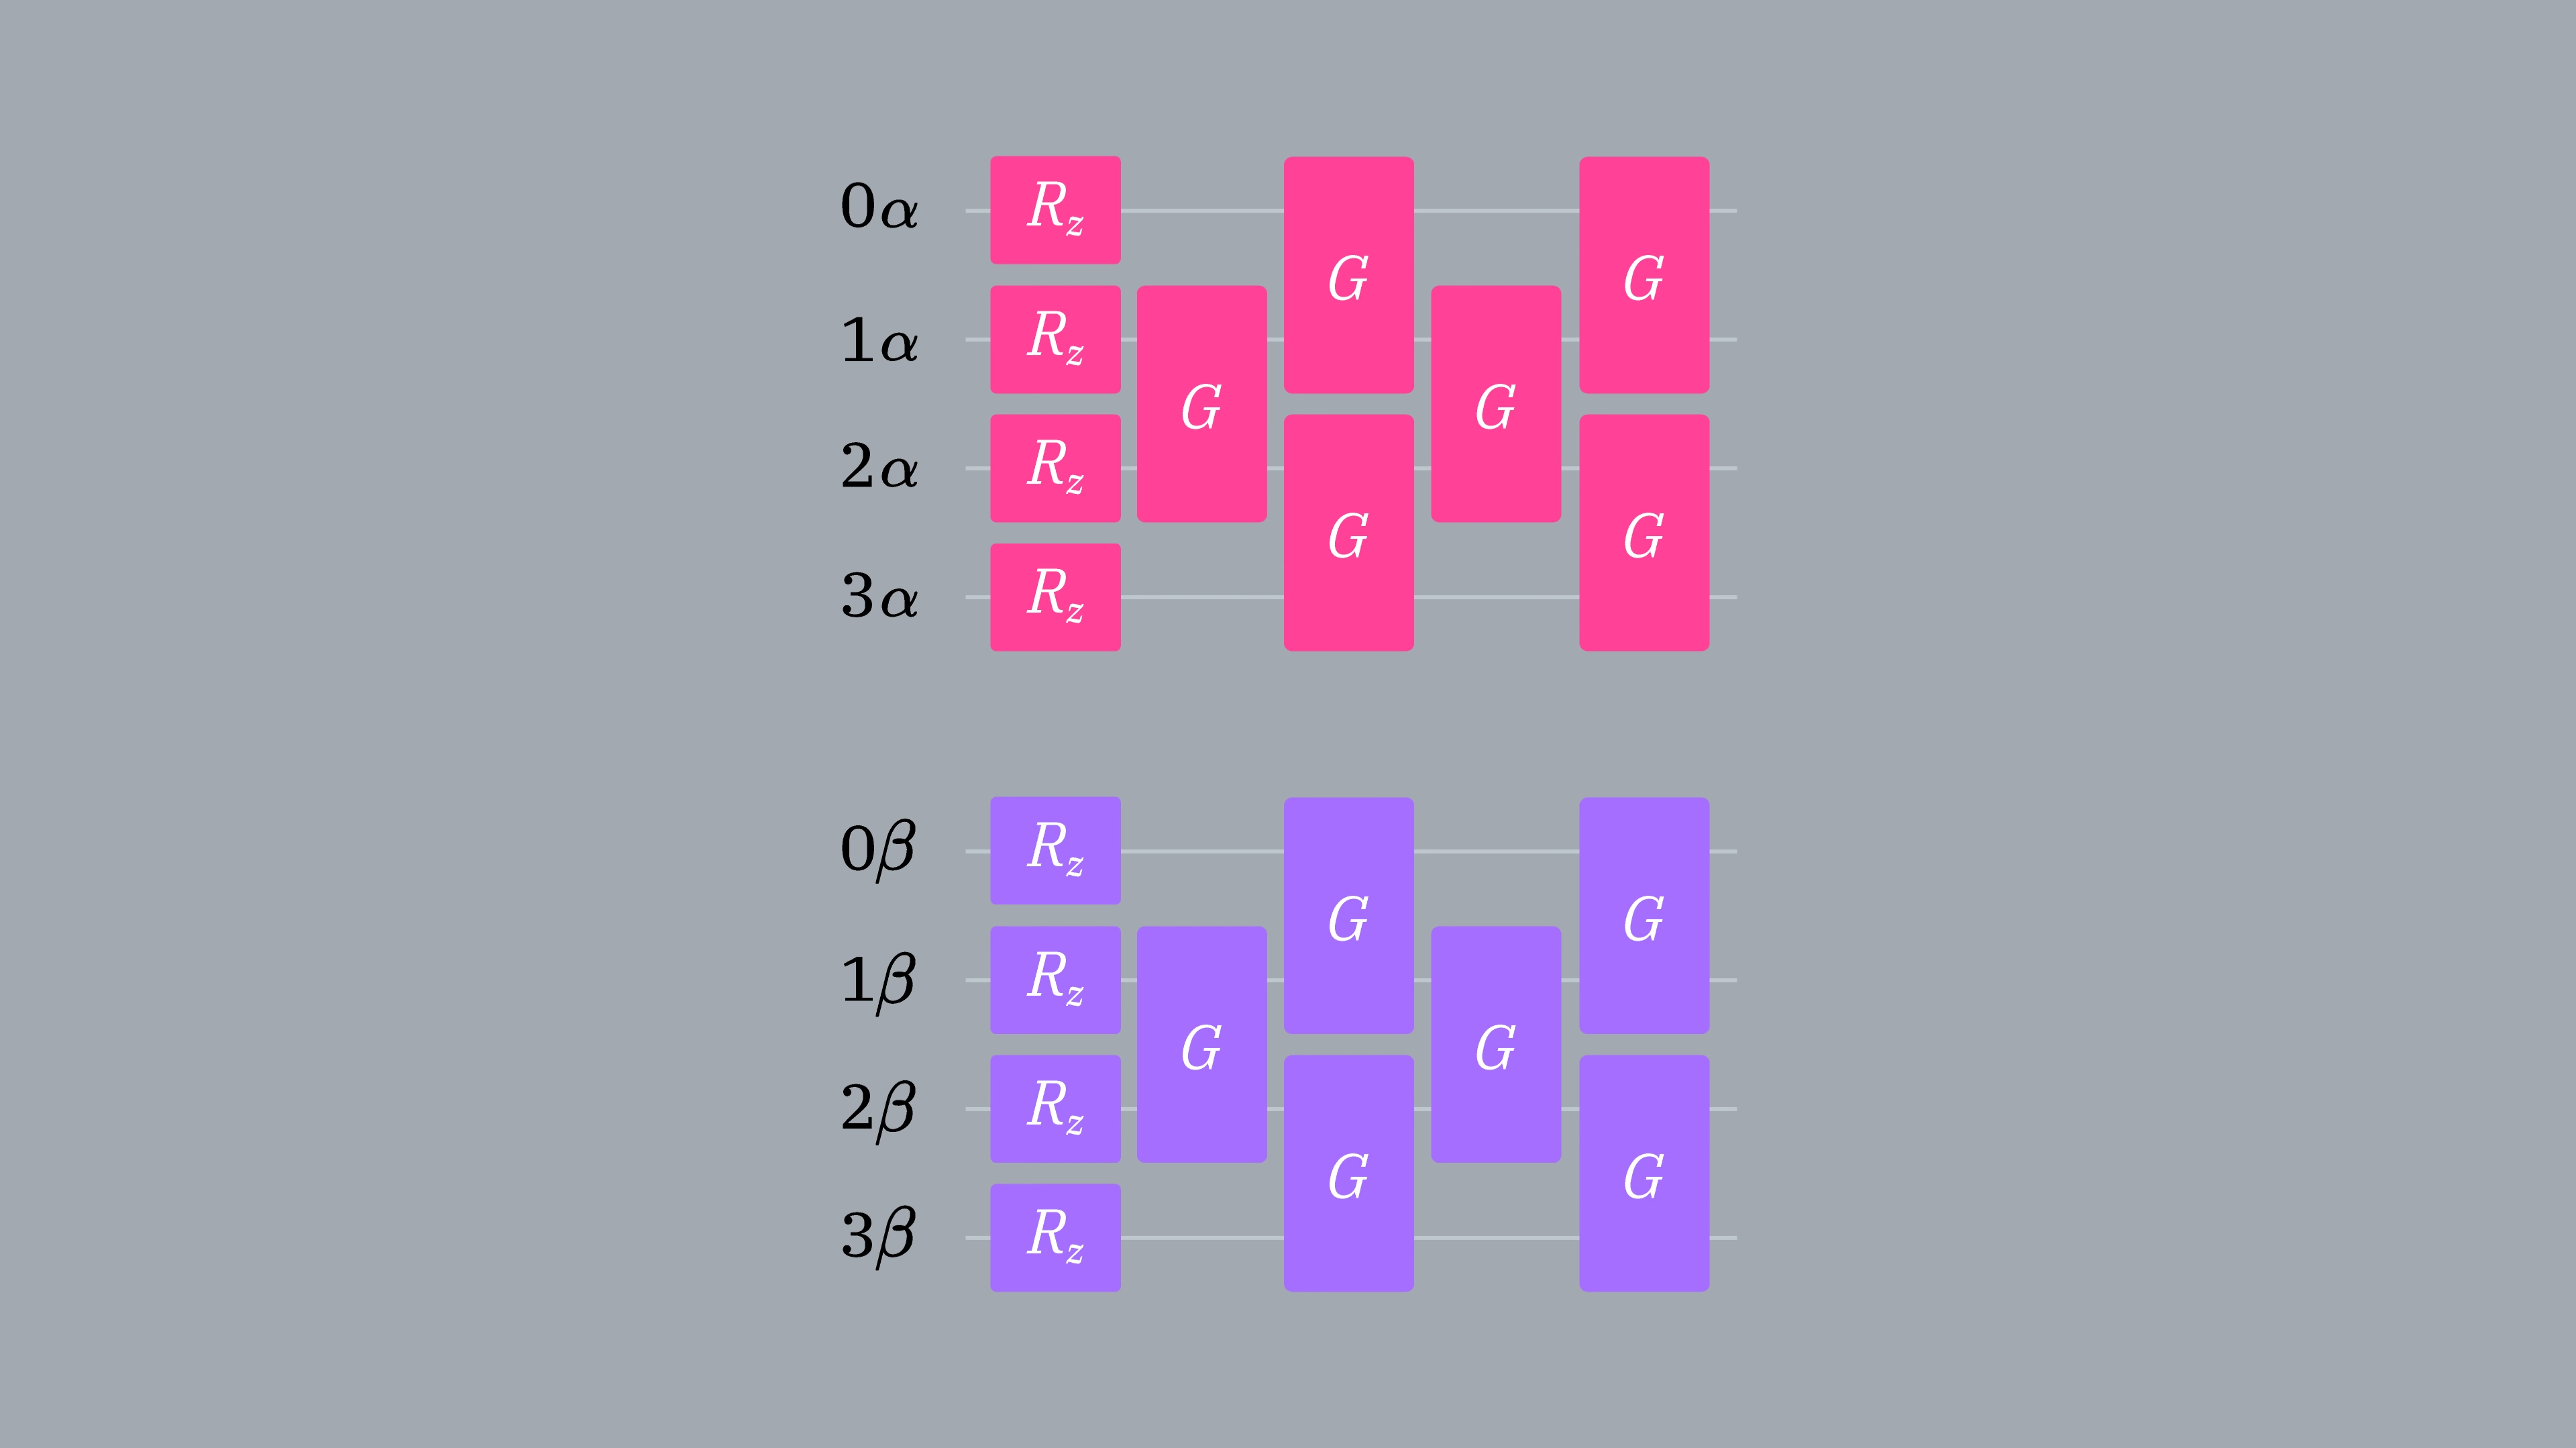
 軌道回転ブロックは単一スピン種((スピンアップ)/(スピンダウン))に作用します。各電子種に対して、軌道回転は単一量子ビット ゲートの層の後に、2量子ビットの Givens 回転ゲート( ゲート)の列から構成されます。
2量子ビットゲートは隣接するスピン軌道(最近接量子ビット)に作用するため、IBM® QPU 上で SWAP ゲートなしに実装できます。
 (対角クーロン演算子とも呼ばれます)は3つのブロックで構成されます。そのうち2つは同じスピンセクター( と )に作用し、1つは2つのスピンセクター間()に作用します。
の全ブロックは、数-数ゲート [1] から構成されます。 ゲートは、 ゲートと、それに続く2つの独立した量子ビットに作用する2つの単一量子ビット ゲートにさらに分解できます。
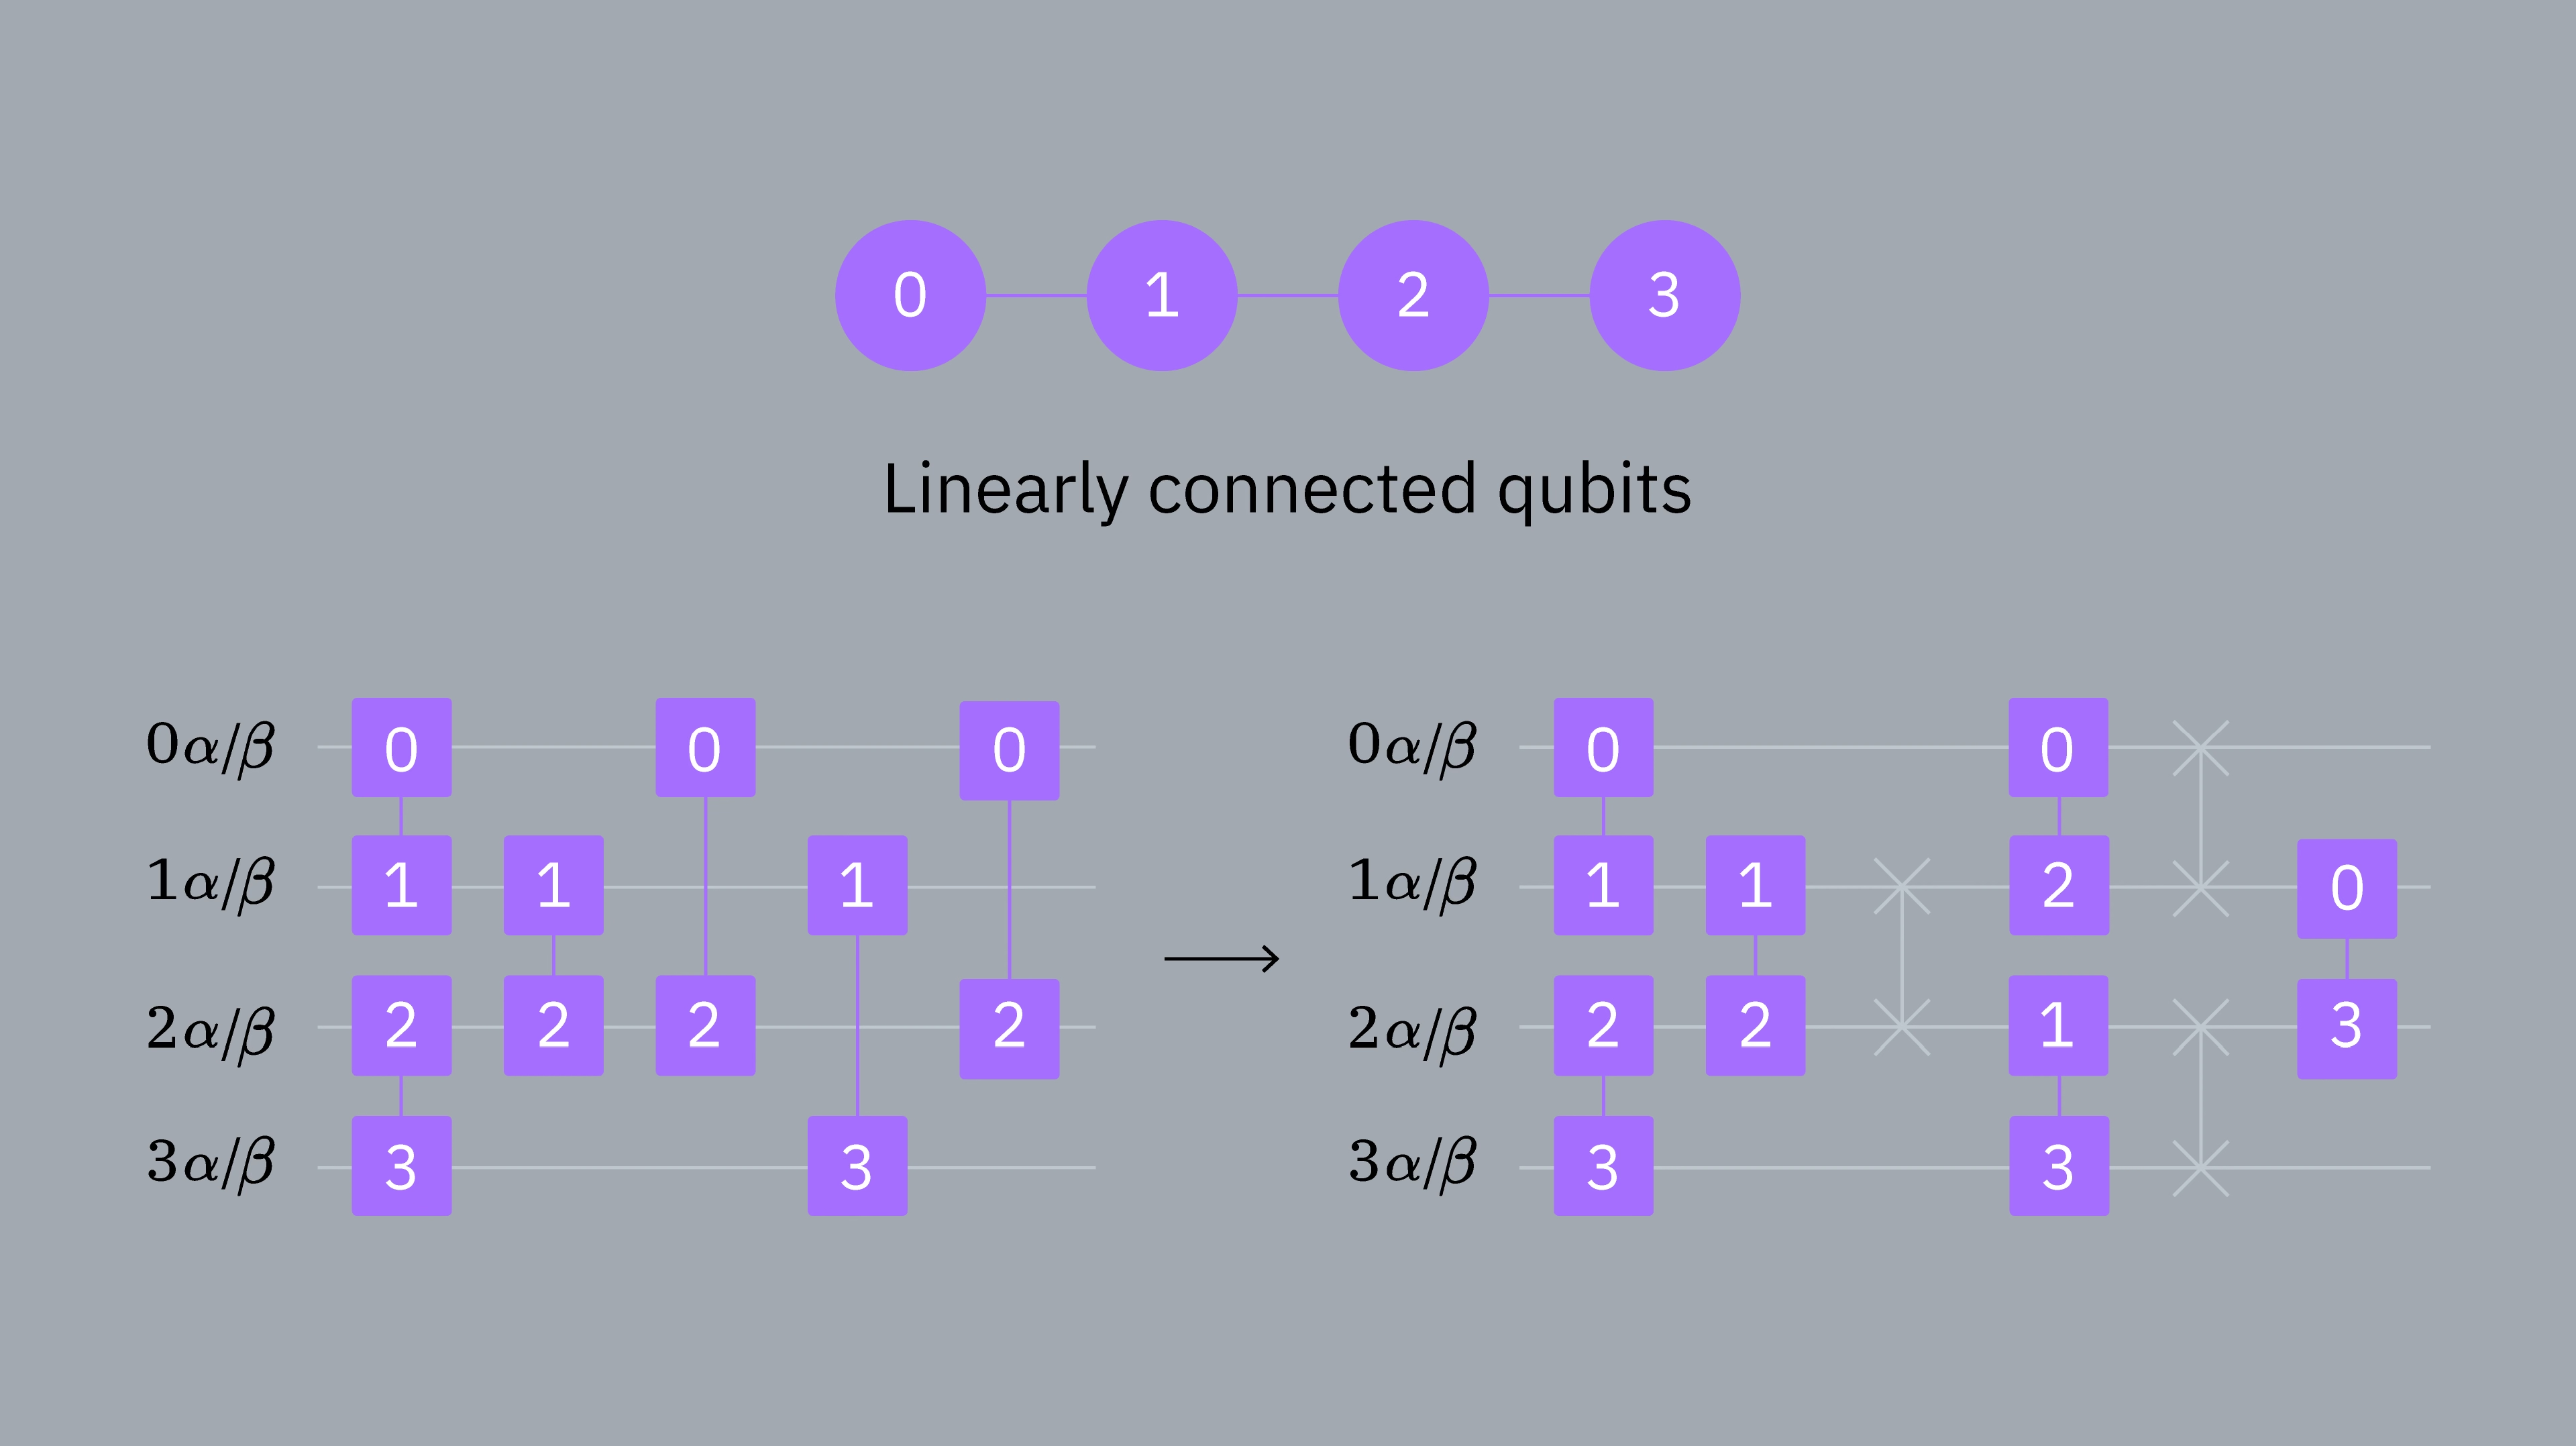
同一スピン成分( と )は、すべての量子ビットペア間に ゲートを持ちます。しかし、超伝導 QPU は接続性に制約があるため、非隣接量子ビット間のゲートを実現するには量子ビットをスワップする必要があります。
例えば、 空間軌道の場合の (または )ブロックを考えてみましょう。線形量子ビット接続では、最後の3つのゲートは非隣接量子ビット間(例えば Q0 と Q2 は直接接続されていない)に作用するため直接実装できません。そのため、それらを隣接させるには SWAP ゲートが必要です(次の図は 個の SWAP ゲートを使った例を示しています)。
 次に、 は異なるスピンセクターの同じインデックスの軌道間(例えば と )にゲートを実装します。同様に、量子ビットが QPU 上で物理的に隣接していない場合、これらのゲートも SWAP を必要とします。
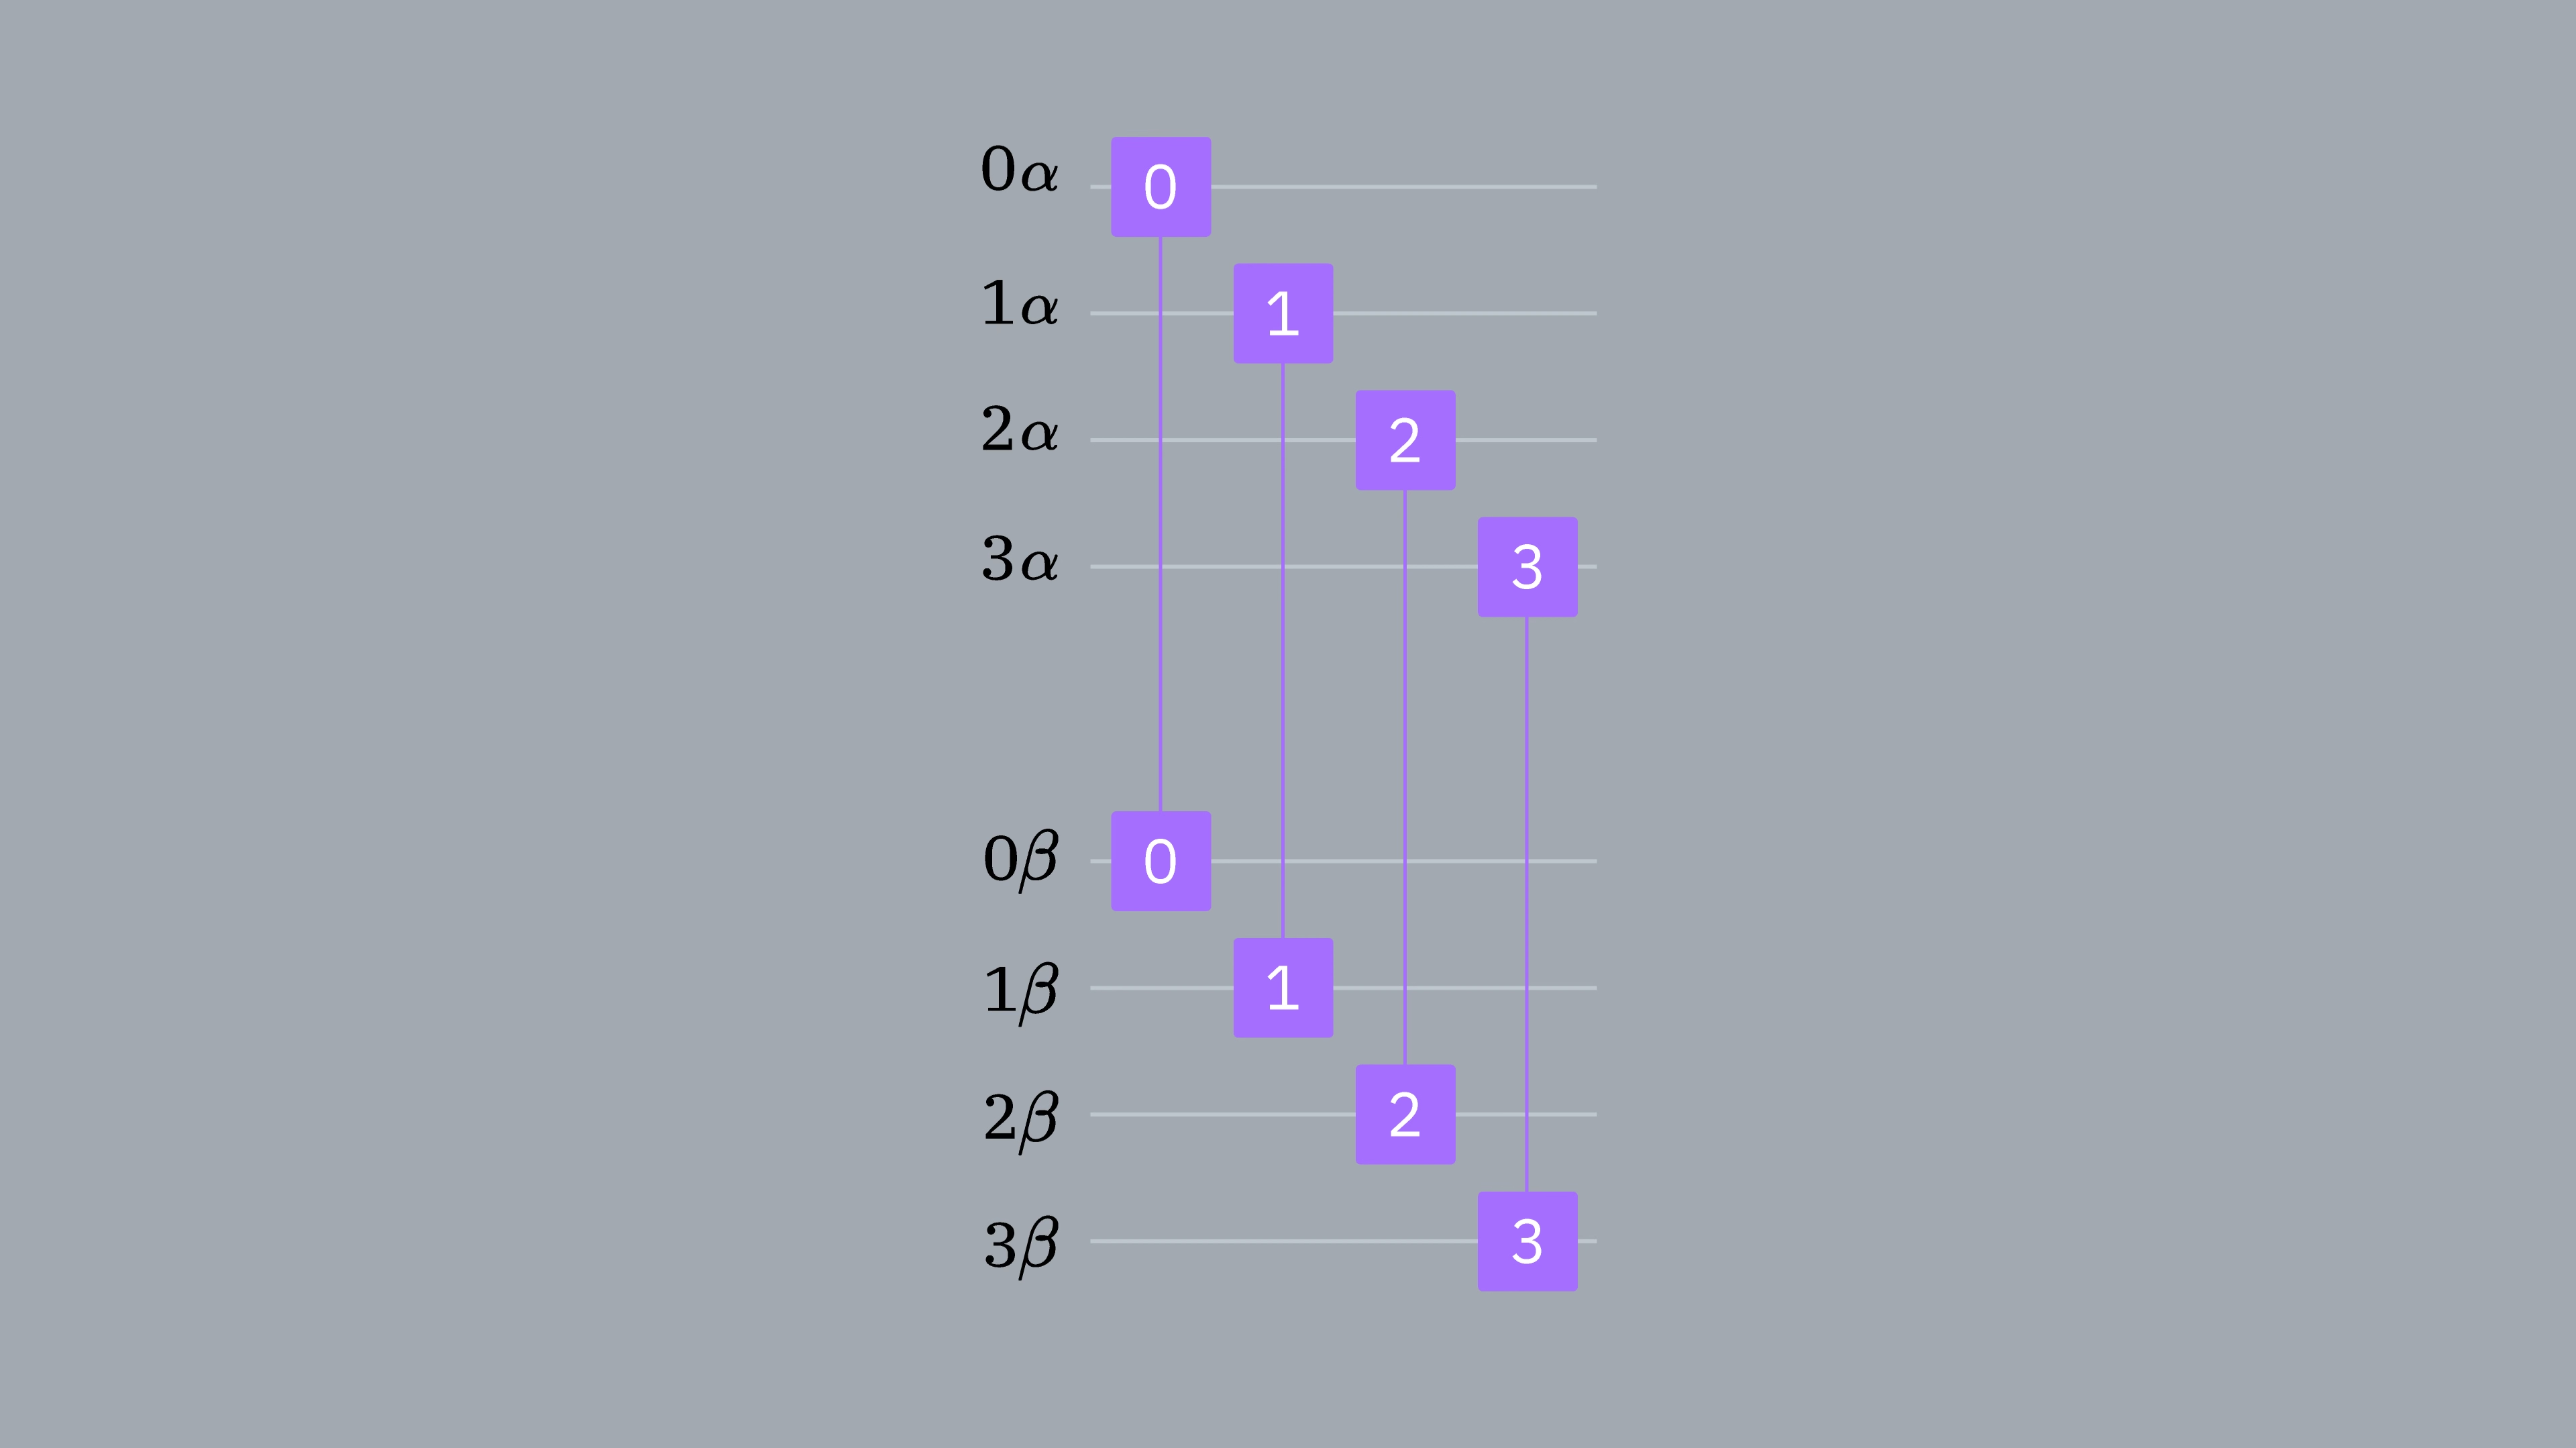 上記の議論から、UCJ アンザッツは非隣接量子ビットの相互作用のために SWAP ゲートが必要であるため、ハードウェア実行にはいくつかの障壁があります。UCJ アンザッツの局所版である LUCJ は、対角クーロン演算子からいくつかの を除去することでこの課題に対処しています。
同一電子種ブロック( と )では、LUCJ 版では最近接接続と互換性のある ゲートのみを保持し、非隣接量子ビット間のゲートを除去します。次の図は、非隣接ゲートを除去した後の LUCJ ブロックを示しています。
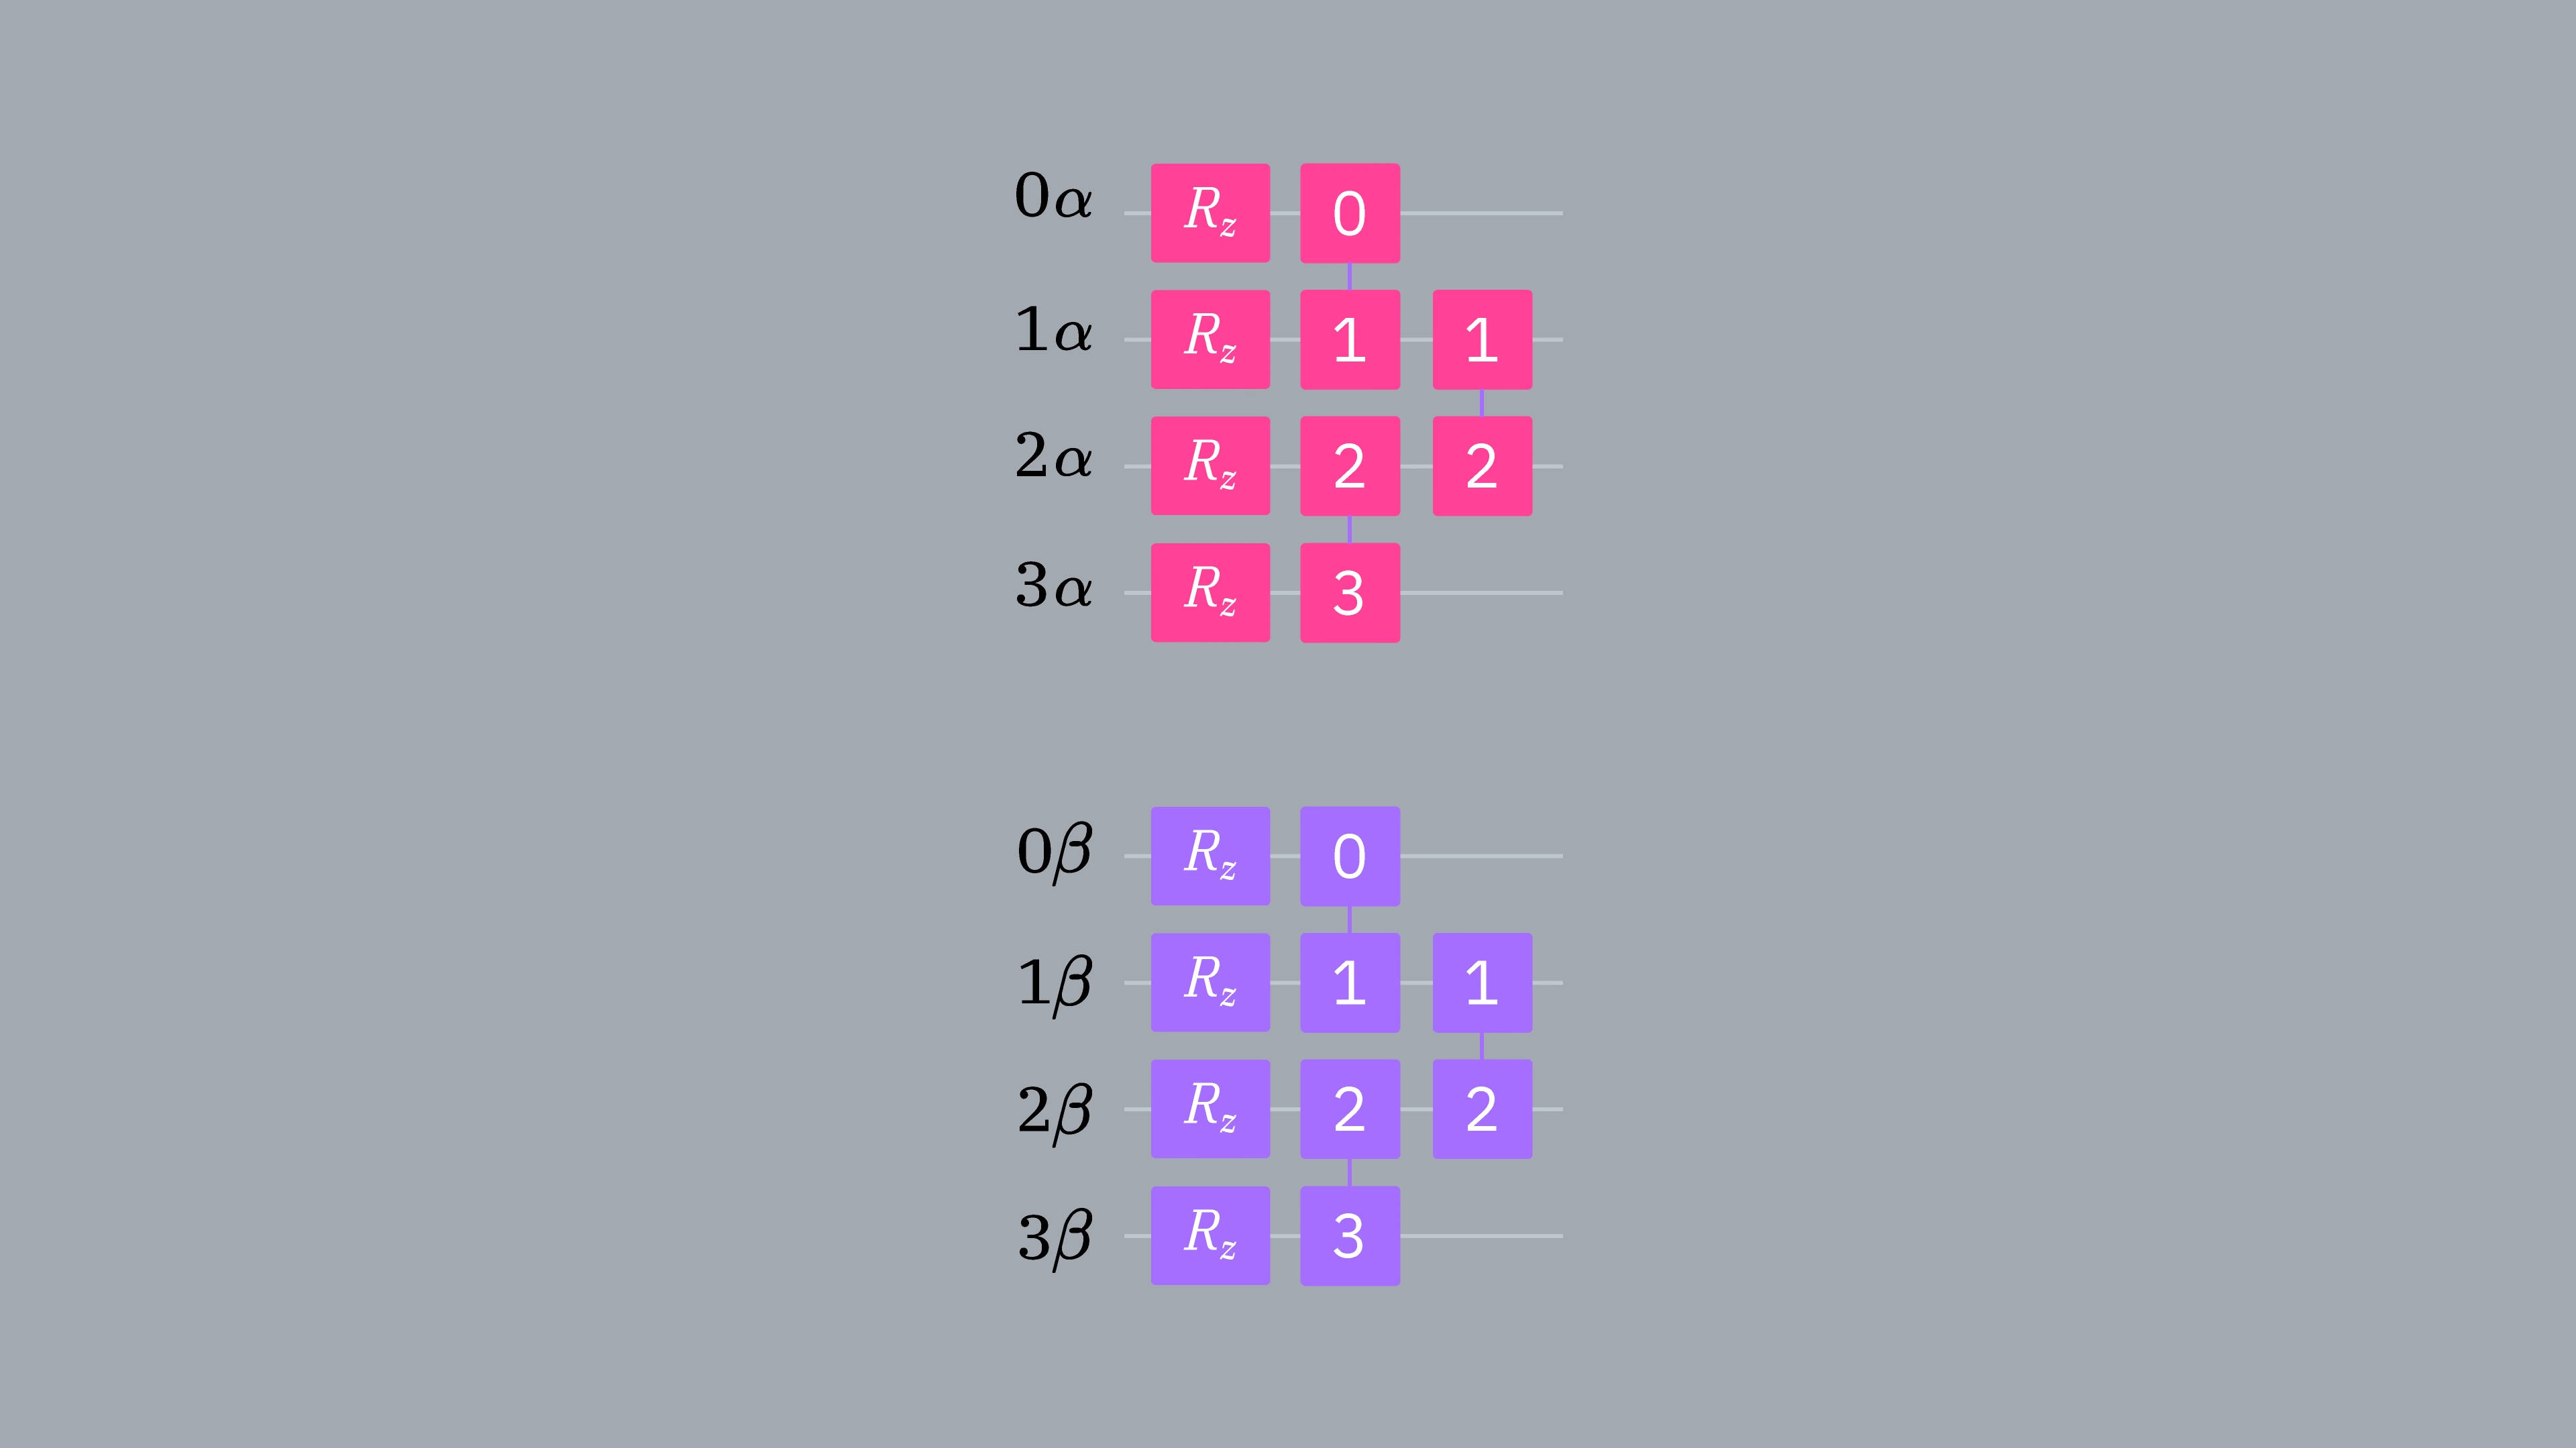 次に、異なる電子種間に作用する ブロックの LUCJ 版は、デバイストポロジーに基づいて異なる形をとることができます。
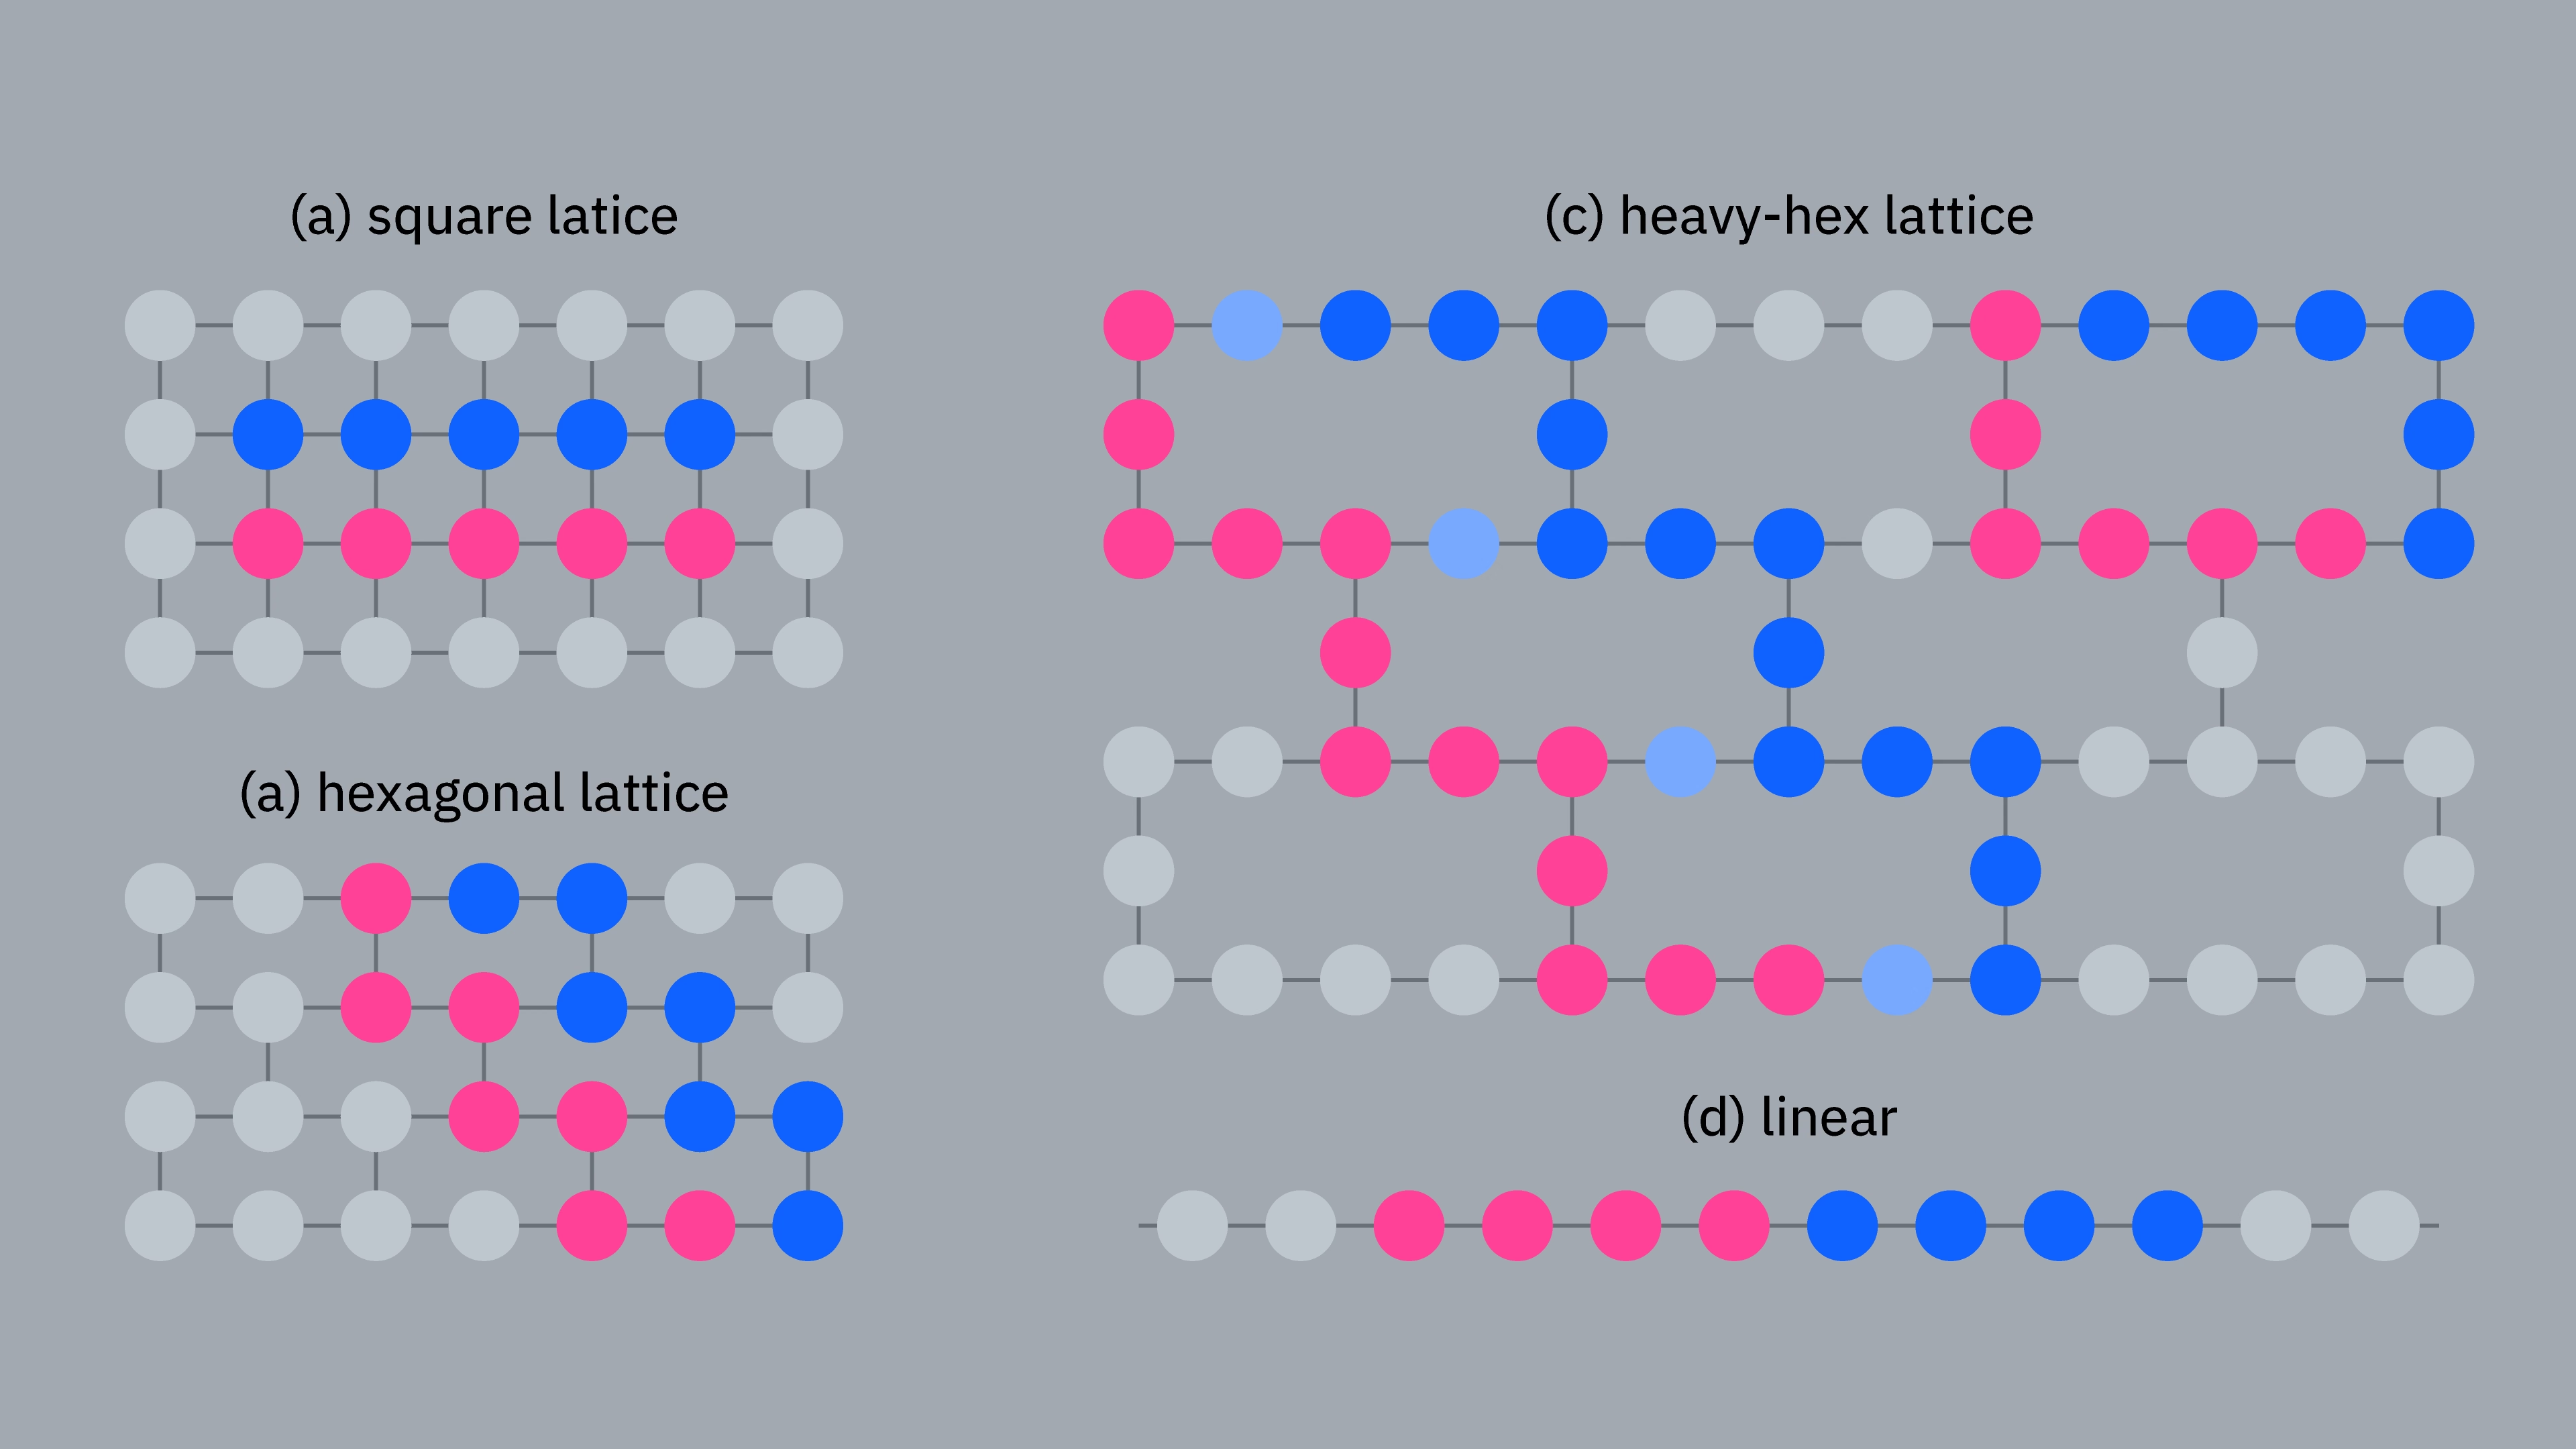
ここでも LUCJ 版は互換性のないゲートを除去します。以下の図は、グリッド、六角形、ヘビーヘックス、線形など、異なる量子ビットトポロジーに対する ブロックのバリアントを示しています。
-
正方形:SWAP なしですべての と 軌道間に ゲートを配置できるため、 ゲートを除去する必要はありません。
-
ヘビーヘックス:- 相互作用は 番目ごとのインデックス(0番目、4番目、8番目など)のスピン軌道間で保持され、「補助量子ビット」を介して接続されます。つまり、 と 軌道を表す線形チェーン間に補助量子ビットが必要です。この配置では、限られた数の SWAP が必要になります。
-
六角形: と を2つの隣接する線形チェーンに配置すると、0番目、2番目、4番目といった一つ置きの軌道が最近接となります。
-
線形: と の軌道が1組のみ接続されるため、 ブロックにはゲートが1つだけになります。
 LUCJ 版を構築するために UCJ アンザッツからゲートを除去するとハードウェア互換性は向上しますが、アンザッツの表現力は低下します。そのため、LUCJ アンザッツを使用する場合、修正された UCJ 演算子の繰り返し()を増やす必要があるかもしれません。
1.2 LUCJ アンザッツの初期化
LUCJ はパラメータ化されたアンザッツであり、ハードウェア実行前にパラメータを初期化する必要があります。アンザッツを初期化する一つの方法として、古典的な連立クラスター単双励起(CCSD)法の t1 および t2 振幅を使用する方法があります。t1 振幅は単一励起演算子の係数であり、t2 振幅は二重励起演算子の係数です。
なお、t1 および t2 振幅で LUCJ アンザッツを初期化するとそれなりの結果が得られますが、アンザッツのパラメータはさらに最適化が必要な場合があります。
# Get CCSD t2 amplitudes for initializing the ansatz
ccsd = pyscf.cc.CCSD(
    scf, frozen=[i for i in range(mol.nao_nr()) if i not in active_space]
)
ccsd.run()

t1 = ccsd.t1
t2 = ccsd.t2
E(CCSD) = -109.0398256929733 E_corr = -0.20458912219883
1.3 ffsim を使った LUCJ アンザッツの構築
ffsim パッケージを使って、上で計算した t1 および t2 振幅でアンザッツを作成・初期化します。この分子は閉殻ハートリー-フォック状態を持つため、UCJ アンザッツのスピンバランス版である UCJOpSpinBalanced を使用します。
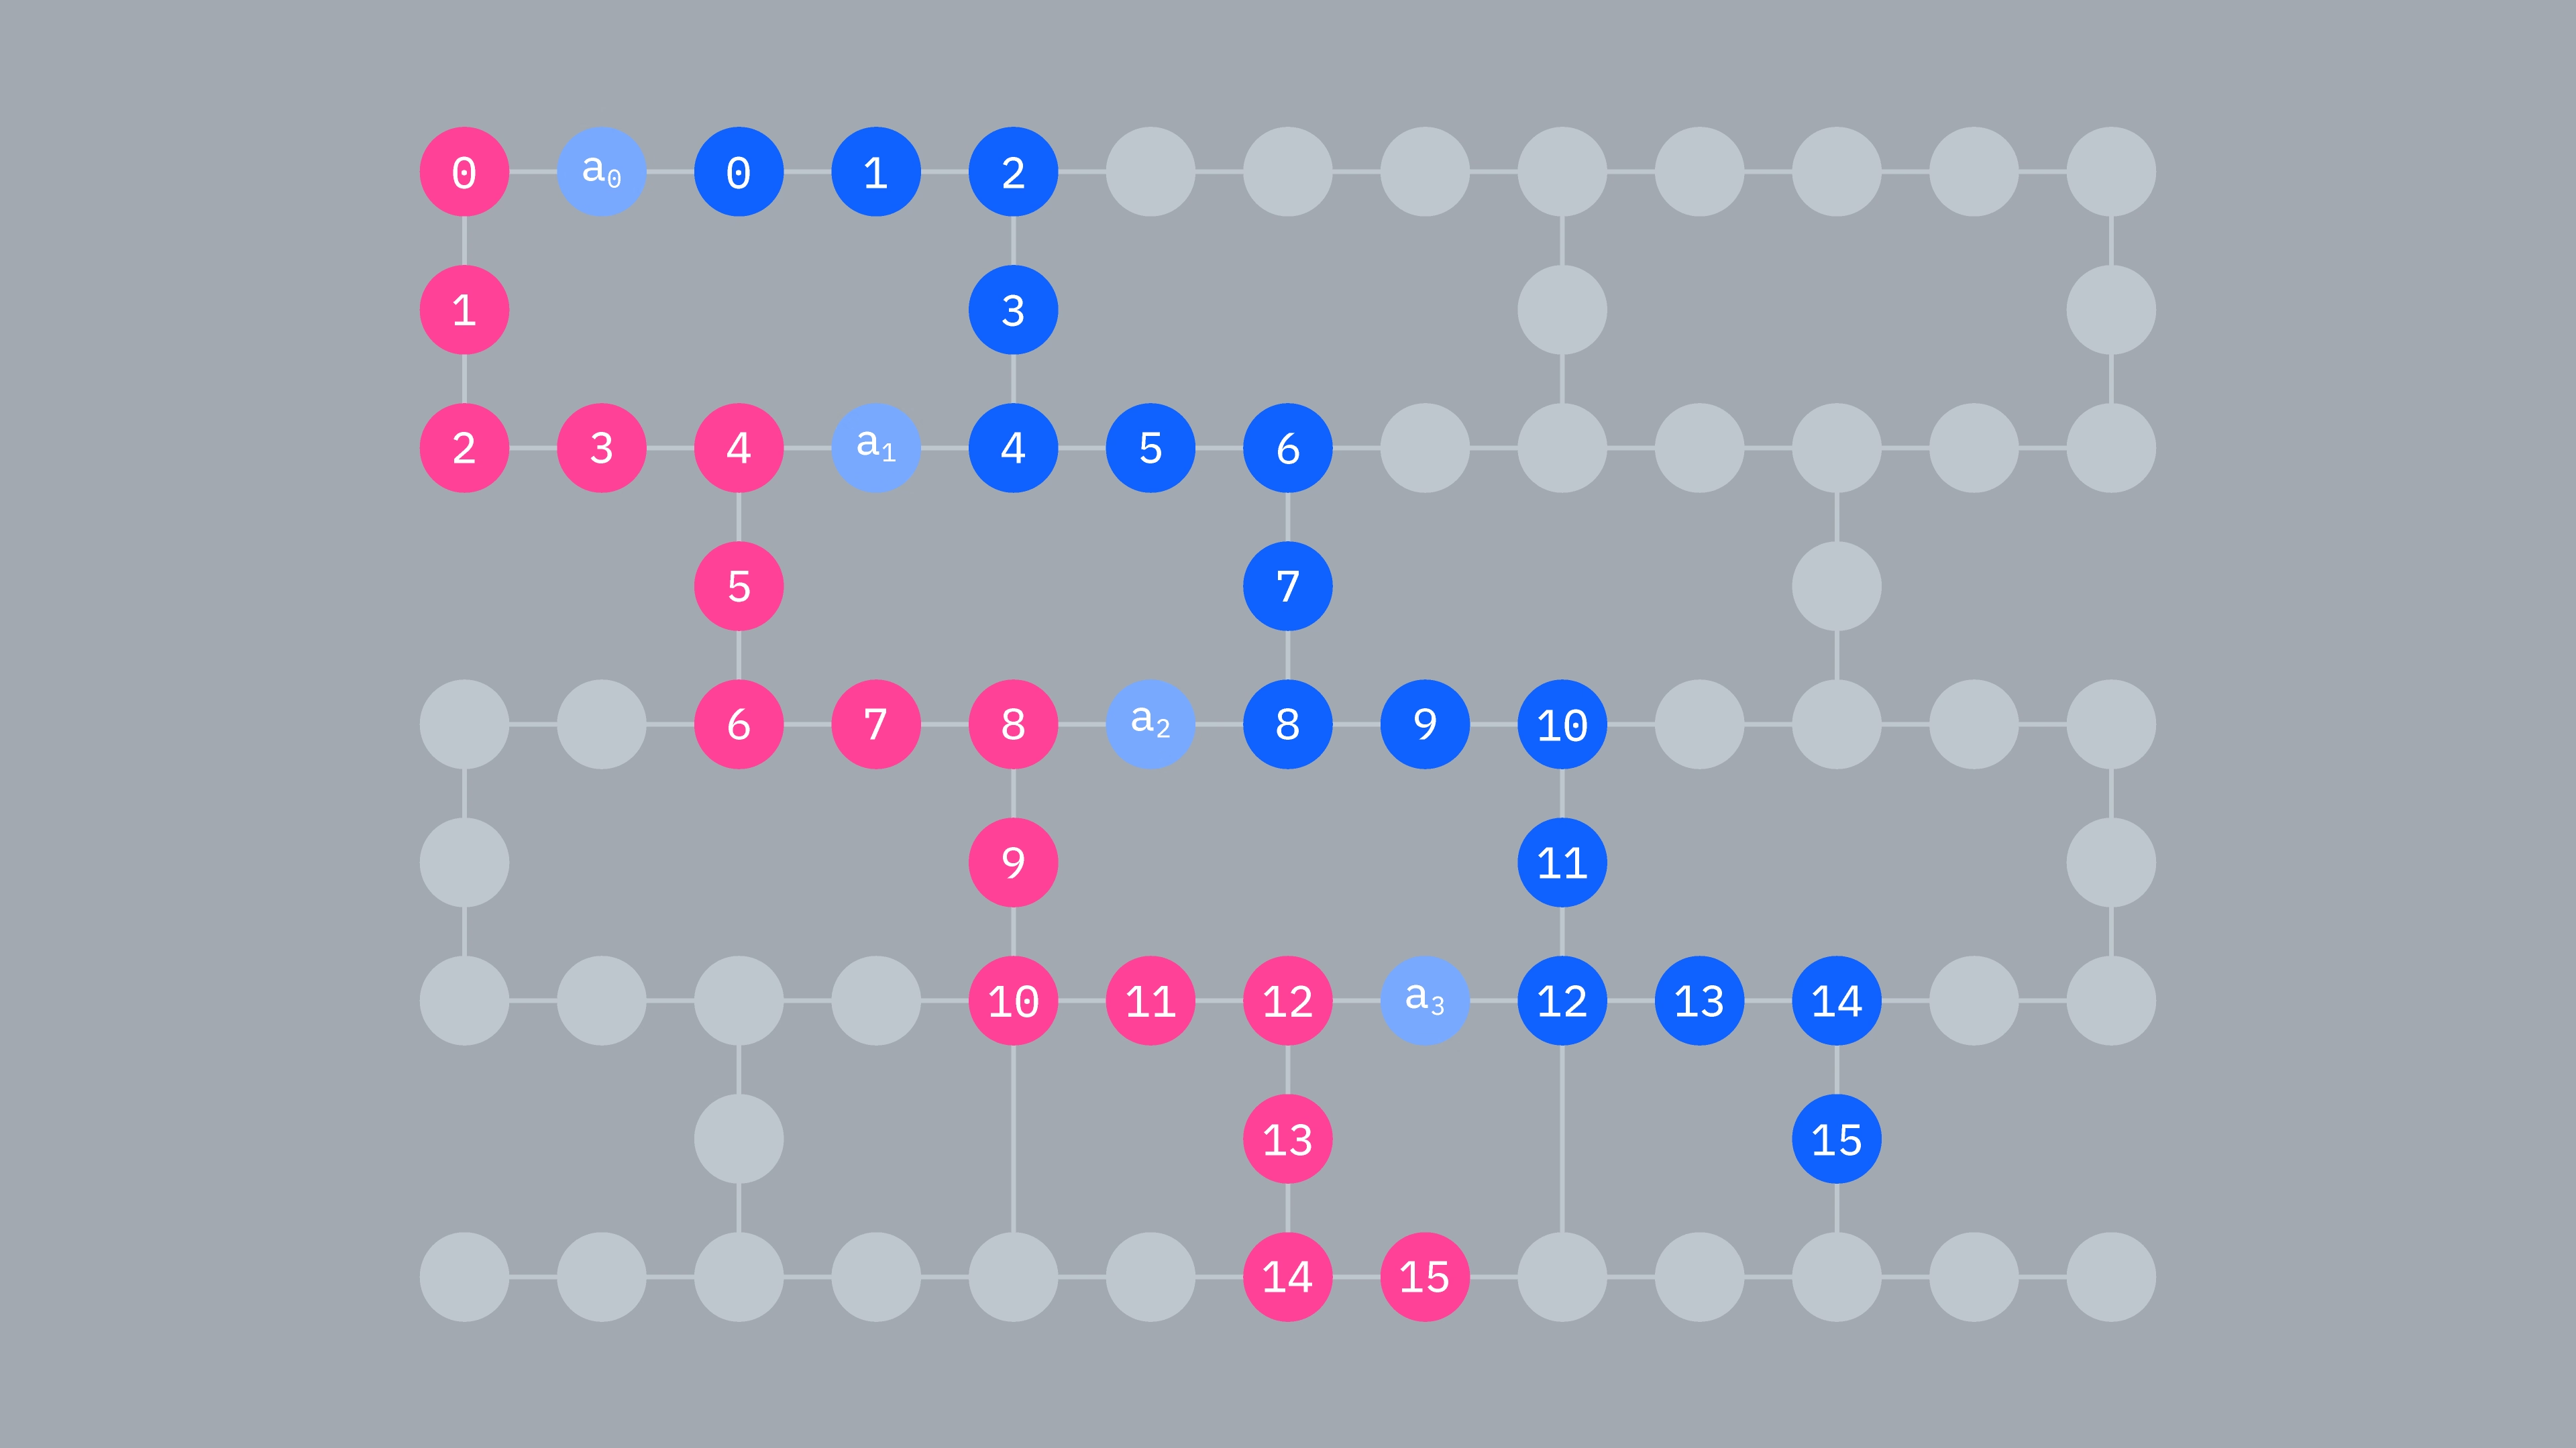
IBM ハードウェアはヘビーヘックストポロジーを持つため、量子ビット相互作用に [1] で使用され上記で説明した「ジグザグ」パターンを採用します。このパターンでは、同じスピンの軌道(量子ビット)は線形トポロジーで接続されます(赤と青の円)。ヘビーヘックストポロジーにより、異なるスピンの軌道は 4 番目ごとの軌道(0番目、4番目、8番目など)で接続されます(紫の円)。
import ffsim
from qiskit import QuantumCircuit, QuantumRegister

n_reps = 2
alpha_alpha_indices = [(p, p + 1) for p in range(num_orbitals - 1)]
alpha_beta_indices = [(p, p) for p in range(0, num_orbitals, 4)]

ucj_op = ffsim.UCJOpSpinBalanced.from_t_amplitudes(
    t2=t2,
    t1=t1,
    n_reps=n_reps,
    interaction_pairs=(alpha_alpha_indices, alpha_beta_indices),
)

nelec = (num_elec_a, num_elec_b)

# create an empty quantum circuit
qubits = QuantumRegister(2 * num_orbitals, name="q")
circuit = QuantumCircuit(qubits)

# prepare Hartree-Fock state as the reference state and append it to the quantum circuit
circuit.append(ffsim.qiskit.PrepareHartreeFockJW(num_orbitals, nelec), qubits)

# apply the UCJ operator to the reference state
circuit.append(ffsim.qiskit.UCJOpSpinBalancedJW(ucj_op), qubits)
circuit.measure_all()
# circuit.decompose().draw("mpl", scale=0.5, fold=-1)
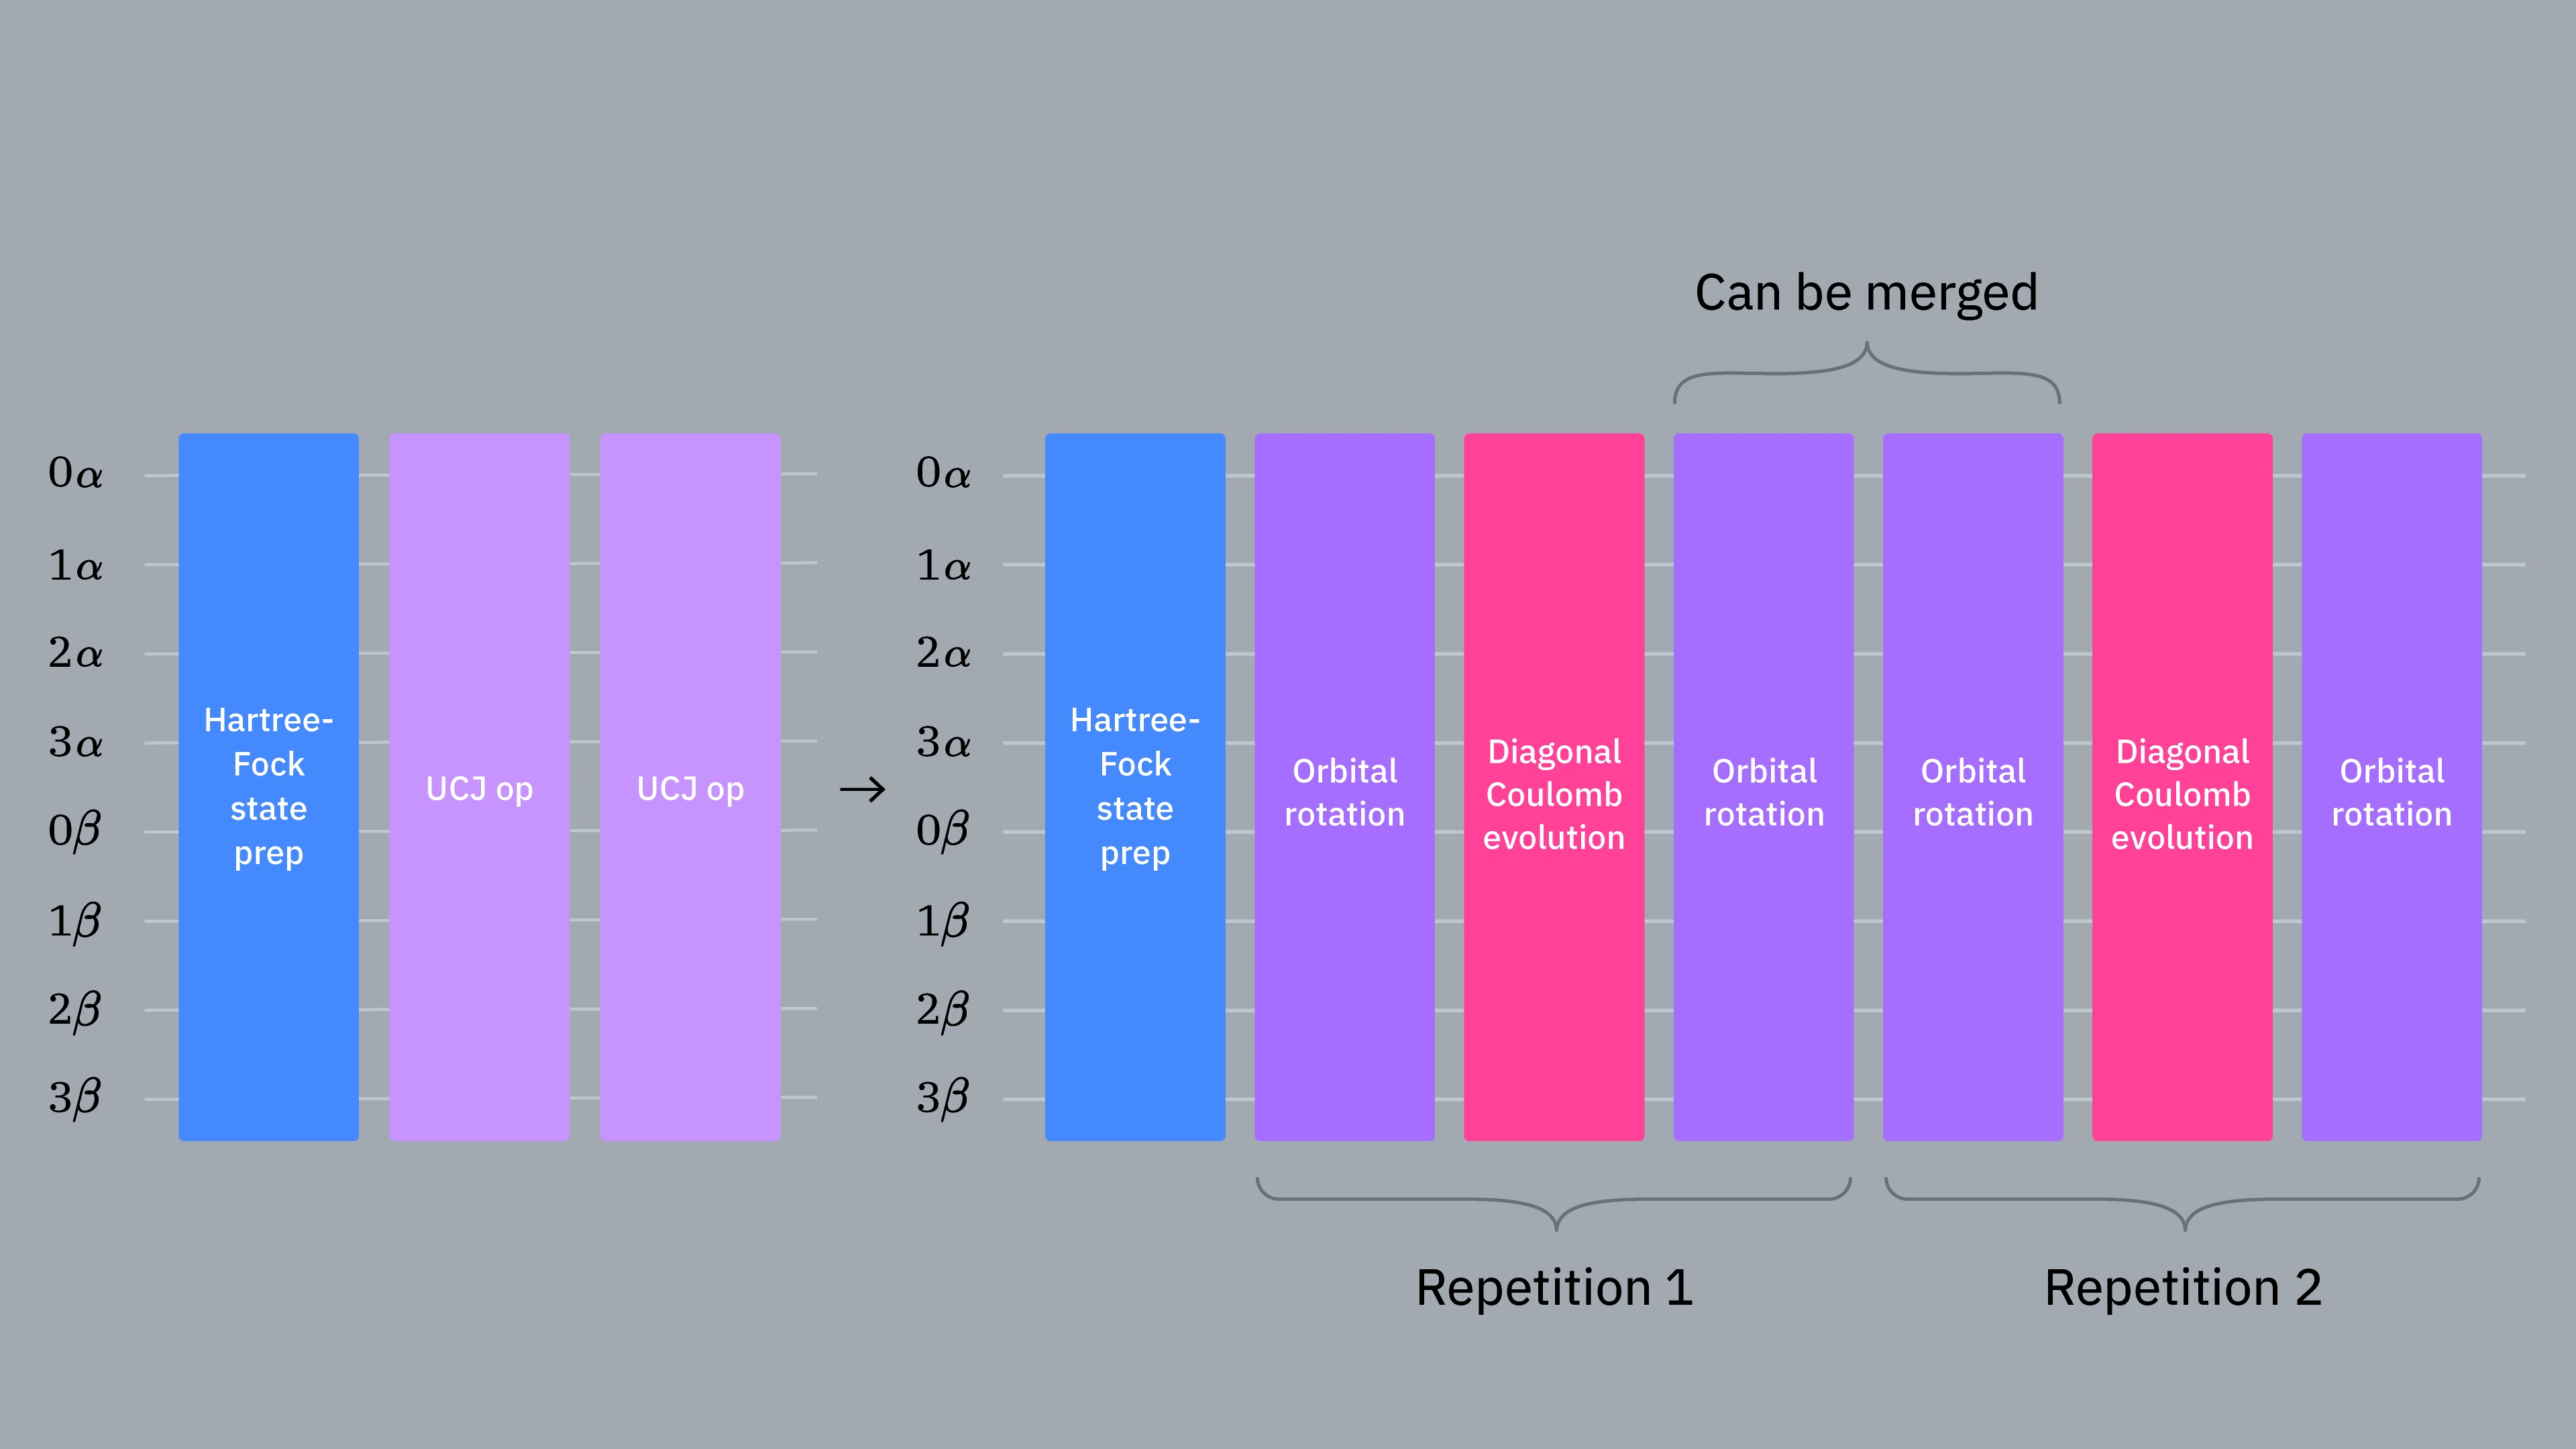
繰り返し層を持つ LUCJ アンザッツは、隣接するブロックの一部をマージすることで最適化できます。n_reps=2 の場合を考えると、中央の2つの軌道回転ブロックを1つの軌道回転ブロックにマージできます。ffsim パッケージには、このような隣接ブロックをマージして回路を最適化する ffsim.qiskit.PRE_INIT というパスマネージャーがあります。
2. ターゲットハードウェア向けに最適化する
まず、使用するバックエンドを取得します。回路をバックエンド向けに最適化し、最適化した回路を同じバックエンドで実行して部分空間のサンプルを生成します。
from qiskit_ibm_runtime import QiskitRuntimeService

service = QiskitRuntimeService()
# Use the least-busy backend or specify a quantum computer using the syntax commented out below.
backend = service.least_busy(operational=True, simulator=False)
# backend = service.backend("ibm_brisbane")
次に、アンザッツを最適化してハードウェア互換にするための以下のステップを推奨します。
-
ターゲットハードウェアから、上記で説明したジグザグパターン(補助量子ビットを挟んだ2本の線形チェーン)に従う物理量子ビット(
initial_layout)を選択する。このパターンで量子ビットを配置すると、ゲート数が少ない効率的なハードウェア互換回路が得られます。 -
選択した
backendとinitial_layoutを使って、Qiskit のgenerate_preset_pass_manager関数でステージ付きパスマネージャーを生成する。 -
ステージ付きパスマネージャーの
pre_initステージをffsim.qiskit.PRE_INITに設定する。ffsim.qiskit.PRE_INITには、ゲートを軌道回転に分解してからマージする Qiskit トランスパイラーパスが含まれており、最終的な回路のゲート数を削減できます。 -
パスマネージャーを回路に対して実行する。
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

spin_a_layout = [0, 14, 18, 19, 20, 33, 39, 40, 41, 53, 60, 61, 62, 72, 81, 82]
spin_b_layout = [2, 3, 4, 15, 22, 23, 24, 34, 43, 44, 45, 54, 64, 65, 66, 73]

initial_layout = spin_a_layout + spin_b_layout

pass_manager = generate_preset_pass_manager(
    optimization_level=3, backend=backend, initial_layout=initial_layout
)

# without PRE_INIT passes
isa_circuit = pass_manager.run(circuit)
print(f"Gate counts (w/o pre-init passes): {isa_circuit.count_ops()}")

# with PRE_INIT passes
# We will use the circuit generated by this pass manager for hardware execution
pass_manager.pre_init = ffsim.qiskit.PRE_INIT
isa_circuit = pass_manager.run(circuit)
print(f"Gate counts (w/ pre-init passes): {isa_circuit.count_ops()}")
Gate counts (w/o pre-init passes): OrderedDict({'rz': 7579, 'sx': 6106, 'ecr': 2316, 'x': 336, 'measure': 32, 'barrier': 1})
Gate counts (w/ pre-init passes): OrderedDict({'rz': 4088, 'sx': 3125, 'ecr': 1262, 'x': 201, 'measure': 32, 'barrier': 1})
3. ターゲットハードウェアで実行する
ハードウェア実行向けに回路を最適化したら、ターゲットハードウェアで実行し、基底状態エネルギー推定のためのサンプルを収集する準備ができています。回路が1つだけなので、qiskit-ibm-runtime ジョブ実行モードを使って回路を実行します。
from qiskit_ibm_runtime import SamplerV2 as Sampler

sampler = Sampler(mode=backend)
sampler.options.dynamical_decoupling.enable = True

job = sampler.run([isa_circuit], shots=10_000)  # Takes approximately 5sec of QPU time
# Run cell after IQX job completion
primitive_result = job.result()
pub_result = primitive_result[0]
counts = pub_result.data.meas.get_counts()
4. 結果を後処理する
SQD ワークフローの後処理部分は、次の図でまとめることができます。
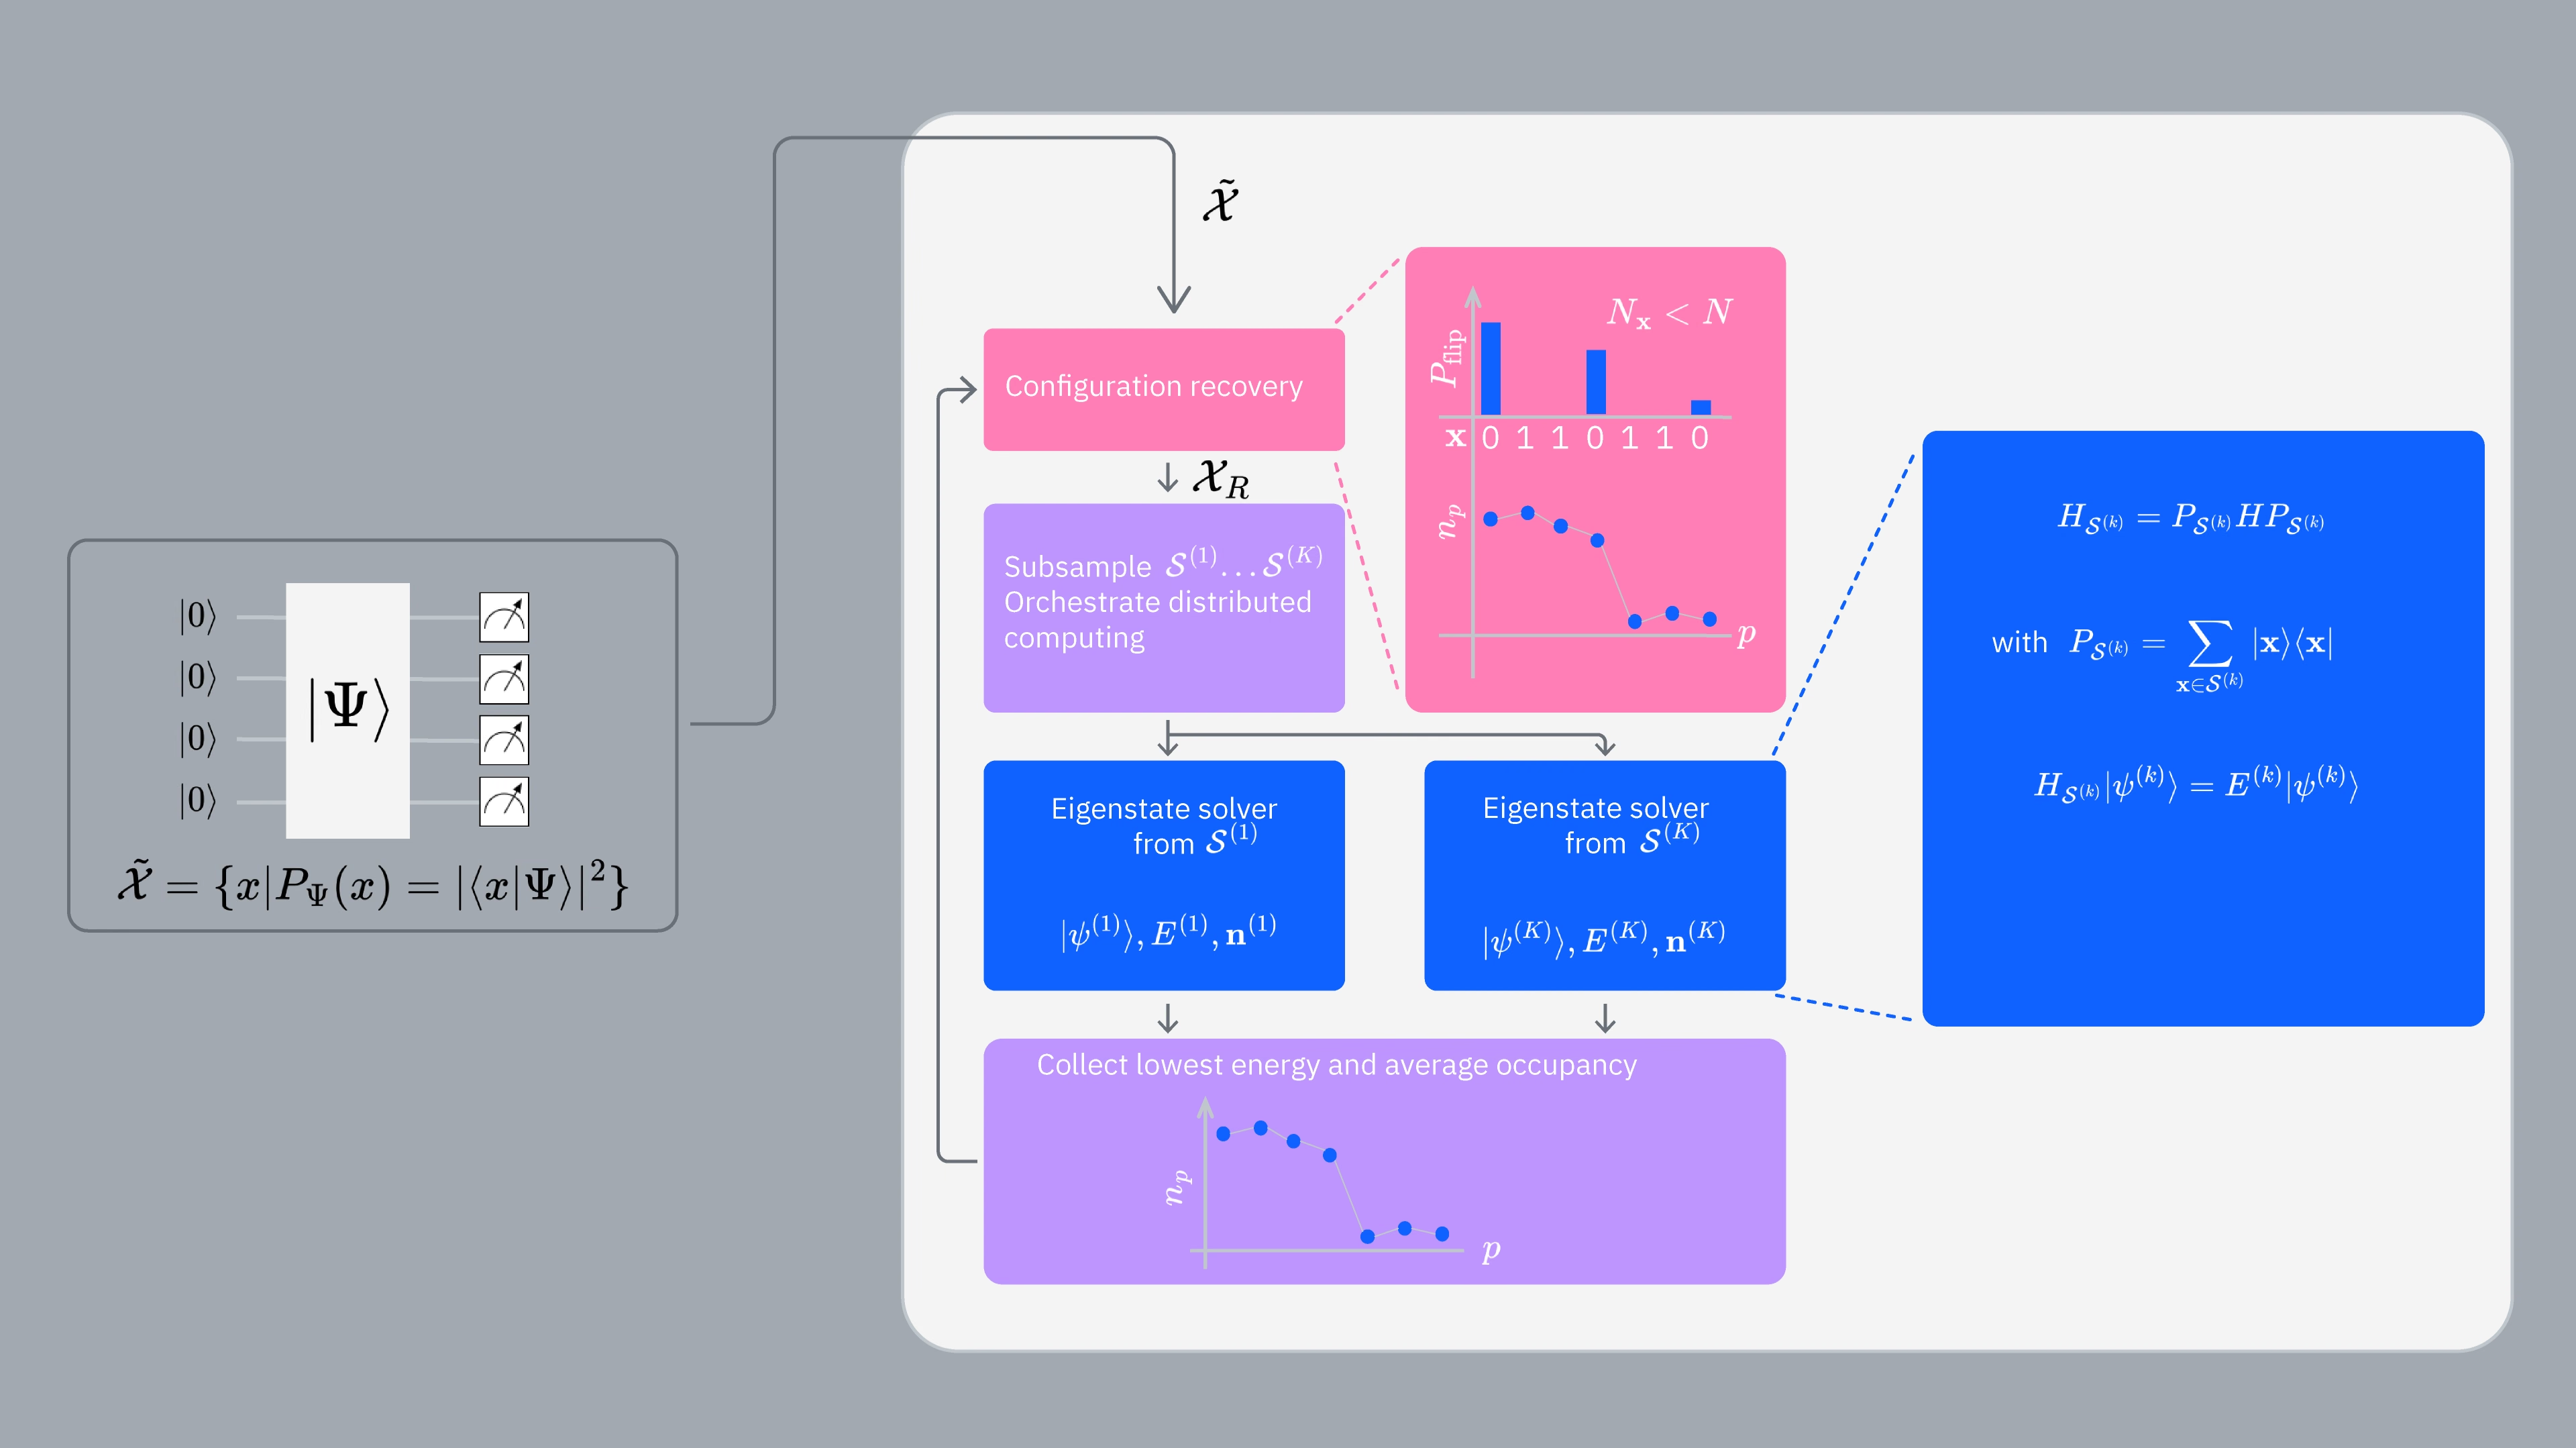 Sampling the LUCJ ansatz in the computational basis generates a pool of noisy configurations , which are used in the post-processing routine. It involves a method called (details discussed later) configuration recovery to probabilistically correct configurations with incorrect electron numbers. Configurations only with correct electron numbers are then subsampled and distributed into multiple batches based on the frequency of appearance of each unique configuration. Each batch of samples defines a subspace (). Next, the molecular Hamiltonian, , is projected onto subspaces:
各射影ハミルトニアン は固有値ソルバーに渡され、対角化によって固有値と固有ベクトルが計算されて固有状態が再構築されます。このレッスンでは、qiskit-addon-sqd パッケージを使ってハミルトニアンを射影・対角化します。このパッケージは PySCF の Davidson 法を対角化に使用します。
次に、バッチから最小固有値(エネルギー)を収集し、平均軌道占有率 も計算します。平均占有率情報は、ノイズのある配置を確率的に修正するコンフィギュレーション回復ステップで使用されます。
次に、自己無撞着コンフィギュレーション回復ループの詳細を説明し、上記で述べた ハミルトニアンの基底状態エネルギーを推定するための具体的なコード例を示します。
4.1 コンフィギュレーション回復:概要
ビットストリング(スレーター行列式)の各ビットはスピン軌道を表します。ビットストリングの右半分はスピンアップ軌道を、左半分はスピンダウン軌道を表します。1 は軌道に電子が占有されていることを意味し、0 は軌道が空であることを意味します。正しい粒子数(スピンアップ電子とスピンダウン電子の両方)は事前に分かっています。行列式 に 個の電子(つまりビットストリング中に 個の がある)があるとします。正しい粒子数を とします。 であれば、そのビットストリングがノイズによって破損していることが分かります。自己無撞着コンフィギュレーションルーティンは、平均軌道占有率情報を活用することで、 個のビットを確率的に反転させてビットストリングを修正しようとします。平均軌道占有率()は、軌道が電子によって占有される確率を示します。 の場合、電子が少ないので、いくつかの を に反転させる必要があり、逆も然りです。
反転する確率は、i 番目のスピン軌道に対して とすることができます。[2] では、著者は修正 ReLU 関数を使った加重確率を用いています。
ここで、 は ReLU 関数の「角」の位置を定義し、パラメータ は角での ReLU 関数の値を定義します。 の場合、 は真の ReLU 関数になり、 の場合は「修正」ReLU になります。論文では著者は と アルファ(またはベータ)粒子数/アルファ(またはベータ)スピン軌道数 (充填率)を使用しています。
平均軌道占有率()は事前には分かりません。基底状態推定の最初のイテレーションは、両スピン種で正しい粒子数を持つ配置のみから始まります。最初のイテレーション後、基底状態の推定値が得られ、その推定値を使って の最初の予測を構築できます。この の予測を使って配置を回復し、次の基底状態推定のイテレーションを実行し、自己無撞着に の予測を精緻化します。このプロセスは停止基準が満たされるまで繰り返されます。
かつ ()の例を考えてみましょう。粒子数を正しく修正するには0のうちの1つを1に反転させる必要があり、その選択肢は 1100、1010、1001 です。反転の確率に基づいて、いずれかの選択肢が_回復された配置_(すなわち正しい粒子数を持つビット列)として選択されます。
最初のイテレーションで2つのバッチを実行し、それらから推定された基底状態が次の通りだとします。
計算基底状態とその振幅を使って、スピン軌道(量子ビット)ごとの電子占有確率(略して「占有率」)を計算できます(確率 = |振幅|)。以下では、推定基底状態に現れる各ビットストリングの量子ビットごとの占有率を表にまとめ、バッチの合計軌道占有率を計算します。なお、Qiskit の順序規則に従い、最も右のビットが量子ビット 0(Q0)を表し、最も左のビットが Q3 を表します。
占有率(Batch0):
| Q3 | Q2 | Q1 | Q0 | |
|---|---|---|---|---|
| 1001 | 0.64 | 0.0 | 0.0 | 0.64 |
| 0110 | 0.0 | 0.36 | 0.36 | 0.0 |
| n (Batch0) | 0.64 | 0.36 | 0.36 | 0.64 |
占有率(Batch1)
| Q3 | Q2 | Q1 | Q0 | |
|---|---|---|---|---|
| 1001 | 0.33 | 0.00 | 0.00 | 0.33 |
| 0101 | 0.0 | 0.33 | 0.00 | 0.33 |
| 0110 | 0.0 | 0.33 | 0.33 | 0.00 |
| n (Batch1) | 0.33 | 0.66 | 0.33 | 0.66 |
占有率(バッチ間の平均)
| Q3 | Q2 | Q1 | Q0 | |
|---|---|---|---|---|
| n (Batch0) | 0.64 | 0.36 | 0.36 | 0.64 |
| n (Batch1) | 0.33 | 0.66 | 0.33 | 0.66 |
| n (average) | 0.49 | 0.51 | 0.35 | 0.65 |
上で計算した平均軌道占有率を使って、配置 における各軌道の反転確率を求めることができます。Q3 で表される軌道はすでに占有されており反転する必要がないため、その p(flip) を に設定します。占有されていない残りの軌道については、反転確率はそれぞれ です。p(flip) とともに、上記の修正 ReLU 関数を使って反転に関連する確率重みも計算します。
反転確率(、、)
| Q3 | Q2 | Q1 | Q0 | |
|---|---|---|---|---|
| p(flip) () | 0 | 0.51 | 0.35 | 0.65 |
| w(p(flip)) | 0 | 0.03 | 0.007 | 0.31 |
最後に、上記の加重確率を使って、占有されていない Q2、Q1、Q0 のいずれかを反転させます。上記の値から、Q0 が最も反転しやすく、回復された配置として が得られる可能性が高いです。
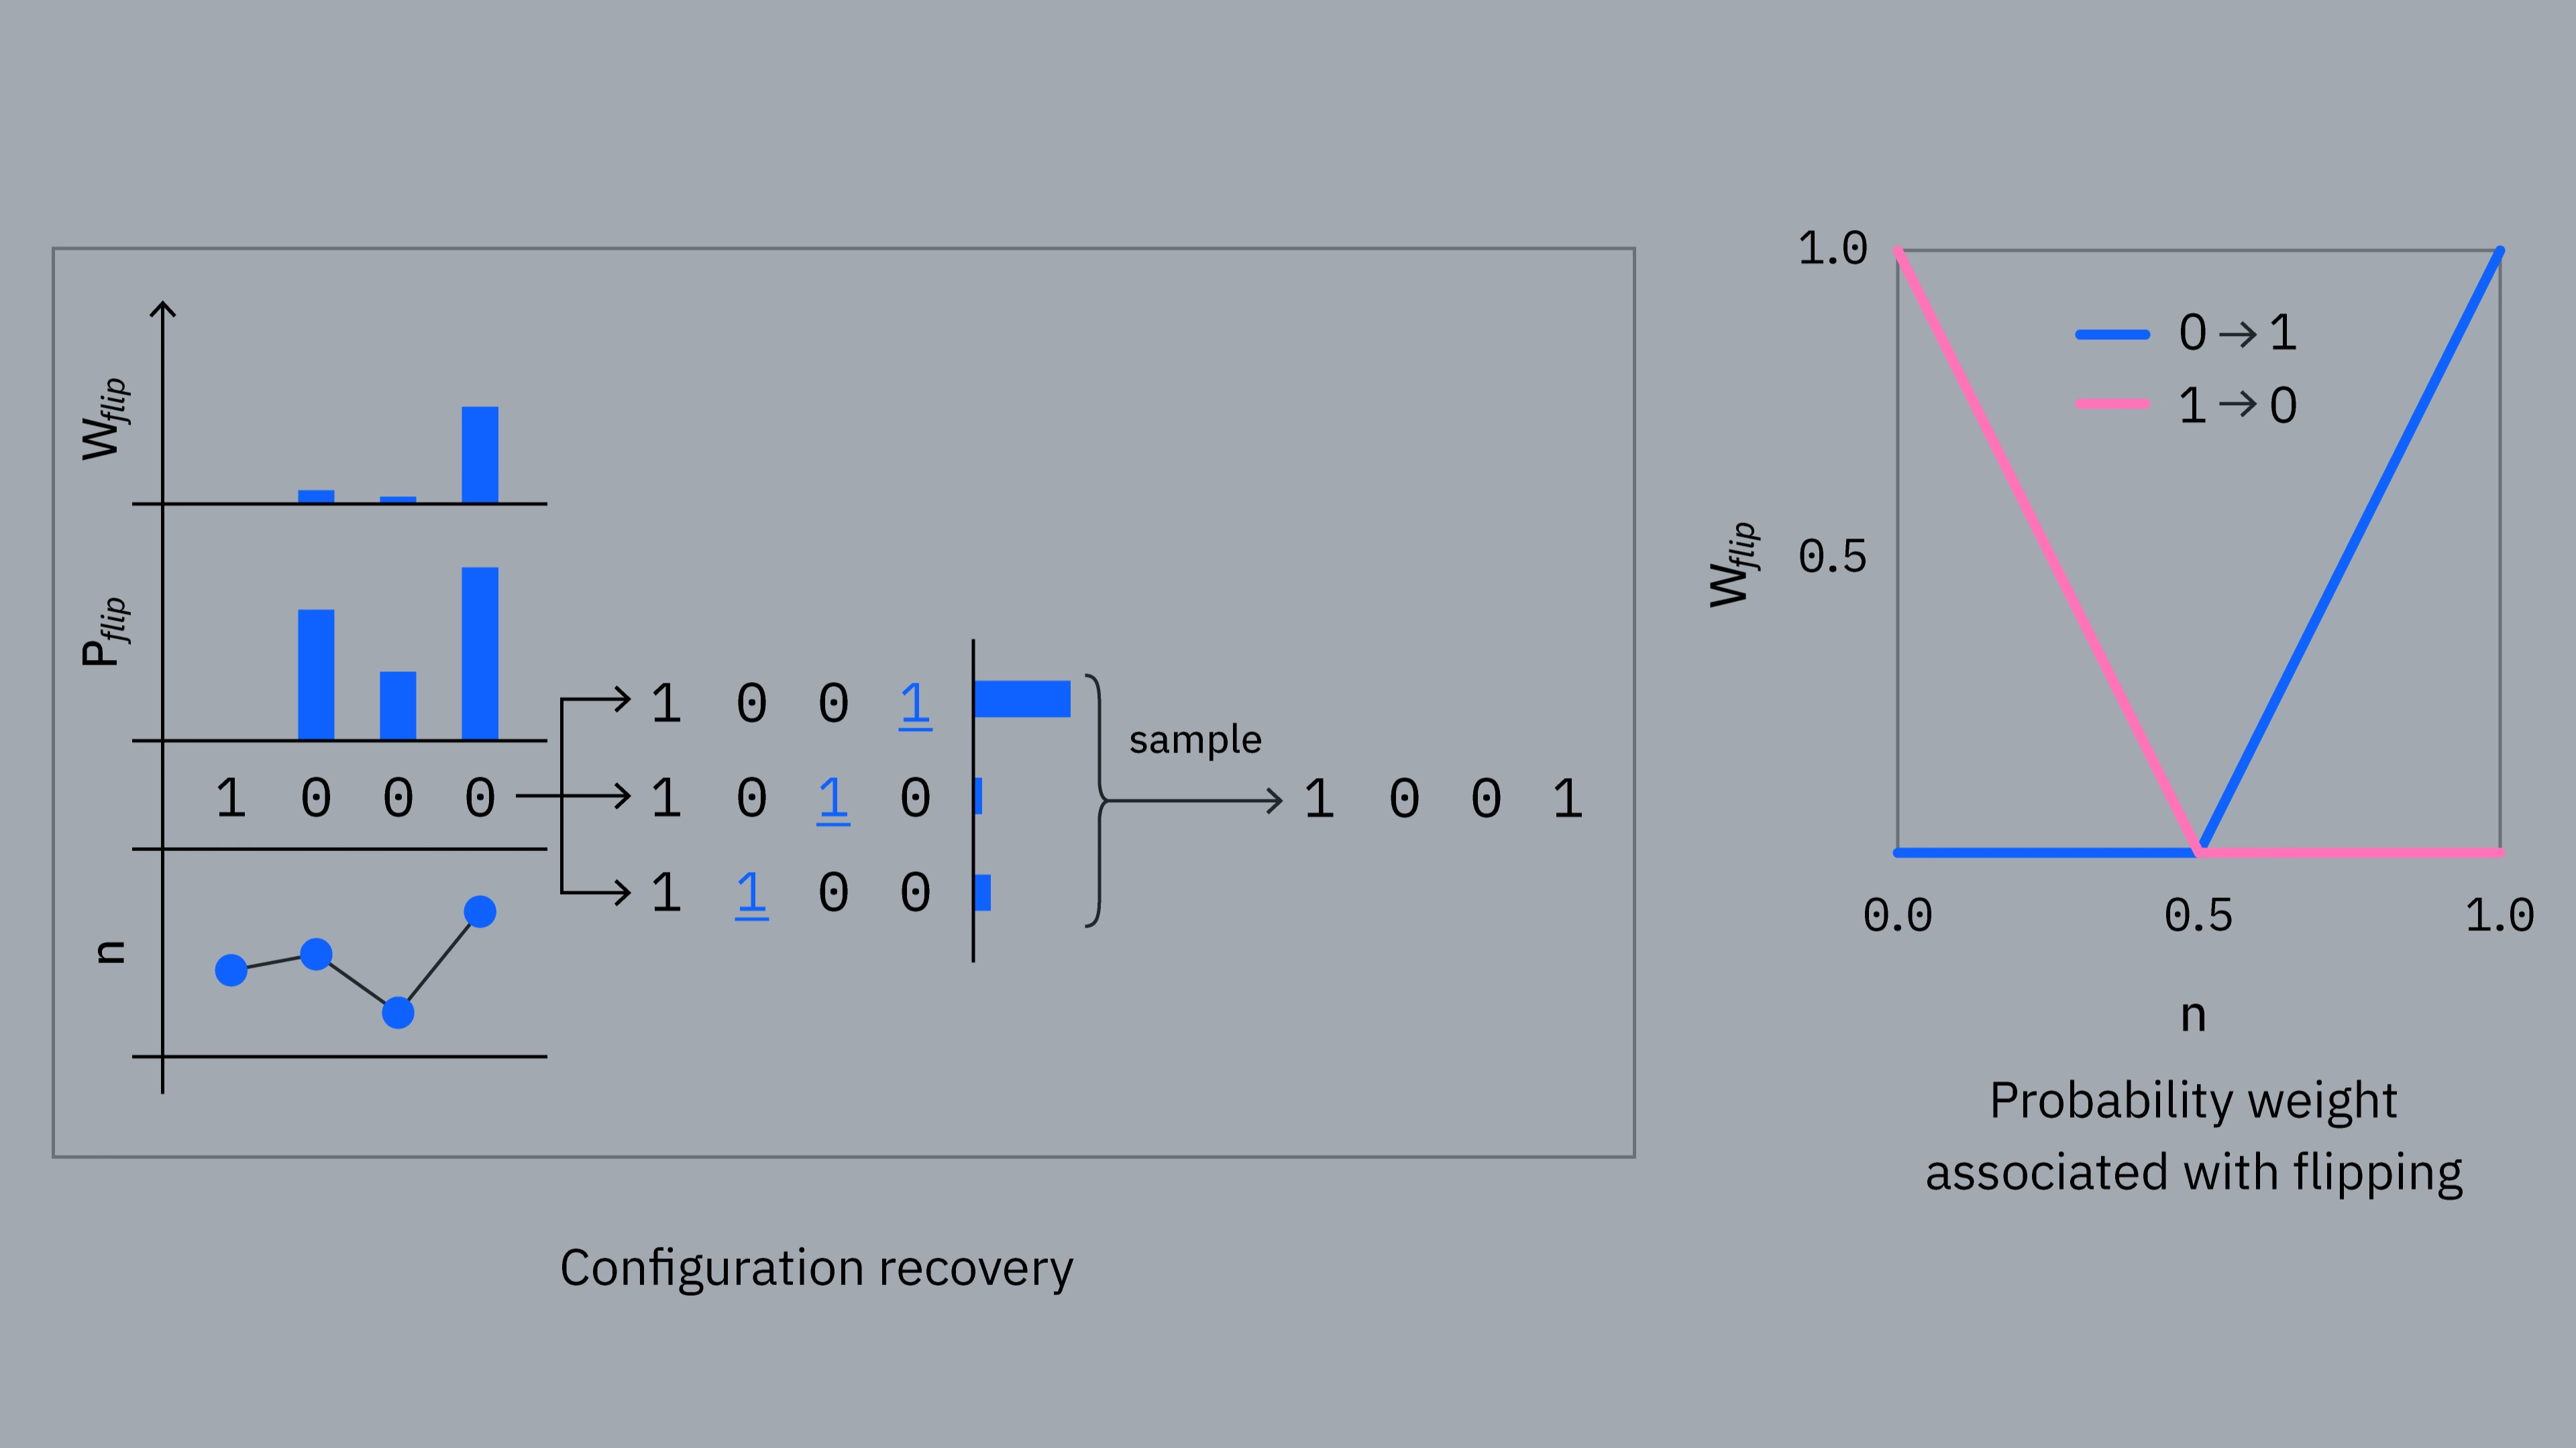 完全な自己無撞着コンフィギュレーション回復プロセスは次のようにまとめられます。
最初のイテレーション: 量子コンピュータが生成したビットストリング(配置またはスレーター行列式)が集合 を形成するとします。これには、各スピンセクターで正しい粒子数を持つ配置()と正しくない配置()の両方が含まれます。
- ()の配置をランダムにサンプリングして、部分空間射影のためのベクトルのバッチ を作成する。バッチ数と各バッチのサンプル数はユーザー定義のパラメータです。各バッチのサンプル数が多いほど、部分空間の次元が大きくなり、対角化の計算コストが高くなります。一方、サンプル数が少なすぎると、基底状態のサポートベクトルを見逃して誤った推定につながる可能性があります。
- バッチに対して固有状態ソルバー(部分空間への射影と対角化)を実行し、近似固有状態 を得る。
- 近似固有状態から の最初の予測を構築する。
以降のイテレーション:
- を使って の粒子数が誤った配置を修正する。これを と呼ぶとすると、 が正しい粒子数を持つ配置の新しい集合となる。
- をサンプリングしてバッチ を作成する。
- 固有状態ソルバーが新しいバッチで実行され、基底状態の新しい推定値 を生成する。
- 近似固有状態から の精緻化された予測を構築する。
- 停止基準が満たされない場合は、ステップ
2.1に戻る。
4.2 基底状態の推定
まず、カウントをビット列行列と確率配列に変換し、後処理に使用します。
行列の各行は一意のビット列を表します。Qiskitではビット列の右側から量子ビットにインデックスが振られるため、列 0 は量子ビット N-1 に対応し、列 N-1 は量子ビット 0 に対応します(N は量子ビット数)。
アルファ軌道は列インデックス範囲 (N, N/2](右半分)で表され、ベータ軌道は列範囲 (N/2, 0](左半分)で表されます。
from qiskit_addon_sqd.counts import counts_to_arrays

# Convert counts into bitstring and probability arrays
bitstring_matrix_full, probs_arr_full = counts_to_arrays(counts)
このテクニックで重要なユーザー制御オプションがいくつかあります:
-
iterations:自己無撞着コンフィギュレーション回復の反復回数 -
n_batches:固有状態ソルバーの各呼び出しで使用する配置のバッチ数 -
samples_per_batch:各バッチに含める一意の配置数 -
max_davidson_cycles:各固有値ソルバーが実行するダビドソンサイクルの最大数
import numpy as np
from qiskit_addon_sqd.configuration_recovery import recover_configurations
from qiskit_addon_sqd.fermion import (
    bitstring_matrix_to_ci_strs,
    solve_fermion,
)
from qiskit_addon_sqd.subsampling import postselect_and_subsample

rng = np.random.default_rng(24)
# SQD options
iterations = 5

# Eigenstate solver options
n_batches = 5
samples_per_batch = 500
max_davidson_cycles = 300

# Self-consistent configuration recovery loop
e_hist = np.zeros((iterations, n_batches))  # energy history
s_hist = np.zeros((iterations, n_batches))  # spin history
occupancy_hist = []
avg_occupancy = None
for i in range(iterations):
    print(f"Starting configuration recovery iteration {i}")
    # On the first iteration, we have no orbital occupancy information from the
    # solver, so we begin with the full set of noisy configurations.
    if avg_occupancy is None:
        bs_mat_tmp = bitstring_matrix_full
        probs_arr_tmp = probs_arr_full

    # If we have average orbital occupancy information, we use it to refine
    # the full set of noisy configurations.
    else:
        bs_mat_tmp, probs_arr_tmp = recover_configurations(
            bitstring_matrix_full,
            probs_arr_full,
            avg_occupancy,
            num_elec_a,
            num_elec_b,
            rand_seed=rng,
        )

    # Create batches of subsamples. We postselect here to remove configurations
    # with incorrect hamming weight during iteration 0, since no config recovery was performed.
    batches = postselect_and_subsample(
        bs_mat_tmp,
        probs_arr_tmp,
        hamming_right=num_elec_a,
        hamming_left=num_elec_b,
        samples_per_batch=samples_per_batch,
        num_batches=n_batches,
        rand_seed=rng,
    )

    # Run eigenstate solvers in a loop. This loop should be parallelized for larger problems.
    e_tmp = np.zeros(n_batches)
    s_tmp = np.zeros(n_batches)
    occs_tmp = []
    coeffs = []
    for j in range(n_batches):
        strs_a, strs_b = bitstring_matrix_to_ci_strs(batches[j])
        print(f"  Batch {j} subspace dimension: {len(strs_a) * len(strs_b)}")
        energy_sci, coeffs_sci, avg_occs, spin = solve_fermion(
            batches[j],
            hcore,
            eri,
            open_shell=open_shell,
            spin_sq=spin_sq,
            max_cycle=max_davidson_cycles,
        )
        energy_sci += nuclear_repulsion_energy
        e_tmp[j] = energy_sci
        s_tmp[j] = spin
        occs_tmp.append(avg_occs)
        coeffs.append(coeffs_sci)

    # Combine batch results
    avg_occupancy = tuple(np.mean(occs_tmp, axis=0))

    # Track optimization history
    e_hist[i, :] = e_tmp
    s_hist[i, :] = s_tmp
    occupancy_hist.append(avg_occupancy)
Starting configuration recovery iteration 0
  Batch 0 subspace dimension: 21609
  Batch 1 subspace dimension: 21609
  Batch 2 subspace dimension: 21609
  Batch 3 subspace dimension: 21609
  Batch 4 subspace dimension: 21609
Starting configuration recovery iteration 1
  Batch 0 subspace dimension: 609961
  Batch 1 subspace dimension: 616225
  Batch 2 subspace dimension: 627264
  Batch 3 subspace dimension: 633616
  Batch 4 subspace dimension: 624100
Starting configuration recovery iteration 2
  Batch 0 subspace dimension: 564001
  Batch 1 subspace dimension: 605284
  Batch 2 subspace dimension: 582169
  Batch 3 subspace dimension: 559504
  Batch 4 subspace dimension: 591361
Starting configuration recovery iteration 3
  Batch 0 subspace dimension: 550564
  Batch 1 subspace dimension: 549081
  Batch 2 subspace dimension: 531441
  Batch 3 subspace dimension: 527076
  Batch 4 subspace dimension: 531441
Starting configuration recovery iteration 4
  Batch 0 subspace dimension: 544644
  Batch 1 subspace dimension: 580644
  Batch 2 subspace dimension: 527076
  Batch 3 subspace dimension: 531441
  Batch 4 subspace dimension: 537289
4.3 結果の考察
最初のプロットは、数回の反復後に基底状態エネルギーを約24 mH以内で推定できることを示しています(化学的精度は一般に1 kcal/mol 1.6 mH とされています)。2番目のプロットは、最終反復後の各空間軌道の平均占有数を示しています。スピンアップ電子とスピンダウン電子の両方が、高い確率で最初の5つの軌道を占有していることがわかります。
推定された基底状態エネルギーはある程度良好ですが、化学的精度の限界( mH)には達していません。このギャップは、射影と対角化に使用した部分空間の次元が小さかったことに起因しています。samples_per_batch=500 を使用したため、部分空間は最大 個のベクトルで張られており、基底状態のサポートに含まれるベクトルが不足しています。samples_per_batch パラメーターを増やすと、より多くの古典的な計算リソースと実行時間を要する代わりに精度が向上するはずです。
# Data for energies plot
x1 = range(iterations)
min_e = [np.min(e) for e in e_hist]
e_diff = [abs(e - exact_energy) for e in min_e]
yt1 = [1.0, 1e-1, 1e-2, 1e-3, 1e-4, 1e-5]

# Chemical accuracy (+/- 1 milli-Hartree)
chem_accuracy = 0.001

# Data for avg spatial orbital occupancy
y2 = occupancy_hist[-1][0] + occupancy_hist[-1][1]
x2 = range(len(y2))
import matplotlib.pyplot as plt

fig, axs = plt.subplots(1, 2, figsize=(12, 6))

# Plot energies
axs[0].plot(x1, e_diff, label="energy error", marker="o")
axs[0].set_xticks(x1)
axs[0].set_xticklabels(x1)
axs[0].set_yticks(yt1)
axs[0].set_yticklabels(yt1)
axs[0].set_yscale("log")
axs[0].set_ylim(1e-6)
axs[0].axhline(
    y=chem_accuracy, color="#BF5700", linestyle="--", label="chemical accuracy"
)
axs[0].set_title("Approximated Ground State Energy Error vs SQD Iterations")
axs[0].set_xlabel("Iteration Index", fontdict={"fontsize": 12})
axs[0].set_ylabel("Energy Error (Ha)", fontdict={"fontsize": 12})
axs[0].legend()

# Plot orbital occupancy
axs[1].bar(x2, y2, width=0.8)
axs[1].set_xticks(x2)
axs[1].set_xticklabels(x2)
axs[1].set_title("Avg Occupancy per Spatial Orbital")
axs[1].set_xlabel("Orbital Index", fontdict={"fontsize": 12})
axs[1].set_ylabel("Avg Occupancy", fontdict={"fontsize": 12})

print(f"Exact energy: {exact_energy:.5f} Ha")
print(f"SQD energy: {min_e[-1]:.5f} Ha")
print(f"Absolute error: {e_diff[-1]:.5f} Ha")
plt.tight_layout()
plt.show()
Exact energy: -109.04667 Ha
SQD energy: -109.02234 Ha
Absolute error: 0.02434 Ha

読者への演習
samples_per_batch パラメーターを段階的に増やし(例えば、 から まで 刻みで、お使いのコンピューターのメモリが許す範囲で)、推定された基底状態エネルギーを比較してみてください。
参考文献
[1] M. Motta et al., "Bridging physical intuition and hardware efficiency for correlated electronic states: the local unitary cluster Jastrow ansatz for electronic structure" (2023). Chem. Sci., 2023, 14, 11213.
[2] J. Robledo-Moreno et al., "Chemistry Beyond Exact Solutions on a Quantum-Centric Supercomputer" (2024). arXiv:quant-ph/2405.05068.