SLCを用いたPEC
確率的エラーキャンセレーション(PEC)は、観測量の期待値計算において量子ノイズを軽減する手法です。期待値の不偏推定を計算できます。この手法は、学習したノイズモデルの逆を注入したノイズのある回路のアンサンブルを実行することで機能します。ノイズモデルは、Pauliツワーリング(ランダム化コンパイルとしても知られています)を用いてPauliチャネルに近似されます。このようなノイズモデルは効率的に学習でき、PECを用いて軽減できます(詳細はProbabilistic error cancellation with sparse Pauli-Lindblad models on noisy quantum processorsを参照してください)。
PECは不偏推定を計算するために指数的なショットオーバーヘッドを必要とします。Shaded Lightcones (SLC)は、古典リソースを使って回路全体にわたるエラーへの感度に上限を与える手法です。これらの上限を用いて、ユーザーは観測量推定のバイアスを制御可能な形で調整できます。
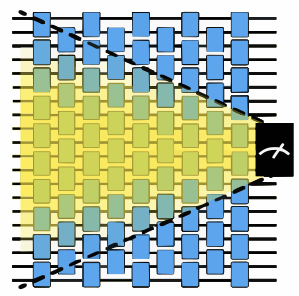
このガイドでは、PECとSLCを組み合わせて、通常のPECに比べてショットオーバーヘッドを抑えながらゲートノイズを軽減する方法を説明します。
ワークフローは次のとおりです。
- 回路と観測量を指定します。
- ノイズのある未軽減の期待値を計算します。
- バイアスの順方向および逆方向の上限を計算します。
- qiskit-noise-learning を使ってエンタングリングレイヤーのノイズを学習します。
- 学習したノイズを使って、計算した上限をローカルスケール行列にマージします。
- ショットオーバーヘッドとバイアスのトレードオフに基づいて、望ましいバイアス上限を選びます。
- PEC + SLCプログラムを準備し、実行して後処理します。
- 軽減された期待値とショットオーバーヘッドを比較します。
回路と観測量を指定する
8量子ビット上の1次元イジング鎖ハミルトニアンのトロッター化された時間発展のミラー回路を準備します。回路をミラーリングしてそのユニタリを打ち消し、恒等回路を作ります。これにより、各観測量の理想的な期待値は計算しなくても1であるとわかります。さらに、ミラーリングは回路の深さを2倍にし、その結果ノイズの影響も2倍になります。
角度 を使って、ダイナミクスを非クリフォードにします。
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "qiskit": "qiskit", "qiskit_addon_slc": "qiskit-addon-slc", "qiskit_aer": "qiskit-aer", "qiskit_ibm_runtime": "qiskit-ibm-runtime", "qiskit_mitigation": "qiskit-mitigation", "qiskit_noise_learning": "qiskit-noise-learning", "samplomatic": "samplomatic"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import warnings

import numpy as np
from qiskit.circuit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp
from qiskit_mitigation.utils import get_measurement_bases

warnings.filterwarnings("ignore")

def construct_ising_circuit(
    num_qubits: int,
    num_trotter_steps: int,
    rx_angle: float,
) -> QuantumCircuit:
    circuit = QuantumCircuit(num_qubits)

    for _ in range(num_trotter_steps):
        circuit.rx(rx_angle, range(num_qubits))
        for first_qubit in (1, 2):
            for idx in range(first_qubit, num_qubits, 2):
                # equivalent to Rzz(-pi/2):
                circuit.sdg([idx - 1, idx])
                circuit.cz(idx - 1, idx)

    return circuit

def prepare_basis(
    circuit: QuantumCircuit, basis: list[int]
) -> QuantumCircuit:
    # basis is a list of integer values from 0 to 3. These map to the basis measurement as:
    # 0 = I; 1 = Z; 2 = X; 3 = Y
    assert len(basis) == circuit.num_qubits

    out_circ = circuit.copy_empty_like()
    for qb, bas in enumerate(basis):
        if bas == 2:
            out_circ.h(qb)
        elif bas == 3:
            out_circ.rx(-np.pi / 2, qb)

    out_circ.barrier()
    out_circ.compose(circuit, inplace=True)
    return out_circ

def mirror_circuit(circuit: QuantumCircuit) -> QuantumCircuit:
    mirror_circ = circuit.copy_empty_like()
    mirror_circ.compose(circuit.inverse(), inplace=True)
    mirror_circ.barrier()
    mirror_circ.compose(circuit, inplace=True)
    mirror_circ.measure_active()
    return mirror_circ

# define observables
num_qubits = 8  # Width of the Ising chain
# The observable to measure: one X component (on qubit 2) and one Z component (on qubit 5)
target_obs_sparse = [("XZ", [2, 5], 1.0)]
observable = SparsePauliOp.from_sparse_list(
    target_obs_sparse, num_qubits=num_qubits
)

# Determine the measurement basis each qubit requires for this observable.
bases, _ = get_measurement_bases(observable)

# Instantiate the mirrored circuit and prepend the basis-preparation gates
num_trotter_steps = 6
rx_angle = np.pi / 4
circuit = construct_ising_circuit(num_qubits, num_trotter_steps, rx_angle)
mirrored_circuit = mirror_circuit(circuit)
mirrored_circuit = prepare_basis(mirrored_circuit, bases[0])
print("Visualization of 1 mirrored Trotter step")
prepare_basis(
    mirror_circuit(construct_ising_circuit(num_qubits, 1, rx_angle)), bases[0]
).draw("mpl", scale=0.6, fold=-1)
Visualization of 1 mirrored Trotter step

ノイズのある未軽減の期待値を計算する
QuantumProgramには、量子回路とsamplexが、Executorプリミティブに適した形式で含まれます。MitigationTask.prepare は、回路、観測量、パラメーター値から QuantumProgram を構築し、指定されたボクシングオプションで回路をボックス化します。measure_annotations ボクシングオプションを "change_basis" に設定して測定を必要な基底に回転させ、シミュレーターがノイズモデルを回路のボックスにマッピングできるように add_tags: "unique_box" を追加します。プログラムはデフォルトでPauliツワーリングされ、ハードウェア上ではコヒーレントノイズが、軽減手法が想定するPauliノイズに変換されます。num_randomizations は各回路のツワール化されたインスタンスをいくつサンプリングするかを設定し、shots_per_randomization は各インスタンスが受け取るショット数を設定します。したがって、その積が回路あたりのショット上限になります。
QPUにアクセスできる場合は、QiskitRuntimeService のバックエンドから構築した Executor でプログラムを実行できます。この例では AerSimulator を使ってプログラムをローカルで実行します。そのシミュレーターオプション layer_noise_model は、与えられたPauli-Lindbladノイズモデルのノイズを、エンタングリングゲートのすべてのレイヤーに注入します。ここでは、レイヤーゲートあたりのエラー(EPLG)が 0.01 のランダムなPauli-Lindbladノイズモデルを生成します。これは現在の典型的なHeron QPUより約1桁高く、小規模な問題でもSLCを使う効果を拡大して見せるためです。
from qiskit.circuit import CircuitInstruction
from qiskit.quantum_info import PauliLindbladMap, pauli_basis
from qiskit_aer import AerSimulator
from qiskit_ibm_runtime import Executor
from qiskit_mitigation import MitigationTask, find_combined_unique_layers
from samplomatic import Tag
from samplomatic.utils import get_annotation

def generate_random_pauli_lindblad_noise(
    layers,
    num_qubits: int,
    eplg: float = 3e-3,
    seed: int | None = None,
) -> list[tuple[CircuitInstruction, PauliLindbladMap]]:
    """Generate random Pauli-Lindblad noise over the full Pauli basis."""
    layer_noise_model = []
    for layer in layers:
        layer_instructions = layer.operation.params[0]
        contain_measurement = any(
            inst.name.startswith("measure") for inst in layer_instructions
        )
        if contain_measurement:  # do not add measurement noise
            layer_noise = PauliLindbladMap.identity(num_qubits)
        else:
            edges = [
                (inst.qubits[0]._index, inst.qubits[1]._index)
                for inst in layer_instructions
            ]  # extract the edges of the layer

            basis_paulis = [p for p in pauli_basis(2) if np.sum(p.x + p.z)]
            rng = np.random.default_rng(seed=seed)
            num_generators = len(basis_paulis)
            rates = rng.random(len(basis_paulis)) * eplg / num_generators

            layer_noise = PauliLindbladMap.from_sparse_list(
                [
                    (pauli.to_label(), edge, rate)
                    for pauli, rate in zip(basis_paulis, rates, strict=True)
                    for edge in edges
                ],
                num_qubits=num_qubits,
            )
        layer_noise_model.append((layer, layer_noise))
    return layer_noise_model

num_randomizations = 400
shots_per_randomization = 16

boxing_options = {"add_tags": "unique_box"}

# find the unique layers to generate the layered noise for
box_layers = find_combined_unique_layers(
    [mirrored_circuit], custom_boxing_options=boxing_options
)
layer_noise_model = generate_random_pauli_lindblad_noise(
    box_layers, num_qubits, eplg=1e-2, seed=42
)

# a local noisy simulator in place of a QPU backend
noisy_executor = Executor(
    AerSimulator(),
    options={"simulator": {"layer_noise_model": layer_noise_model}},
)

task = MitigationTask()
program = task.prepare(
    circuit=mirrored_circuit,
    observables=observable,
    parameters=None,
    num_randomizations=num_randomizations,
    shots_per_randomization=shots_per_randomization,
    custom_boxing_options=boxing_options,
)

program._semantic_role = "simulation"  # flag the program for the simulator
job_unmit_res = noisy_executor.run(program).result()
unmitigated_res = task.postprocess(job_unmit_res)

print(f"unmitigated result: {unmitigated_res.data.evs[0]}")
unmitigated result: 0.63125
バイアスの順方向および逆方向の上限を計算する
ノイズ学習にQPU時間を費やす前に、SLCは古典シミュレーションを使って、各潜在的なエラーが観測量のバイアスに与える寄与の上限を求めます。これは、相補的な2つのパスで行われます。
-
順方向伝播: 各Pauliエラーを回路の残りの部分を通して順方向に伝播させ、観測量との交換子を評価します。観測量と反可換なエラーだけが結果にバイアスを与えうるため、このパスは各エラーの順方向の影響に対する上限を与えます。
-
逆方向伝播: 各エラーを回路の始めまで逆方向に伝播させ、初期状態との交換子を評価します。回路は全ゼロ状態から始まるため、それと可換なエラーは結果に影響を与えられず、反対方向から上限が引き締められます。
この2つの上限を合わせると、各エラーがバイアスに与える最悪ケースの寄与を狭く挟み込む範囲が得られます。次のステップでは、これらの上限を学習したノイズレートとマージして、どのエラーを補正する価値があり、どのエラーを安全に放置できるかを順位付けします。ここでは、ボックス化された回路内の各 InjectNoise アノテーションが、SLCの上限を関連付けられる一意の識別情報を持つように、inject_noise_strategy="individual_modification" ボクシングオプションが必要です。
より大規模な問題では、これらの計算に多大な古典計算リソースが必要になる場合があります。
from qiskit_addon_slc.bounds import (
    compute_backward_bounds,
    compute_forward_bounds,
    tighten_with_speed_limit,
)
from qiskit_mitigation import PEC

slc_boxing_options = {
    "add_tags": "unique_box",
    "inject_noise_strategy": "individual_modification",
}

slc_pec_task = PEC()

boxed_circuit, noise_model_paulis = (
    slc_pec_task.generate_slc_bounds_computation_input(
        mirrored_circuit, custom_boxing_options=slc_boxing_options
    )
)

forward_bounds = compute_forward_bounds(
    boxed_circuit, noise_model_paulis, observable
)
tighten_forward_bounds = tighten_with_speed_limit(
    forward_bounds, boxed_circuit, noise_model_paulis, observable
)
backward_bounds = compute_backward_bounds(boxed_circuit, noise_model_paulis)
エンタングリングレイヤーのノイズを学習する
各エラーが期待値のバイアスにどれだけ影響するか、またそれを補正するのにどれだけコストがかかるかの最終的な推定を計算するために、ノイズレートを学習し、先に計算したノイズの予測上限に適用します。
PEC(およびPEC+SLC)は、回路内の各エンタングリングゲートのレイヤーについて、ツワール化されたノイズモデルを仮定します。マルコフ型のノイズモデルを仮定する場合、回路の深さは特定のエンタングリングレイヤーのノイズチャネルに影響しないと想定されます。したがって、一意なエンタングリングゲートのレイヤーごとにノイズモデルを学習するだけで済みます。このガイドで使用する回路は、2つの一意なレイヤーに分割できます。一意なレイヤーは個別に学習する必要があるため、ノイズモデルを学習したい場合は、一意なエンタングリングレイヤーの集合が最小になるように回路を設計することが重要です。回路内の一意なレイヤーが多すぎると、多数のレイヤーを学習するためのサンプリングコストのせいで、ノイズ学習が実行不可能になる場合があります。
ノイズの学習には qiskit-noise-learning を使用します。学習器は学習用回路内で各レイヤーを fragment_depths 回繰り返し、各回路を num_randomizations 回ツワール化し、測定された忠実度の減衰をPauli-Lindbladモデルにフィットさせます。これらのパラメーターは、学習したモデルの精度に影響を与えることがあります。学習したノイズモデルが正確であるほど、ノイズキャンセレーションもより正確になります。
次のコードは、2つのレイヤーを1つのマップにまとめた学習済みノイズモデルを描画します。各量子ビットは、2つのレイヤーにわたって合計した重み1のX、Y、Zレートの円グラフで表され、各エッジは学習した重み2のレートを示します。たとえば、3e-4 というレートは、そのレイヤーを10,000回使用するうちおよそ3回その誤りが発生することを意味します。
from qiskit.providers.fake_provider import GenericBackendV2
from qiskit.quantum_info import PauliList
from qiskit_ibm_runtime.results import LayerError, PauliLindbladError
from qiskit_ibm_runtime.visualization.embeddings import Embedding
from qiskit_noise_learning.aer_executor import AerExecutor
from qiskit_noise_learning.noise_learner import LearningOptions, NoiseLearner
from samplomatic import InjectNoise

line_coupling = [(i, i + 1) for i in range(num_qubits - 1)]
backend = GenericBackendV2(
    num_qubits=num_qubits,
    basis_gates=["id", "rz", "sx", "x", "cz"],
    coupling_map=line_coupling,
)

# first learn only the layers PEC will inject noise into, i.e. not the measurement layer
pec_layers = [
    layer
    for layer in slc_pec_task.find_unique_layers(
        mirrored_circuit, slc_boxing_options
    )
    if get_annotation(layer.operation, InjectNoise)
]
layers = slc_pec_task.find_unique_layers(mirrored_circuit, slc_boxing_options)

learning_options = LearningOptions(
    fragment_depths=[2, 4, 8, 16],
    num_randomizations=250,
    shots_per_randomizations=16,
)

# qiskit-noise-learning is not compatible with the Executor in local mode,
# and requires the simulator present in the package for running simulation
noise_dict = {
    get_annotation(layer.operation, Tag).ref: noise_layer
    for layer, noise_layer in layer_noise_model
}
noise_learner_simulator = AerExecutor(
    qasm_simulator=AerSimulator(), noise_dict=noise_dict
)
learner = NoiseLearner(
    backend, options=learning_options, executor=noise_learner_simulator
)
learned_noise = (
    learner.run(pec_layers).result().to_dict()
)  # keyed by InjectNoise reference

# Draw the learned model on the line, laid out as a line with the qubits in order.
# Composing the two layers' maps sums their rates, giving one map over all the edges.
embedding = Embedding(
    [(0, 0), (0, 2), (0, 4), (2, 4), (4, 4), (4, 2), (4, 0), (2, 0)],
    line_coupling,
)
first, second = learned_noise.values()
learned_model = first.compose(second).simplify()
error = PauliLindbladError(
    PauliList(
        learned_model.get_qubit_sparse_pauli_list_copy().to_pauli_list()
    ),
    learned_model.rates,
)
fig = LayerError(circuit, list(range(num_qubits)), error).draw_map(
    embedding, radius=0.4, height=460, width=620
)
fig.update_traces(
    marker={
        "cmin": 0,
        "cmax": max(learned_model.rates),
        "colorbar": {"tickformat": ".1e", "title": "rate"},
    },
    selector={"mode": "markers"},
)
fig.show()

学習したノイズを使って、計算した上限をローカルスケール行列にマージする
古典的な上限(前のステップで計算したもの)と学習したノイズレートの両方が揃ったので、ローカルスケール行列を計算できます。これは、PECが個々のノイズ項をどの程度積極的にキャンセルすべきかを決める、エラーごとの重みです。
SLCの重要な考え方は、すべてのエラーを完全にキャンセルする必要はないということです。順方向と逆方向の上限がどちらも小さいエラーは、そのレートにかかわらず観測量への影響がごくわずかであるため、部分的または完全に未軽減のままにできます。merge_bounds は古典的な上限を学習したPauli-Lindbladレートとマージし、続いて compute_local_scales が、ユーザーが指定した bias_tolerance に従って、各エラーに0(完全に無視)から1(完全にキャンセル)までのスケールを割り当てます。バイアスへの推定寄与が大きいエラーは1に近いスケール(完全なPEC処理)を受け取り、寄与が小さいエラーはより低いスケールを受け取るため、それらが抱えるサンプリングオーバーヘッドが減ります。
SLCは、2つの両極端、つまり通常のPEC(バイアスゼロ、オーバーヘッド最大)と軽減なし(オーバーヘッドゼロ、ノイズによるバイアスが最大)の間で、連続的なつまみを提供します。bias_tolerance パラメーターがこのつまみを制御します。0 に設定すると完全なPECに戻り、より大きな値にすると、より低いサンプリングオーバーヘッド γ² と引き換えに、より大きな残存バイアスを許容します。
このステップでは、bias_tolerance をさまざまな値でスイープし、それぞれについて結果のサンプリングオーバーヘッドを計算します。これらの点を完全なPECのオーバーヘッドと比較してプロットすると、ショット予算に合った動作点を選ぶのに役立ちます。たとえば、5 %の残存バイアスを許容すると、完全なPECに比べてサンプリングオーバーヘッドを1桁削減でき、そうでなければ不可能だった計算を今日のQPUで実行可能にできる場合があります。
import matplotlib.pyplot as plt
from qiskit_addon_slc.bounds import compute_local_scales, merge_bounds

merged_bounds = merge_bounds(
    boxed_circuit,
    tighten_forward_bounds,
    backward_bounds,
    noise_rates=learned_noise,
)

biases = []
costs = []
for bias in [0.0, *np.arange(0.01, 0.11, 0.01).tolist()]:
    _, cost_, bias_ = compute_local_scales(
        boxed_circuit,
        merged_bounds,
        noise_rates=learned_noise,
        bias_tolerance=bias,
    )
    biases.append(bias_)
    costs.append(cost_)

# Compute tha full PEC overhead and compare it with the overhead and bias of different SLC configurations
vanilla_gamma = slc_pec_task.calculate_gamma(
    slc_pec_task.boxed_circuit, learned_noise, 1
)

xticks = np.arange(0, 11, 2)

fig, ax = plt.subplots()
ax.scatter(
    [0], [vanilla_gamma**2], marker="D", c="tab:orange", label="full PEC"
)
ax.plot(
    100 * np.array(biases),
    np.array(costs),
    "o-",
    c="tab:blue",
    label="PEC+SLC",
)
ax.set_xticks(xticks, [f"{x:.2f}" for x in xticks])

ax.set_xlabel("Remaining bias [%]")
ax.set_ylabel(r"Sampling overhead, $\gamma^2$")
ax.grid()
ax.legend()
fig.suptitle("PEC sampling overhead reduction due to SLC")
Optimal spacetime partitioning not implemented! Just partitioning list of noisy boxes.
Text(0.5, 0.98, 'PEC sampling overhead reduction due to SLC')

ショットオーバーヘッドとバイアスのトレードオフに基づいて、望ましいバイアス上限を選ぶ
このガイドでは、バイアス許容値を5%とします。このバイアスの計算は学習したノイズモデルに基づいており、デバイスの実際のノイズと完全には一致していない可能性があることに注意してください。
chosen_bias_threshold = 0.05
local_scales, sampling_cost, bias = compute_local_scales(
    boxed_circuit, merged_bounds, learned_noise, bias_tolerance=bias
)
slc_pec_task.set_slc_local_scales(
    local_scales, float(np.sqrt(sampling_cost)), bias
)
PEC + SLCプログラムを準備し、実行して後処理する
ローカルスケールを選んだので、完全なPEC+SLC実行プログラムを構築できます。PEC.prepare の呼び出しは、反ノイズ注入戦略を回路のボックスアノテーションにエンコードした QuantumProgram を構築します。noise_gain="slc_local_scales" を渡すと、通常のPECのようにすべてのエラーに同じ完全な逆ノイズゲインを適用するのではなく、set_slc_local_scales で設定されたエラーごとの重みを使用するようExecutorに指示します。
公平な比較を行うために、noise_gain=0 を指定した2つ目の PEC タスクを準備します。これはSLCのバイアス許容なしの完全なPECキャンセレーションに相当します。両方のプログラムは同じ QuantumProgram に追加されて1つの実行ジョブを共有するため、それらの回路はインターリーブされて一緒に実行され、ハードウェアのドリフトは両方に等しく影響します。
ジョブが完了した後、postprocess は、各タスクに適切なPECの再スケーリング係数 γ を適用して、生の測定ビット列を期待値に変換します。
program_pec = slc_pec_task.prepare(
    circuit=mirrored_circuit,
    observables=[observable],
    parameters=None,
    num_randomizations=num_randomizations,
    shots_per_randomization=shots_per_randomization,
    custom_boxing_options=slc_boxing_options,
    noise_maps=learned_noise,  # PEC option
    noise_gain="slc_local_scales",  # PEC option. Defines the usage of SLC
    max_sampling_overhead=100,  # PEC option
)

full_pec_task = PEC()
program_pec = full_pec_task.prepare(
    circuit=mirrored_circuit,
    observables=[observable],
    parameters=None,
    num_randomizations=num_randomizations,
    shots_per_randomization=shots_per_randomization,
    custom_boxing_options=boxing_options,
    quantum_program=program_pec,
    noise_maps=learned_noise,  # PEC option
    noise_gain=0,  # PEC option
    max_sampling_overhead=100,  # PEC option
)

# Execute
program_pec._semantic_role = (
    "simulation"  # flag the program for the simulator
)
job_pec_results = noisy_executor.run(program_pec).result()

# post-processing
pec_slc_res = slc_pec_task.postprocess(job_pec_results)
full_pec_res = full_pec_task.postprocess(job_pec_results)
軽減された期待値とショットオーバーヘッドを比較する
ミラー回路の理想的な期待値は構成上1であるため、どの推定値のバイアスも単純に |1 - result| です。この最後のセルは、3つのシナリオについてバイアスと総ショット数を並べて出力します。
-
未軽減: エラーキャンセレーションを適用していない、ノイズのある生の期待値。
-
完全なPEC: すべてのレイヤーで完全な逆ノイズモデルを使用した、バイアスゼロのエラーキャンセレーション。完全な γ² のサンプリングオーバーヘッドを伴います。
-
PEC+SLC: shaded-lightconeのローカルスケールに導かれたエラーキャンセレーション。選択した
bias_toleranceを許容する代わりに、ショット数を大幅に減らします。
3つの行を比較すると、SLCの具体的な利点がわかります。PEC+SLCの軽減後のバイアスは未軽減のバイアスをはるかに下回ったまま、総ショット数は完全なPECが必要とした数よりも大幅に少なくなります。
print(
    f"Unmitigated result bias: {np.abs(1 - unmitigated_res.data.evs[0]) * 100:.2f}%, \
total shots ran: {job_unmit_res[0]['_meas'].shape[0] * job_unmit_res[0]['_meas'].shape[2]}"
)

print(
    f"Full PEC final result bias: {np.abs(1 - full_pec_res.data.evs[0]) * 100:.2f}%, \
total shots ran: {job_pec_results[1]['_meas'].shape[0] * job_pec_results[1]['_meas'].shape[2]}"
)

print(
    f"PEC+SLC final result bias: {np.abs(1 - pec_slc_res.data.evs[0]) * 100:.2f}%, \
total shots ran: {job_pec_results[0]['_meas'].shape[0] * job_pec_results[0]['_meas'].shape[2]}"
)
Unmitigated result bias: 36.88%, total shots ran: 6400
Full PEC final result bias: 0.97%, total shots ran: 48528
PEC+SLC final result bias: 1.46%, total shots ran: 24480