量子機械学習入門
概要とモチベーション
量子機械学習へようこそ!
以下の動画では、下記のテキストを補足する簡単な紹介を行います。
動画の内容を簡単に振り返り、補足します:
-
ある問題が初めて量子コンピュータで解かれ、その後、古典的なスーパーコンピュータでも解く方法が見つかるというサイクルが見られています。このように古典コンピューティングと量子コンピューティングがお互いの限界を押し上げるサイクルは、しばらく続く可能性があります。
-
エラーの削減や利用可能な量子ビット数の増加といった分野の進歩を前提とすれば、量子コンピューティングが古典コンピューティングに対して証明可能な優位性を持てる特定の問題が存在します。しかし、量子に適したデータセットや有用な量子特徴マップを探索する時代はまだ続いています。
-
量子機械学習(QML)は、量子コンピューティングが既存の古典的なワークフローを強化・補完できる多くの興味深い分野の一つです。
機械学習(ML)はデータセットにアルゴリズムを適用するものであり、QML にはデータ側またはアルゴリズム側(あるいは両方)に量子力学が含まれる可能性があります。これらすべての可能性は潜在的に興味深いものです。しかし、私たちは主に古典的データに適用される量子アルゴリズムの議論に限定します。理由の一つは、古典的データを用いた ML 問題がすでに非常によく研究されており、広く利用可能であることです。古典的データから始まる問題を解くことへの関心は広く存在します。もう一つの理由は QRAM の欠如です。量子データを比較的長い時間スケールで大量に保存する能力がなければ、量子データから始まる手法はまだ産業への応用からかなり遠い状態にあります。また、古典的データに効率的に「量子的にアクセス」する方法も明確ではありません。特に興味深い ML の種類として、ラベル付きデータセットを使ってアルゴリズムを訓練する教師あり学習と、アルゴリズムがラベルなしサンプルから分布を学習しようとする教師なし学習があります。教師なしアルゴリズムは、例えば同じ分布から新しいサンプルを生成する方法や、類似した特性を持つグループにサンプルをクラスタリングする方法を学習することがあります。
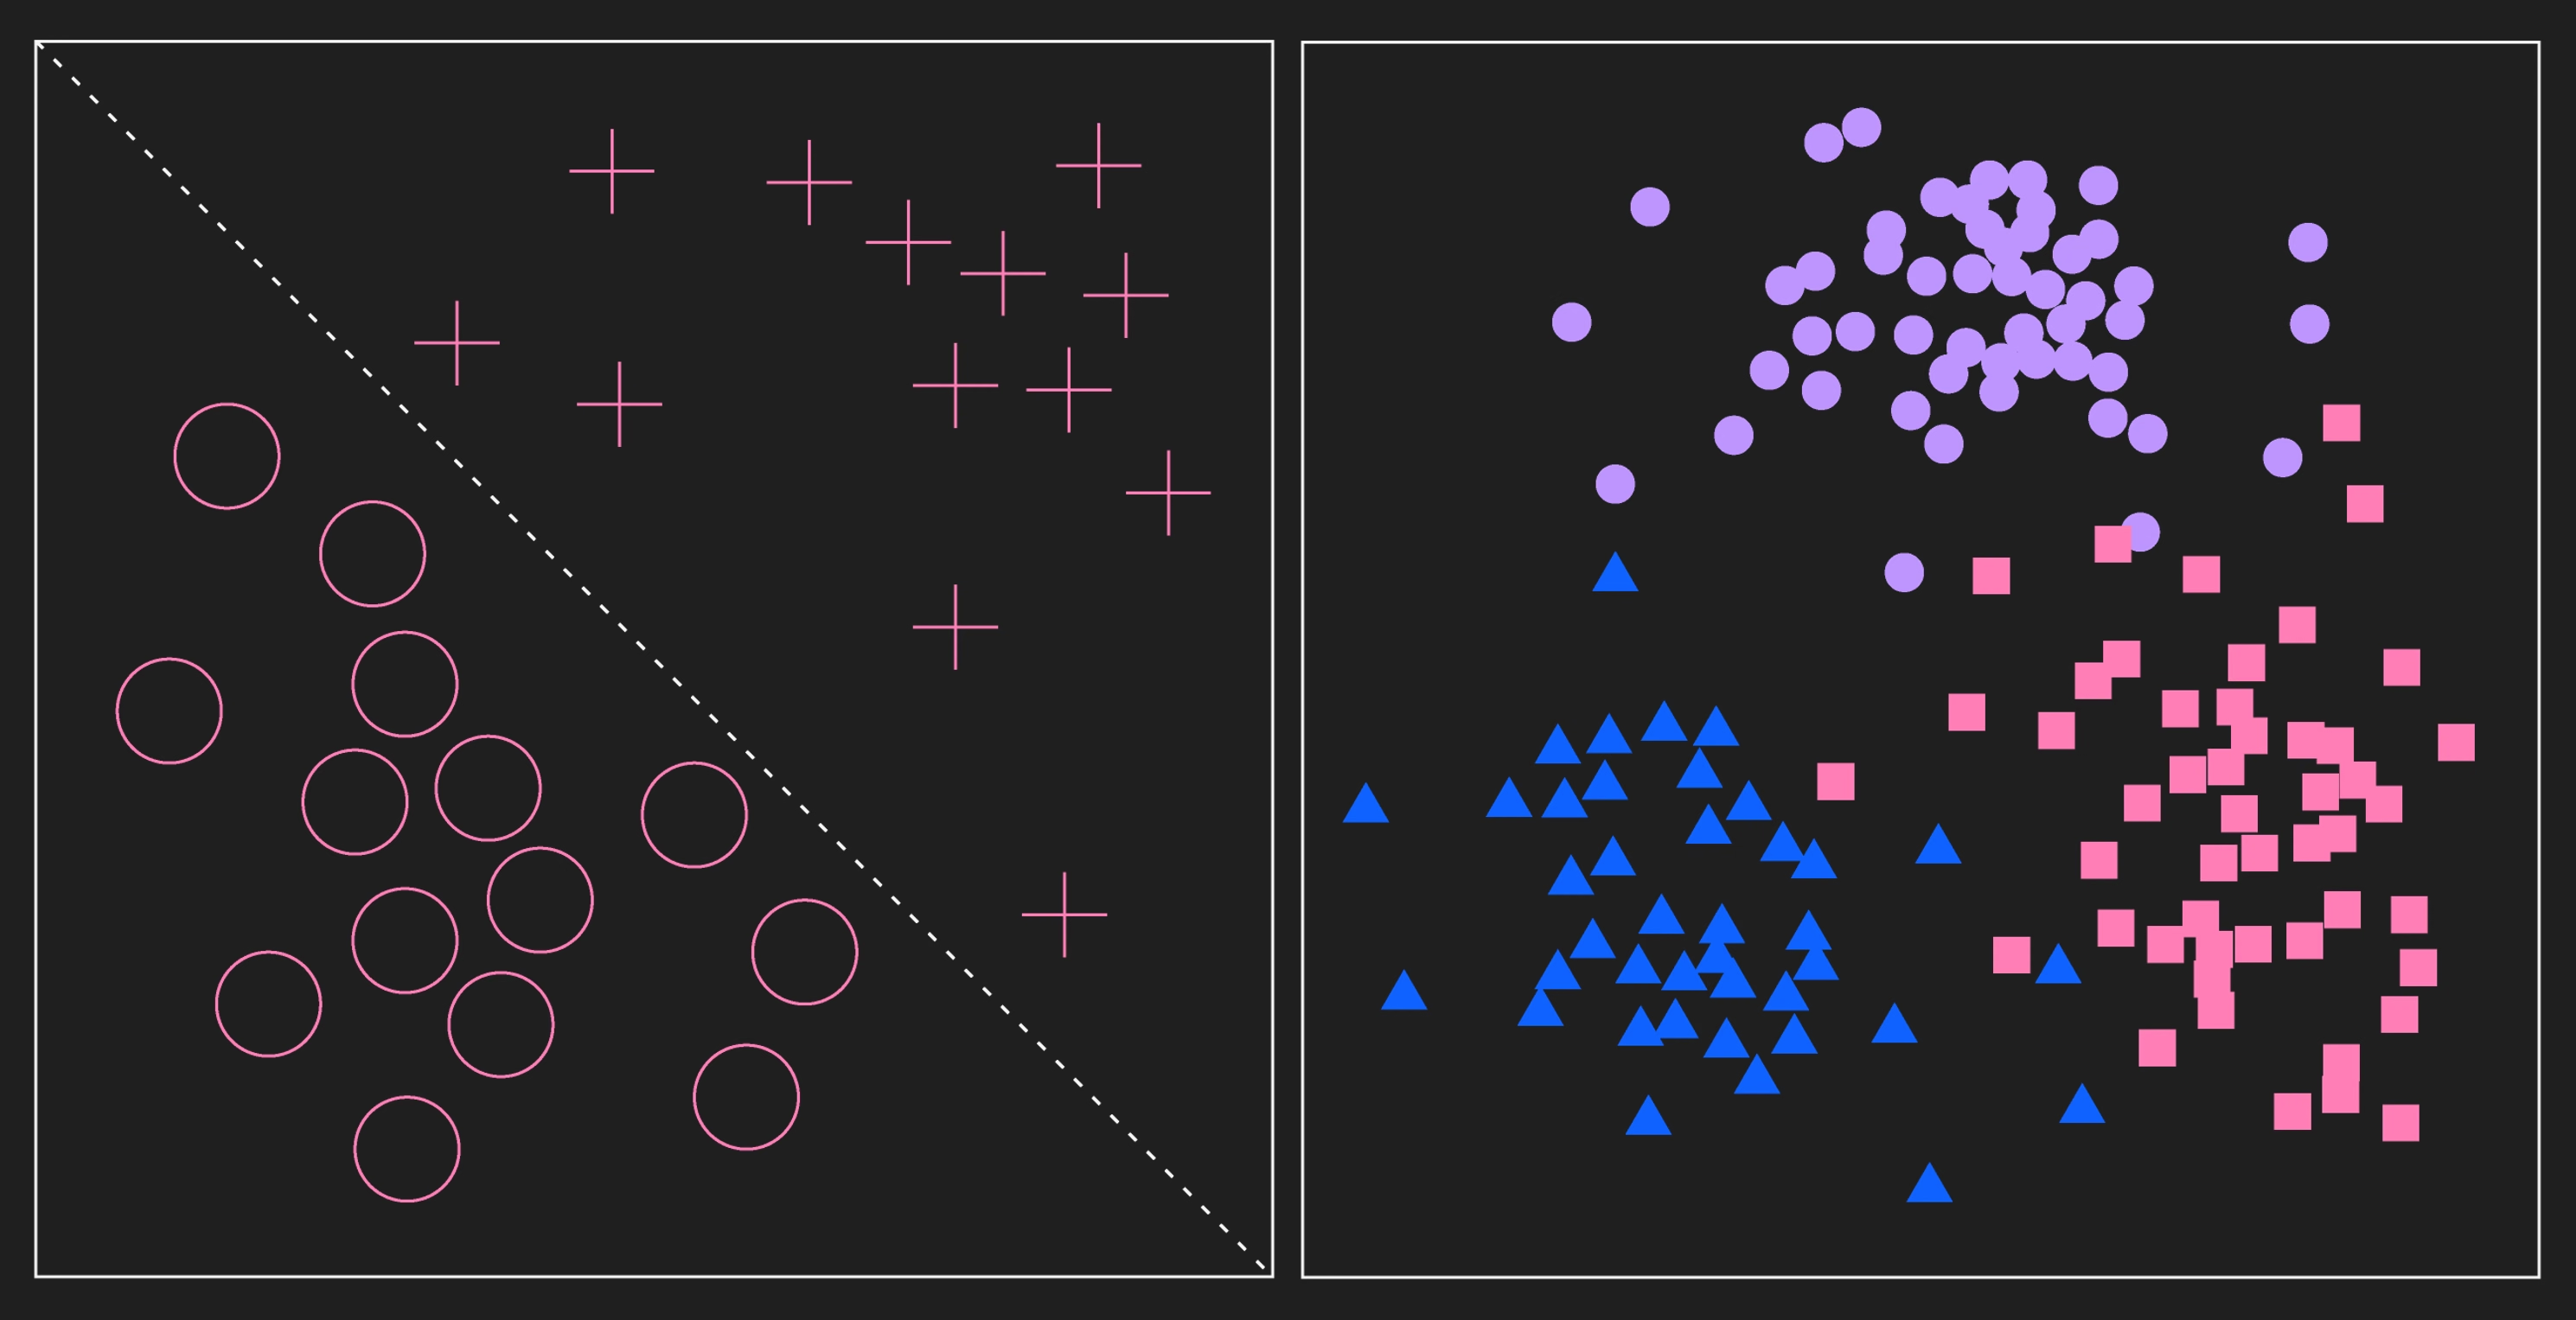
左の画像は教師あり学習のようにラベル付きされた2つのカテゴリのデータを示しています。この場合、カテゴリは線形分離可能です。右の画像はデータのクラスターを示しています。教師なし学習タスクでは、これらのデータは最初はラベル付けされておらず、アルゴリズムが分布を調べ、クラスターを探索します。アルゴリズムが識別するクラスターの例を可視化するために、データポイントにラベルが付与されています。二つの主な違いは、教師あり学習プロセスはデータが既にラベル付けされた状態から始まり、教師なしプロセスはデータが最終的にラベル付けされる場合でも、最初はラベルなしデータから始まる点です。
機械学習の背景知識を持つ方は、多くの解法がデータをより高次元の空間に写像することを伴うことをご存知でしょう。これはカーネルの文脈で特によく研究されています。簡単に復習すると、データがデータと同じ次元数の直線、平面、または超平面(コンパクトに表現するために「超平面」と呼ぶことにします)によってカテゴリに分離できる場合があります。これは上の最初の画像に示されています。一方、そのような次元では超平面によって分離できない場合もあります(2番目の画像を参照)。しかし、高次元への写像で活用できる構造がデータに存在する場合があり、その高次元空間ではデータが分離可能になります。これは、円形対称性を持つ 2D データを、データポイントが放物面に沿って配置される 3D 空間に写像する例で示されています。
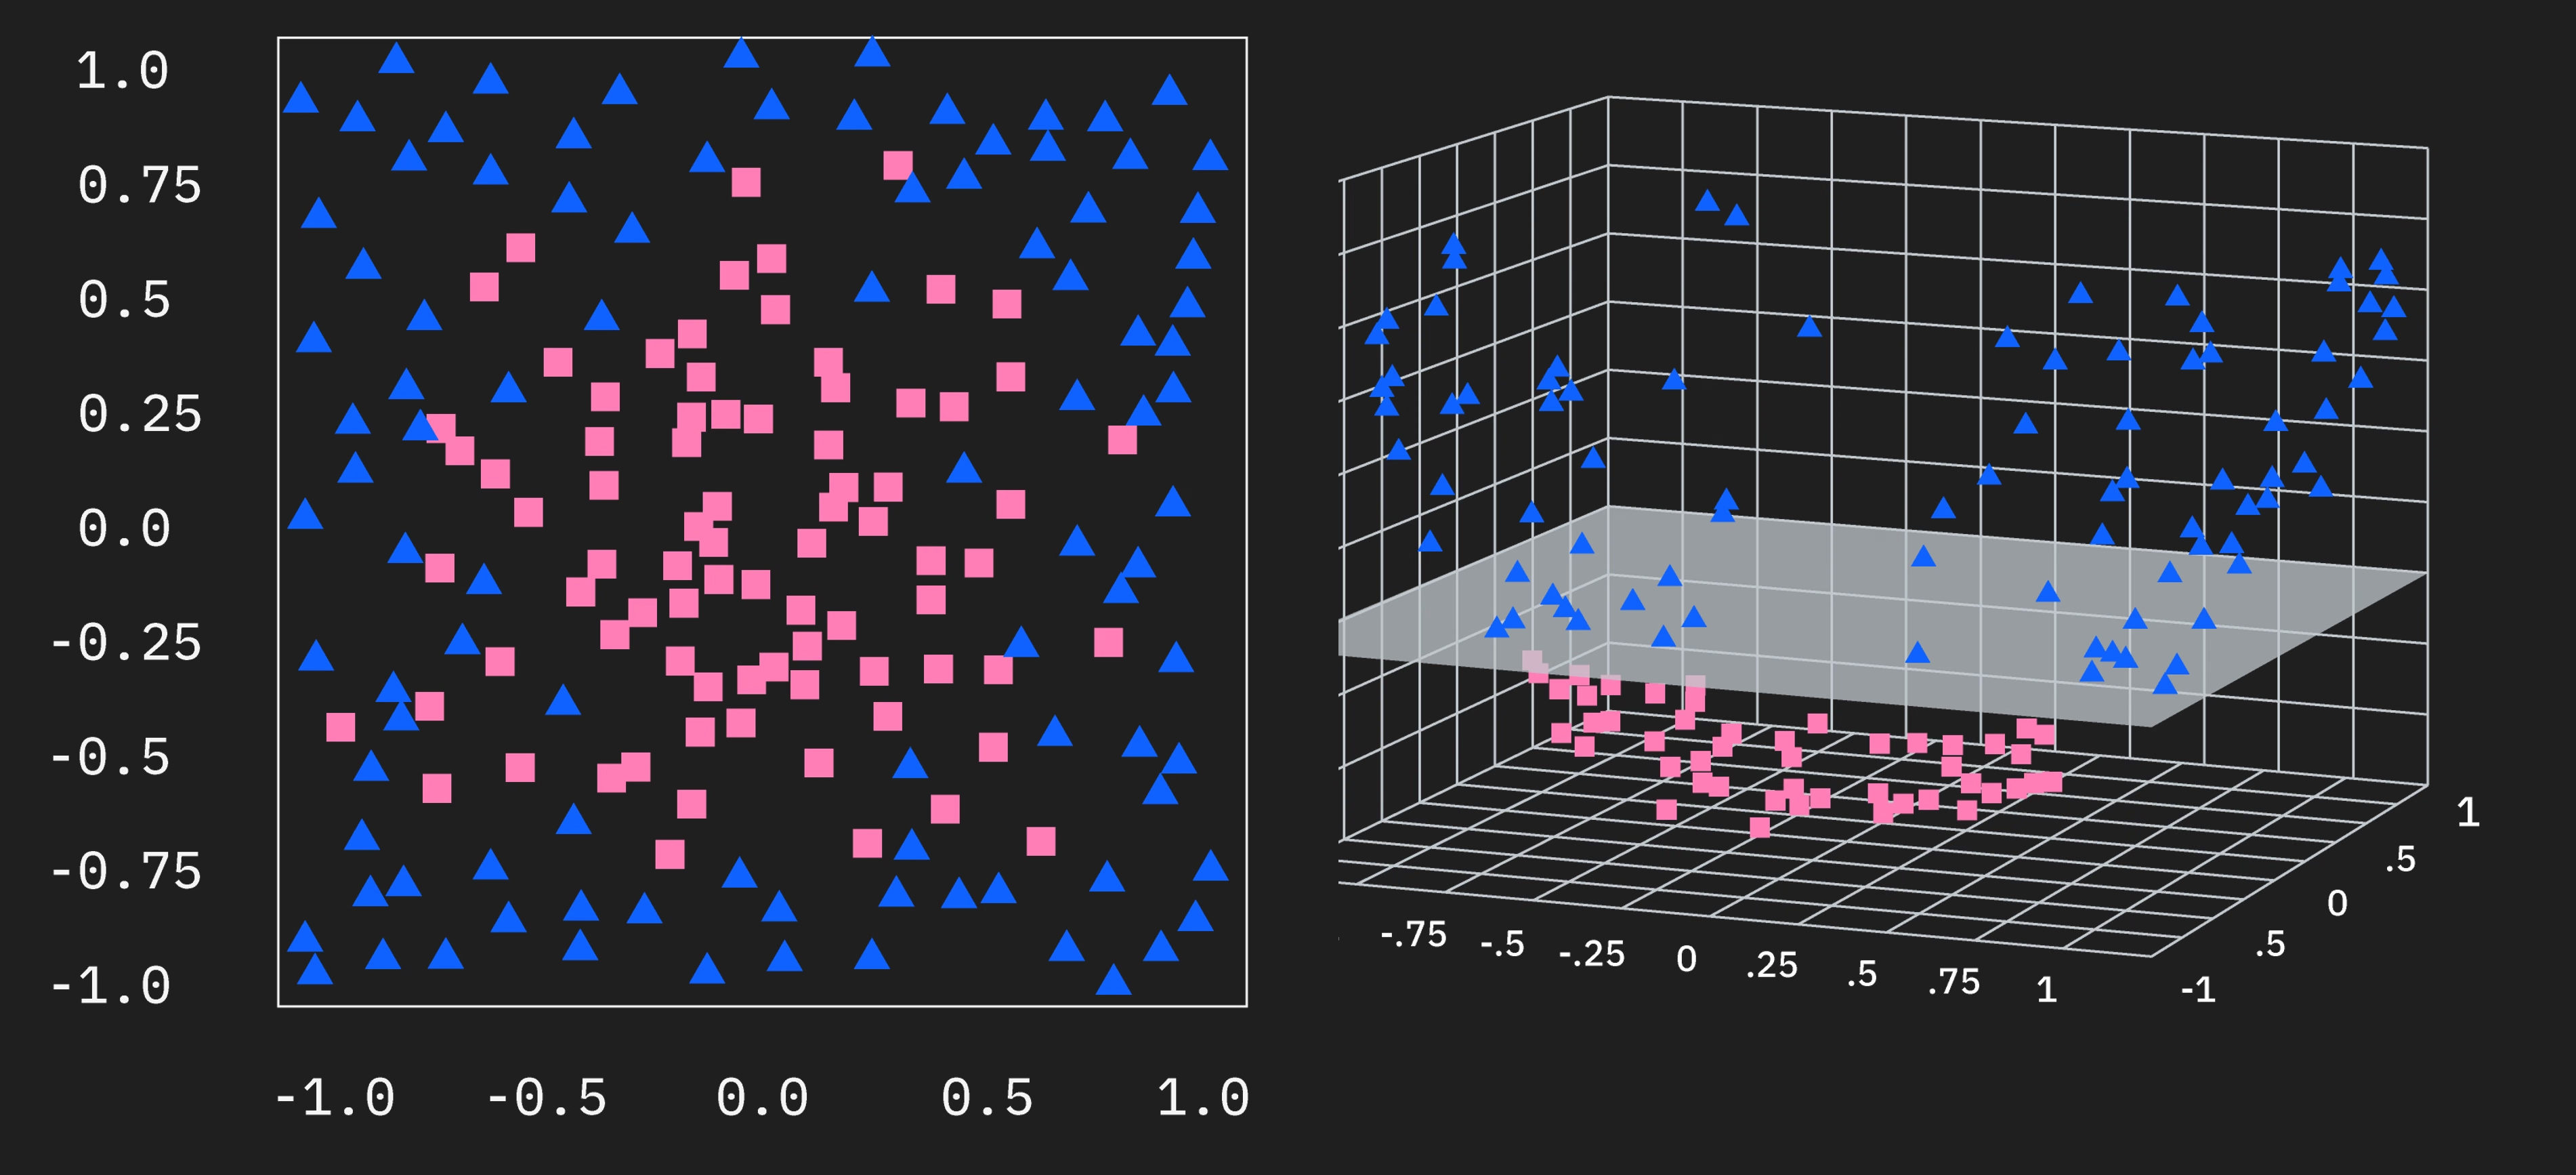
QML における共通の目標は、低次元の特徴セットからより高次元の空間への写像を見つけることで、データポイントを効果的に分離し、その写像を使って新しいデータポイントを分類できるようにすることです。 しかし、これは簡単なタスクではありません。機械学習における量子コンピューティングの潜在的な有用性についての議論は、適切な注意事項を伴う必要があります。特に、データセット選択における微妙な点や、実用スケールへの到達における課題に対処する必要があります。また、古典的なアルゴリズムによって既に効率的かつ適切に処理されているデータについて、古典的な ML アルゴリズムを上回ることを目指すのではなく、有用な可能性がある新しい特徴マップの探索へと議論の焦点を移す必要があります。
期待値の管理
文献に記述されている QML アプリケーションで使用される多くのデータセットは「特徴量エンジニアリングされている」ものであり、量子コンピューティングが有用であるという狭い使用事例を示すために特別に選択または生成されたデータセットを意味します。これが不正行為のように見えるとすれば、それは目の前のタスクを誤解しているということです。一部の量子特徴マップがすべてまたは多くの分類タスクを古典的機械学習アルゴリズムよりも効率的またはスケーラブルに解決できる、ということはありません。むしろ、一部の量子特徴マップ(すべてではない)は古典的な特徴マップとは異なる振る舞いをします。目の前のタスクは、複雑なデータ構造の文脈で量子回路を探索することです。取り組むべき具体的な質問は以下の通りです:
- 古典的な代替手法と比較して、最も新規な振る舞いをする可能性が高い量子回路はどれか?
- そのような新規な量子回路を使って最もよく探索できる特性を持つデータが関係する、実世界の問題は存在するか?
- これらの量子回路は近期の量子コンピュータでスケールするか?
不十分な説明
量子コンピューティングがどのように強力になれるかについて、簡略化された説明によく出会います。それはおおよそ次のようなものです:
古典コンピュータがビットの情報を使うように、量子コンピュータはキュービットを使います。例えば4ビットが与えられた場合、古典コンピュータは 通りの可能な状態のいずれか一つを取ることができますが、量子コンピュータは16の状態すべての重ね合わせに同時に存在でき、この重ね合わせ全体に対して演算を実行できます。場合によっては、これにより高次元空間への写像に基づく潜在的に興味深い学習アルゴリズムを自然に設計できます。
これは真の発言ですが、不十分であり、これから説明するように少し誤解を招く面があります。また、複素数係数と実数係数の違いが強調されることもあります:
システムが異なる状態にある確率を持つと記述できる確率論的な古典システムは、次のように表すことができます。
このようなシステムでは、係数 、、 などは、正の実数の場合にのみ意味を持ちます。量子コンピュータの状態は複素数になり得る確率振幅によって記述されます。
上記の発言は非常に慎重に述べられており、真実です(表面的に似た多くの発言は誤りです)。しかし、これらの正しい発言は機械学習における量子コンピューティングの力の説明にはなっていません。まず、機械学習への量子コンピューティングの応用には測定が必要であり、量子ビットが複数の状態に同時にある状態を測定することはできません。 のような重ね合わせ状態にキュービットを準備できますが、測定結果は または のどちらかになります。したがって最低限、次元性の増大に関するこの話は不完全です。さらに、カーネルの文脈では、量子コンピューティングにおける次元の増大は、古典的な代替手法に対する計算能力の十分条件にはなりません。なぜならガウスカーネルは無限次元だからです。ガウス特徴マップは無限次元のマップされたベクトルを計算する必要を回避する「カーネルトリック」と組み合わせてのみ使用されるという微妙な点がありますが、要点は変わりません:
エンタングルした量子状態の高次元性は指数的な並列性ではなく、機械学習における性能向上の十分条件でもありません。
以降のレッスンでは、量子回路を機械学習タスクに組み込むためのワークフローを紹介します。これは量子コンピューティングの力の探索を容易にするという明確な目的で行います。このコースのどの特徴マップやアルゴリズムも、一般的な問題に対してより良い機械学習結果への近道として提示されることはありません。なぜなら、そのような特徴マップやアルゴリズムは存在しないからです。むしろ、有用な量子コンピューティングの探索に使用するための幅広い量子ツールを提示します。
脱量子化
脱量子化(Dequantization)とは、特定のタスクセット(通常はスケーリングを含む)について、ある量子アルゴリズムと同様に機能する古典アルゴリズムへの置き換えを指します。定義によっては、古典的アルゴリズムが量子アルゴリズムより多項式的にしか遅くない場合を指すこともあります。
当初、古典的アルゴリズムに対して大きな高速化を提供すると考えられていたいくつかの量子機械学習(QML)アルゴリズムが、近年脱量子化されています。この脱量子化のプロセスにより、機械学習への量子的アプローチの潜在的な優位性と限界について重要な洞察が得られました。
最も注目すべき脱量子化の結果の一つは、Ewin Tang のレコメンデーションシステムに関する研究から来ています。Tang は、以前は量子コンピュータでのみ達成可能と考えられていた速度でレコメンデーションタスクを実行できる古典的アルゴリズムを発見しました。この発見は、量子アルゴリズムがこの問題において指数的な優位性を持つという仮定に疑問を呈しました。Shin らによるより最近の研究では、変分量子機械学習モデルの関数クラスの脱量子化可能性の条件を特定することに焦点が当てられています。
脱量子化への一般的なアプローチの一つ(唯一の手法ではありませんが)は、データ読み込みのオーバーヘッドを考慮することです。つまり、古典的データに適用される量子アルゴリズムには、古典的データが量子コンピュータにエンコードされるステップが必ず存在します。量子アルゴリズムが量子データが既に利用可能な開始点を仮定する場合、事実上エンコードに必要な時間を隠していることになります。量子データを仮定することが合理的な文脈もありますが、多くの関心のある応用は古典的データから始まります。いくつかの脱量子化の事例では、このエンコード時間を含めた場合、かつ古典的なデータ読み込みが効率的に達成できる場合に、量子アルゴリズムが古典的な対応物を上回らなくなることが示されています。
アルゴリズムが脱量子化できないとしても、それがすべての古典アルゴリズムより効率的またはスケーラブルであることを意味するわけではありません。極端で作為的な例として、サイズ k の集合から最大の j 個の要素を選び出すアルゴリズムを想像してください。k 個の各要素を Shor のアルゴリズムで素因数分解し、その素因数を使って最大の要素を決定する量子アルゴリズムを書くこともできるでしょう。このようなアルゴリズムはおそらく脱量子化できませんが、同じ最大要素の選択を行う古典アルゴリズム(不要な素因数分解の部分を除く)よりも劇的に非効率です。
存在証明
2021年、IBM Quantum® の研究者である Yunchao Liu、Srinivasan Arunachalam、Kristan Temme は Nature に論文 A rigorous and robust quantum speed-up in supervised machine learning を発表しました。上記の注意事項と一致して、この研究では(1)古典的に難しいことが知られており、(2)量子アルゴリズムが高速化を示すのに適している、という条件を満たす分類問題が慎重に選択されました。
この論文は離散対数に基づくデータの分類を扱っています。論文を引用すると、「大きな素数 と の生成元 に対して、 の入力に対して を、 を表すのに必要なビット数 の多項式時間で計算できる古典アルゴリズムは存在しないという、広く信じられている予想がある」とされています。一方、Shor のアルゴリズムは多項式時間で離散対数問題を解くことが知られています。この問題の選択は、上記の基準を同時に満たしています:古典的な困難性(脱量子化される可能性が低い)と、量子アルゴリズムに適していることが知られているという点です。
この分類問題の慎重な選択により、著者たちは量子カーネル法(以下で簡単にスケッチし、後のレッスンで詳しく説明します)を使って、エンドツーエンドかつロバストな指数的高速化を示すことができました。ここで「エンドツーエンド」とは古典的データから始まるという仮定に関するものを指し、著者たちはこの場合データエンコードの時間を含めています。「ロバスト」とは、量子アルゴリズムを使って分類されるデータが広いマージンで分離されており、有限サンプリング誤差などの実世界の考慮事項に対して分類の成功がロバストであることを指します。
これらはすべて、量子カーネルが指数的高速化をもたらせる問題が確かに存在することを示しています。しかし現在の科学の状態では、そのような問題は量子アルゴリズムに適しているはずだという観察または理論的な正当化に基づいて選択されています。古典コンピュータがすでに非常によく処理している機械学習タスクで量子的高速化を期待することは現実的ではありません。
量子ユーティリティの探索のためのそのような理想的なケースを特定することは、このコースの学習者にとって大きな責任です。そして、このようなコースで達成できるタスクではありません。その探索は、あなたのような研究者で構成される IBM Quantum Network 全体のタスクです。このコースでは QML のワークフローとエンコーディング戦略を示すことで、あなたが自分の専門分野で量子ユーティリティを探索し始められるようにします。
この入門が量子機械学習についていくつかのことを明確にしたことを願っています:
- 量子アルゴリズムは、古典的に難しく量子アルゴリズムに適した非常に特定の問題において、古典的アルゴリズムに対して指数的高速化を提供できます。
- 量子コンピューティングにおけるエンタングルした状態の高次元性は重要ですが、古典的アルゴリズムに対して優位性を得るための十分条件ではありません。
- 量子アルゴリズムに適した問題を見つけることは非常に難しいタスクであり、それは主にこのコースの学習者に委ねられます。
チェックイン質問
量子状態と古典状態の違いは何ですか?
Answer
多くの違いがあります。特に注目すべきは:複素係数と、単一のコピーによる重ね合わせです。エンタングルメントや干渉など、今後のレッスンで議論される他の多くの違いもあります。
正しいか誤りか?高度にエンタングルした量子状態により、大半の機械学習問題を量子コンピューター上でより効率的に解くことができる。
Answer
誤り。ほとんどの機械学習問題は古典アルゴリズムによって非常に効率的に解決されており、量子アルゴリズムが大幅な高速化をもたらす可能性は低いです。QML における目標は、量子状態でうまく記述できる特徴を持つデータセットを見つけることや、モデルの精度を最適化するデータ特徴のマッピングを見つけることです。
コースの学習目標
このコースを修了することで、以下のコアスキルとコンピテンシーを身につけることが期待できます。学習者は以下のことができるようになります:
-
QML とは何か、量子が古典的機械学習にどう接続するかを説明できる。
-
ML ワークフローに量子の語彙と主要用語を適用できる。
-
QML ワークフローの主要なコンポーネント(様々な種類)を特定できる。
-
さまざまな種類の QML を特定し、区別できる。
-
IBM Quantum プリミティブを使用し、Qiskit パターンに従って、量子カーネル法と変分量子分類器を実装します。
-
QML が最も有望な場合と、そうでない場合を特定できる。
-
例題の問題を自分自身のデータセットに合わせて調整できる。
-
QML における学習時間、ノイズ、複数状態読み出しにおける誤差の積算などの問題を認識できる。
-
QML が自分の組織にどこで恩恵をもたらす可能性があるかについて推薦できる。
コース構成
このコースはいくつかのレッスンで構成されています。各レッスンには、新しいスキルを練習したり、進めながら理解度を確認したりできるチェックイン質問がテキスト全体に散りばめられています。これらは必須ではありません。
コースの終わりには20問のクイズがあります。Credly を通じて量子機械学習バッジを取得するには、このクイズで70%以上のスコアを獲得する必要があります。70%以上のスコアを獲得すると、バッジは自動的に間もなくメールで送られてきます。クイズは2回まで提出できます。最初の提出後、間違えた問題に再挑戦する機会があります。2回目の提出後、スコアは確定します。詳細はクイズを参照してください。
コース構成は以下の通りです:
-
レッスン1:はじめにと概要
-
レッスン2:機械学習の復習
-
レッスン3:データエンコーディング
-
レッスン4:量子カーネル法とサポートベクターマシン
-
レッスン5:変分量子分類器 / ニューラルネットワーク
-
バッジのための試験
最初の QML コードを実行する
多くの場合、細かく分解して背景を深く掘り下げる前に、どこへ向かっているかを見ておくことは有益です。以下のコードセルは、量子カーネル法の単純な例を実行します。具体的には、単一のカーネル行列要素が計算されます。カーネル法や量子カーネルに不慣れなユーザーは怖気づく必要はありません。このコースの複数のレッスンで、これらのセルで行われていることを正確に分析することに専念します。
このコードで同時に Qiskit パターンを紹介します:ユーティリティスケールでの量子コンピューティングへのアプローチのためのフレームワークです。このフレームワークは、非常に一般的で大半の問題に適用できる4つのステップで構成されています(ただし、一部のワークストリームでは特定のステップを複数回繰り返す場合があります)。
Qiskit パターン:
-
ステップ1:古典的な入力を量子問題にマッピングする
-
ステップ2:量子実行のために問題を最適化する
-
ステップ3:IBM Quantum プリミティブを使用して実行する
-
ステップ4:分析 / 後処理
以下のセルでは、各ステップの簡単な説明のみを提供します。詳しく学ぶための適切なレッスンを見つけるのに十分な情報です。
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"numpy": "numpy", "pandas": "pandas", "qiskit": "qiskit"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
# Import some qiskit packages required for setting up our quantum circuits.
from qiskit.circuit import Parameter, ParameterVector, QuantumCircuit
from qiskit.circuit.library import unitary_overlap

# Import StatevectorSampler as our sampler.
from qiskit.primitives import StatevectorSampler

# Step 1: Map classical inputs to a quantum problem:

# Start by getting some appropriate data.
# The data imported below consist of 128 rows or data points.
# Each row has 14 columns that correspond to data features, and a 15th column with a label (+/-1).
!wget https://raw.githubusercontent.com/qiskit-community/prototype-quantum-kernel-training/main/data/dataset_graph7.csv

# Import some required packages, and write a function to pull some
# training data out of the csv file you got above.
import pandas as pd
import numpy as np

def get_training_data():
    """Read the training data."""
    df = pd.read_csv("dataset_graph7.csv", sep=",", header=None)
    training_data = df.values[:20, :]
    ind = np.argsort(training_data[:, -1])
    X_train = training_data[ind][:, :-1]

    return X_train

# Prepare training data
X_train = get_training_data()

# Empty kernel matrix
num_samples = np.shape(X_train)[0]

# Prepare feature map for computing overlap between two data points.
# This could be pre-built feature maps like ZZFeatureMap, or a custom quantum circuit,
# as shown here.
num_features = np.shape(X_train)[1]
num_qubits = int(num_features / 2)
entangler_map = [[0, 2], [3, 4], [2, 5], [1, 4], [2, 3], [4, 6]]
fm = QuantumCircuit(num_qubits)
training_param = Parameter("θ")
feature_params = ParameterVector("x", num_qubits * 2)
fm.ry(training_param, fm.qubits)
for cz in entangler_map:
    fm.cz(cz[0], cz[1])
for i in range(num_qubits):
    fm.rz(-2 * feature_params[2 * i + 1], i)
    fm.rx(-2 * feature_params[2 * i], i)

# Pick two data points, here 14 and 19, and assign the features to the circuits as parameters.
x1 = 14
x2 = 19
unitary1 = fm.assign_parameters(list(X_train[x1]) + [np.pi / 2])
unitary2 = fm.assign_parameters(list(X_train[x2]) + [np.pi / 2])

# Create the overlap circuit
overlap_circ = unitary_overlap(unitary1, unitary2)
overlap_circ.measure_all()
overlap_circ.draw("mpl", scale=0.6, style="iqp")

# Step 2: Optimize problem for quantum execution

# Use IBM Quantum Compute Service to get the least busy backend for running on real quantum computers.
# from qiskit_ibm_runtime import QiskitRuntimeService

# service = QiskitRuntimeService(channel="ibm_quantum")
# backend = service.least_busy(
#    operational=True, simulator=False, min_num_qubits=overlap_circ.num_qubits
# )

# Transpile the circuits optimally for the chosen backend using a pass manager.
# from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager
# pm = generate_preset_pass_manager(optimization_level=3, backend=backend)
# overlap_ibm = pm.run(overlap_circ)

# Step 3: Execute using IBM Quantum primitives

# Specify the number of shots to use.
num_shots = 10_000

## Evaluate the problem using statevector-based primitives from Qiskit
sampler = StatevectorSampler()
counts = (
    sampler.run([overlap_circ], shots=num_shots).result()[0].data.meas.get_int_counts()
)

# Step 4: Analyze and post-processing

# Find the probability of 0.
counts.get(0, 0.0) / num_shots
--2025-05-09 10:04:28--  https://raw.githubusercontent.com/qiskit-community/prototype-quantum-kernel-training/main/data/dataset_graph7.csv
Resolving raw.githubusercontent.com (raw.githubusercontent.com)... 185.199.110.133, 185.199.109.133, 185.199.108.133, ...
Connecting to raw.githubusercontent.com (raw.githubusercontent.com)|185.199.110.133|:443... connected.
HTTP request sent, awaiting response... 200 OK
Length: 49405 (48K) [text/plain]
Saving to: ‘dataset_graph7.csv.2’

dataset_graph7.csv. 100%[===================>]  48.25K  --.-KB/s    in 0.03s

2025-05-09 10:04:29 (1.37 MB/s) - ‘dataset_graph7.csv.2’ saved [49405/49405]
0.8199
上記のすべてのステップを理解する必要はありませんが、なぜこれを行っているのかを理解するために、出力を理解しようとすることは大切です。機械学習の多くのプロセスは、2値分類(その他のことも含め)の一部として内積を使用します。量子力学には明らかなつながりがあります。様々な状態 を測定する確率が、初期状態 との内積 によって与えられるからです。したがって上記で行ったことは、2つのデータポイントの特徴を含む量子回路を作成し、それらを量子ベクトルの空間にマッピングし、測定を行うことでその空間での内積を推定したことです。これは量子カーネル推定の例です。このプロセスは2つのデータポイント(14番目と19番目)に対してのみ実装したことに注意してください。すべての可能なペアに対してこれを行うと、出力(この場合は数値 0.821...)を使って、訓練データセット内のすべてのポイント間のオーバーラップを記述する結果の行列を埋めることができます。これが「カーネル行列」です。
理解度チェック
上記のプロセスで、14番目と19番目のデータ点に対するカーネル行列のエントリを計算しました。同じデータ点を2回(例えば14番目と14番目)使用した場合、どのような値が得られるべきでしょうか?言い換えると、カーネル行列の対角成分はどうあるべきでしょうか?ノイズがない場合について答えてください。ただし、ノイズが存在する場合、答えからの逸脱が生じる可能性があることに注意してください。
Answer
対角成分は 1.0 であるべきです。このプロセスは、あるベクトルとそれ自身との正規化された内積を計算しているはずであり、それは常に1でなければなりません。