リアルタイム・ベンチマークを用いたバックエンド・プロパティの更新
使用量の見積もり: ibm_kingstonで3分(注:これはあくまで見積もりです。実際の実行時間は異なる場合があります。)
学習成果
-
QPUが報告するプロパティがデバイスの現在の挙動から遅れる可能性がある理由と、自分で再測定する価値がある場合
-
5つの標準的な特性評価実験(読み出し、単一量子ビットランダム化ベンチマーク、階層化された2量子ビットランダム化ベンチマーク、、)がそれぞれ何を測定するか
-
1回の呼び出しまたは段階的に、完全な特性評価スイートを実行し、更新されたプロパティを持つバックエンド・オブジェクトを取得する方法
-
測定されたプロパティを報告されたプロパティと比較する方法、および一部の差異がデバイスのドリフトではなく測定手法を反映している理由
前提条件
-
Qiskitパターンのワークフロー
-
Qiskit Runtime実行モード、特に batch mode
-
バックエンド・プロパティやキャリブレーション・データなど、QPU情報を調べる方法
背景
すべてのIBM Quantum® QPUは、各量子ビットが現在どの程度うまく機能しているかを表す一連のプロパティを報告します。緩和時間()、コヒーレンス時間()、読み出し誤り、1量子ビットおよび2量子ビットのゲート誤りです。これらの数値は実際に重要です。トランスパイラはこれらを使用して、回路をどの物理量子ビット上で実行すべきかを決定し、誤り緩和(エラー緩和)手法はこれらに依存し、また、デバイスが実験に十分機能しているかどうかを判断するためにこれらを利用することもあります。
報告されるプロパティは、通常1日に約1回実行されるキャリブレーション手順から得られます。しかし、超伝導量子ビットはより短い時間スケールでドリフトする可能性があり、一時的な欠陥(いわゆる2準位系)が、キャリブレーション時には優れていた量子ビットを一時的に劣化させることがあります。さらに、ジョブは実際に実行されるかなり前にトランスパイルされることが多いため、報告されたプロパティに基づく判断が古い情報に依存している可能性があります。チュートリアル量子ビット選択のためのリアルタイム・ベンチマークでは、これらのプロパティが日々どれほど変動しうるかを示し、個々のQiskit Experimentsから手作業で完全な特性評価ワークフローを構築しています。
このチュートリアルでは、Qiskit Device BenchmarkingのBackendCharacterizationユーティリティを使用することで、そのワークフローの効率化されたバージョンを示します。このユーティリティは、実験の構築、ジョブの送信、曲線フィッティングを数回の呼び出しにパッケージ化します。約70秒のQPU時間を費やすことで、現在のデバイスの状態を反映したプロパティを持つバックエンド・オブジェクトが得られ、報告された値と比較したり、下流のツールに渡したりする準備が整います。
特性評価実験
このスイートは、それぞれ標準的な実験を用いて5つのプロパティを測定します。
-
読み出し誤り (
readout): 各量子ビットはまたはに準備され、すぐに測定されます。誤った状態を読み出す確率が、状態準備と測定(SPAM)誤りを与えます。 -
単一量子ビット・ゲート誤り (
rb_1q): ランダム化ベンチマーク(RB)は、理想的には恒等演算に合成されるランダムな単一量子ビット・クリフォード・ゲートのシーケンスを実行します。生存確率がシーケンス長とともにどのように減衰するかによって、SPAM誤りとは独立に、ゲートあたりの平均誤りが得られます。 -
2量子ビット・ゲート誤り (
rb_2q): 同じRBの考え方を、レイヤー忠実度実験のように、同時に実行される重複のない2量子ビット・ゲートの全レイヤーに適用します。多くのゲートが同時に実行されるため、得られる誤り率にはクロストークの影響が含まれ、深い回路が実際に経験するものに近くなります。 -
(
t1): 各量子ビットが励起され、遅延時間を増やしながら測定されます。励起状態の集団の減衰から緩和時間が得られます。 -
(
t2): ハーン・エコー実験では、各量子ビットを重ね合わせ状態にし、遅延の途中でエコー・パルスを適用し、位相コヒーレンスがどれだけ速く失われるかを測定します。デフォルトでは単一のエコーが使用されますが、マルチエコー(CPMG方式)のバリアントがこのチュートリアルの最後で実演されます。
更新が行うこと・行わないこと
このワークフローを使用する際は、以下の3点に留意してください。
-
更新されたプロパティは、あなたに返されるバックエンド・オブジェクト内にのみ存在します。デバイス自体や、IBM Quantumが他のユーザーに報告するキャリブレーション・データには何も変更はありません。
-
測定された値は、特定の方法論によって取得されたスナップショットです。特に、階層化された2量子ビット誤りと並列化された単一エコーの値は、報告されたキャリブレーション・データとは異なる方法で測定されているため、観測される差異の一部はドリフトではなく方法論によるものです。このチュートリアルでは、それが該当する箇所を指摘します。
-
特性評価自体にはQPU時間がかかります(Heron r2プロセッサーでの完全なスイートで約70秒)。これは最新の情報を得るための代償です。
このワークフローは、Qiskitパターンの4つのステップに従います。
-
ステップ1: 古典的な入力を量子問題にマッピングする。 デバイスと測定するプロパティのセットを選択します。
-
ステップ2: 量子ハードウェア実行のために問題を最適化する。 このユーティリティは、実験回路をデバイスのネイティブ・ゲートで直接構築し、チップ全体に並列化します。
-
ステップ3: Qiskitプリミティブを使用して実行する。 実験はバッチ内のSamplerジョブとして実行されます。
-
ステップ4: 後処理を行い、望ましい古典的な形式で結果を返す。 測定データを量子ビットごとの誤りマップにフィッティングし、バックエンドを更新し、測定されたプロパティを報告されたプロパティと比較します。
必要要件
このチュートリアルを開始する前に、以下がインストールされていることを確認してください。
-
可視化サポート付きのQiskit SDK v2.0以降
-
Qiskit Runtime v0.40以降(
pip install qiskit-ibm-runtime) -
Qiskit Device Benchmarking。これによりQiskit Experimentsもインストールされます(
pip install git+https://github.com/qiskit-community/qiskit-device-benchmarking.git)
セットアップ
必要なライブラリをインポートします。
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"numpy": "numpy", "qiskit_device_benchmarking": "git+https://github.com/qiskit-community/qiskit-device-benchmarking.git", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import logging
import sys

import numpy as np
from qiskit_ibm_runtime import Batch, QiskitRuntimeService

from qiskit_device_benchmarking.utilities.characterization_utils import (
    BackendCharacterization,
    plot_characterization_comparison,
)
特性評価スイートは複数の実験を構築し、複数のジョブを送信し、結果をフィッティングするため、全体として数分かかる場合があります。INFOレベルのロギングを有効にして、各段階が発生するたびに進捗を出力するようにします。
logger = logging.getLogger("qiskit_device_benchmarking")
logger.setLevel(logging.INFO)
logger.addHandler(logging.StreamHandler(stream=sys.stdout))
小規模シミュレーター例
このチュートリアルにはシミュレーター例は含まれていません。このワークフローは、特定のデバイスの物理的な不完全性、すなわちその量子ビットがどれだけ速く緩和・脱位相するか、そのゲートと読み出しがどれくらいの頻度で失敗するかを測定します。理想的なシミュレーターにはこうした不完全性が一切ないため、特性評価するものがありません。フェイク・バックエンドに合成ノイズ・モデルを付加することもできますが、その場合、実験は自分で設定した数値を再現するだけになってしまいます。そのため、ここではQiskitパターンの4つのステップに分けて、直接ハードウェアに進みます。
大規模ハードウェア例
ステップ1: 古典的な入力を量子問題にマッピングする
このワークフローでは、「問題」はデバイス自体です。古典的な入力は、特性評価したいQPUと測定するプロパティのリストであり、量子実験はそれらから生成された特性評価回路です。
まず、バックエンドを選択します。このチュートリアルでは、156量子ビットのHeron r2プロセッサーであるibm_kingstonを使用します。アクセス可能な任意のIBM Quantumデバイスに置き換えることができます(またはservice.least_busy()で1つを選ぶこともできます)。
service = QiskitRuntimeService()
device = "ibm_kingston"
backend = service.backend(device)
次に、測定するプロパティを選択します。以下の実験の任意の部分集合を渡すことができます。
-
readout: SPAM(状態準備と測定)実験 -
rb_1q: 独立した単一量子ビット・ランダム化ベンチマーク -
rb_2q: レイヤー忠実度実験による同時2量子ビット・ランダム化ベンチマーク -
t2: ハーン・エコー実験(デフォルトでは単一エコー) -
t1: 緩和実験
完全な一連の実験を実行してデバイスの全体像を把握してください。特定のプロパティのみに関心があり、QPU時間を節約したい場合は、リストからエントリを削除してください。
experiments = ["readout", "rb_1q", "rb_2q", "t1", "t2"]
ステップ2: 量子ハードウェア実行のために問題を最適化する
ほとんどのチュートリアルでは、ここで回路をトランスパイルします。ここでは、BackendCharacterizationが内部でそれを処理します。デバイスのネイティブ・ゲートで実験回路を直接構築し、すべての量子ビットで単一量子ビット実験を並列に実行し、結合マップの互いに素なレイヤーにわたって2量子ビットのベンチマークをスケジュールすることで、少数のジョブでデバイス全体をカバーします。この並列化のおかげで、一連の実験全体で消費されるQPU時間は約70秒だけです。
ワークフローを管理するクラスを初期化します。
# Initialize the class used to run the experiments
characterizer = BackendCharacterization(backend)
ステップ3: Qiskitプリミティブを使用して実行する
run_experimentsメソッドは回路を構築し、それらをSamplerジョブとして送信します。ジョブがQPU上でまとめてスケジュールされるように、これをBatchコンテキスト内で実行してください。このメソッドは、すべてのジョブが送信されると値を返します。(バッチの外部や、Session内で実行することもできます。)
Sessionコンテキストマネージャーが開いている間にBackendが渡されたという警告が表示される場合があります。これは想定内であり、安全に無視できます。
# Run the characterization experiments inside a Batch
with Batch(backend=backend):
    jobs = characterizer.run_experiments(experiments=experiments)
base_primitive.get_mode_service_backend:WARNING:2026-07-14 14:23:02,051: A backend was passed in as the mode but a session context manager is open so this job will run inside this session/batch instead of in job mode.
Building readout experiments
Building 1Q RB experiments
Building 2Q RB experiments
Building T1 experiments
Building T2 experiments
Layered two-qubit RB submitted: ['d9b7tfu6hjac73ffba2g', 'd9b7tjug26ic73dfju3g', 'd9b7u3u6hjac73ffban0', 'd9b7u7rv6alc73csmicg']
Readout job submitted: d9b7u8bv6alc73csmidg
T1 experiment submitted: ['d9b7u8ug26ic73dfjuqg']
T2 (Hahn) experiment submitted: ['d9b7u9fu62qs738othg0']
Single-qubit RB submitted: ['d9b7v8m6hjac73ffbc40', 'd9b7veeg26ic73dfk040']
このメソッドは、送信されたジョブを実験ごとにキー付けされたディクショナリとして返します。これは、IBM Quantum Platformダッシュボードでジョブを追跡したり、デバッグしたりするのに役立ちます。
# Print all the job IDs for debugging purposes
jobs
{'rb_2q': [<RuntimeJobV2('d9b7tfu6hjac73ffba2g', 'sampler')>,
  <RuntimeJobV2('d9b7tjug26ic73dfju3g', 'sampler')>,
  <RuntimeJobV2('d9b7u3u6hjac73ffban0', 'sampler')>,
  <RuntimeJobV2('d9b7u7rv6alc73csmicg', 'sampler')>],
 'readout': [<RuntimeJobV2('d9b7u8bv6alc73csmidg', 'sampler')>],
 't1': [<RuntimeJobV2('d9b7u8ug26ic73dfjuqg', 'sampler')>],
 't2': [<RuntimeJobV2('d9b7u9fu62qs738othg0', 'sampler')>],
 'rb_1q': [<RuntimeJobV2('d9b7v8m6hjac73ffbc40', 'sampler')>,
  <RuntimeJobV2('d9b7veeg26ic73dfk040', 'sampler')>]}
ステップ4: 後処理を行い、目的の古典形式で結果を返す
結果を分析する
analyze_resultsメソッドはジョブの終了を待ち、測定データをフィッティングします。とについては指数関数的減衰、RB実験については生存確率の減衰、読み出しについては割り当て行列です。戻り値は誤りマップのディクショナリで、測定したプロパティごとに1エントリを持ち、各エントリは量子ビット(または量子ビットのペア)をその測定値に対応付けます。
error_maps = characterizer.analyze_results()
print(f"The following error maps are available: {list(error_maps.keys())}")
readout_q0 = error_maps["readout_error"][0]
print(f"For example, readout error for qubit 0 is {readout_q0}")
The following error maps are available: ['readout_error', 'oneq_error_x', 'oneq_error_sx', 'lf_error_map', 't1_map', 't2_map']
For example, readout error for qubit 0 is 0.007600000000000051
このマップは、読み出しエラー、単一量子ビットのxゲートとsxゲートのエラー、レイヤー化された2量子ビットのエラー(レイヤー忠実度実験によるlf_error_map)、そして秒単位のとの時間をカバーしています。
バックエンド・プロパティを更新する
update_backendメソッドは、測定値をバックエンドのコピーのプロパティに書き込み、それを返します。元のbackendオブジェクトは報告されたキャリブレーション・データを保持したままなので、以下に示すように両者を比較できます。この更新は、あくまでPythonセッションにローカルなものであり、デバイス上や他のユーザーに対して何も変更しないことに注意してください。
backend_updated = characterizer.update_backend()
Updating readout error
Updating single-qubit X error
Updating single-qubit SX error
Updating two-qubit error
Updating T1
Updating T2
測定されたプロパティと報告されたプロパティを比較する
最後に、測定されたリアルタイムのプロパティを、バックエンドが報告する値に対してプロットします。各パネルでは、量子ビット(または量子ビットのペア)は測定値でソートされているため、測定曲線は当然滑らかになり、その周りに散らばる報告値のばらつきによって両者の不一致がどこにあるかがわかります。単一量子ビットRBでは、ゲートあたりの同じ測定誤りがxゲートとsxゲートの両方に割り当てられるため、単一のプロットが表示されます。軸の範囲はデータの大部分から選択されるため、いくつかの極端な外れ値によってプロットが圧縮されることはありません。範囲外の点は、プロット上の注釈でカウントされます(または、ylimを渡して範囲を上書きできます)。
plot_characterization_comparison(
    old_props=backend.properties().to_dict(),
    new_props=backend_updated.properties().to_dict(),
    plots=["readout", "rb_1q", "rb_2q", "t1", "t2"],
)
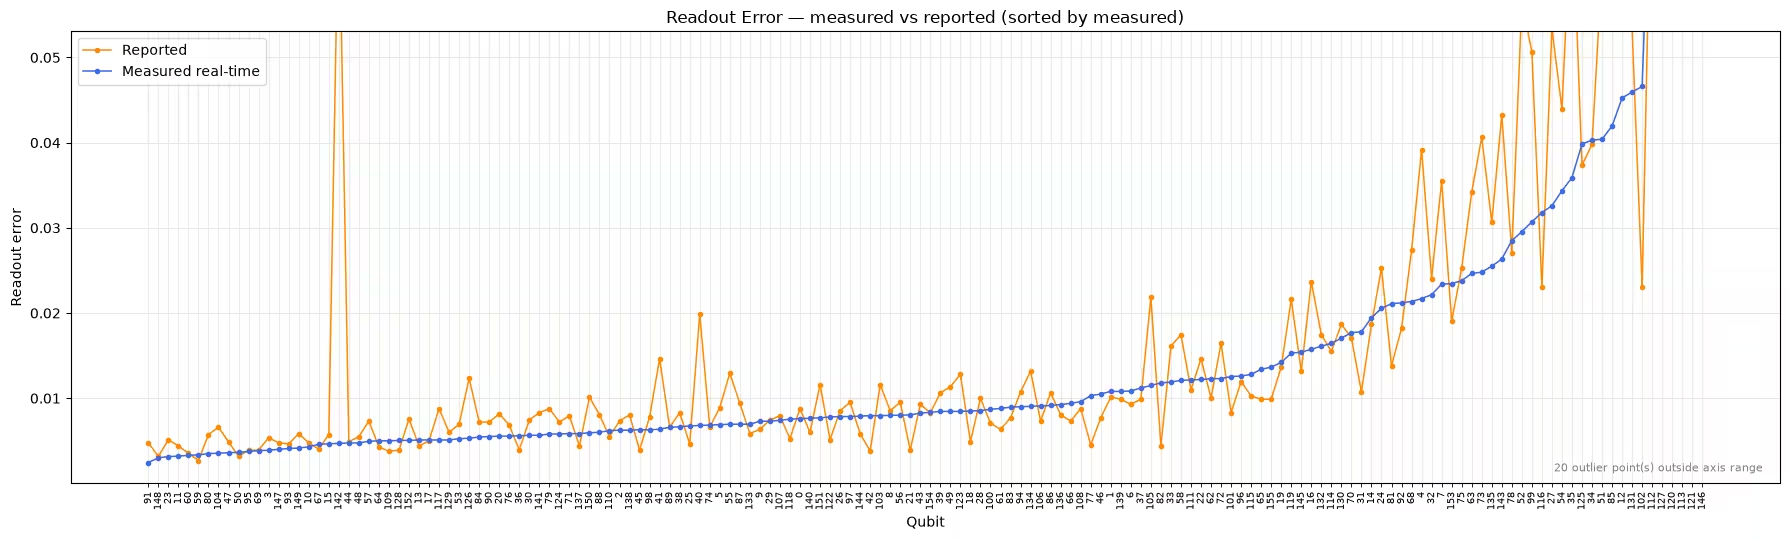
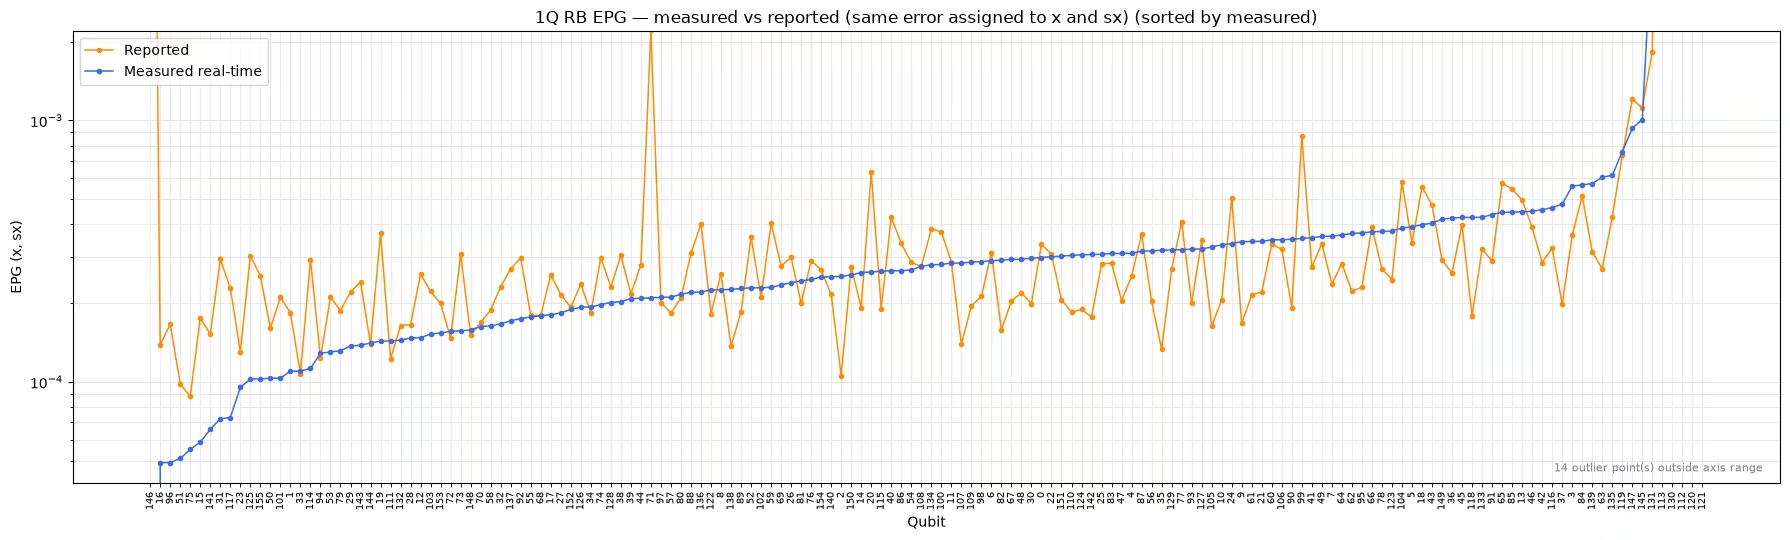
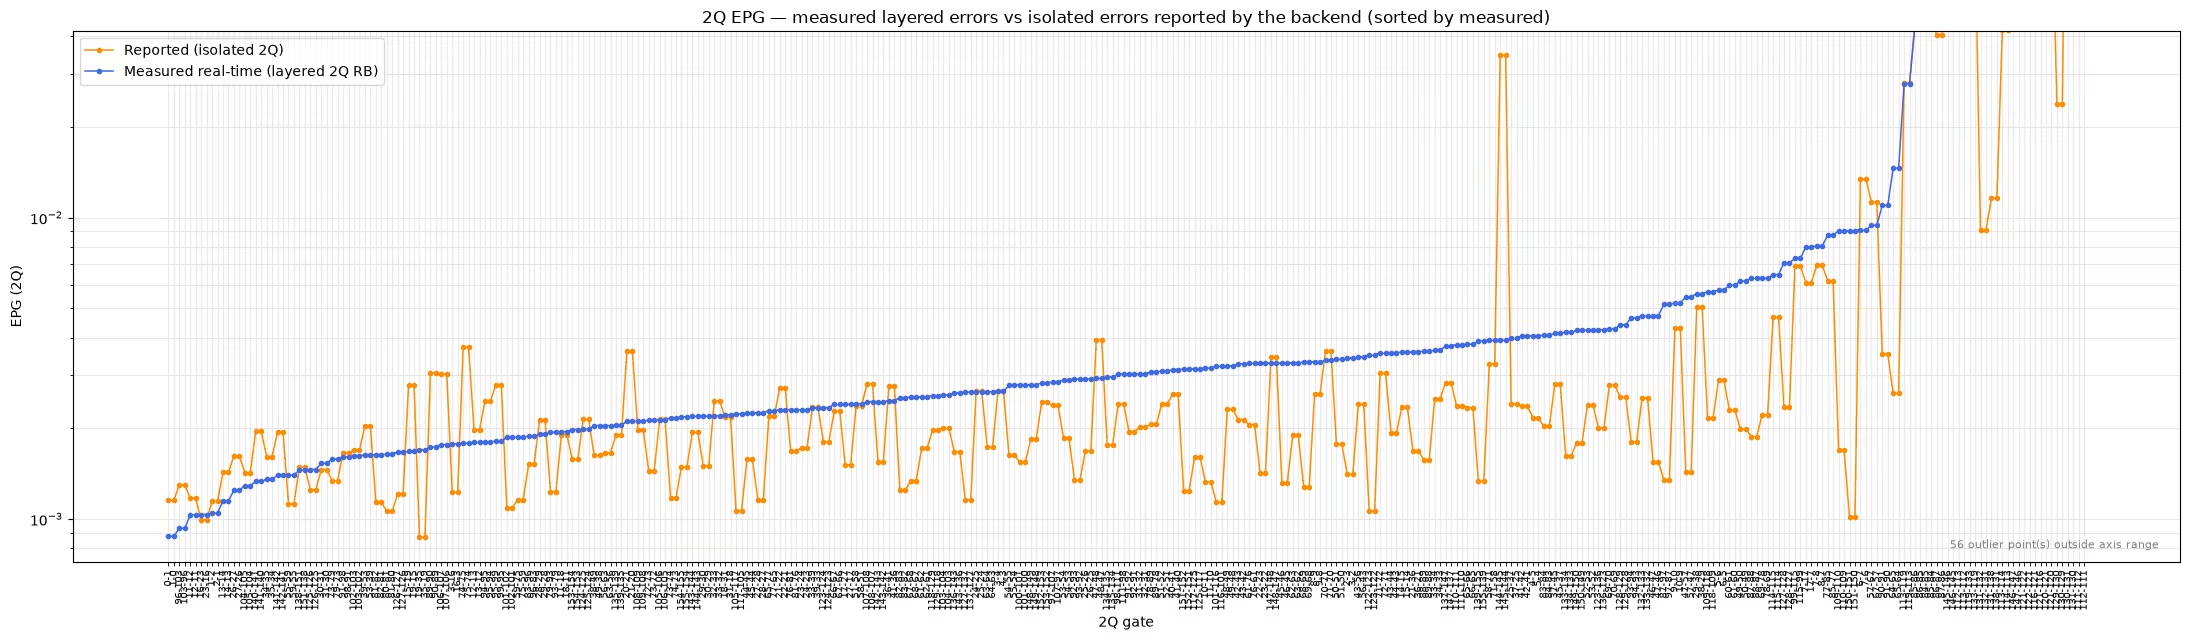
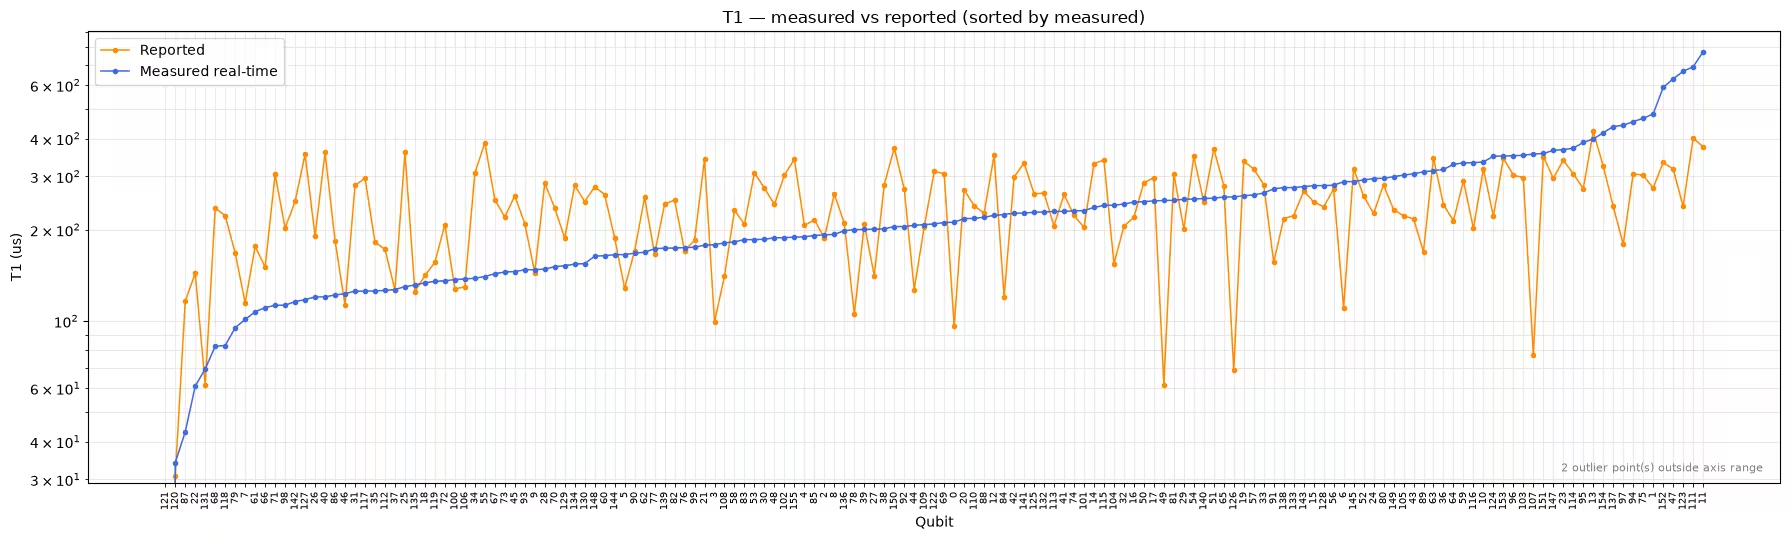
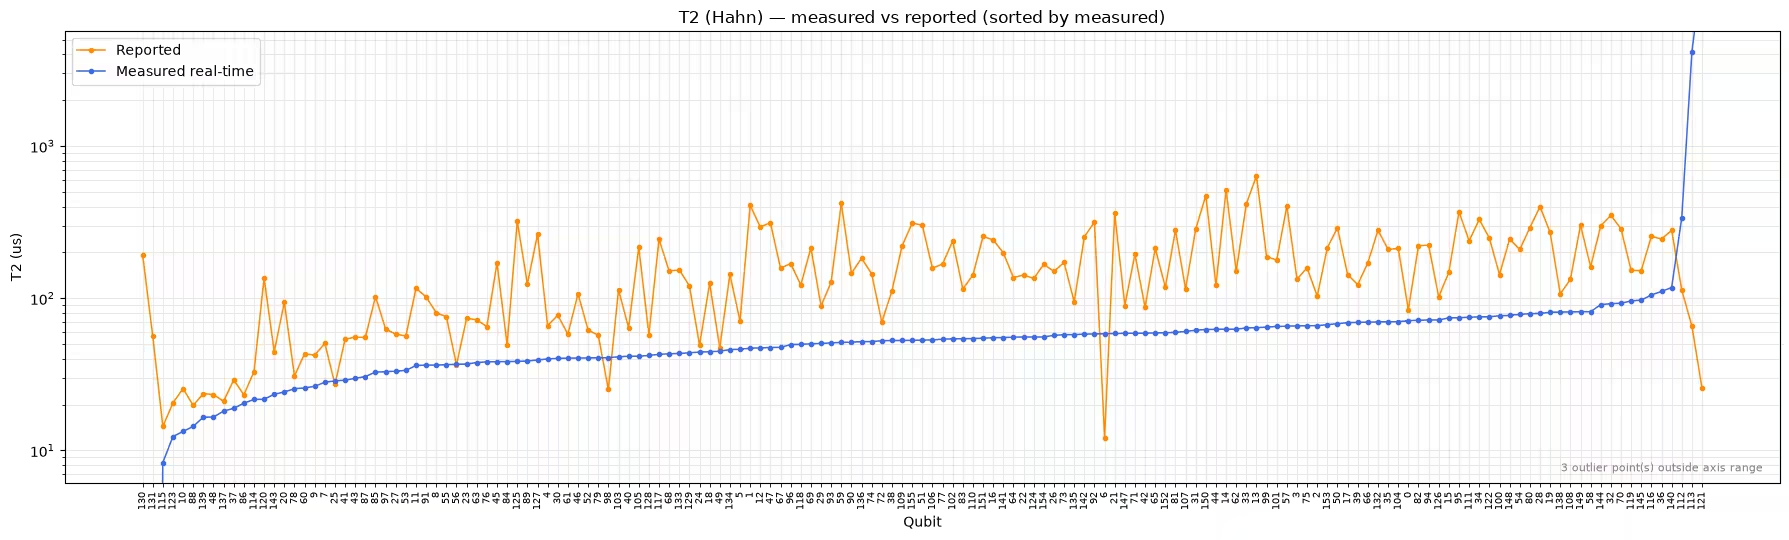
これらのプロットは注意深く読む必要があります。両曲線間のすべてのギャップがデバイスのドリフトを意味するわけではないからです。
-
読み出しと単一量子ビットのエラー: 測定値はほとんどの量子ビットで報告値に沿っていますが、一握りの量子ビットの報告値は測定曲線から大きく外れています。これらの局所的な不一致こそ、このワークフローが検出するように設計されているドリフトです。
-
: 2つのデータセットは体系的なオフセットなしにお互いの周りに散らばっており、これはが時間の経過とともに自然に変動することと一致しています。
-
2量子ビットのエラー: 測定値は報告値よりも体系的に高くなっています。これは予想通りです。報告値は孤立したゲートで測定されているのに対し、レイヤー忠実度実験は多数のゲートを同時に実行するため、クロストークが含まれるからです。レイヤー化された数値は深い回路にとってより関連性が高いですが、報告されたキャリブレーション・データと直接比較することはできません。
-
: 測定値はほとんどの量子ビットで報告値よりもかなり低くなっています。ここでも、次のセクションで検討するように、手法が大きな役割を果たします。
個々の実験結果を検査する
また、experiment_dataプロパティを通じて、個々のキャラクタリゼーション実験の生の結果を検査することもできます。これは、基盤となるQiskit ExperimentsのExperimentDataオブジェクトを返します。例えば、以下では単一量子ビットの測定された減衰曲線を表示しています。これは、フィットが算出した数値を信頼する前に、フィットの品質を確認するのに役立ちます。
t1_data = characterizer.experiment_data["t1"]

# Each qubit has its own fit figure
n_figs = len(t1_data.figure_names)
print(f"{n_figs} figures available, e.g. {t1_data.figure_names[0]}")

# Show the T1 decay curve of the first qubit
t1_data.figure(0)
156 figures available, e.g. T1_Q0_c78ef792.svg

ダイナミカル・デカップリング・トレインでT2を測定する
デフォルトでは、実験は単一のHahnエコーを適用し、すべての量子ビットを並列に測定します。これは、上記の比較プロットが示したように、バックエンドが報告するよりも著しく低い値をもたらす可能性があります。1つの仮説はエコーの数です。報告された値は、低周波ノイズを抑制するダイナミカル・デカップリングを用いてキャリブレーションされている可能性があります。これを検証するために、t2_num_echoesをより大きな値に設定してのみのキャラクタリゼーションを実行します。これにより、CPMGスタイルのエコー・パルス列が適用されます。両方のケースで、遅延は自由時間発展の合計時間を表すため、フィットされた値はシングルエコーの結果と直接比較可能です。
# Run a T2-only characterization using a CPMG-style train of 8 echoes
characterizer_dd = BackendCharacterization(backend)
backend_updated_dd = characterizer_dd.run_and_update(
    experiments=["t2"], t2_num_echoes=8
)
Building T2 experiments
T2 (Hahn) experiment submitted: ['d9b96s6g26ic73dflcn0']
Updating T2
# Compare the multi-echo T2 against the backend-reported values
plot_characterization_comparison(
    old_props=backend.properties().to_dict(),
    new_props=backend_updated_dd.properties().to_dict(),
    plots=["t2"],
    title_prefix="8-echo CPMG",
)

# Compare medians across the reported values, the single-echo run,
# and the 8-echo run
reported_t2s = [
    prop["value"]
    for qubit in backend.properties().to_dict()["qubits"]
    for prop in qubit
    if prop["name"] == "T2"
]
t2_reported = np.median(reported_t2s)
t2_single = np.median(list(error_maps["t2_map"].values())) * 1e6
t2_dd = (
    np.median(list(characterizer_dd.analyze_results()["t2_map"].values()))
    * 1e6
)
print(
    f"Median T2 — reported: {t2_reported:.0f} us | "
    f"single echo: {t2_single:.0f} us | 8-echo CPMG: {t2_dd:.0f} us"
)
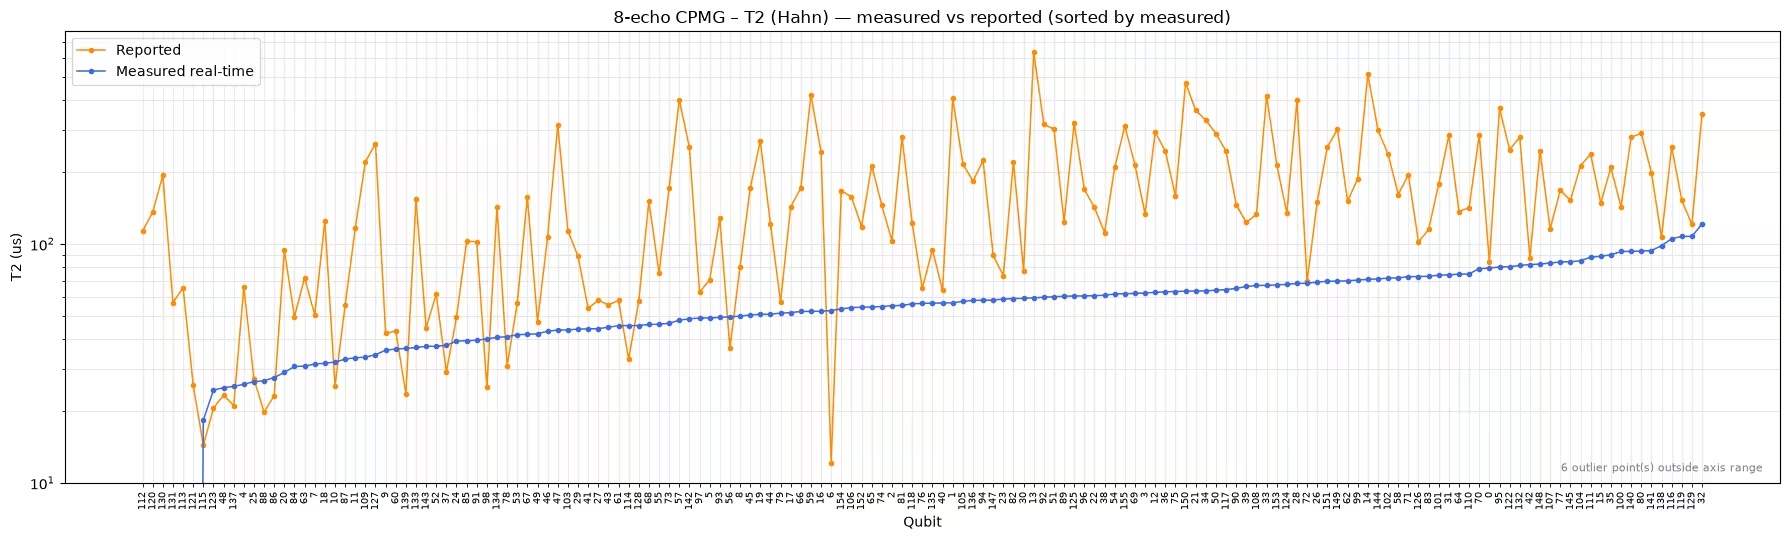
Median T2 — reported: 142 us | single echo: 53 us | 8-echo CPMG: 56 us
この実行では、追加のエコーによって結果はほとんど変化しませんでした。8エコーの中央値(56 µs)はシングルエコーの中央値(53 µs)に近く、両方とも報告された中央値(142 µs)を大きく下回ったままです。エコーの数だけではこのギャップを説明できません。キャリブレーション手順の詳細や、量子ビットを孤立させずにすべて並列に測定していることなど、他の方法論上の違いが関係しています。
実用上の教訓は、手法をまたいだ(およびレイヤー化された2量子ビットのエラー)の比較には注意が必要だということです。更新された値は、実際のワークロードに近い条件下で取得された自己無矛盾なスナップショットであり、量子ビット同士を比較したり、デバイスを長期にわたって追跡したりするのに適しています。しかし、報告されたキャリブレーション・データとのギャップは、自動的にドリフトの証拠になるわけではありません。
ステップ1~4を1回の呼び出しに圧縮する
日常の使用では、中間結果が必要になることはほとんどありません。run_and_updateメソッドは、上記で行ったすべての処理(構築、送信、フィッティング、更新)を1回の呼び出しに連結し、更新されたバックエンドを返します。これは同じexperimentsリストを受け付け(t2_num_echoesなどのオプションも転送します)、BatchやSessionのコンテキストでラップすることも同様に可能です。
以下のセルは、すべてのジョブと後処理が完了するまで戻りません。
# Initialize a fresh characterizer
characterizer = BackendCharacterization(backend)

# Run all of the experiments and update the backend in a single call
backend_updated = characterizer.run_and_update(experiments=experiments)
Building readout experiments
Building 1Q RB experiments
Building 2Q RB experiments
Building T1 experiments
Building T2 experiments
Layered two-qubit RB submitted: ['d9b7oqnu62qs738otat0', 'd9b7p76g26ic73dfjolg', 'd9b7pnm6hjac73ffb57g', 'd9b7q4fu62qs738otce0']
Readout job submitted: d9b7q4mg26ic73dfjprg
T1 experiment submitted: ['d9b7q57u62qs738otcfg']
T2 (Hahn) experiment submitted: ['d9b7q5m6hjac73ffb5pg']
Single-qubit RB submitted: ['d9b7r4e6hjac73ffb71g', 'd9b7reu6hjac73ffb7d0']
Updating readout error
Updating single-qubit X error
Updating single-qubit SX error
Updating two-qubit error
Updating T1
Updating T2
更新されたbackend_updatedオブジェクトは、バックエンドのプロパティがワークフローに反映される場所であればどこでも使用できるようになりました。量子ビット選択のためのリアルタイム・ベンチマーキングチュートリアルと組み合わせて、このプロセスを試して、回路をトランスパイルする際に最もパフォーマンスの高い量子ビットを選択してみてください。デバイスは常にドリフトし続けるため、実際にワークロードを実行する時間の近くでプロパティを更新してください。
次のステップ
この作業に興味を持たれた方は、以下の資料にも興味があるかもしれません:
- 量子ビット選択のためのリアルタイム・ベンチマーキングチュートリアルで、更新されたプロパティを使用してより良い量子ビットを選択する
- 報告されたキャリブレーション・データがどのように公開されているかを、QPU情報ガイドで学ぶ
- Qiskit Experimentsドキュメントで個々のキャラクタリゼーション実験を調べる
- Qiskit Device Benchmarkingリポジトリでさらなるデバイス・レベルのベンチマークを閲覧する