SQDとSKQD
この章では、量子コンピューターと古典コンピューターが連携して、科学における最も重要な課題のひとつである「分子や物質のエネルギーを正確に推定すること」をどのように解決するかを探っていきます。
Iskandar Sitdikov氏が、以下の動画でアルゴリズムのアプローチについて説明しています。
ハミルトニアン
この問題の核心にあるのが、数学的な演算子である「ハミルトニアン」です。ハミルトニアンはシステム全体のエネルギーを表します。計算上の観点からは、このハミルトニアンを大きな行列として考えることができます。私たちが求めている解、具体的にはシステムの基底状態は、この行列の最小固有値に対応します。しかし問題なのは、実際に扱う問題ではこのハミルトニアン行列が非常に大きくなることです。システムのサイズに対して指数関数的に増大し(を量子ビット数とすると)、最も強力なスーパーコンピューターでも格納・直接求解することができなくなります。
これを回避するために、「部分空間法」と呼ばれる強力な戦略を使います。行列全体を扱う代わりに、求めている低エネルギー解に関する最も重要な情報が含まれていると考えられる小さな関連部分、つまり「部分空間」をインテリジェントに選択します。
基底状態の集合 によって小さな部分空間が定義されると、完全なハミルトニアンをその部分空間に射影して新しい小さな行列 を生成します。この行列の各要素は、 のように、部分空間の基底状態と元のハミルトニアンから計算されます。この小さな行列は古典コンピューターで容易に対角化でき、得られた固有値が推定エネルギーになります。
ご想像のとおり、このアプローチ全体の成否は「良い」部分空間を選択できるかどうかに大きく依存します。部分空間が真の基底状態を正確に表現していなければ、最終的な答えは誤ったものになります。ここで量子コンピューターが活躍します。量子コンピューターを使うことで、重要な部分空間を特定するために設計された複雑な量子状態を準備してサンプリングすることができます。複雑な化学構造や結合部位のような非常に大規模な問題では、射影された行列でさえ対角化が困難な場合があります。そのため、このような問題は量子リソースと古典リソース双方の強みを活用するのに理想的です。
以下のセクションでは、量子力学を活用してこれらの部分空間を探索・構築する2つの高度なアルゴリズム、SQDとSKQDを説明します。より詳しく学びたい方は、IBM Quantum Learningにこれらのトピックを詳細に扱った専用の完全コースがあります。このコースでの説明は概要レベルにとどめます。
サンプルベース量子対角化(SQD)
サンプルベース量子対角化(SQD)は、部分空間法を量子的な方法で実装する強力な変分アルゴリズムです。アダマールテストのようなコストのかかる複雑な手続きを避け、量子コンピューターを使って試行状態を準備し、ビット列をサンプリングします。このビット列が古典的対角化のための部分空間を定義します。
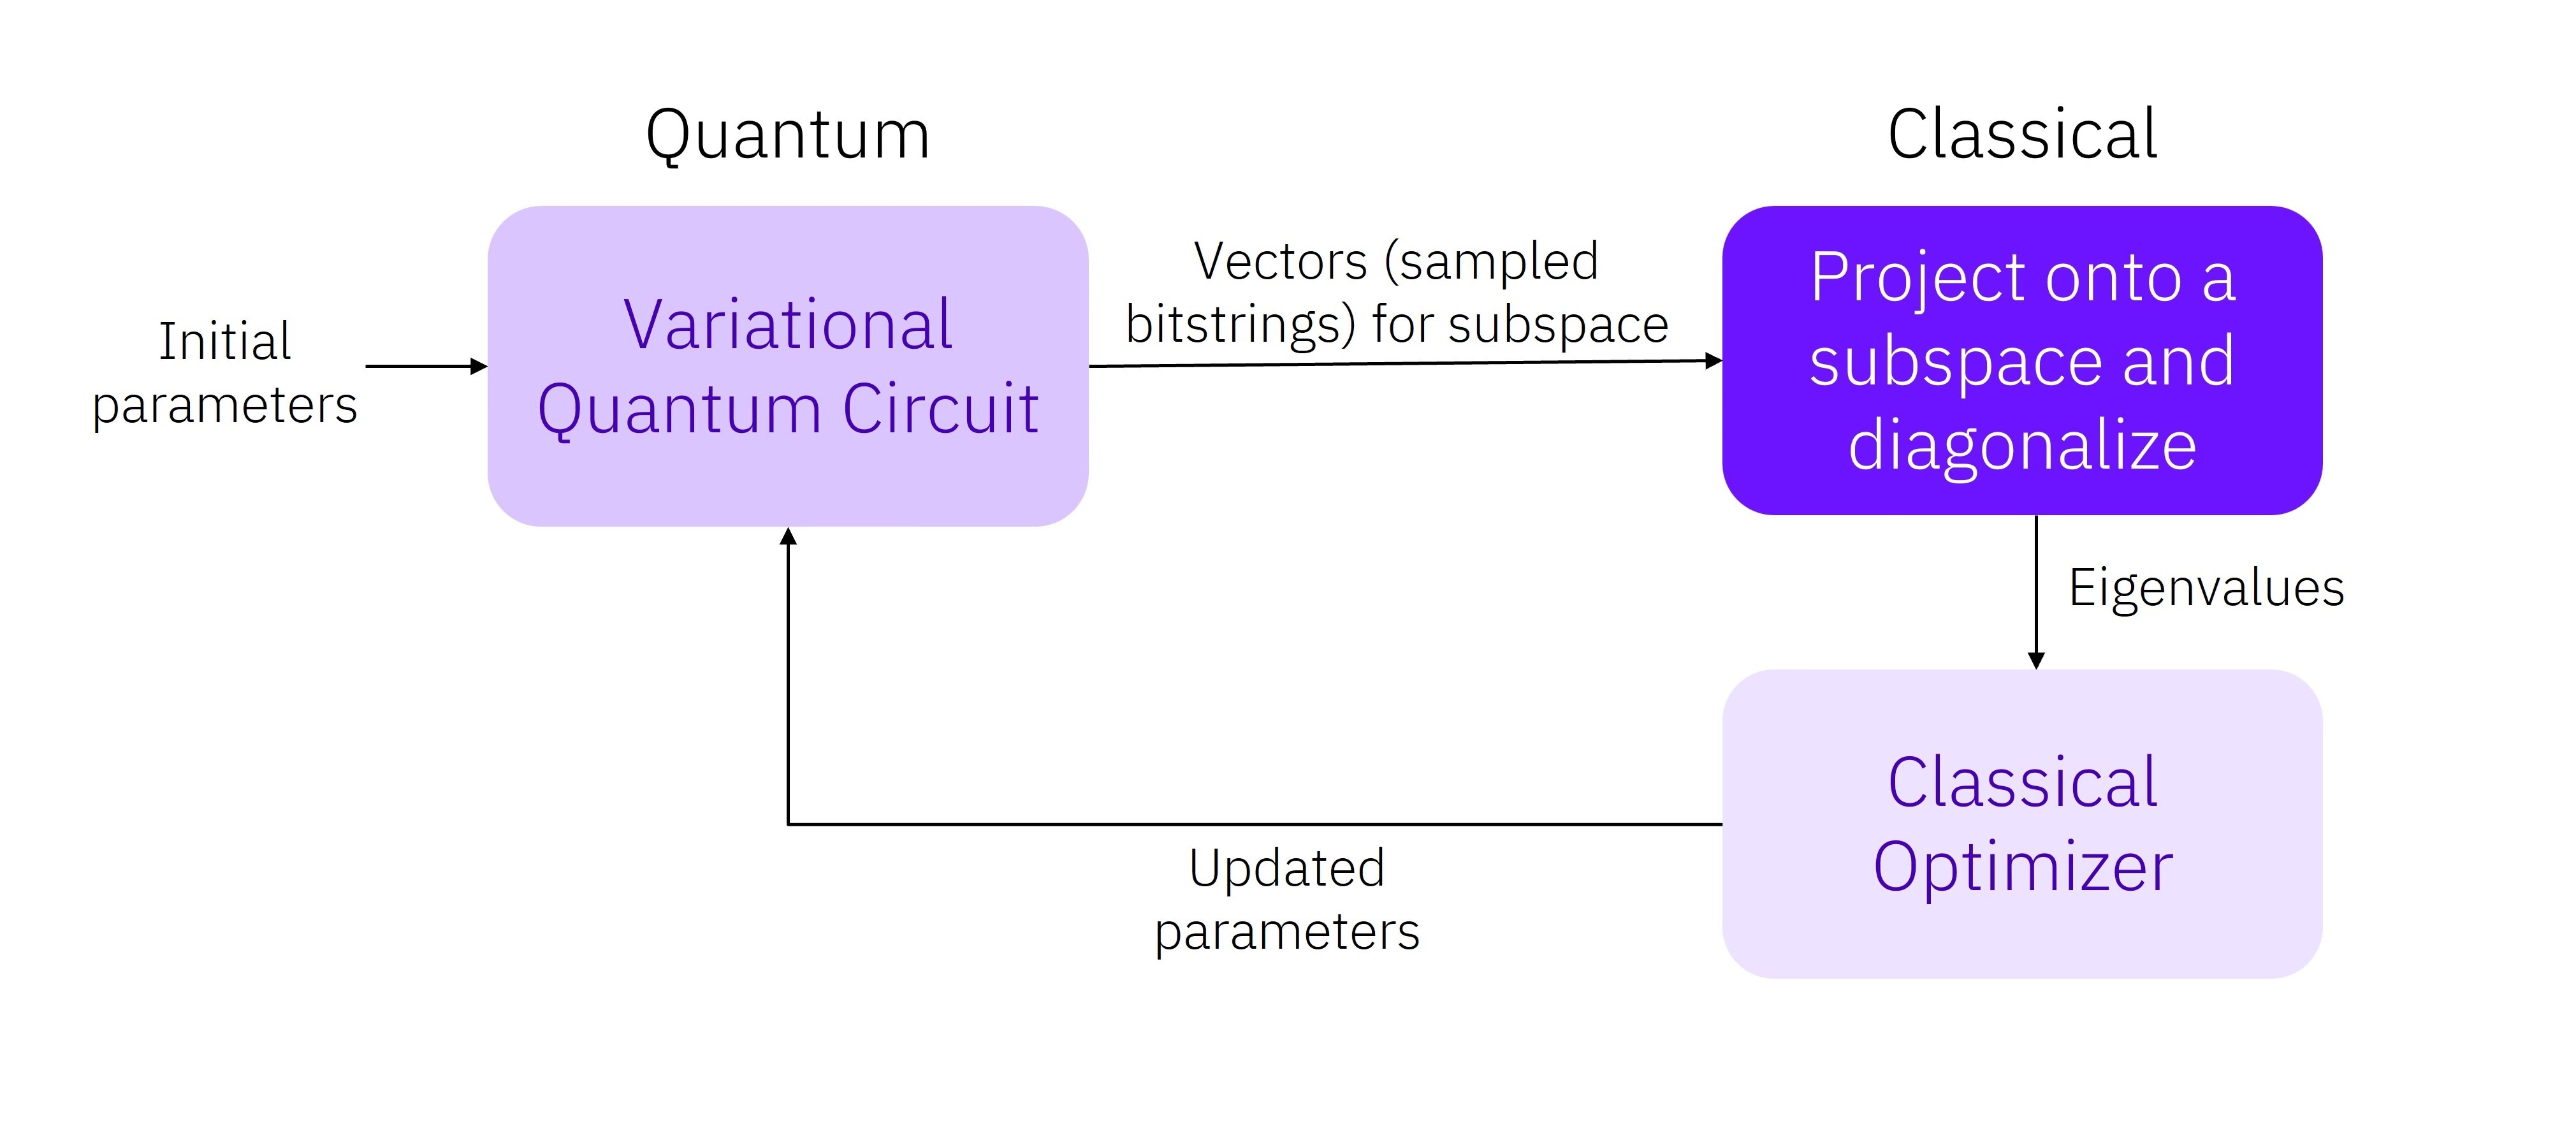
SQDアルゴリズムは以下のステップに分解できます。
ステップ1:アンザッツ状態の準備
量子ビット上のハミルトニアンを とします。真の基底状態はすべての 基底状態にわたってサポートを持つ可能性がありますが、SQDは基底状態がスパースな部分空間(多項式サイズのビット列集合)で良く近似できる場合に最も効果的です。
この部分空間を構築するために、化学における Hartree-Fock(HF)状態などの初期入力状態 から始めます。次に、アンザッツと呼ばれるパラメーター化量子回路 を適用します。
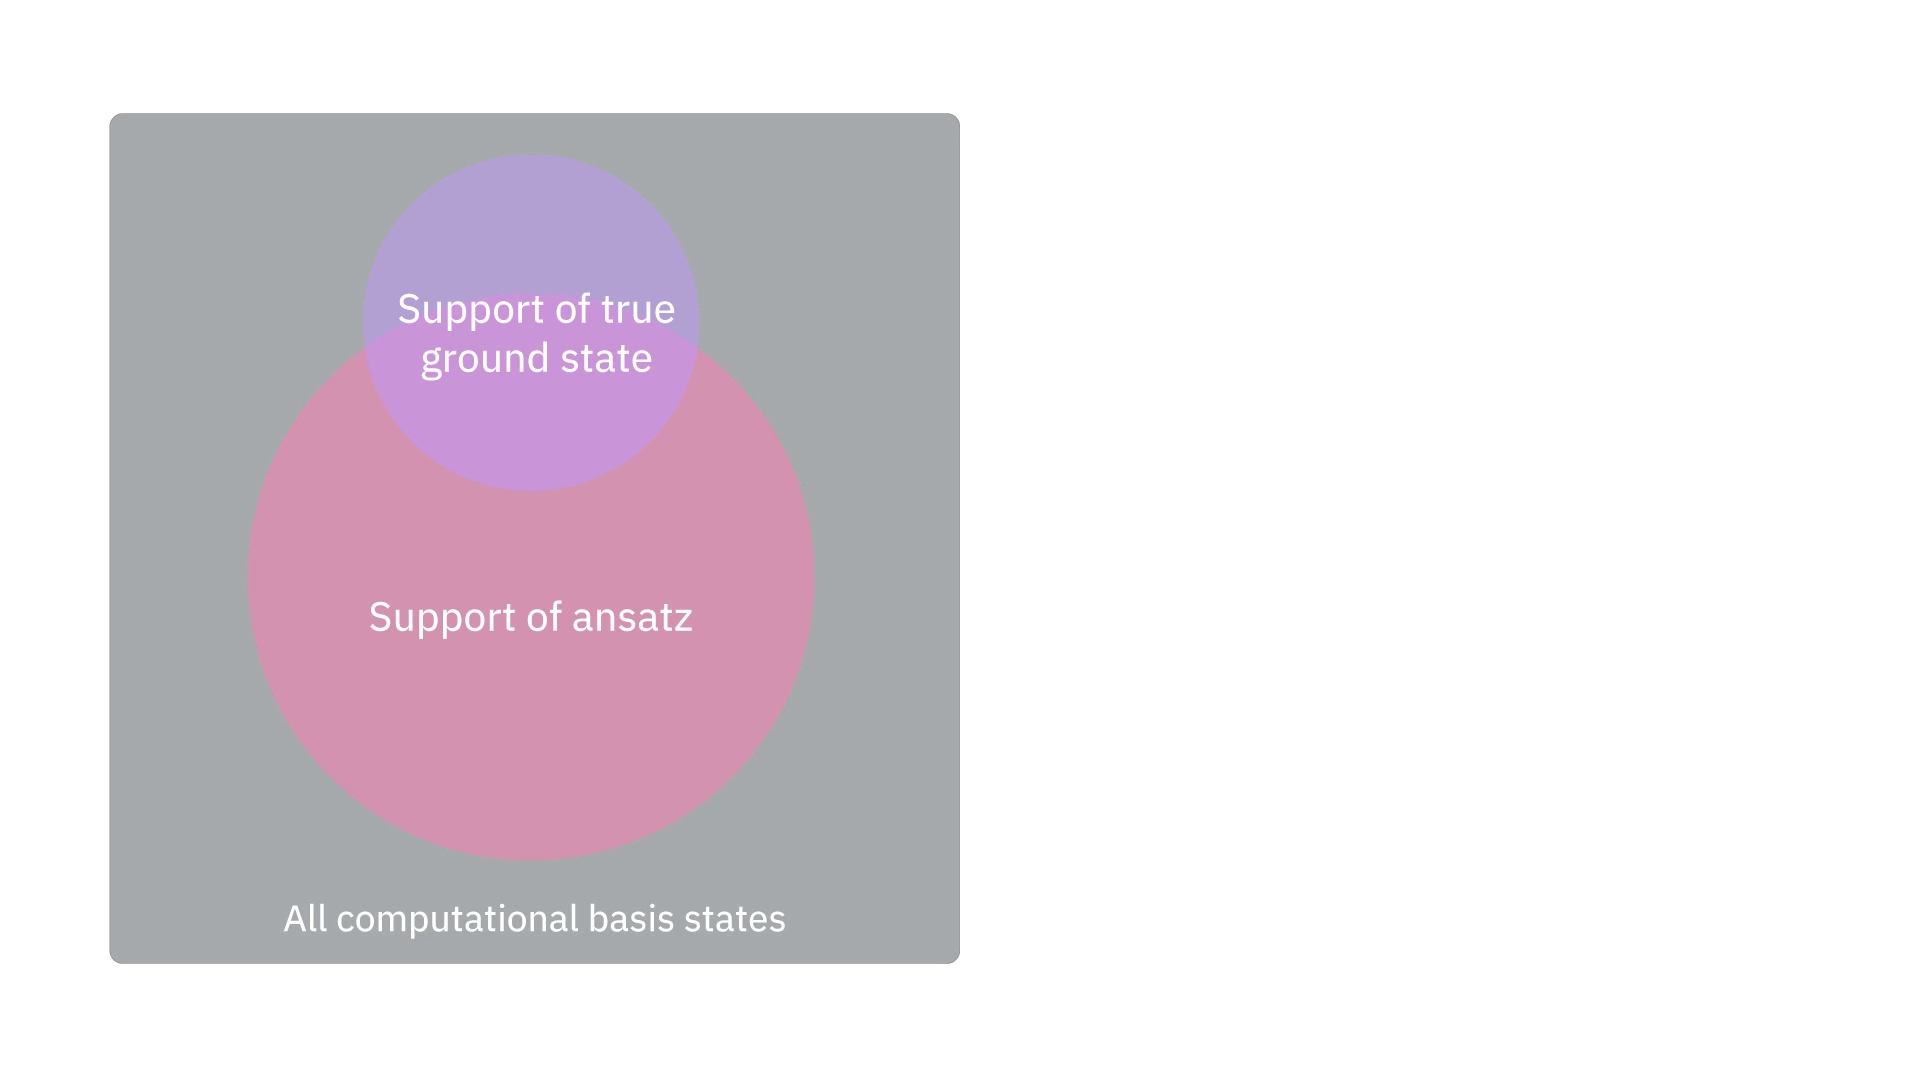
この図は、良いアンザッツの目標を示しています。アンザッツが準備する量子状態のサポート(それを構成する基底状態の集合)は、真の基底状態のサポートと大きく重なることが理想的です。この回路によって、アンザッツを計算基底状態に素早く射影できます。射影された基底状態はさらに古典的対角化に使用されます。言い換えると、アンザッツが基底状態そのものである必要はなく、同じ基底状態を含んでいるだけで十分です。そのうえで、射影されたハミルトニアンの古典的対角化により、基底状態を最もよく近似する基底状態の重ね合わせが得られます。
ステップ2:部分空間のサンプリング
アンザッツで準備した回路からサンプリングすることで、ビット列の集合 が得られます。これらのビット列が選択した部分空間の基底を定義します。このステップの量子実行時間は回路の深さとサンプル数によって決まります。
ステップ3:射影と古典的対角化
サンプリングされたビット列を使って、それらが張る部分空間にハミルトニアンを射影します。各ビット列ペア に対して、行列要素 を古典的に計算します。パウリ演算子はスパースであるため、このステップは物理的なハミルトニアンに対して古典的に効率的です。得られた小さな行列 を古典プロセッサーで対角化して、基底状態とそのエネルギーを推定します。
ステップ4:アンザッツの最適化(オプション)
このプロセスを反復的に行うことができます。推定された基底状態エネルギーをコスト関数として、勾配降下法などの手法を使って回路パラメーター()を最適化し、アンザッツを改善することで、次の反復のエネルギー近似精度を向上させます。
SQDの主な利点
SQDは量子優位性の実証において有力な候補となる、以下のような強力な特長を持っています。
-
ノイズへの高い頑健性:真の基底状態が2つのビット列にのみサポートを持つとします。それらがサンプリングされていれば、たとえアンザッツとの重なりが小さくても、対角化によって適切な重みが割り当てられ、サンプリングされた余分なノイズビット列は効果的に無視されます。この固有のフィルタリング機能により、SQDは特にノイズ耐性に優れています。
-
古典的な検証可能性:QPEやVQAとは異なり、SQDは基底状態の古典的な近似を生成します。つまり、ビット列のリストとその重みを持つ誰でも、古典コンピューターだけでエネルギー推定値を再計算・検証できます。
SQDはすでに、77量子ビット・10,570ゲートの回路を使って、Nの基底状態解離エネルギーや[2Fe-2S]・[4Fe-4S]クラスターの電子特性の推定に活用されています [2]。
理解度チェック
真か偽か:SQDは化学システムに適用できる。
Answer
真
理解度チェック
アンザッツを構成するすべての計算基底状態の集合を A とします。システムの真の基底状態を構成するすべての計算基底状態の集合を G とします。次のうち「良い」アンザッツに対応するものはどれですか?当てはまるものをすべて選んでください:
(a)
(b)
(c)
(d)
Answer
(c) と (d)
SKQD(サンプルベースクリロフ量子対角化)
サンプルベースクリロフ量子対角化(SKQD)は、SQDの原理を発展させた別の強力な量子サンプルベースアルゴリズムです。目標はSQDと同じ——対角化のための良い部分空間を見つけること——ですが、SKQDはビット列の生成にもっと構造化された手法を採用しており、格子ハミルトニアンのような問題に特に適しています。
SKQDの核心的なアイデアは、良いアンザッツを見つけるためにパラメーター化回路を最適化するのではなく、システム自身の自然な時間発展、つまりクリロフ部分空間によって生成される状態の集合からサンプリングすることで、基底状態に収束することが証明できるという点です。SKQDアルゴリズムは以下のステップに分解できます。
ステップ1:時間発展によるクリロフ部分空間の構築
初期状態 から処理を開始します。重要なのは、この初期状態が基底状態と「良い」重なりを持つ必要がない点です。初期状態は「多項式的に大きい」、つまりシステムサイズの多項式で記述できるだけで十分です。アルゴリズム自体がその状態をシステムの基底状態へと近づけていきます。SKQDは時間発展演算子 を異なる時間長に対して適用します。これにより、 個の異なる量子状態の集合が生成されます。
この時間発展した状態の集合がクリロフ基底を形成します。このステップは、ハミルトニアンの項数が多くない格子ハミルトニアンに特に効果的です。化学問題では、この時間発展は非常に深い回路になる可能性があるため、そのようなケースではSQDが推奨されることが多いです。
ステップ2:クリロフ基底状態からのサンプリング
次に、前のステップで準備した 個の異なる状態()それぞれからビット列サンプルを収集します。これらすべてのビット列をまとめて、部分空間の基底を形成します。
ステップ3:射影と古典的対角化
このステップはSQDのものと同一です。収集されたビット列を使って、それらが張る部分空間に完全なハミルトニアンを射影します。得られた小さな行列 を古典コンピューターで対角化して、基底状態エネルギーを求めます。
SKQDの主な利点と保証
SKQDの構造化されたアプローチは固有のメリットをもたらします。
-
収束の証明可能性:SKQDの重要な利点は、明確に定義された特定の条件下での収束の理論的保証です。真の基底状態がスパースであり(多項式個のビット列で良く近似でき)、第一励起状態とのエネルギーギャップが十分に大きければ、この手法は効率的に機能することが証明されています。これらの条件下で、SKQDは基底状態を構成する重要なビット列を確実に見つけ出し、高精度で基底状態エネルギーを近似できることが保証されます。必要な量子実験とショット数は多項式個にとどまります。この保証により、サンプルベースのアプローチは量子位相推定のような確立された手法と同様の厳密な理論的基盤に立脚しています。
-
SQDとの共通の利点:SQDと同様に、SKQDもノイズ頑健性の特性を持ちます。つまり、サンプリングされたビット列の集合に必要な「良い」ビット列が含まれていれば、対角化によって誤ったビット列にはほぼゼロの重みが割り当てられ、ノイズに対して頑健な手続きになります。さらに、解が古典的HPCから得られるため、解のエネルギーは古典的に検証可能です。
実験では、SKQDは最大70量子ビットと数千のゲートを使って複雑な4不純物アンダーソンモデルの基底状態を研究し、DMRGのような最先端の古典手法と優れた一致を達成しました。[1]
理解度チェック
SKQDアルゴリズムのどの部分が、化学問題よりもスピン格子のような物理問題に適しているのでしょうか?またその理由は何ですか?
Answer
時間発展にはトロッター回路が必要であり、複雑でスパースでないハミルトニアンではこれが非常に深くなります。スピン格子相互作用はスピン行列で記述され、パウリ行列と等価です。したがって、スピン格子のハミルトニアン、特に最近接相互作用を持つものは、パウリ行列でよりコンパクトに表現できる傾向があります。
異種コンピューティングとしてのSQDとSKQD
ここまでを整理すると、サンプルベースアルゴリズムは異種リソース上のさまざまなプログラミングモデルの組み合わせとして表現できます。たとえば、アルゴリズムをタスクワークフローとして表現できます。
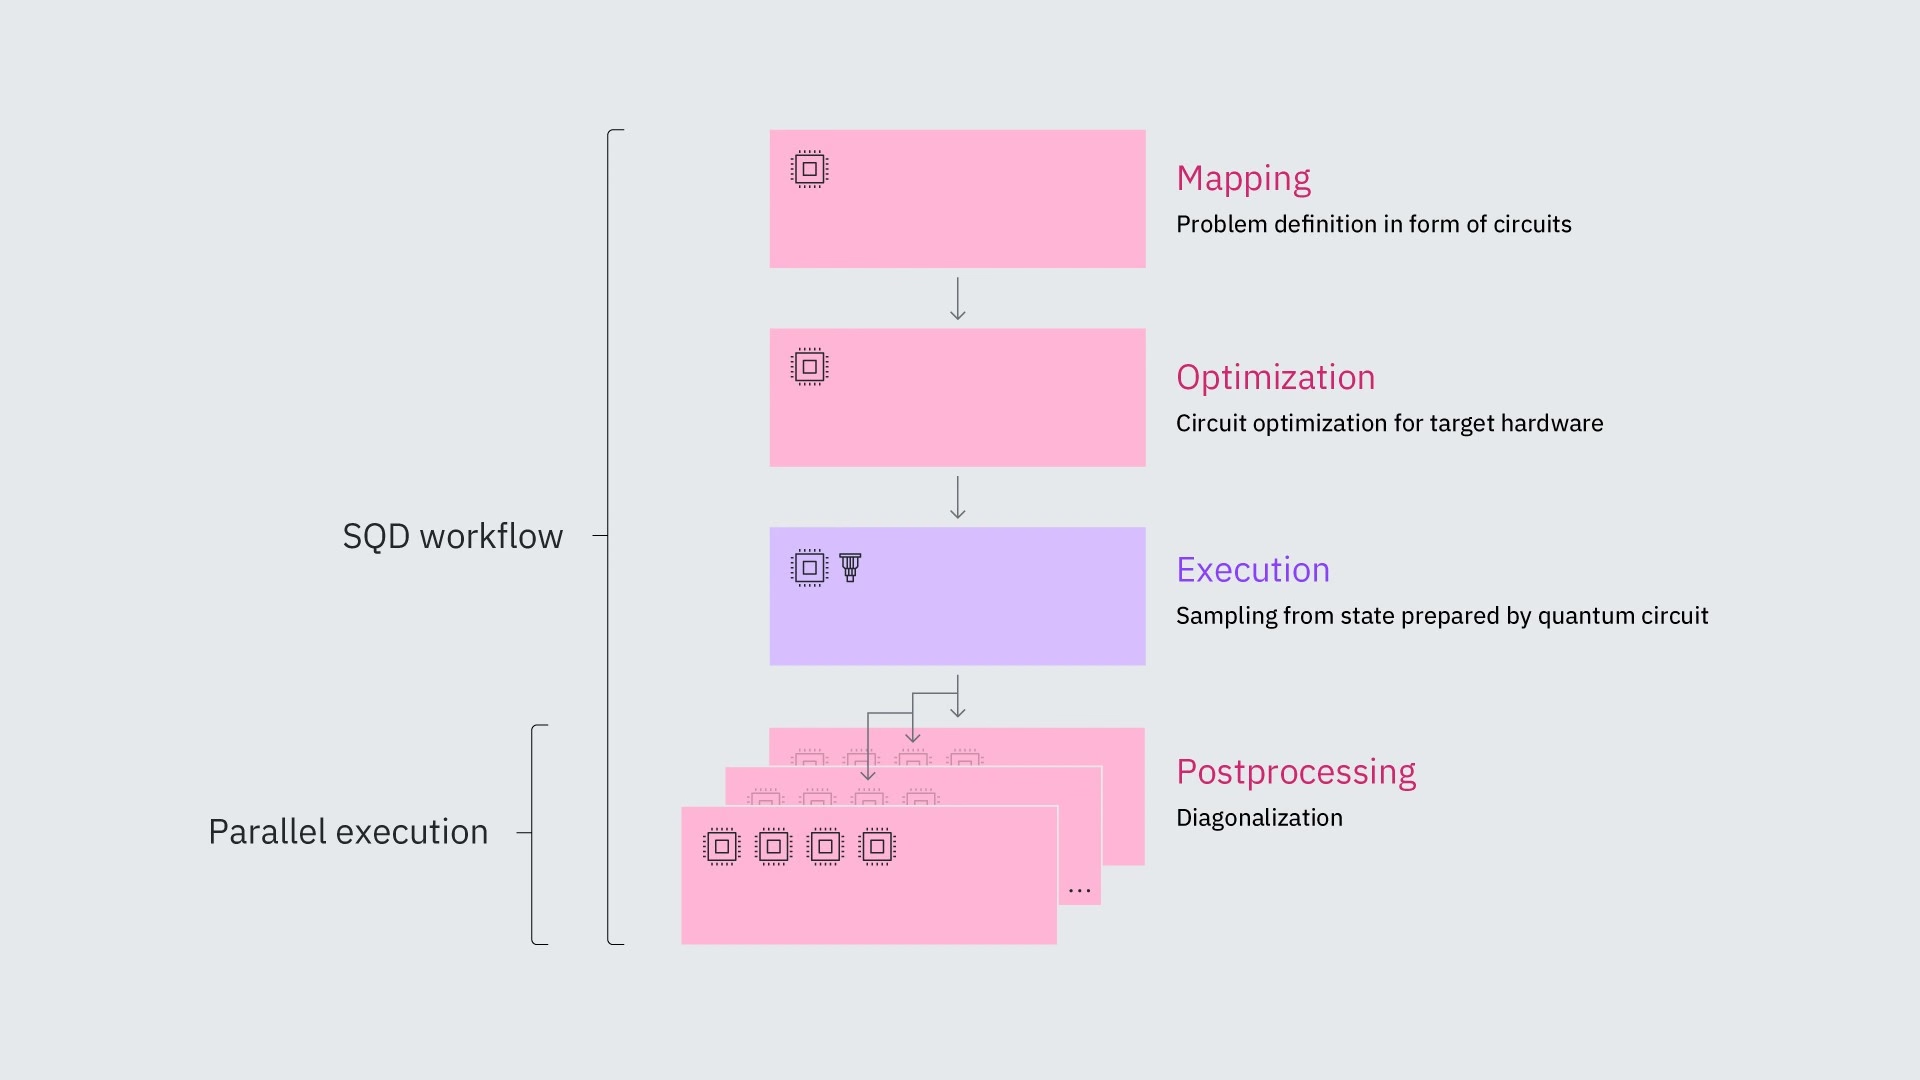
この図は基本的な4段階ワークフローを示しています。まず、目標状態と重なるような量子回路を準備するタスクがあり、次に古典リソースのみで実行できるトランスパイルのタスクがあります。続いて、量子リソースを必要とする量子回路実行のためにプリミティブを使うタスクがあり、最後に後処理タスクがあります。これ自体が、複数のノードで動作する並列対角化アルゴリズムになる場合もあります。
さらに、アンザッツを変えながらこれらのアルゴリズムを何度も実行したり、異なる初期状態集合(ポピュレーション)で完全に並列に実行したりすることも考えられます。
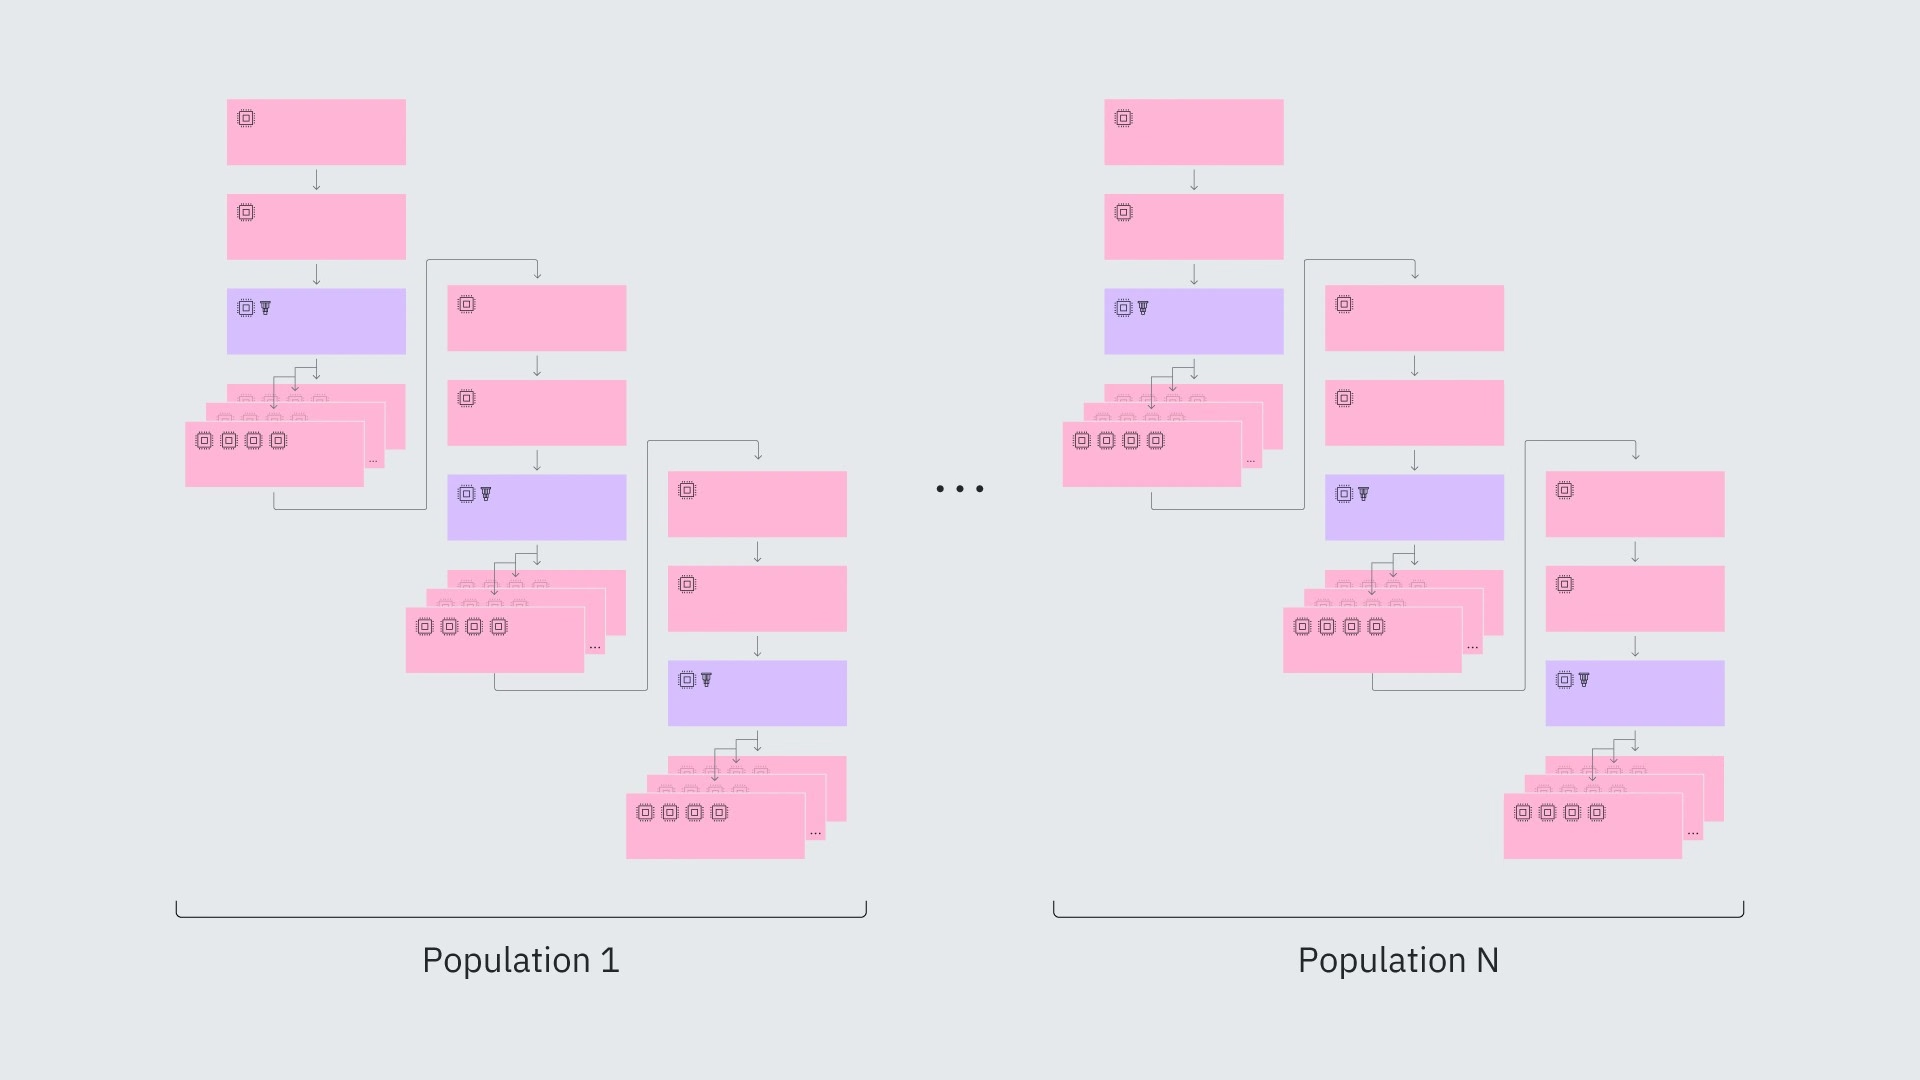
上図に示すように、以下を行いながら複数のワークフローを同時に実行できます。
-
最も効果的なアンザッツを見つけるために、アンザッツのパラメーターや構造を変化させる。
-
局所最小値を避けてより頑健な結果を得るために、異なる初期状態や設定(「ポピュレーション」)から開始する。
タスクベースの異種性とワークフローレベルの並列性を組み合わせたこの多層的なアプローチが、これらのアルゴリズムの可能性を最大限に引き出す鍵です。
プログラミング実践
それでは、SKQDアルゴリズムを使って、前述した異種ワークフローを実際に実践してみましょう。このプロセスは4つの明確なステージに分かれており、それぞれに対応するPythonスクリプトとジョブ投入用シェルスクリプトがあります。
マッピング(mapping.py と mapping.sh)
ワークフローの最初のステップは、物理的な問題を定義して量子回路の集合にマッピングすることです。
mapping.py は特定の物理問題のパラメーターを定義します——この場合、7つのバスサイト(n_bath = 7)を持つアンダーソン不純物モデルです。システムのハミルトニアンを表す1体(h1e)と2体(h2e)の積分値を構築します。
...

n_bath = 7  # number of bath sites

...

# One body matrix elements in the "position" basis
h1e = -t * np.diag(np.ones(n_bath), k=1) - t * np.diag(np.ones(n_bath), k=-1)
h1e[impurity_index, impurity_index + 1] = -V
h1e[impurity_index + 1, impurity_index] = -V
h1e[impurity_index, impurity_index] = eps

# Two body matrix elements in the "position" basis
h2e = np.zeros((n_bath + 1, n_bath + 1, n_bath + 1, n_bath + 1))
h2e[impurity_index, impurity_index, impurity_index, impurity_index] = U

...

# The one-body time evolution
free_fermion_evolution = ffsim.qiskit.OrbitalRotationJW(n_modes, Utar)

# The two-body time evolution
def append_diagonal_evolution(dt, U, impurity_qubit, num_orb, q_circuit):
    """Append two-body time evolution to a quantum circuit."""
    if U != 0:
        q_circuit.append(
            CPhaseGate(-dt / 2 * U),
            [impurity_qubit, impurity_qubit + num_orb],
        )
次に、SKQDアルゴリズムに必要な量子回路を生成します。初期状態(initial_state)を作成してから、異なるステップ数(d = 8)の時間発展演算子を適用して、さまざまなクリロフ基底状態 を生成します。
# The reference state
def initial_state(q_circuit, norb, nocc):
    """Prepare an initial state."""
    for i in range(nocc):
        q_circuit.append(XGate(), [i])
        q_circuit.append(XGate(), [norb + i])
    rot = XXPlusYYGate(np.pi / 2, -np.pi / 2)

    for i in range(3):
        for j in range(nocc - i - 1, nocc + i, 2):
            q_circuit.append(rot, [j, j + 1])
            q_circuit.append(rot, [norb + j, norb + j + 1])
    q_circuit.append(rot, [j + 1, j + 2])
    q_circuit.append(rot, [norb + j + 1, norb + j + 2])

...

# Generate the initial state
qubits = QuantumRegister(2 * n_modes, name="q")
init_state = QuantumCircuit(qubits)
initial_state(init_state, n_modes, n_modes // 2)

...

d = 8  # Number of Krylov basis states
circuits = []
for i in range(d):
    circ = init_state.copy()
    circuits.append(circ)
    for _ in range(i):
        append_diagonal_evolution(dt, U, impurity_index, n_modes, circ)
        circ.append(free_fermion_evolution, qubits)
        append_diagonal_evolution(dt, U, impurity_index, n_modes, circ)
    circ.measure_all()

print(circuits[0].draw(scale=0.4, fold=-1))
このスクリプトは、測定が追加された8個の生成回路のリストを circuits.qpy というファイルに保存します。
mapping.sh は mapping.py ジョブを投入するためのSlurmバッチスクリプトです。これは古典的な計算なので、標準CPUパーティション(--partition=normal)のリソースをリクエストします。
#!/bin/bash
#
#SBATCH --job-name=sqd-mapping
#SBATCH --output=sqd-mapping.out
#SBATCH --nodes=1
#SBATCH --ntasks-per-node=1
#SBATCH --cpus-per-task=1
#SBATCH --partition=normal

srun python /data/ch4/sqd/mapping.py
最適化(optimization.py と optimization.sh)
回路が用意できたら、ターゲットの量子ハードウェア上で効率的に実行できるよう最適化・コンパイルする必要があります。
optimization.py では、まずマッピングステージで作成した circuits.qpy ファイルを読み込み、量子リソースマネージャーである QRMI() を使って量子リソース情報を取得します。次に、Qiskitの generate_preset_pass_manager を高い最適化レベル(optimization_level=3)で使用して、抽象的な論理回路をISA(Instruction Set Architecture)回路に変換します。このプロセスにより、回路はハードウェアのネイティブゲートを使って書き直され、回路の深さを削減しエラーを最小化するよう最適化されます。
...
qrmi = QRMI()
resources = qrmi.resources()
quantum_resource = resources[0]
target = quantum_resource.target

pass_manager = generate_preset_pass_manager(
    optimization_level=3,
    target=target
)
isa_circuits = pass_manager.run(circuits)
トランスパイルされたハードウェア対応回路は isa_circuits.qpy という新しいファイルに保存されます。
トランスパイルは古典的なタスクなので、マッピングスクリプトと同様に、このSlurmジョブも古典CPUパーティション(--partition=normal)で実行されます。
#!/bin/bash
#
#SBATCH --job-name=sqd-mapping
#SBATCH --output=sqd-mapping.out
#SBATCH --nodes=1
#SBATCH --ntasks-per-node=1
#SBATCH --cpus-per-task=1
#SBATCH --partition=normal

srun python /data/ch4/sqd/mapping.py
実行(execution.py と execution.sh)
量子コンピューターが使われるのはこのステージだけです。ここでは最適化された回路を実行して測定サンプルを収集します。
execution.py は最適化済みの isa_circuits.qpy ファイルを読み込み、量子リソースに接続した SamplerV2 プリミティブを初期化します。次に sampler.run() を呼び出して、指定したショット数(shots=500)でQPU上で回路を実行します。
...

qrmi = QRMI()
resources = qrmi.resources()
quantum_resource = resources[0]

# Sample from the circuits
noisy_sampler = Sampler(quantum_resource)
job = noisy_sampler.run(isa_circuits, shots=500)
実行終了時に、すべての回路からの測定結果(ビット列)が収集・統合され、カウントが counts.json ファイルに保存されます。
このステージのSlurmスクリプト execution.sh は他のスクリプトと異なります。量子パーティション(--partition=quantum)で実行するようにリクエストし、1つのQPU(--gres=qpu:1)を具体的に指定します。
#!/bin/bash
#
#SBATCH --job-name=sqd-execution
#SBATCH --output=sqd-execution.out
#SBATCH --nodes=1
#SBATCH --ntasks-per-node=1
#SBATCH --cpus-per-task=1
#SBATCH --partition=quantum
#SBATCH --gres=qpu:1

srun python /data/ch4/sqd/execution.py
後処理(postprocessing.py と postprocessing.sh)
最終ステップでは、古典コンピューターに戻り、量子実験のデータを分析してターゲットシステムの基底状態エネルギーという最終結果を算出します。
postprocessing.py プログラムはまず測定結果を含む counts.json ファイルを読み込みます。次に、アンダーソンモデルのハミルトニアンを(mapping.py と同じパラメーターを使って)再構築します。そして、測定されたビット列とハミルトニアンの定義を diagonalize_fermionic_hamiltonian 関数に渡します。この関数がSKQDのコアロジックを実行します。つまり、ビット列を使って射影ハミルトニアン を構築し、それを対角化して基底状態エネルギーを求めます。
...

def callback(results: list[SCIResult]):
    result_history.append(results)
    iteration = len(result_history)
    print(f"Iteration {iteration}")
    for i, result in enumerate(results):
        print(f"\tSubsample {i}")
        print(f"\t\tEnergy: {result.energy}")
        print(f"\t\tSubspace dimension: {np.prod(result.sci_state.amplitudes.shape)}")

rng = np.random.default_rng(24)
result = diagonalize_fermionic_hamiltonian(
    h1e,
    h2e,
    bit_array,
    samples_per_batch=300,
    norb=n_modes,
    nelec=nelec,
    num_batches=3,
    max_iterations=10,
    symmetrize_spin=True,
    callback=callback,
    seed=rng,
)
最後に、計算されたSKQDエネルギーを出力し、この問題の既知の厳密エネルギーと比較して、計算の最終的な絶対誤差を表示します。
最終的なジョブスクリプトは古典パーティション(--partition=normal)で実行されます。すべての分析が古典的なためです。大きな部分空間の場合、このステップにはより多くの古典HPCリソースが必要になることがあります。
#!/bin/bash
#
#SBATCH --job-name=sqd-postprocessing
#SBATCH --output=sqd-postprocessing.out
#SBATCH --nodes=1
#SBATCH --ntasks-per-node=1
#SBATCH --cpus-per-task=1
#SBATCH --partition=normal

srun python /data/ch4/sqd/postprocessing.py
まとめ
以上です!複雑なハイブリッドプログラムの管理を始めるのに役立つ、いくつかの概念と例を見てきました。もちろん、これは量子リソースと古典HPCリソースの組み合わせでできることのほんの入口に過ぎません。
さらなるユースケースやアルゴリズムを探索するには、IBM Quantum Platformのドキュメントとチュートリアルを参照してください。また、計算科学者とデータセンター管理者の両方に向けたアルゴリズムとソフトウェアの詳細情報については、次のレッスンで共有するリソースもぜひご活用ください。
参考文献
[1] Quantum-Centric Algorithm for Sample-Based Krylov Diagonalization. https://arxiv.org/abs/2501.09702
[2] Chemistry beyond the scale of exact diagonalization on a quantum-centric supercomputer. https://www.science.org/doi/10.1126/sciadv.adu9991