フェルミオン・Circuitを扱う
このガイドで説明する概念は、現在Python APIでのみ利用できます。同等の機能は、今後のリリースでC APIでも提供される予定です。
このガイドでは、FermionicCircuitを使って、先にQubitへマッピングするのではなく、フェルミオン空間で直接クォンタム・アルゴリズムを実装する方法を説明します。
フェルミオン・Circuitを使う理由
Qubitベースのアーキテクチャでフェルミオン・ハミルトニアンの時間発展を実装する、従来のワークフローを考えてみましょう。
-
フェルミオン・ハミルトニアンを定義します(例:)。
-
それをQubit演算子にマッピングします(例:Jordan-Wignerマッピングを使用)。
-
Qubit空間で時間発展を実装します(トロッター分解やその他の手法を使用)。
このアプローチには根本的な限界があります。早い段階でQubitにマッピングすると、フェルミオン構造に関する問題固有の知識が失われてしまいます。標準的な最適化パスはフェルミオンの対称性や許容される項の並べ替えを利用できず、その結果、不要な深さとGate数を持つ最適でないCircuitになります。
FermionicCircuitを使うと、より良いワークフローになります。
-
フェルミオン・ハミルトニアンを定義します(例:)。
-
フェルミオン・Gateを使って、フェルミオン空間で直接時間発展を実装します。
-
トランスパイル処理の一環として、Qubit空間にマッピングします。
このアプローチでは、問題固有の知識をフェルミオン空間に保持することで限界に対処します。フェルミオン空間では、最適化パスがフェルミオン構造や可換関係を利用してCircuitの深さを減らせます。フェルミオン・Circuitは「どのような計算を行うか」を記述し、トランスパイルは「それをQubitにどうマッピングするか」を担当するため、関心事がより明確に分離されます。
汎用的なモード・インデックス
operatorsモジュールとFermionicCircuitはどちらも、モードの性質について何も仮定しない汎用的なモード・ベースのインデックスを使用します。モードとは、フェルミオンの自由度に付けられた抽象的なインデックスにすぎず、固有の意味は持ちません。この設計はoperatorsモジュールと同様であり、最大限の柔軟性を確保します。たとえば、OperatorTraitプロトコルを実装している演算子であれば、その数学的表現に関係なく、時間発展を実装できます。
フェルミオン・Circuitを構築する
以下の例では、前のセクションで説明した時間発展を実装します。フェルミオン・モードの数を指定してFermionicCircuitを構築し、qiskit_fermions.circuit.libraryのフェルミオン・Gateを追加して時間発展を実装します。
この例では、演算子の項のグルーピングを使って、演算子にドメイン知識を組み込む方法も示します。ハミルトニアンの項にグループ・インデックスを割り当てることで、トランスパイル・スタック全体を通じて最適化パスが利用できる構造情報を保持できます。
>>> from qiskit_fermions.circuit import FermionicCircuit
>>> from qiskit_fermions.circuit.library import Evolution
>>> from qiskit_fermions.operators import FermionOperator, cre, ann
>>>
>>> # Create a circuit with 4 fermionic modes
>>> circuit = FermionicCircuit(4)
>>>
>>> # Define a simple fermionic Hamiltonian
>>> hamiltonian = FermionOperator.from_terms([
...     ([cre(0), ann(2)], 0.5),
...     ([cre(2), ann(0)], 0.5),
...     ([cre(1), ann(3)], 0.5),
...     ([cre(3), ann(1)], 0.5),
... ])
>>> # Add some problem structure by grouping our Hamiltonian terms
>>> hamiltonian.groups = [0, 0, 1, 1]
>>>
>>> # Add an evolution gate to implement exp(-i * t * H)
>>> evolution = Evolution(4, hamiltonian, time=1.0)
>>> circuit.append(evolution, circuit.register)


分解のような単純な操作でも、演算子の項のグルーピングが保持されることに注目してください。これは、構造情報がCircuitスタックの中をどのように流れていくかを示しています。Qubitへの完全なトランスパイルについては、フェルミオン・Circuitのトランスパイルガイドを参照してください。
バリアでGateを分離する
最適化パスは、可能な場合は隣接するGateを融合します。たとえば、MergeOrbitalRotationsは連続するOrbitalRotationGateの並びを1つにまとめ、MergeSlaterDeterminantPreparationはInitializeModesを、それに続く回転に畳み込みます。
これを防ぎたい場合は、FermionicCircuit.barrier()を使用します。バリアにはユニタリ作用がないため、Circuitが準備する状態は変わりません。バリアは、パスが融合を行わない境界を示すだけです。引数なしで呼び出すとすべてのモードにまたがり、モードを渡すとそのモードに限定できます。
>>> from qiskit_fermions.circuit.library import OrbitalRotation
>>> import numpy as np
>>>
>>> rotations = FermionicCircuit(4)
>>> rotations.append(OrbitalRotation(np.eye(4, dtype=complex)), rotations.register)
>>> rotations.barrier()
>>> rotations.append(OrbitalRotation(np.eye(4, dtype=complex)), rotations.register)

バリアはフェルミオンからQubitへのトランスパイル後も残るため、その後のQubitレベルの最適化にも制約を与えます。この段階については、フェルミオン・Circuitのトランスパイルガイドで説明しています。
Circuitを繰り返す
多くのアルゴリズムでは、同じGateのブロックを何度も適用します。時間発展が典型的な例です。トロッター・ステップを一度構築し、目標の時間に達するまで繰り返します。繰り返しCircuitを構築するにはrepeat()を、それを状態準備のプレフィックスに結合するにはcompose()を使用します。
以下の例では、Fermi-Hubbardモデルの2次のトロッター・ステップを構築します。このステップは対称的です。ホッピング項を、オンサイト相互作用を挟む、時間幅が半分の2つのOrbitalRotationGateに分割します。
>>> import scipy.linalg
>>> from qiskit_fermions.circuit.library import InitializeModes, OrbitalRotation
>>>
>>> norb, reps, time = 2, 3, 1.0
>>> num_modes = 2 * norb
>>> dt = time / reps
>>>
>>> hopping = np.zeros((norb, norb))
>>> hopping[0, 1] = hopping[1, 0] = -1.0
>>> interaction = FermionOperator.from_dict(
...     {(cre(p), ann(p), cre(p + norb), ann(p + norb)): 2.0 for p in range(norb)}
... )
>>>
>>> def rotation(duration):
...     propagator = scipy.linalg.expm(-1j * duration * hopping)
...     # the same rotation acts on the alpha and beta halves of the register
...     return scipy.linalg.block_diag(propagator, propagator)
>>>
>>> trotter_step = FermionicCircuit(num_modes)
>>> trotter_step.append(OrbitalRotation(rotation(dt / 2)), trotter_step.modes)
>>> trotter_step.append(
...     Evolution(num_modes, interaction, dt, atomic=True), trotter_step.modes
... )
>>> trotter_step.append(OrbitalRotation(rotation(dt / 2)), trotter_step.modes)
このステップを繰り返し、Hartree-Fock参照状態に結合すると、完全な時間発展が得られます。
>>> evolution = FermionicCircuit(num_modes)
>>> evolution.append(InitializeModes([True, False, True, False]), evolution.modes)
>>> evolution.compose(trotter_step.repeat(reps), inplace=True)
>>> evolution.count_ops()["OrbitalRotation"]
6
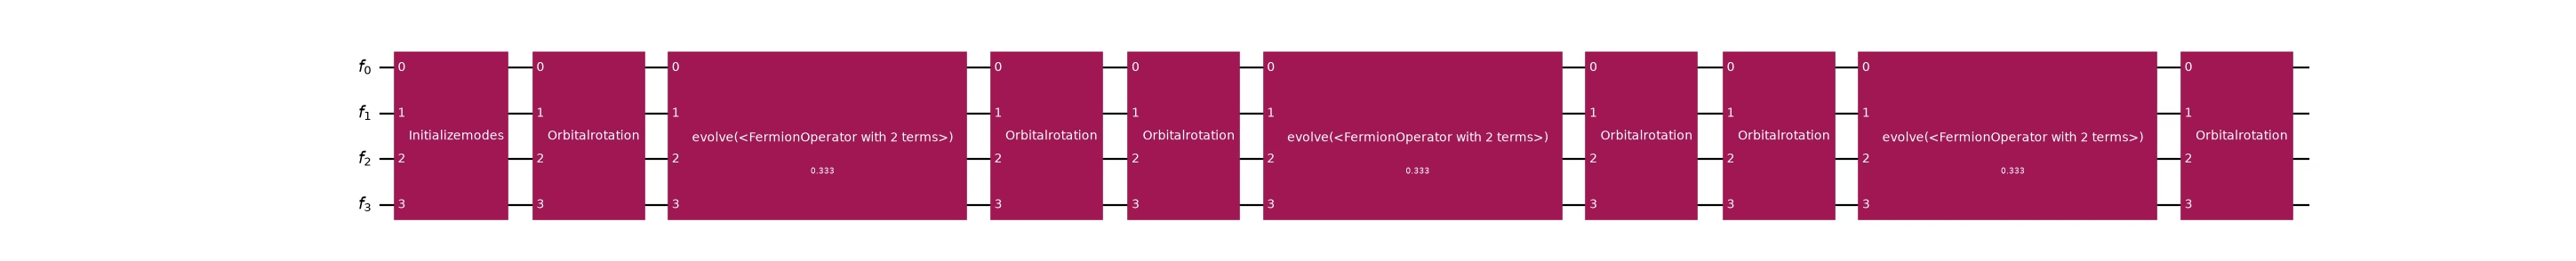
繰り返しは単一のGateにまとめられるのではなく、返されるCircuitに展開されるため、count_ops()ではステップごとに2つの回転が数えられます。この展開によって、ステップの境界にある冗長性がTranspilerから見えるようになります。あるステップの末尾の半分の時間幅の回転と、次のステップの先頭の回転が隣接するため、MergeOrbitalRotationsがそれらを1つの回転にまとめます。
>>> from qiskit_fermions.transpiler import FermionicPassManager
>>> from qiskit_fermions.transpiler.passes import MergeOrbitalRotations
>>>
>>> merged = FermionicPassManager([MergeOrbitalRotations()]).run(evolution)
>>> merged.count_ops()["OrbitalRotation"]
4
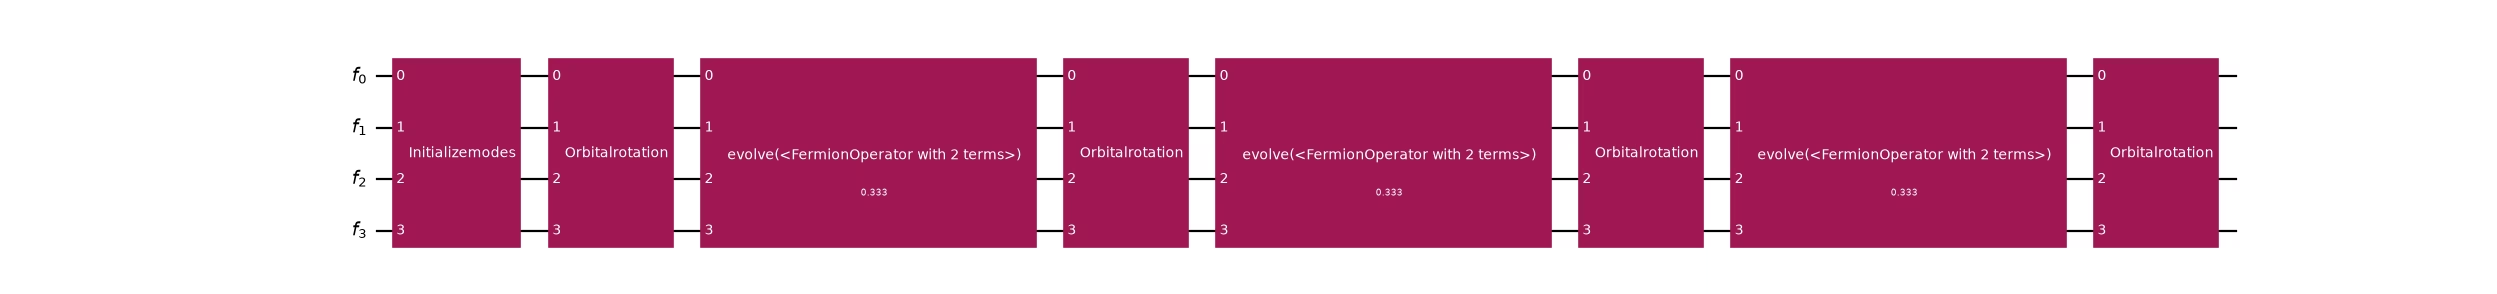
結果のコストは、ステップごとに1回転、さらに1回転が加わったものになります。これは、半ステップを手作業で融合した場合と同じです。ステップを自然な対称形で記述して繰り返せば同じCircuitが得られるため、融合は最適化の段階に任せることができます。
繰り返しを分離したままにしたい場合は、insert_barriers=Trueを渡して、それらの間にbarrier()を配置します。最適化パスはバリアをまたいでGateを融合しないため、すべての回転が残ります。
>>> separated = trotter_step.repeat(reps, insert_barriers=True)
>>> FermionicPassManager([MergeOrbitalRotations()]).run(separated).count_ops()[
...     "OrbitalRotation"
... ]
6
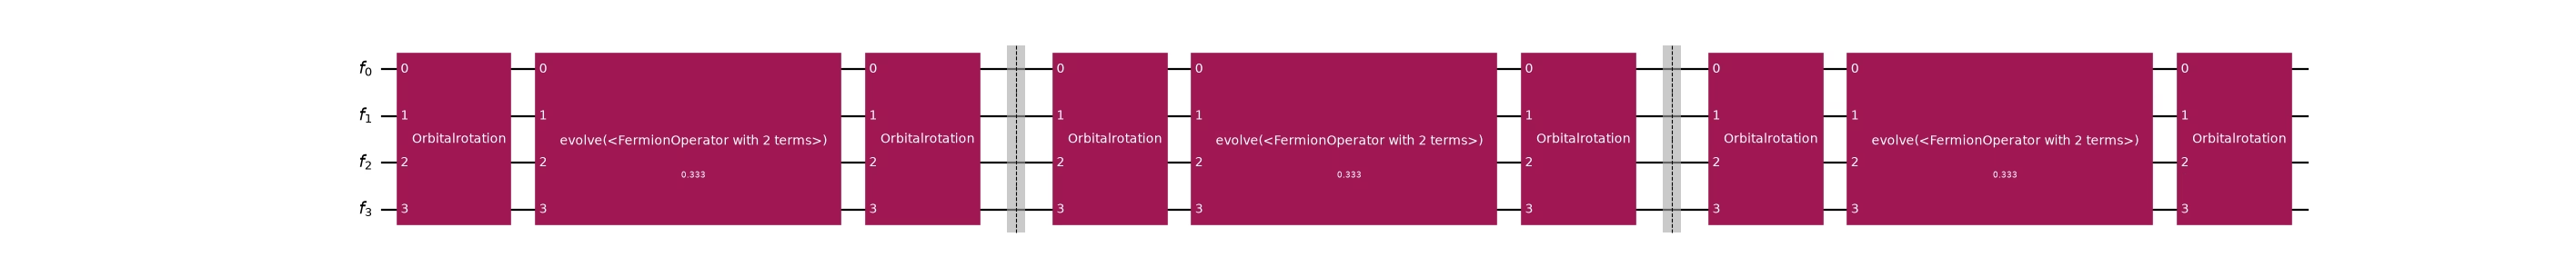
FermionicSuzukiTrotterのreps引数は、別の概念です。これは1つのEvolutionGateを、より短い多数の因子に細分化します。一方、repeat()はCircuit全体を複製します。1つのEvolutionを含むCircuitを繰り返しても、全体の時間発展の時間が増えるだけです。
フェルミオン・モードを測定する
measure_all()は、すべてのモードをそれぞれ専用の古典ビットに読み出し、モードiをビットiに対応付けます。一部のモードだけを読み出すには、独自のClassicalRegisterとともにmeasure()を使用します。
>>> measured = trotter_step.measure_all(inplace=False)
>>> measured.count_ops()["measure"]
4
inplace=Falseを渡すと、測定を加えたコピーが返され、元のCircuitはそのまま残ります。測定はユニタリではなく、測定を含むCircuitはもはや状態ベクトルに適用できないため、シミュレーションも行いたい場合は測定していないCircuitを手元に残しておいてください。
トランスパイル後のQuantumCircuitではなく、ここで測定することで、サンプリングされたビット列が読み取りやすくなります。フェルミオン測定は読み出すモードを名前で指定するため、モードを移動させるすべての段階(フェルミオンレベルのRelabelModes、Qubitレベルのレイアウトとルーティング)が測定も一緒に運びます。そのため、ビット列は、指定したモードに対応したインデックスのままになります。
measure_all()とは異なり、測定の前にbarrier()は挿入されません。バリアが必要な場合は、先に自分でbarrier()を呼び出してください。
測定されたビットが期待どおりの意味を持つかどうかは、ここではなくトランスパイル中に選ばれるフェルミオン-Qubitエンコーディングによって決まります。Jordan-Wignerのような占有基底のエンコーディングでは、各モードは1つのQubitで表され、ビットはそのモードの占有数になります。詳しくはFermionicMeasureを参照してください。
フェルミオン・Circuitをトランスパイルする
FermionicCircuitが表すクォンタム・アルゴリズムを実行するには、それをQuantumCircuitにトランスパイルする必要があります。その方法は、フェルミオン・Circuitのトランスパイルガイドで学べます。
次のステップ
-
qiskit_fermions.circuit.libraryのドキュメントで、利用可能なフェルミオン・Gateについて学びましょう。 -
演算子の解説ガイドを参照して、フェルミオン・Circuitで使用できるフェルミオン・ハミルトニアンの構築方法を理解しましょう。
-
実践的なエンドツーエンドの例については、SQDRIFTの入門ガイドを確認してください。
-
ffsimとの関係に関するガイドを読んで、
FermionicCircuitを直接シミュレーションする方法と、これらの汎用的なモード・インデックスがシミュレーション時にのみスピンの意味を持つ仕組みを理解しましょう。