フローセットを用いた2次元Fermi-Hubbard動力学のシミュレーション
このガイドの概念は現在、Python APIでのみ利用可能です。同等の機能は、今後のリリースでC APIでも利用できるようになる予定です。
まず 1次元フローセットガイド をお読みください。 このガイドはその2次元版の続編であり、そこで説明された情報を繰り返しません。転送演算子と頂点演算子、フローセットとは何か、groups がどのように回路に引き継がれるか、そしてカスタム符号化が MapperFnEvolutionSynthesis を通じてどのようにTranspilerに組み込まれるかです。
全体で参照されるTranspilerの各段階についてはトランスパイルガイドを、カスタムマッパーを書くための一般的な手順についてはマッパーガイドを参照してください。
1次元ガイドは、2次元を扱う際には局所符号化が必要になると述べて終わりました。このガイドはそのステップを進め、正方格子上の2次元Fermi-Hubbardモデルを、Verstraete-Cirac(VC)符号化 [2] を用いて扱います。
この研究の基礎となる、1次元の問題との違いは3つあります。
-
フローセットが増える。 鎖には2つの矢印の向きがありますが、正方格子には4つ(東、西、北、南)あり、それぞれが単一のパスではなく、頂点を共有しない有向パスの和集合(格子の行または列ごとに1つ)です。
-
符号化はサイトごとに補助Qubitを得る。系全体で1つではなく、その結果、
Qubit対モード比は になります。転送演算子は重み3(水平)と重み4(垂直)のPauliになり、4つのフローセットはそれぞれ独自のPauli形状に写像されるため、それぞれが独自の対角化Cliffordを必要とします。
-
エンコードされたハミルトニアンは部分空間上でのみ忠実です: 同時
プラケット制約の同時 固有空間上でのみ成り立ちます [2] [3]。1次元では符号化は単なるアイソメトリであり、検証はスペクトルのチェックでした。ここでは、ステップ9が示すように、比較を射影しなければなりません。
得られる利点は1次元と同じ形です。1回のTrotterステップの2Qubit深さは格子サイズに対して一定となり、 です(ホッピングが で文献 [1] と一致し、相互作用が )。一方、同じ符号化されたハミルトニアンの項ごとのTrotter化は線形に増加します。もちろん、Gate数は依然として結合の数とともに増加します。サイズに依存しなくなるのは、それらのGateが占める層の数です。ここでの深さはすべて、抽象的で完全に結合されたレジスタ上で数えています。符号化をデバイスの制限された結合マップに写像することはそれ自体が別の問題で、最後に議論します。
格子とその4つの向き
最初の変化は、有向相互作用グラフに現れます。サイトは行優先の順序で番号付けされ、site(r, c) = r * cols + c となり、1次元の鎖と同じようにすべての結合は両方の向きを持ちますが、今度は結合が2つの軸に沿って走ります。
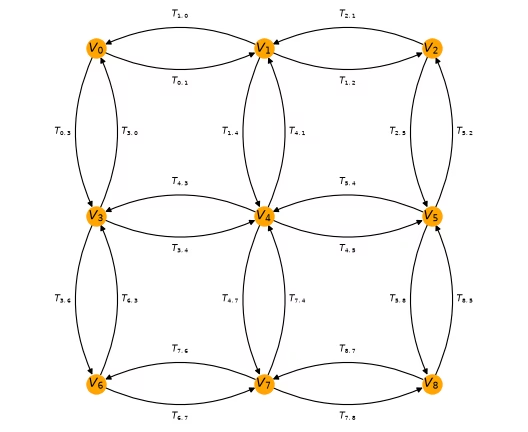
可換規則は1次元のものと変わりません。サイトを共有する2つの転送演算子は、矢印がそこを通過して流れるときに可換であり、衝突するときに反可換です。しかし、サイトには今や2つではなく最大4つの結合が接続しているため、そこを通る矢印はより多くの方法で衝突し得て、決して衝突しない矢印の集合はもはや単一のパスではありません。水平な矢印を左から右へ読むと1つのそのような集合が得られ、垂直な矢印を上から下へ読むと別の集合が得られ、それぞれを反転させるとさらに2つが得られます。これらが、以降のすべてを構成する東、西、北、南のフローセットです。
Verstraete-Cirac符号化
Verstraete-Cirac(VC)は、すべてのフェルミオンモード をそれ専用の補助Qubitと対にします。 個の格子サイトがある場合、モード はQubit 上にあり、その補助Qubitは Qubit 上にあるため、レジスタは 個のQubitを保持します。頂点演算子は可能な限り単純なままで、
これにより、占有数を後で直接読み取ることができます。転送演算子は辺の向きに依存します。水平な辺 ( が西のサイト)と、垂直な辺( が北のサイト)では、
重み3の「三角形」と重み4の「正方形」になります。各矢印を識別することが重要です。 が西のサイトの場合、 は東を指しますが、 が北のサイトの場合は南を指します。逆の向きは恒等式 から得られ、これにより XXZ の三角形は YYZ に、XYXY の正方形は YXXY になります。これら4つの異なるラベルが4つのフローセットであり、このガイドの残りでそれらを追跡します。
これらは文献の式 (A1) と完全には一致しません。 [1] は「単一量子ビット回転を除いて」と述べていますが、ここでは3点が異なります。論文と照らし合わせる読者が気づくはずなので、明記しておきます。
-
係数: 式 (A1) には係数がありません。ここでの は とするためのもので、
TransferVertexOperatorが用いる規格化 と一致します。論文では転送演算子は の中でしか必要とされず、そこでは係数が回転角に吸収されます。ここでは、ある恒等式を満たす演算子である必要があります。 -
向き: 式 (A1) は の行の偶奇で文字を選びます。水平な辺では両端点で同じになるため、 と を区別しません。論文では、 の層で共役をとることで向きを別途復元しています。このガイドでは代わりに向きをエンコーディングに組み込み、 から逆向きを導きます。これにより、2つの向きがステップ3で異なるパウリ演算子に対応します。
-
垂直方向の形: 式 (A1) は行の偶奇で
XXXXとYYYYを交互に使いますが、このガイドでは単一のXYXYを使います。これらは同じことを実現する2通りの方法で、垂直な辺がそれに接する水平な辺と正しく衝突するための文字の非対称性です。この違いを自由な基底選択と見なさないでください。偶奇による交替をやめて単一のXXXXを使うと、代数が完全に破綻します。そのため、異なる文字は仮定ではなく検証されます。
アンシラはサイトに付随し、比率は になります。(奇数の) プラケットごとに補助量子ビットを置き、比率を に下げるのがダービー・クラッセン・エンコーディングです。ここで VC を使うのは、その転送演算子の対角化クリフォードが文献 Ref. [1] に閉じた形で与えられているためです。
1. 正方格子上のハミルトニアン
構成は1次元の場合と同じですが、辺のリストが2次元になります。サイトには上の図で使った行優先の番号付け site(r, c) = r * cols + c をそのまま使います。これにより、水平な結合は連続するインデックスを結び、垂直な結合は cols だけ異なるインデックスを結びます。
>>> from collections import defaultdict
>>> from qiskit_fermions.operators import TransferVertexOperator
>>>
>>> def fermi_hubbard_2d(rows, cols, tunneling, interaction):
...     site = lambda r, c: r * cols + c
...     edges = [(site(r, c), site(r, c + 1)) for r in range(rows) for c in range(cols - 1)]
...     edges += [(site(r, c), site(r + 1, c)) for r in range(rows - 1) for c in range(cols)]
...     data: defaultdict[tuple[tuple[int, int], ...], complex] = defaultdict(complex)
...     for j, k in edges:
...         # hopping: -t (a^dag_j a_k + a^dag_k a_j) = t (T_jk + T_kj)
...         data[((j, k),)] += tunneling
...         data[((k, j),)] += tunneling
...         # interaction: U n_j n_k with n_j = (1 - V_j) / 2
...         data[()] += interaction / 4
...         data[((j, j),)] -= interaction / 4
...         data[((k, k),)] -= interaction / 4
...         data[((j, j), (k, k))] += interaction / 4
...     return TransferVertexOperator.from_dict(data)
>>>
>>> rows, cols = 3, 3
>>> num_sites = rows * cols
>>> hamiltonian = fermi_hubbard_2d(rows, cols, tunneling=1.0, interaction=2.0)
>>> print(f"Number of terms: {len(hamiltonian)}")
Number of terms: 46
2. 2つではなく4つのフロー集合
各ホッピング項は、格子上で矢印が向く方向によって分類します。2つの端点の divmod による行・列座標を比較して水平な辺と垂直な辺を分け、差の符号から向きを決めます。対角的なものすべて (恒等演算子、 項、 項) は5番目のグループに入ります。
向きの規約。 名前は上の図から読み取っただけのものです。矢印が行に沿って右向きか左向きかで東か西、列に沿って上向きか下向きかで北か南とします。番号付けが行優先なので、東と南がインデックスの増える方向です。以降の処理は名前に依存しません (グループのラベルにすぎません) が、混同しやすいので図と照らして確認しておくとよいでしょう。文献 Ref. [1] も正方格子のフロー集合を同じ名前で呼んでいます。
>>> EAST, WEST, NORTH, SOUTH, DIAGONAL = range(5)
>>>
>>> def flow_set_groups(operator, cols):
...     groups = []
...     for terms, _ in operator.iter_terms():
...         if len(terms) == 1 and terms[0][0] != terms[0][1]:
...             j, k = terms[0]
...             row_j, col_j = divmod(j, cols)
...             row_k, col_k = divmod(k, cols)
...             if row_j == row_k:
...                 groups.append(EAST if col_k > col_j else WEST)
...             else:
...                 groups.append(SOUTH if row_k > row_j else NORTH)
...         else:
...             groups.append(DIAGONAL)
...     return groups
>>>
>>> hamiltonian.groups = flow_set_groups(hamiltonian, cols)
>>>
>>> names = ["east", "west", "north", "south", "diagonal"]
>>> for index, name in enumerate(names):
...     count = sum(1 for group in hamiltonian.groups if group == index)
...     print(f"{name:9s} {count:2d}")
east       6
west       6
north      6
south      6
diagonal  22
1つのフロー集合の中では、1次元の場合と同様に、どの矢印も他の矢印と頭尾でつながるか、まったくつながらないかのどちらかです。したがってフロー集合は項ごとに可換のままで、その時間発展にはトロッター誤差が生じません。新しいのは、フロー集合が非連結になる点です。rows x cols 格子の東集合は、rows 本の独立した左から右への経路からなります。この非連結性は、ステップ6で示すように、複雑さではなくむしろ利点です。
3. 演算子のエンコード
エンコーディングは、1つの一般化転送演算子をパウリ文字列に写す1つの関数で、それが map_transfer_vertex_generators() に渡されます。1次元版と比べて本体の場合分けが増え、対角、水平、垂直、そして による逆向きがあります。
1つ問題があります。map_transfer_vertex_generators() はジェネレーターだけを渡してコールバックしますが、結合のパウリ文字列を決めるには、モードのインデックスから行と列の座標を復元するための cols も必要です。関数を入れ子にして閉包で捉える代わりに、functools.partial() で束縛します。こうすると両方の関数がトップレベルに置かれ、それぞれ単独で呼び出せます。
>>> from functools import partial
>>>
>>> from qiskit.quantum_info import SparseObservable
>>> from qiskit_fermions.mappers import map_transfer_vertex_generators
>>>
>>> def ancilla_qubit(mode, num_sites):
...     """The auxiliary qubit paired with fermionic mode `mode`."""
...     return num_sites + mode
>>>
>>> def vc_action(generator, width, cols):
...     """Map one generalized transfer operator to its Verstraete-Cirac Pauli."""
...     num_sites = width // 2
...     ancilla = partial(ancilla_qubit, num_sites=num_sites)
...     j, k = generator
...     if j == k:  # vertex operator V_j = Z_j
...         return SparseObservable.from_sparse_list([("Z", [j], 1.0)], num_qubits=width)
...     row_j, col_j = divmod(j, cols)
...     row_k, col_k = divmod(k, cols)
...     if row_j == row_k:  # horizontal: weight-3 triangle
...         left, right = (j, k) if col_j < col_k else (k, j)
...         operator = SparseObservable.from_sparse_list(
...             [("XXZ", [left, right, ancilla(left)], 0.5)], num_qubits=width
...         )
...         forward = (j, k) == (left, right)
...     else:  # vertical: weight-4 square
...         up, down = (j, k) if row_j < row_k else (k, j)
...         operator = SparseObservable.from_sparse_list(
...             [("XYXY", [up, down, ancilla(up), ancilla(down)], 0.5)], num_qubits=width
...         )
...         forward = (j, k) == (up, down)
...     if forward:
...         return operator
...     # reverse orientation: T_kj = -V_j V_k T_jk
...     v_j = SparseObservable.from_sparse_list([("Z", [j], 1.0)], num_qubits=width)
...     v_k = SparseObservable.from_sparse_list([("Z", [k], 1.0)], num_qubits=width)
...     return (-1.0 * v_j.compose(v_k).compose(operator)).simplify()
>>>
>>> def vc_encoding(operator, width, cols):
...     """Map a TransferVertexOperator to a qubit observable, Verstraete-Cirac style."""
...     return map_transfer_vertex_generators(
...         operator,
...         partial(vc_action, width=width, cols=cols),
...         identity=lambda: SparseObservable.identity(width),
...         compose=SparseObservable.compose,
...     ).simplify()
>>>
>>> # bind the lattice width once; the transpiler only ever passes (operator, width)
>>> encoding = partial(vc_encoding, cols=cols)
>>> num_qubits = 2 * num_sites
>>> num_qubits
18
マッピングの前にグループ化する利点はすぐにわかります。各フロー集合は、集合全体で一様な単一のパウリの形にエンコードされます。
>>> for index, name in enumerate(names):
...     observable = encoding(hamiltonian.split_out_groups()[index], num_qubits)
...     shapes = sorted({label for label, _, _ in observable.to_sparse_list()})
...     print(f"{name:9s} {shapes}")
east      ['XXZ']
west      ['YYZ']
north     ['YXXY']
south     ['XYXY']
diagonal  ['', 'Z', 'ZZ']
4つのホッピングの形はそれぞれ異なるため、各フロー集合にはステップ5で固有のクリフォードが与えられます。逆向きは同じものの名前を付け替えたものではなく、別のパウリ演算子です。このため、1次元の合成では回路が1つで済むのに対し、2次元のフロー集合の合成では4つの回路が必要になります。
4. カスタムエンコーディングでトランスパイルする
この段階は、量子ビットレジスターが広くなった1次元版と同じです。CustomF2QLayout が モードのレジスターを 個の量子ビットに対応づけ、MapperFnEvolutionSynthesis がエンコーディングを担い、その product_formula 引数が、得られた PauliEvolutionGate の分解方法を選びます。単一のアンシラについて同じパイプラインを構築する1次元ガイドのステップ6と比べてみてください。
>>> from qiskit.circuit import QuantumRegister
>>> from qiskit.passmanager import MultiStagePassManager
>>> from qiskit.synthesis import LieTrotter
>>> from qiskit_fermions.circuit import FermionicCircuit
>>> from qiskit_fermions.circuit.library import Evolution
>>> from qiskit_fermions.circuit.library.synthesis import FermionicLieTrotter
>>> from qiskit_fermions.transpiler import FermionicCircuitToDAG, QuantumDAGToCircuit
>>> from qiskit_fermions.transpiler.passes import (
...     CustomF2QLayout,
...     F2QSynthesis,
...     MapperFnEvolutionSynthesis,
... )
>>>
>>> total_time = 1.0
>>>
>>> def flow_set_pass_manager(mode_register, encoding, product_formula=None):
...     """Build the pipeline mapping `mode_register` with the VC `encoding`."""
...     synthesis = F2QSynthesis()
...     synthesis.methods["Evolution"] = MapperFnEvolutionSynthesis(
...         encoding, product_formula=product_formula
...     )
...     # this encoding spends one ancilla per fermionic mode
...     qubit_register = QuantumRegister(2 * mode_register.size, "q")
...     return MultiStagePassManager(
...         input=FermionicCircuitToDAG(),
...         layout=CustomF2QLayout({mode_register: qubit_register}),
...         synthesis=synthesis,
...         output=QuantumDAGToCircuit(),
...     )
>>>
>>> circuit = FermionicCircuit(num_sites)
>>> circuit.append(
...     Evolution(
...         num_sites, hamiltonian, time=total_time, synthesis=FermionicLieTrotter()
...     ),
...     circuit.modes,
... )
>>>
>>> # as in 1D, one decompose() splits the Evolution group by group (five gates here,
>>> # the four hopping flow sets in group order, then the diagonal interaction)
>>> flow_set_circuit = circuit.decompose()
>>> flow_set_circuit.count_ops()["Evolution"]
5
ステップ2で数えた 6、6、6、6、22 個の項をそれぞれ持つ5つのゲートです。各ゲートは独立にマッピングされ合成されるため、フェルミオンのレベルで決めた分割が回路に至るまで保たれます。
>>> pass_manager = flow_set_pass_manager(flow_set_circuit.register, encoding, LieTrotter())
>>> qubit_circuit = pass_manager.run(flow_set_circuit)
>>> qubit_circuit.num_qubits
18
>>>
>>> def two_qubit_stats(circuit):
...     decomposed = circuit.decompose(reps=6)
...     two_qubit = lambda instruction: len(instruction.qubits) == 2
...     return decomposed.count_ops().get("cx", 0), decomposed.depth(two_qubit)
>>>
>>> two_qubit_stats(qubit_circuit)
(144, 47)
これがベースラインです。エンコーディングとグループ化はどちらも済んでいますが、LieTrotter は各フロー集合を項ごとに合成するため、深さは格子とともに増加します。
5. フロー集合ごとの深さ2のクリフォード
仕組みは1次元と同じです。可換なフロー集合全体を、各項を互いに異なる重み1のパウリに写すクリフォードで共役します。こうすると、集合全体の時間発展のコストは単一量子ビット回転だけになります。1次元では CZ ゲートのブリックワーク1層がこの役割を果たしました。
2次元では、文献 Ref. [1] の IV C 節と図7に従って、各フロー集合に固有の回路が必要です。4つとも一度に格子の1本の線 (東西なら行、南北なら列) とその線のアンシラに作用し、いずれも次の3つの部分からなる同じ形をしています。
-
単一量子ビット回転の層。各量子ビットを、そのフロー集合が必要とする基底に置きます。
-
最初の
CX層。常に同じサイトのサイトとアンシラの間に入ります。 -
2番目の
CX層。線に沿って隣り合うものを結合します。
ステップ2と3だけが2量子ビット層なので、線の長さにかかわらず2量子ビット深さは です。以下ではフロー集合ごとに1つの関数として書き出します。回転がそうなっているのは、各フロー集合の項を共役して、互いに異なる重み1の像になることを要件として見つけたためです。そのため、与えられたものとして扱い、続く検査を信頼してください。
2つの水平な集合が最も単純です。項は重み3の XXZ と YYZ で、サイト上の を に変える追加の だけが異なります。
>>> from qiskit.circuit import QuantumCircuit
>>>
>>> def east_clifford(circuit, line, ancilla):
...     """Diagonalize the east flow set (XXZ) on one lattice row."""
...     for j in line:
...         circuit.h(ancilla(j))
...     for j in line[:-1]:  # layer 1: each site with its own ancilla
...         circuit.cx(ancilla(j), j)
...     for j, k in zip(line, line[1:]):  # layer 2: ancilla with the next site along
...         circuit.cx(k, ancilla(j))
>>>
>>> def west_clifford(circuit, line, ancilla):
...     """Diagonalize the west flow set (YYZ) on one lattice row."""
...     for j in line:
...         circuit.s(j)  # the only difference from east: X -> Y on the sites
...         circuit.h(ancilla(j))
...     for j in line[:-1]:
...         circuit.cx(ancilla(j), j)
...     for j, k in zip(line, line[1:]):
...         circuit.cx(k, ancilla(j))
2つの垂直な集合は重み4の XYXY と YXXY で、その分だけ込み入っています。回転は線に沿った位置によって交互に変わり、2番目の CX 層も交互に、偶数位置ではサイト同士、奇数位置ではアンシラ同士を結合します (またはその逆です)。
>>> def south_clifford(circuit, line, ancilla):
...     """Diagonalize the south flow set (XYXY) on one lattice column."""
...     for position, j in enumerate(line):
...         if position % 2 == 0:
...             circuit.sdg(ancilla(j))
...             circuit.h(ancilla(j))
...         else:
...             circuit.h(j)
...             circuit.s(j)
...             circuit.h(ancilla(j))
...             circuit.s(ancilla(j))
...     for j in line:  # layer 1
...         circuit.cx(ancilla(j), j)
...     for position, (j, k) in enumerate(zip(line, line[1:])):  # layer 2
...         if position % 2 == 0:
...             circuit.cx(ancilla(j), ancilla(k))  # ancilla to ancilla
...         else:
...             circuit.cx(j, k)  # site to site
>>>
>>> def north_clifford(circuit, line, ancilla):
...     """Diagonalize the north flow set (YXXY) on one lattice column."""
...     for position, j in enumerate(line):
...         if position % 2 == 0:
...             circuit.h(ancilla(j))
...             circuit.s(ancilla(j))
...         else:
...             circuit.h(j)
...             circuit.s(j)
...             circuit.sdg(ancilla(j))
...             circuit.h(ancilla(j))
...     for j in line:  # layer 1
...         circuit.cx(ancilla(j), j)
...     for position, (j, k) in enumerate(zip(line, line[1:])):  # layer 2
...         if position % 2 == 0:
...             circuit.cx(k, j)  # site to site, and the other way round from south
...         else:
...             circuit.cx(ancilla(j), ancilla(k))
3サイトの1本の線 (まずサイト、次にそのアンシラ) に描くと、仕組み全体が1つの図に収まります。2つのうち三角形の形のほうがわかりやすく、アンシラの基底変換のあとに2つの CX 層が続き、最初の層は各サイトを自身のアンシラと組にし、2番目の層は線に沿って次のサイトに届きます。
>>> line = [0, 1, 2]  # three sites, with ancillas on qubits 3, 4, 5
>>> triangle = QuantumCircuit(6)
>>> east_clifford(triangle, line, lambda mode: 3 + mode)
>>> triangle.draw("mpl")
<Figure size ... with 1 Axes>

正方形の形はより多くの単一量子ビット操作を必要とし (回転は線に沿って交互に変わります)、その2番目の CX 層はサイト同士の結合とアンシラ同士の結合を交互に行います。
>>> square = QuantumCircuit(6)
>>> south_clifford(square, line, lambda mode: 3 + mode)
>>> square.draw("mpl")
<Figure size ... with 1 Axes>

どちらも CX 層2つ分の深さで、線にサイトを追加しても深くならずに幅だけが広がります。これが定数深さの主張のすべてで、見ればわかります。西と北のクリフォードは単一量子ビット層だけが異なるため、別々には描きません。
合成にまだ必要なのは、各項がどこに行き着くかを決めることです。 個のサイトからなる線には 個の結合があり、それぞれが1つの項を与えるので、以下のヘルパーは結合ごとに1つのエントリーを返します。項が移った量子ビットと、それがなった単一量子ビットのパウリです。重要なのは、これらが予測されたものではなく共役から読み取られることです。1つの CZ ブリックワークが を閉じた形で与える1次元とは異なり、ここにはそのような公式がなく、列の線のアンシラは連続していません。フロー集合ごとに異なるのは入力するパウリ文字列だけで、それはステップ3ですでに出力しました。
>>> from qiskit.quantum_info import Clifford, SparsePauliOp
>>>
>>> def clifford_supports(clifford, pauli, line, ancilla, num_qubits):
...     """Conjugate a flow set's terms to find which qubit each one lands on.
...
...     `pauli` is the flow set's Pauli string, as printed in step 3. Its letters apply
...     to the i-th term's qubits in the order below: the two sites of the bond, then
...     their ancillas.
...
...     This is the one check that needs SparsePauliOp: Clifford conjugation wants a
...     `Pauli` and its symplectic bits, and SparseObservable exposes neither -- its own
...     `evolve` conjugates by a Pauli, not by a Clifford.
...     """
...     supports = []
...     for i in range(len(line) - 1):
...         qubits = [line[i], line[i + 1], ancilla(line[i]), ancilla(line[i + 1])]
...         term = SparsePauliOp.from_sparse_list(
...             [(pauli, qubits[: len(pauli)], 1.0)], num_qubits=num_qubits
...         )
...         image = term.paulis[0].evolve(clifford, frame="s")
...         # a weight-1 image has exactly one qubit with an X and/or Z bit set
...         (support,) = np.nonzero(image.x | image.z)
...         assert len(support) == 1, f"term {i} is not weight-1"
...         supports.append((int(support[0]), image[support].to_label()))
...     return supports
像は互いに異なり、かつ重み1になる必要があります。そうすれば各項を自身の量子ビット上で独立に回転できます。2量子ビット深さ は、上の4つの構成ですでに見えており、どれも線の長さに関係なく2つの CX 層を出力します。以下では、両方の性質をすべてのフロー集合、すべての線、そして複数の格子サイズにわたって検査します。ステップ6はその後 clifford_supports を呼び出すので、これは単なる実演ではなく合成の実働部分です。
6. フロー集合を考慮した合成
合成には有利な出発点があります。Evolution はグループごとに自身を分割するため、synthesize はフロー集合ごとに1回 (ここでは5回、4つのホッピング集合と対角グループ) 呼び出されます。したがって、そこで扱うすべてのホッピング項が同じパウリの形を共有し、1つのクリフォードですべてを対角化できます。最初の項からその形を読み取り、残りをどの線上にあるかで分類するだけで済みます。そこで、2次元が思ったより安く済む理由となる観察が得られます。
1つのフロー集合の成分は頂点が互いに素です。西集合の行同士は量子ビットを共有しません。そのため、1つのフロー集合のクリフォードはすべてまとめて出力でき、行を1つずつ順番待ちさせることなく、同じ2つの2量子ビット層を共有します。したがって、1つのフロー集合のコストは、格子の行数や列数にかかわらず一定の層数 (クリフォードに2、その逆に2) になり、これが全体の深さが定数になる理由です。
>>> from qiskit.synthesis.evolution import EvolutionSynthesis
>>>
>>> # The interaction couples nearest neighbors only, so every interior site carries four
>>> # Rzz gates -- one per bond -- and can only do one at a time: four layers is the best
>>> # any schedule can achieve. Horizontal bonds split by column parity, vertical ones by
>>> # row parity, which achieves it.
>>> def rzz_layers(circuit, angles, cols):
...     """Emit the diagonal Rzz gates in four layers of disjoint qubit pairs."""
...     horizontal = [(j, k) for j, k in angles if k - j == 1]
...     vertical = [(j, k) for j, k in angles if k - j == cols]
...     schedule = [
...         [(j, k) for j, k in horizontal if (j % cols) % 2 == 0],
...         [(j, k) for j, k in horizontal if (j % cols) % 2 == 1],
...         [(j, k) for j, k in vertical if (j // cols) % 2 == 0],
...         [(j, k) for j, k in vertical if (j // cols) % 2 == 1],
...     ]
...     # emit layer by layer, since Qiskit's depth follows the order gates were added
...     for layer in schedule:
...         for j, k in layer:
...             circuit.rzz(angles[j, k], j, k)
>>>
>>> class FlowSetSynthesis(EvolutionSynthesis):
...     """Synthesize one 2D line flow set at a time, via its depth-2 Clifford."""
...
...     preserve_order = True
...
...     def __init__(self, rows, cols):
...         self.rows, self.cols = rows, cols
...
...     def rows_of_lattice(self):
...         return [[r * self.cols + c for c in range(self.cols)] for r in range(self.rows)]
...
...     def columns_of_lattice(self):
...         return [[r * self.cols + c for r in range(self.rows)] for c in range(self.cols)]
...
...     def synthesize(self, evolution):
...         num_qubits = 2 * self.rows * self.cols
...         ancilla = partial(ancilla_qubit, num_sites=self.rows * self.cols)
...         circuit = QuantumCircuit(evolution.operator.num_qubits)
...         terms = [
...             (label, indices, 2 * evolution.time * coeff.real)
...             for label, indices, coeff in evolution.operator.to_sparse_list()
...         ]
...
...         # `Evolution.decompose()` hands us one gate per flow set, so every hopping term
...         # here shares a single Pauli shape and one Clifford diagonalizes all of them
...         shapes = tuple({label for label, _, _ in terms} - {"", "Z", "ZZ"})
...         match shapes:
...             case ("XXZ",):
...                 clifford_function, lines = east_clifford, self.rows_of_lattice()
...                 along_rows = True
...             case ("YYZ",):
...                 clifford_function, lines = west_clifford, self.rows_of_lattice()
...                 along_rows = True
...             case ("XYXY",):
...                 clifford_function, lines = south_clifford, self.columns_of_lattice()
...                 along_rows = False
...             case ("YXXY",):
...                 clifford_function, lines = north_clifford, self.columns_of_lattice()
...                 along_rows = False
...             case ():  # the diagonal group: no conjugation needed
...                 self.diagonal(circuit, terms)
...                 return circuit
...             case _:
...                 raise ValueError(f"expected one known flow set per gate, got {shapes}")
...
...         # a term's line is the row it sits in and its slot the column, or vice versa
...         rotations: dict[int, list] = defaultdict(list)
...         for _, indices, angle in terms:
...             row, col = divmod(indices[0], self.cols)
...             line, slot = (row, col) if along_rows else (col, row)
...             rotations[line].append((slot, angle))
...
...         active = sorted(rotations)
...         # the lines of one flow set are vertex-disjoint, so all of their Cliffords
...         # are emitted together and share the same two two-qubit layers
...         conjugation = QuantumCircuit(num_qubits)
...         for line in active:
...             clifford_function(conjugation, lines[line], ancilla)
...         circuit.compose(conjugation, inplace=True)
...         for line in active:
...             supports = clifford_supports(
...                 Clifford(conjugation), shapes[0], lines[line], ancilla, num_qubits
...             )
...             for slot, angle in rotations[line]:
...                 match supports[slot]:
...                     case qubit, "X":
...                         circuit.rx(angle, qubit)
...                     case qubit, "Y":
...                         circuit.ry(angle, qubit)
...                     case qubit, "Z":
...                         circuit.rz(angle, qubit)
...         circuit.compose(conjugation.inverse(), inplace=True)
...         return circuit
...
...     def diagonal(self, circuit, terms):
...         """Synthesize the diagonal group: a phase, single-qubit Z and paired Rzz."""
...         rzz = {}
...         for label, indices, angle in terms:
...             match label, indices:
...                 case "", _:  # the identity contributes only a global phase
...                     circuit.global_phase -= angle / 2
...                 case "Z", [qubit]:  # a lone vertex operator
...                     circuit.rz(angle, qubit)
...                 case "ZZ", [j, k]:  # interaction, see rzz_layers above
...                     rzz[min(j, k), max(j, k)] = angle
...                 case _:
...                     raise ValueError(f"unexpected Pauli term: {label} on {indices}")
...         rzz_layers(circuit, rzz, self.cols)
1次元と同様に、これはこのエンコーディング専用に意図して書かれています。4つのパウリの形を認識し、それ以外には暗黙にフォールバックせず例外を送出します。また上で述べたゲート1つにつきフロー集合1つの分割も前提としており、そのことを明示します。1つのゲートに複数のホッピングの形があるなら、グループ化が適用されなかったということで、これは回避すべきものではなくエラーです。
1次元版と同様に、この合成はトロッターのステップ数を取りません。トロッターのステップは、フロー集合の間を巡る必要がありますが、以下の transpile_trotter_step はフェルミオン回路を集合ごとに1つの Evolution ゲートに分解します。そのためこのメソッドは一度に1つの集合しか見ず、繰り返せるのはその集合の内部だけで、それでは何も変わりません。1つの演算子を繰り返しても、その時間発展を等しい断片に分割するだけだからです。
したがって複数ステップのトロッター化には、分解の前に、1つのゲート内で演算子の groups を尊重する積公式が必要です。FermionicLieTrotter がそれを行い、ステップ10では収束の測定に使います。
名前の似た2つのクラスに注意してください。上でベースラインとして使った Qiskit の LieTrotter は、グループ化がすでに失われているマッピング後のハミルトニアンに作用します。FermionicLieTrotter はそのフェルミオン版で、フロー集合をまだ見ることができるのはこちらです。
7. 結果: 定数深さ
ここまでは、ステップ1で作った単一の 格子で実行してきました。成長する格子にわたって2つの合成経路を比較するには、(演算子、グループ化、エンコーディング、回路、パスマネージャーという) 一連の流れをサイズごとに繰り返す必要があるため、一度ラップしておくと便利です。
>>> def transpile_trotter_step(rows, cols, product_formula, steps=1):
...     """Transpile `steps` Trotter steps on a `rows` x `cols` lattice."""
...     num_sites = rows * cols
...     operator = fermi_hubbard_2d(rows, cols, 1.0, 2.0)
...     operator.groups = flow_set_groups(operator, cols)
...     encoding = partial(vc_encoding, cols=cols)
...
...     circuit = FermionicCircuit(num_sites)
...     circuit.append(
...         Evolution(
...             num_sites,
...             operator,
...             time=total_time,
...             synthesis=FermionicLieTrotter(reps=steps),
...         ),
...         circuit.modes,
...     )
...     circuit = circuit.decompose()  # split into one Evolution per flow set
...
...     pass_manager = flow_set_pass_manager(circuit.register, encoding, product_formula)
...     return pass_manager.run(circuit)
両方の指標をさまざまな格子サイズにわたって集め、格子の辺に対してプロットすると、違いがはっきりします。
>>> sizes = [3, 4, 5, 6, 7, 8]
>>> lie_trotter = [
...     two_qubit_stats(transpile_trotter_step(n, n, LieTrotter())) for n in sizes
... ]
>>> flow = [
...     two_qubit_stats(transpile_trotter_step(n, n, FlowSetSynthesis(n, n))) for n in sizes
... ]
>>>
>>> figure, axes = plt.subplots(1, 2, figsize=(9, 3.5), layout="constrained")
>>> for panel, index, title in zip(axes, (1, 0), ("two-qubit depth", "CX count")):
...     _ = panel.plot(sizes, [stat[index] for stat in lie_trotter], "o-", label="qubit-level")
...     _ = panel.plot(sizes, [stat[index] for stat in flow], "s-", label="flow set")
...     _ = panel.set(xlabel="lattice edge $L$ (an $L \\times L$ lattice)", title=title)
...     _ = panel.legend()
>>> figure
<Figure size ... with 2 Axes>

2量子ビット深さは から (量子ビット数では18から128) まで 24 で一定ですが、同じようにエンコードされたハミルトニアンに適用した LieTrotter は、格子の辺に比例して 47 から 92 まで増加します。どちらの場合も適用すべき項は 個あるため、ゲート数は両方で増えます。フロー集合が取り除くのは、それらのゲートが占める層数の増加です。
予算は、ホッピングの16と相互作用の8に分かれます。
-
4つのフロー集合のそれぞれのコストは の2量子ビット層で、入るときのクリフォードと出るときの逆で、どちらも構成上の深さは2であり、間には単一量子ビット回転しかありません。これで となり、文献 Ref. [1] が引用する値と一致します。そこではホッピング項だけを数えているためです。上のコードで とすると、これを再現できます。
-
対角グループが残りの8を加えます。その
Rzzゲートは4つの層に詰め込まれ、各Rzzは単一量子ビット回転を挟んだ2つのCXゲートに分解されるので、 です。4層は最適です。正方格子では相互作用は最近接にしか届かないため、内部の各サイトは (結合ごとに1つ) 4つのRzzゲートを持ち、一度に1つにしか関与できません。
どちらの和も格子サイズに依存しておらず、これが要点です。
8. 回路を検証する
フロー集合による合成と LieTrotter は、同じエンコード済みハミルトニアンの同じトロッターステップを記述しているので、そのユニタリは大域位相を除いて一致するはずです。ランダムな状態ベクトルを使えば、完全なユニタリを構築するよりはるかに安価に食い違いを検出できます。
どちらの回路も、状態に適用する前に 1量子ビットおよび2量子ビットゲートまで分解します。分解しないままだと、高レベルの Evolution 命令ごとに Statevector が完全な の密な演算子を構築することになります。先に分解すればゲートを1つずつ適用でき、ここでは数百倍高速になります。
>>> import numpy as np
>>> from qiskit.quantum_info import Statevector
>>>
>>> rng = np.random.default_rng(1234)
>>>
>>> def agrees_up_to_one_phase(rows, cols, samples=3):
...     """Compare both syntheses on random states.
...
...     Returns whether they agree up to a phase, and whether it is the *same* phase
...     for every input state.
...     """
...     lie_trotter = transpile_trotter_step(
...         rows, cols, LieTrotter()
...     ).decompose(reps=6)
...     flow = transpile_trotter_step(
...         rows, cols, FlowSetSynthesis(rows, cols)
...     ).decompose(reps=6)
...     dimension = 2**lie_trotter.num_qubits
...     residuals, phases = [], []
...     for _ in range(samples):
...         vector = rng.normal(size=dimension) + 1j * rng.normal(size=dimension)
...         state = Statevector(vector / np.linalg.norm(vector))
...         a = state.evolve(lie_trotter).data
...         b = state.evolve(flow).data
...         overlap = np.vdot(a, b)
...         phases.append(overlap / abs(overlap))
...         residuals.append(np.linalg.norm(b - a * overlap / abs(overlap)))
...     # the SAME global phase must work for every input state
...     spread = max(abs(phase - phases[0]) for phase in phases)
...     return bool(max(residuals) < 1e-9), bool(spread < 1e-9)
>>>
>>> agrees_up_to_one_phase(rows, cols)
(True, True)
この検査では両方の半分が重要です。単一の状態でのユニタリ・モジュラスの重なりは必要条件ですが十分ではなく、状態に依存する位相を誤った合成であれば、やはりそれが表れます。複数のランダムな状態にわたって同じ位相を要求することで、このギャップが埋まります。
9. 安定化部分空間で物理を検証する
これが2次元特有の難しさです。1次元ではエンコーディングは等長写像で、ジョルダン・ウィグナー参照とスペクトルを比較すれば十分でした。VC は等長写像ではありません。 モードに 個の量子ビットを使うので、 次元の空間が 次元の物理空間を含みます。これは2次元の局所エンコーディングに共通の性質で (余剰の量子ビットはプラケットごとに1つの局所可換対称性によって拘束されます [2] [3])、エンコード済みハミルトニアンがフェルミオンのハミルトニアンを忠実に表現するのは、それらの拘束の同時 固有空間上のみであることを意味します。
ジェネレーターは引用ではなくここで構成します。正方形の面ごとに1つで、それぞれはその面を回るエンコード済みの辺演算子のループにすぎません。
このためには辺演算子が自然な対象です。それらの閉ループは粒子数を保存するあらゆるハミルトニアンの対称性ですが、対応する転送演算子のループはそうではありません。両者は各結合の始点サイトにおける頂点演算子の分だけ異なります。
閉ループを1周すると、すべてのサイトがちょうど1つの結合の始点になるので、ループはサイトごとに1つの を集めます。これはプラケットの4つのサイトの局所パリティです。この局所パリティが違いを生みます。ハミルトニアンは粒子をプラケットの境界をまたいでホッピングさせるため、保存するのは大域パリティだけです。したがって、むき出しの転送ループはこれと可換ではなく、(パリティ因子を持つ) 辺のループは可換になります。
エンコーディングは転送演算子上で定義されているので、辺演算子をマッピングするには上の関係が必要です。これは5行のコールバックで、vc_action が map_transfer_vertex_generators() に収まるのとまったく同じように、map_edge_vertex_generators() に収まります。
>>> from qiskit_fermions.mappers import map_edge_vertex_generators
>>> from qiskit_fermions.operators import EdgeVertexOperator
>>>
>>> def vc_edge_action(generator, width, cols):
...     """Map one generalized *edge* operator to its Verstraete-Cirac Pauli."""
...     j, k = generator
...     if j == k:  # a vertex operator is the same object in both algebras
...         return SparseObservable.from_sparse_list([("Z", [j], 1.0)], num_qubits=width)
...     # The library decomposes T_jk = (i/2) V_j E_jk, so E_jk = -2i V_j T_jk. Reuse the
...     # transfer encoding for T_jk rather than repeating its four cases here. Note that
...     # `compose` left-multiplies its argument, so this composes to V_j T_jk; the other
...     # order carries the opposite sign, since a vertex and a transfer operator sharing a
...     # mode anticommute.
...     vertex = SparseObservable.from_sparse_list([("Z", [j], 1.0)], num_qubits=width)
...     return (-2.0j * vc_action(generator, width, cols).compose(vertex)).simplify()
>>>
>>> def vc_edge_encoding(operator, width, cols):
...     """Map an EdgeVertexOperator to a qubit observable, Verstraete-Cirac style."""
...     return map_edge_vertex_generators(
...         operator,
...         partial(vc_edge_action, width=width, cols=cols),
...         identity=lambda: SparseObservable.identity(width),
...         compose=SparseObservable.compose,
...     ).simplify()
>>>
>>> def plaquette_loops(rows, cols):
...     """The directed edge loop around each square face."""
...     at = lambda r, c: r * cols + c
...     return [
...         [(at(r, c), at(r, c + 1)), (at(r, c + 1), at(r + 1, c + 1)),
...          (at(r + 1, c + 1), at(r + 1, c)), (at(r + 1, c), at(r, c))]
...         for r in range(rows - 1)
...         for c in range(cols - 1)
...     ]
>>>
>>> def stabilizers(rows, cols):
...     """One plaquette stabilizer per square face of the lattice."""
...     num_qubits = 2 * rows * cols
...     out = []
...     for loop in plaquette_loops(rows, cols):
...         loop_operator = EdgeVertexOperator.from_dict({tuple(loop): 1.0})
...         encoded_loop = vc_edge_encoding(loop_operator, num_qubits, cols)
...         out.append(encoded_loop / complex(encoded_loop.coeffs[0]))
...     return out
>>>
>>> plaquette_stabilizers = stabilizers(rows, cols)
>>> for stabilizer in plaquette_stabilizers:
...     print(stabilizer.to_sparse_list())
[('ZZYXXY', [1, 4, 9, 10, 12, 13], (1+0j))]
[('ZZYXXY', [2, 5, 10, 11, 13, 14], (1+0j))]
[('ZZYXXY', [4, 7, 12, 13, 15, 16], (1+0j))]
[('ZZYXXY', [5, 8, 13, 14, 16, 17], (1+0j))]
各ジェネレーターの重みは で、そのプラケットの2つの物理量子ビットと4つのアンシラに広がっています。これらは対合的で、エンコード済みハミルトニアンと可換なので、物理部分空間は時間発展によって保たれます。どちらの性質も演算子についての主張なので、 行列を必要とせず、SparseObservable 代数上で記号的に検査します。
>>> encoded = encoding(hamiltonian, num_qubits)
>>> identity = SparseObservable.identity(num_qubits)
>>> for stabilizer in plaquette_stabilizers:
...     square = stabilizer.compose(stabilizer).simplify()
...     print(square == identity, stabilizer.commutes(encoded))
True True
True True
True True
True True
スタビライザーが手元にあれば、比較に基底の対応は不要です。 なので、占有数はどちらの描像でも同じ物理量子ビット上にあるからです。そこで、アンシラを にして物理量子ビット上に直接積状態を書き、それをスタビライザー部分空間に射影し、エンコード済みハミルトニアンで時間発展させ、両側からサイト密度 を読み取ります。
ここでのすべてのステップはベクトルのレベルにとどまります。射影演算子は、展開してかけ合わせるのではなく、 の因子を1つずつ適用し、時間発展には expm_multiply() を使います。これは を一度も形成せずに を計算します。エンコード済みハミルトニアンは疎な 次元の演算子なので、この違いがこの節を軽く保ちます。
>>> from scipy.sparse.linalg import expm_multiply
>>> from qiskit_fermions.mappers.library import transfer_vertex_jordan_wigner
>>>
>>> # an exact evolution time, unrelated to the Trotter step above
>>> evolution_time = 0.6
>>> reference = transfer_vertex_jordan_wigner(hamiltonian, num_sites).simplify()
>>>
>>> def to_sparse_matrix(observable):
...     # SparseObservable carries no dense- or sparse-matrix method, so route through
...     # SparsePauliOp. This is only ever needed for the numerical checks below --
...     # the encoding itself never leaves SparseObservable.
...     return SparsePauliOp.from_sparse_observable(observable).to_matrix(sparse=True)
>>>
>>> def basis_state(occupation, num_qubits):
...     """The computational basis state with `occupation` on the first qubits.
...
...     Qubit `q` carries bit `2**q`, and the ancillas are the *high* qubits `N..2N-1`,
...     so the same integer indexes the same site occupations on either register and
...     leaves every ancilla in |0>.
...     """
...     index = int("".join(str(bit) for bit in reversed(occupation)), 2)
...     state = np.zeros(2**num_qubits, dtype=complex)
...     state[index] = 1.0
...     return state
>>>
>>> def project_onto_codespace(state, stabilizers):
...     """Apply the projector one (1 + S) factor at a time, then renormalize.
...
...     The factors commute, so their product is itself a projector and the order does
...     not matter. Multiplying it out would build a dense 2^2N x 2^2N operator; applied
...     factor by factor this stays a handful of sparse matrix-vector products.
...
...     Each factor is really (1 + S)/2, but every one contributes the same scalar, so the
...     halvings only rescale the result and the final normalization absorbs them.
...     """
...     for stabilizer in stabilizers:
...         state += to_sparse_matrix(stabilizer) @ state
...     return state / np.linalg.norm(state)
>>>
>>> occupation = [1, 0, 1, 0, 1, 0, 0, 1, 0]  # site occupations of the initial state
>>> initial_reference = basis_state(occupation, num_sites)
>>> initial_encoded = project_onto_codespace(
...     basis_state(occupation, num_qubits), plaquette_stabilizers
... )
>>>
>>> evolved_encoded = expm_multiply(
...     -1j * evolution_time * to_sparse_matrix(encoded), initial_encoded
... )
>>> evolved_reference = expm_multiply(
...     -1j * evolution_time * to_sparse_matrix(reference), initial_reference
... )
>>>
>>> def density(state, qubit, width):
...     """Site density <n_j> = (1 - <Z_j>) / 2 of a statevector."""
...     z = to_sparse_matrix(
...         SparseObservable.from_sparse_list([("Z", [qubit], 1.0)], num_qubits=width)
...     )
...     return (1 - (state.conj() @ (z @ state)).real) / 2
>>>
>>> encoded_densities = [density(evolved_encoded, j, num_qubits) for j in range(num_sites)]
>>> reference_densities = [density(evolved_reference, j, num_sites) for j in range(num_sites)]
>>>
>>> for j, density_value in enumerate(encoded_densities):
...     print(f"site {j}: {density_value:.10f}")
site 0: 0.6750993356
site 1: 0.3689791258
site 2: 0.6750993356
site 3: 0.3818130396
site 4: 0.4868585996
site 5: 0.3818130396
site 6: 0.2693544696
site 7: 0.4916285849
site 8: 0.2693544696
>>> np.allclose(encoded_densities, reference_densities, atol=1e-12)
True
これらがエンコードされた密度です。射影後にのみ忠実になるエンコーディングの格子でありながら、ジョルダン・ウィグナー参照と機械精度で一致します。
10. トロッター収束を測定する
ステップ8では2つの合成が互いに一致することを確認しましたが、これは精度ではなく等価性についての主張です。どちらも同じ1回のトロッターステップを記述しているので、どちらも同じトロッター誤差を持ちます。その誤差を測るには厳密な参照が必要で、ステップ9がちょうどそれを作りました。
ステップ数は FermionicLieTrotter から得られます。これは先にベースラインとして使った量子ビットレベルの公式のフェルミオン版です。分解の前にグループ化された演算子全体に適用すると、その繰り返しは、どれか1つの集合の内部ではなく、4つのフロー集合と対角グループの間を巡ります。
>>> initial_state = project_onto_codespace(
...     basis_state(occupation, num_qubits), plaquette_stabilizers
... )
>>> exact = expm_multiply(
...     -1j * total_time * to_sparse_matrix(encoded), initial_state
... )
>>>
>>> def trotter_fidelity(steps):
...     # `steps` goes to the fermionic formula inside transpile_trotter_step, so the
...     # repetition cycles between the flow sets rather than within any one of them
...     circuit = transpile_trotter_step(
...         rows, cols, FlowSetSynthesis(rows, cols), steps=steps
...     )
...     evolved = Statevector(initial_state).evolve(circuit.decompose(reps=6))
...     return abs(np.vdot(evolved.data, exact)) ** 2
>>>
>>> for steps in (1, 2, 4, 8):
...     print(f"{steps} step(s): fidelity {trotter_fidelity(steps):.6f}")
1 step(s): fidelity 0.053820
2 step(s): fidelity 0.704014
4 step(s): fidelity 0.932937
8 step(s): fidelity 0.982687
ステップを短くするにつれて忠実度は1に向かって単調に上昇し、これは積公式が示すべき振る舞いです。ステップを短くすることは2つのつまみの一方にすぎません。FermionicSuzukiTrotter は、フェルミオン空間で Evolution ゲートを合成するで測定しているように、より高い次数で両者をトレードオフします。
でこのハミルトニアンを1ステップだけ進めるのは近似として不十分で (4つのホッピング集合と相互作用は可換でないため)、最初の行は1から大きく離れます。それが要点で、構成を裏付けるのは個々の行ではなく収束です。
スケジュールの各因子はこの格子のすべてのモードにわたるため、因子をその台に絞り込んでも何も変わらず、FlowSetSynthesis が照合する絶対的な量子ビットインデックスは変わりません。演算子のグループがレジスターの一部にしか触れないような場合に書く合成では、その再ラベル付けを考慮する必要があります。
まとめ
-
2次元で変わるのは手順ではなく帳簿管理です。 1次元ガイドのすべての要素は変更なしでそのまま引き継がれます。グループ化には
groups、エンコーディングにはmap_transfer_vertex_generators()、一致しないレジスターにはCustomF2QLayout、それをトランスパイラーに組み込むにはMapperFnEvolutionSynthesisを使います。増えたのは、それぞれの内部の場合分けの数です。 -
互いに素であることが2次元を定数深さにします。 フロー集合は頂点が互いに素な線に分解されるため、そのクリフォードは並列に出力され、格子がどれだけ大きくても2つの2量子ビット層を共有します。4つのフロー集合と対角グループで固定の予算が決まります。ここでは4つのフロー集合に 、対角の相互作用グループに を足したものです。
-
各向きはそれぞれ固有のパウリの形です。 は
XXZをYYZに、XYXYをYXXYに変えるので、4つのフロー集合には4つのクリフォードが必要です。1つのクリフォードが軸の両方の向きを覆うと仮定するのは、2次元のフロー集合の合成を誤る最も簡単な方法です。 -
台は共役から読み取ります。 1次元では、1つの
CZブリックワークが閉じた形で像を与えます。2次元ではそのような公式はなく、列の線ではアンシラが連続していないため、各項がどこに行き着くかを手で導いた推測は壊れやすくなります。共役して結果を調べるコストはCliffordの構築1回分で、間違えようがありません。また、項を別の場所に移す同等に有効なクリフォードでも、そのまま動作し続けます。 -
分類はグループ化に任せましょう。
Evolutionはグループごとに自身を分割するため、合成には一度に1つのフロー集合が渡され、分割を導き直す必要がありません。最初の項から1つのパウリの形を読み取り、対応するクリフォードを選びます。これを仮定し、成り立たないときは例外を送出することで、synthesizeは短く保たれます。 -
ステップ数は分割の上にあります。 ここでの合成はゲートごとに1つのフロー集合を見るので、集合にまたがって時間発展を細分化できません。
FermionicLieTrotterは分解の前にフェルミオン空間でそれを行い、これが収束テストを可能にします。 -
部分空間上で検証します。 モードの 量子ビットのエンコーディングが忠実なのは、スタビライザーがそう言う場所だけです。VC は を保つので、最も安価で確実な検査は、積状態を射影して密度を比較することです。インタートウィナーもスペクトルの照合も不要で、制限されたハミルトニアンが縮退しているとスペクトルの照合は信頼できません。
エンコード済みハミルトニアンはスタビライザーと可換なので、射影は初期状態にだけ適用すればよく、時間発展が部分空間を自ずと保ちます。実機ではこれが、エンコーディングを誤り検出のリソースとして有用にする点でもあり、スタビライザーを測定できます。
次のステップ
上の内容を拡張する方向が2つあり、どちらも手法ではなく要素の変更です。1つ目はエンコーディングです。ここでヴェルストレート・シラックを選んだのは、文献 Ref. [1] がその対角化クリフォードを閉じた形で与えているためですが、ダービー・クラッセンはサイトごとではなく奇数のプラケットごとに1つのアンシラを使い、量子ビット対モード比は ではなく になります。その転送演算子は異なるパウリの形を持つため、移植とは、ステップ3のエンコーディング関数を書き直し、新しい形ごとにクリフォードを見つけることにあたります。グループ化、レイアウト、合成の足場は変更なしで引き継がれます。
2つ目は格子そのものです。ここでの内容はすべて、開放境界と単一のフェルミオン種を仮定しています。周期境界は各線を閉じた輪にします。矢印は依然としてすべて可換で、それぞれが次と頭尾でつながるためですが、ステップ5の2つのクリフォードの形は端点のある線向けに作られています。 個のサイトの輪には向きごとに 個の結合がありますが、線では 個なので、折り返しの結合は構成の中に居場所がなく、固有の処理が必要です。スピンを持つモデルはより簡単で、レジスターが2倍になり、フロー集合には触れずに対角グループにオンサイトの相互作用項が加わります。どちらも定数深さの議論を乱しませんが、どちらも帳簿管理を変え、最初のまとめにあるように、2次元で大きくなるのはその部分です。
ハードウェアの接続性はここでは扱いません。 上のすべての回路は、任意の量子ビット対が相互作用できる抽象的なレジスター上に構築されており、報告された深さはその設定で数えたものです。実際のデバイスにはカップリングマップの制限があり、このエンコーディングをそれに対応づけることは、それ自体が相当に難しい問題です。VC レジスターは 量子ビットのグラフで、そのゲートはサイトと自身のアンシラの間、隣り合うサイトの間、隣り合うアンシラの間で動くため、レイアウトは3種類の対すべてを同時に隣接させておく必要があります。それができなければ、トランスパイラーは SWAP ゲートを挿入し、それらが追加する層は、定数深さの構成が取り戻していたものです。文献 Ref. [1] も同様に、深さの値を、CX を唯一のネイティブなエンタングラーとする正方形の接続グラフを仮定して引用しています。与えられたデバイスのトポロジー上で局所エンコーディングの良いレイアウトとルーティング戦略を見つけることは、このガイドの範囲を超えています。
A. Gandon, S. Piccinelli, M. Rossmannek, F. Tacchino, A. Baiardi, J. Nys, and I. Tavernelli, Stabilizer-based quantum simulation of fermion dynamics with local qubit encodings (2026), arXiv:2512.11418v2.
F. Verstraete and J. I. Cirac, Mapping local Hamiltonians of fermions to local Hamiltonians of spins, J. Stat. Mech. 2005, P09012 (2005).
Y.-A. Chen and Y. Xu, Equivalence between fermion-to-qubit mappings in two spatial dimensions, PRX Quantum 4, 010326 (2023).