フローセットを用いた1次元フェルミ・ハバード・ダイナミクスのシミュレーション
このガイドで説明する関数は、現在 Python API でのみ利用できます。同等の機能は、将来のリリースで C API にも提供される予定です。
このガイドでは、ハミルトニアンの記述から、時間発展後のサイト密度の確認まで、1次元フェルミ・ハバード模型の時間ダイナミクスの回路を構築します。このルートが興味深いのは、Gandon らのフローセットフレームワーク [1] から得られた、ある1つの考え方によるものです。この研究は、このパッケージの TransferVertexOperator のきっかけにもなりました。
フェルミオンから量子ビットへのマッピングの後にハミルトニアンの項をグルーピングする代わりに、マッピングの前に、フローセットへとグルーピングします。フローセットとは、有向フェルミオン相互作用グラフの1次元部分集合で、その転送演算子が互いに可換なものです。
この選択が、以下のすべてを方向付けます。これには次のものが必要です。
-
フローセットに合わせたカスタムのフェルミオンから量子ビットへのエンコーディング。ここでは補助量子ビットを1つ使用するため、特定のハミルトニアン項の実装に関わる量子ビット数が、(ジョルダン・ウィグナー(JW)の場合のように)フェルミオンモードの数とともに増加しなくなります。
-
各セット内の可換性を利用するカスタム合成。その成果は、2量子ビット深さが系のサイズに対して一定である回路で、JW ベースの項ごとのトロッター化では線形に増加するのとは対照的です。
独自のエンコーディングをトランスパイラーに組み込むための仕組み(CustomF2QLayout と MapperFnEvolutionSynthesis)は、あらゆるモデルに引き継げます。
全体で参照されるトランスパイラーのステージについてはトランスパイレーションのガイドを、カスタムマッパーを作成するための一般的な手順についてはマッパーのガイドを参照してください。
転送演算子とフローセット
TransferVertexOperator は、頂点演算子 と転送演算子 から構築されます。フェルミオンの生成演算子と消滅演算子で表すと、
つまり、 はモード の占有数を測定します(空のとき 、占有されているとき になります)。一方、 は有向辺 に沿ってフェルミオンを転送します。 の2つの添字は互いに入れ替えられないことに注意してください。最初の添字はマイナスの組み合わせを、2番目の添字はプラスの組み合わせを担っており、これにより は と区別され、辺に向きが与えられます。
これらは混合型の交換関係を満たします。互いに素なサイトに作用する2つの転送演算子は、それぞれがフェルミオン演算子の偶数個の積であるため、自明に可換です。興味深いのは、サイトを共有する場合です。その場合、2つの演算子は、矢印がそのサイトを通り抜けて流れるとき(一方が入り、一方が出る)は可換であり、衝突するとき(両方が入る、または両方が出る)は反可換です。
このルールは図で見るのが最も分かりやすくなります。頂点をノード、各 を から への矢印として描くと、有向相互作用グラフが得られます。ここでは、このガイド全体で使用する4サイトの鎖について、すべての結合の両方向の向きを含めて示します。

図でルールをたどってみましょう。たとえば と を見てください。一方の矢印はサイト2に入り、もう一方はそこから出ていくため、フェルミオンはそのまま通り抜けて流れ、2つの演算子は可換です。一方、 と を見てください。どちらの矢印もサイト2に向かっています。これらは衝突し、2つの演算子は反可換です。
これがフローセットを可能にしている仕組みです。有向パスを形成する矢印の集合を選ぶと、すべてのペアは頭と尾でつながるか、まったく接しないかのどちらかになるため、個々の演算子が共有サイトで重なっていても、集合全体が可換になります。したがって、単一のフローセットによる時間発展にはトロッター誤差が生じず、ステップ7で示すように、一定の回路深さで実行することもできます。
1. フェルミ・ハバード・ハミルトニアン
サイト上の1次元フェルミ・ハバード模型(スピンなし、開放境界)は、次のとおりです。
文献 [1] の式(9)に従うと、ホッピング項は です。相互作用は対角的であるため、 を用いて頂点演算子で表現されます。
どちらの部分も、TransferVertexOperator として直接構築されます。 は対角成分 (j, j) として格納されることに注意してください。
>>> from collections import defaultdict
>>> from qiskit_fermions.operators import TransferVertexOperator
>>>
>>> def fermi_hubbard_1d(num_sites, tunneling, interaction):
...     data: defaultdict[tuple[tuple[int, int], ...], complex] = defaultdict(complex)
...     for j in range(num_sites - 1):
...         k = j + 1
...         # hopping: -t (a^dag_j a_k + a^dag_k a_j) = t (T_jk + T_kj)
...         data[((j, k),)] += tunneling
...         data[((k, j),)] += tunneling
...         # interaction: U n_j n_k with n_j = (1 - V_j) / 2
...         data[()] += interaction / 4
...         data[((j, j),)] -= interaction / 4
...         data[((k, k),)] -= interaction / 4
...         data[((j, j), (k, k))] += interaction / 4
...     return TransferVertexOperator.from_dict(data)
>>>
>>> num_sites = 4
>>> hamiltonian = fermi_hubbard_1d(num_sites, tunneling=1.0, interaction=2.0)
>>> print(format(hamiltonian))
  1.500000e0 +0.000000e0j * ()
-5.000000e-1 +0.000000e0j * (V(0))
 5.000000e-1 +0.000000e0j * (V(0) V(1))
  1.000000e0 +0.000000e0j * (T(0,1))
  1.000000e0 +0.000000e0j * (T(1,0))
 -1.000000e0 +0.000000e0j * (V(1))
 5.000000e-1 +0.000000e0j * (V(1) V(2))
  1.000000e0 +0.000000e0j * (T(1,2))
  1.000000e0 +0.000000e0j * (T(2,1))
 -1.000000e0 +0.000000e0j * (V(2))
 5.000000e-1 +0.000000e0j * (V(2) V(3))
  1.000000e0 +0.000000e0j * (T(2,3))
  1.000000e0 +0.000000e0j * (T(3,2))
-5.000000e-1 +0.000000e0j * (V(3))
内部のサイトは2つの結合に現れるため の係数が になりますが、境界のサイトは1つの結合にしか現れません。ここに挙げたすべての項は、上に描いたグラフに現れます。T(j,k) の項はその矢印であり、V(j) の項はそのノードです。
2. フローセットに分割する
次に、各項を、それが属するフローセットでラベル付けします。groups 属性は、この目的のために存在します。グループ化された演算子に対する Evolution ゲートは、グループごとに1つの Evolution に分解されます(ステップ6でこれを活用します)。そのため、ここでフェルミオンレベルで決めたグルーピングは、回路にも引き継がれます。
1次元の鎖では、2つのホッピングフローセットは、東向きの矢印()と西向きの矢印()です。対角的な相互作用項は、あらゆる対角項と可換であり、3つ目のグループを形成します。
>>> def flow_set_groups(operator):
...     groups = []
...     for terms, _ in operator.iter_terms():
...         match terms:
...             case [(left, right)] if right == left + 1:
...                 groups.append(0)  # east-oriented: T_{j,j+1}
...             case [(left, right)] if right == left - 1:
...                 groups.append(1)  # west-oriented: T_{j+1,j}
...             case _:
...                 groups.append(2)  # diagonal interaction terms
...     return groups
>>>
>>> hamiltonian.groups = flow_set_groups(hamiltonian)
>>> hamiltonian.num_groups()
3
>>> for index, group in enumerate(hamiltonian.split_out_groups()):
...     print(index, sorted(terms for terms, _ in group.iter_terms()))
0 [[(0, 1)], [(1, 2)], [(2, 3)]]
1 [[(1, 0)], [(2, 1)], [(3, 2)]]
2 [[], [(0, 0)], [(0, 0), (1, 1)], [(1, 1)], [(1, 1), (2, 2)], [(2, 2)], [(2, 2), (3, 3)], [(3, 3)]]
グループ0と1が2つのフローセットです。各セットは鎖に沿った有向パスであるため、フローの性質により、グループ内のすべての項は可換です。
積公式はグループを別々に指数化し、エルミートな因子だけがユニタリな時間発展を持つため、各グループはそれ自体でエルミートでなければなりません。groups_are_hermitian() がこれを確認します。
>>> from qiskit_fermions.operators.terms.grouping import groups_are_hermitian
>>>
>>> groups_are_hermitian(hamiltonian)
[True, True, True]
ここは立ち止まって考える価値があります。2つのホッピンググループは一方向だからです。グループ0には東向きの項だけが、グループ1には西向きの項だけが含まれています。ハミルトニアンをこのように分割すると、通常はエルミート性が失われます。 には、その共役の相手である が必要だからです。TransferVertexOperator はこの問題を回避します。 は、それ単独ですでにエルミートだからです。これは、素の ではなく、2つのマヨラナ演算子の積です(ステップ1の定義を参照してください)。そのため、ジョルダン・ウィグナー像の係数は、虚数ではなく実数になります。したがって、この演算子表現を選ぶことこそが、一方向のフローセットを正当なトロッター因子にしているのです。
このガイド全体で使用する東/西のラベルは幾何学的なもので、鎖を左から右に描き、モードのインデックスがその方向に増加するものとしています。 は東を、 は西を指します。文献 [1] は、この呼び方について内部的に一貫していません(本文と図が一致しません)。そのため、このガイドでは意図的に本文には従わず、図のラベルを維持しています。論文と照らし合わせて読む際は、方位を表す語ではなく、パウリの重み(以下の1と3)によってフローセットを対応付けてください。
3. カスタムエンコーディングを書く
文献 [1] のセクション IV B では、局所的なフェルミオンから量子ビットへのエンコーディングが、フローセットに制限されたときにとり得る形式を分類しています。通常のジョルダン・ウィグナーは 個の量子ビットを使用し、すべてのホッピング項を重み2のパウリに写像します。この分類は、余分な量子ビットを使うことで、エンコードされた演算子に構造が得られることを示しています。
ここで実装するエンコーディングは、付録 B 2(式 B4 と B5)のパリティ非局在化構成で、補助量子ビットを1つ使用するため、 になります。フェルミオンのパリティは、量子ビットのペアにわたって非局在化されます。
最後の式の添字 が、余分な量子ビットを必要とします。鎖の最後の結合は なので、その は量子ビット 、つまり最後のフェルミオンモード の1つ先に位置します。この末尾の量子ビットが補助量子ビットであり、 が ではなく になる理由です。同じ到達範囲は にも現れ、 のとき、その は補助量子ビット上にあります。
その成果はすぐに確認できます。1つのフローセット全体が、重み1のパウリの和に写像されます。
の前置係数は規格化 によって決まり、2つの向きの間の相対的なマイナス符号は、上のパウリが満たす積の恒等式 によって決まります。どちらかを誤ると、交換関係には従うものの、同じハミルトニアンを表さない演算子になってしまうため、ステップ4で示すように、エンコーディングを数値的に検証する必要があります。
エンコーディングを書くとは、単一の一般化された転送演算子をパウリ列に写像する関数を書くことを意味します。項に対する反復とそれらの合成は、map_transfer_vertex_generators() が処理します。
>>> from qiskit.quantum_info import SparseObservable
>>> from qiskit_fermions.mappers import map_transfer_vertex_generators
>>>
>>> def flow_set_action(action, num_qubits):
...     match action:
...         case (j, k) if j == k:
...             # vertex operator: V_j = Z_j Z_{j+1}
...             return SparseObservable.from_sparse_list(
...                 [("ZZ", [j, j + 1], 1.0)], num_qubits=num_qubits
...             )
...         case (j, k) if k == j + 1:
...             # east-oriented transfer operator: weight 1
...             return SparseObservable.from_sparse_list(
...                 [("X", [k], -0.5)], num_qubits=num_qubits
...             )
...         case (j, k) if k == j - 1:
...             # west-oriented transfer operator: weight 3
...             return SparseObservable.from_sparse_list(
...                 [("ZXZ", [k, k + 1, k + 2], 0.5)], num_qubits=num_qubits
...             )
...         case _:
...             raise ValueError(f"not a nearest-neighbor transfer operator: {action}")
>>>
>>> def flow_set_encoding(operator, num_qubits):
...     return map_transfer_vertex_generators(
...         operator,
...         lambda action: flow_set_action(action, num_qubits),
...         identity=lambda: SparseObservable.identity(num_qubits),
...         compose=SparseObservable.compose,
...     ).simplify()
MapperFnEvolutionSynthesis.mapper_fn はシグネチャ (operator, num_qubits) を想定しており、戻り値の型は SparseObservable でなければなりません。これにより、この関数をトランスパイラープラグインとして直接使用できます。ステップ6を参照してください。
これをステップ1のハミルトニアンに適用すると、 個の量子ビット上のエンコードされた演算子が得られます。
>>> num_qubits = num_sites + 1
>>> encoded = flow_set_encoding(hamiltonian, num_qubits)
>>> for label, indices, coeff in sorted(encoded.to_sparse_list()):
...     print(f"{label:3s} {str(indices):12s} {coeff.real:+.2f}")
    []           +1.50
X   [1]          -0.50
X   [2]          -0.50
X   [3]          -0.50
ZXZ [0, 1, 2]    +0.50
ZXZ [1, 2, 3]    +0.50
ZXZ [2, 3, 4]    +0.50
ZZ  [0, 1]       -0.50
ZZ  [0, 2]       +0.50
ZZ  [1, 2]       -1.00
ZZ  [1, 3]       +0.50
ZZ  [2, 3]       -1.00
ZZ  [2, 4]       +0.50
ZZ  [3, 4]       -0.50
項は14個あり、3つの形に分かれます。ホッピングは X と ZXZ に、相互作用は ZZ になり、先頭の [] は恒等演算子で、全体の位相にのみ寄与します。ZZ 項は最近接および次近接の隣接に及ぶことに注意してください。 は量子ビット から にわたりますが、これがパリティを非局在化するコストです。
フローセットごとにグルーピングすると、この構成がもたらす非対称性が明らかになります。各グループに存在するパウリの重みを一覧にしてみましょう。
>>> for index, group in enumerate(hamiltonian.split_out_groups()):
...     weights = {len(indices) for _, indices, _ in flow_set_encoding(group, num_qubits).to_sparse_list()}
...     print(index, sorted(weights))
0 [1]
1 [3]
2 [0, 2]
東向きのフローセット(グループ0)は、すべて重み1のパウリで構成されています。したがって、その時間発展は1量子ビット回転の層となり、エンタングルゲートを必要としません。一方、ジョルダン・ウィグナーでは、すべてのホッピング項が重み2であり、エンタングルゲートが必要です。これは、文献 [1] の空間と時間のトレードオフを最も単純な形で表したものです。余分な量子ビットを1つ使うだけで、ホッピングハミルトニアンの半分が1量子ビット回転に変換されます。
西向きのフローセット(グループ1)は、その代償を重み3で支払い、相互作用(グループ2)は重み2にあります。重み0の項は恒等演算子です。これらはまだ回路に関する主張ではありません。合成がこれらの重みから何を生み出すかは、ステップ6と7のテーマです。
4. エンコーディングを検証する
カスタムエンコーディングは、忠実であって初めて役に立ちます。手書きのものは確認する必要があります。このエンコーディングは 個の量子ビットを使用するため、量子ビットのヒルベルト空間はフェルミオンのものの2倍の大きさになり、エンコードされたハミルトニアンはジョルダン・ウィグナーのものと項ごとに等しくなることはありません。両者は代わりに等長写像で結び付けられます。
等長写像の由来: ジョルダン・ウィグナーでは、基底状態は占有数の列であり、量子ビット が を保持します。これに対し、このエンコーディングは累積パリティを格納します。次を定義します。
ビット は、サイト までのすべての占有数のパリティを記録します。 個の占有数に対して 個のこのようなビットがあり、ここから補助量子ビットが生じます。占有数は、隣接するビット間の差 として復元されます。そのため、占有されたサイトは、隣接する2つのビットの間のドメインウォールとして現れ、これがドメインウォール(またはクラマース・ワニエ)エンコーディングと呼ばれる理由です。 である理由でもあります。隣接する2つの の積が、その差を読み取るのです。
このマップをいくつかの状態について書き出すと、構造が具体的に見えてきます( が固定されているため、 個のQubit状態のうち像に含まれるのは半分だけであり、したがってユニタリではなくアイソメトリになる点に注意してください)。
>>> def domain_wall_bits(occupations):
...     parity = 0
...     bits = [0]
...     for occupation in occupations:
...         parity ^= occupation
...         bits.append(parity)
...     return bits
>>>
>>> for occupations in ([0, 0, 0, 0], [1, 0, 0, 0], [1, 1, 0, 0], [1, 0, 1, 0]):
...     bits = domain_wall_bits(occupations)
...     # little-endian: reversed() prints qubit 0 on the right, as Qiskit labels do
...     print("".join(map(str, occupations)), "->", "".join(str(b) for b in reversed(bits)))
0000 -> 00000
1000 -> 11110
1100 -> 00010
1010 -> 00110
サイト0上の単一のフェルミオンは、その上にあるすべての累積パリティを反転させます。これが非局所化の働きです。これらの列を行列にまとめると、アイソメトリ が得られ、この符号化が2つのハミルトニアンを*相互に結びつける(intertwine)*とき、その符号化は忠実であるといえます。
つまり、フェルミオン状態をQubit空間に写像してからそこで時間発展させた結果は、先にフェルミオン空間で時間発展させてから写像した結果と一致しなければなりません。
>>> import numpy as np
>>> from qiskit.quantum_info import SparsePauliOp
>>> from qiskit_fermions.mappers.library import transfer_vertex_jordan_wigner
>>>
>>> def to_matrix(observable):
...     # SparseObservable carries no dense-matrix method, so route through
...     # SparsePauliOp. This is only ever needed for the checks below --
...     # the encoding itself never leaves SparseObservable.
...     return SparsePauliOp.from_sparse_observable(observable).to_matrix()
>>>
>>> def domain_wall_isometry(num_sites):
...     isometry = np.zeros((2 ** (num_sites + 1), 2**num_sites), dtype=complex)
...     for index in range(2**num_sites):
...         occupations = [(index >> j) & 1 for j in range(num_sites)]
...         bits = domain_wall_bits(occupations)
...         isometry[sum(b << j for j, b in enumerate(bits)), index] = 1.0
...     return isometry
>>>
>>> isometry = domain_wall_isometry(num_sites)
>>> np.allclose(isometry.conj().T @ isometry, np.eye(2**num_sites))
True
>>>
>>> def intertwines(operator):
...     """Whether both mappings of `operator` agree through the isometry."""
...     flow = to_matrix(flow_set_encoding(operator, num_qubits))
...     reference = to_matrix(transfer_vertex_jordan_wigner(operator, num_sites).simplify())
...     return np.allclose(flow @ isometry, isometry @ reference)
>>>
>>> intertwines(hamiltonian)
True
>>> # and, more strongly, once per flow set: a product formula evolves the groups
>>> # separately, so each one has to be intertwined on its own
>>> all(intertwines(group) for group in hamiltonian.split_out_groups())
True
相互結合関係は、各フローセットごとに個別に、かつ厳密に成り立ちます。この2番目のより強い主張が、後のステップで利用されるものです。積公式はグループを1つずつ時間発展させ、相互結合した因子の積もまた相互結合しているため、これらのグループから構築されるあらゆる近似は、符号化が異なっていても2つの符号化の間で一致します。系として、スペクトルも一致しなければならず、Jordan-Wignerの固有値はすべて、より大きな空間では2回ずつ現れます。これは、制約のない大域パリティの各値に対して1回ずつです。
>>> jw_matrix = to_matrix(transfer_vertex_jordan_wigner(hamiltonian, num_sites).simplify())
>>> flow_matrix = to_matrix(flow_set_encoding(hamiltonian, num_qubits))
>>>
>>> jw_spectrum = np.linalg.eigvalsh(jw_matrix)
>>> flow_spectrum = np.linalg.eigvalsh(flow_matrix)
>>> np.allclose(
...     np.sort(flow_spectrum),
...     np.sort(np.concatenate([jw_spectrum, jw_spectrum])),
... )
True
>>> print(f"{jw_spectrum[0]:.10f}  {flow_spectrum[0]:.10f}")
-1.8557725066  -1.8557725066
5. フェルミオン回路を構築する
Qubitを扱う前に、まずフェルミオンレベルで動力学を表現します。FermionicCircuit はQubitではなくフェルミオンモードに作用し、ハミルトニアンに対する Evolution Gateが回路全体になります。
>>> from qiskit_fermions.circuit import FermionicCircuit
>>> from qiskit_fermions.circuit.library import Evolution
>>> from qiskit_fermions.circuit.library.synthesis import FermionicLieTrotter
>>>
>>> total_time = 1.0
>>> circuit = FermionicCircuit(num_sites)
>>> circuit.append(
...     Evolution(
...         num_sites, hamiltonian, time=total_time, synthesis=FermionicLieTrotter()
...     ),
...     circuit.modes,
... )
>>> circuit.draw("mpl")
<Figure size ... with 1 Axes>

4つのモードすべてにまたがる不透明な1つのボックスがあり、興味深いのはそれが何に分解されるかです。synthesis 引数がその方法を指定します。FermionicLieTrotter は1次の積公式で、演算子を groups によって分割し、各グループを順番に時間発展させます。つまり、ステップ2のフローセットへの分割こそがTrotter化であり、1回の decompose() でそれが実行され、グループの順序(東、西、そして対角方向の相互作用)でフローセットごとに1つの Evolution が得られ、それぞれ3項、3項、8項を含みます。
>>> flow_set_circuit = circuit.decompose()
>>> flow_set_circuit.draw("mpl")
<Figure size ... with 1 Axes>
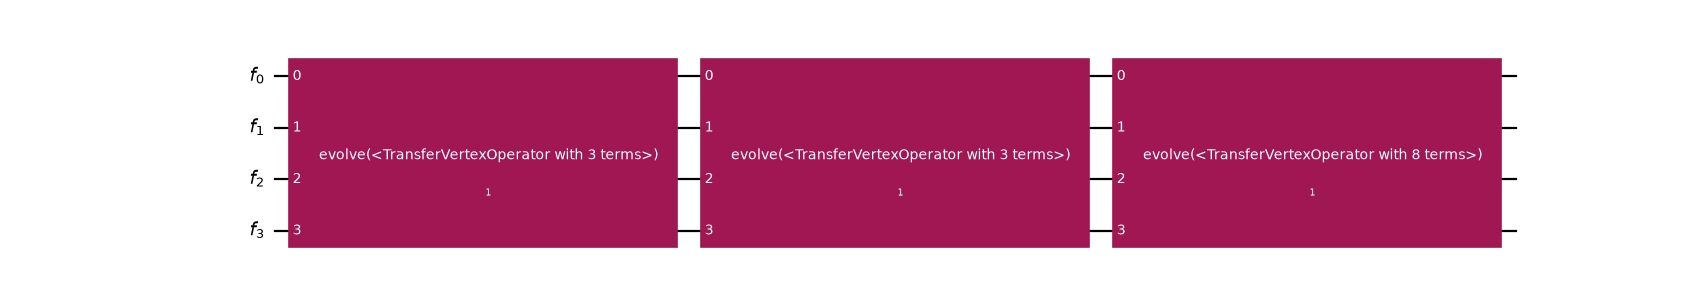
これは完全にフェルミオン空間で行われることに注意してください。Qubitにはまだ一切触れていないのに、近似はすでに行われています。したがってTrotterステップ数もここに属し、それが reps で、時間を分割してスイープ全体を繰り返します。
>>> def trotter_steps(reps):
...     step = FermionicCircuit(num_sites)
...     step.append(
...         Evolution(
...             num_sites,
...             hamiltonian,
...             time=total_time,
...             synthesis=FermionicLieTrotter(reps=reps),
...         ),
...         step.modes,
...     )
...     return step.decompose()
>>>
>>> trotter_steps(3).count_ops()["Evolution"]
9
Gateは9個です。3つのフローセットを、それぞれ時間の3分の1ずつで3回繰り返します。この繰り返しこそが、1つのグループを再分割するのではなくTrotter化たらしめるものです。単一のグループを繰り返しても何も得られません。同じ演算子の連続する指数関数は可換なので、A(t/3) A(t/3) A(t/3) は単に A(t) になるからです。グループを読み取る公式ならそれらを交互に配置できますが、写像の後に適用される公式にはできません。その時点ではグループ分けが失われているためです。
これこそがグループ分けを意味あるものにするステップです。出力された各Gateは独立して写像・合成されるため、下流のすべての処理は、フェルミオンレベルで決定された分割に基づいて行われます。分解を省略すると、演算子全体が次の段階に渡され、グループ分けは無視されます。
6. カスタム符号化でトランスパイルする
これで符号化をTranspilerで使用する準備が整いました。あと2つの要素が必要です。
-
レイアウト。 デフォルトの
TrivialF2QLayoutは1モードにつき1Qubitを前提としていますが、この状況では適切ではありません。CustomF2QLayoutは、フェルミオンレジスタを異なるサイズのQuantumRegisterに対応付けます。これにより補助Qubitがパイプラインに入ります。 -
合成プラグイン。
MapperFnEvolutionSynthesisはマッパー関数を直接受け取り、それを使ってEvolutionGateのハミルトニアンを写像し、 の規約を保ったままPauliEvolutionGateを出力します。そのproduct_formulaが、そのGateを回転にどう変換するかを決定します。これは写像後にQubitへ作用する、2つ目の独立した積公式であることに注意してください。ここではQiskitのLieTrotterが渡され、ステップ7でこれをフローセットを認識するものに置き換えます。
以下の比較はすべてこのパイプラインを再実行するため、一度ラップしておくと便利です。
>>> from qiskit.circuit import QuantumRegister
>>> from qiskit.passmanager import MultiStagePassManager
>>> from qiskit_fermions.transpiler import FermionicCircuitToDAG, QuantumDAGToCircuit
>>> from qiskit_fermions.transpiler.passes import (
...     CustomF2QLayout,
...     F2QSynthesis,
...     MapperFnEvolutionSynthesis,
... )
>>>
>>> def flow_set_pass_manager(mode_register, product_formula=None):
...     '''Build the pipeline mapping `mode_register` with the flow-set encoding.'''
...     synthesis = F2QSynthesis()
...     synthesis.methods["Evolution"] = MapperFnEvolutionSynthesis(
...         flow_set_encoding, product_formula=product_formula
...     )
...     # this encoding spends one ancilla on top of the fermionic modes
...     qubit_register = QuantumRegister(mode_register.size + 1, "q")
...     return MultiStagePassManager(
...         input=FermionicCircuitToDAG(),
...         layout=CustomF2QLayout({mode_register: qubit_register}),
...         synthesis=synthesis,
...         output=QuantumDAGToCircuit(),
...     )
>>>
>>> from qiskit.synthesis import LieTrotter
>>>
>>> pass_manager = flow_set_pass_manager(flow_set_circuit.register, LieTrotter())
>>> qubit_circuit = pass_manager.run(flow_set_circuit)
>>> qubit_circuit.num_qubits
5
4つのフェルミオンモードが5Qubitの回路になり、補助Qubitはカスタムレイアウトによって供給されています。
それでは、得られた回路に実際に何が含まれているかを見てみましょう。繰り返し分解すると、時間発展Gateは最終的に U と CX まで簡約されるため、以下で比較する2つの合成戦略の2Qubitコストを同じ尺度で測定できます。count_ops() は CX の数を報告し、depth() はフィルター関数を受け取って2Qubitの深さを測定します。この reps は分解の深さであり、積公式が行うTrotterステップ数とは無関係であることに注意してください(後でこのガイドに出てくるTrotterステップ数も reps と呼ばれます)。
>>> decomposed = qubit_circuit.decompose(reps=6)
>>> decomposed.count_ops()["cx"]
26
>>> decomposed.depth(lambda instruction: len(instruction.qubits) == 2)
23
CX Gateは26個で23層あり、ほとんど並列実行されていません。回路を描画すると理由がわかります。
>>> decomposed.draw("mpl", fold=-1)
<Figure size ... with 1 Axes>
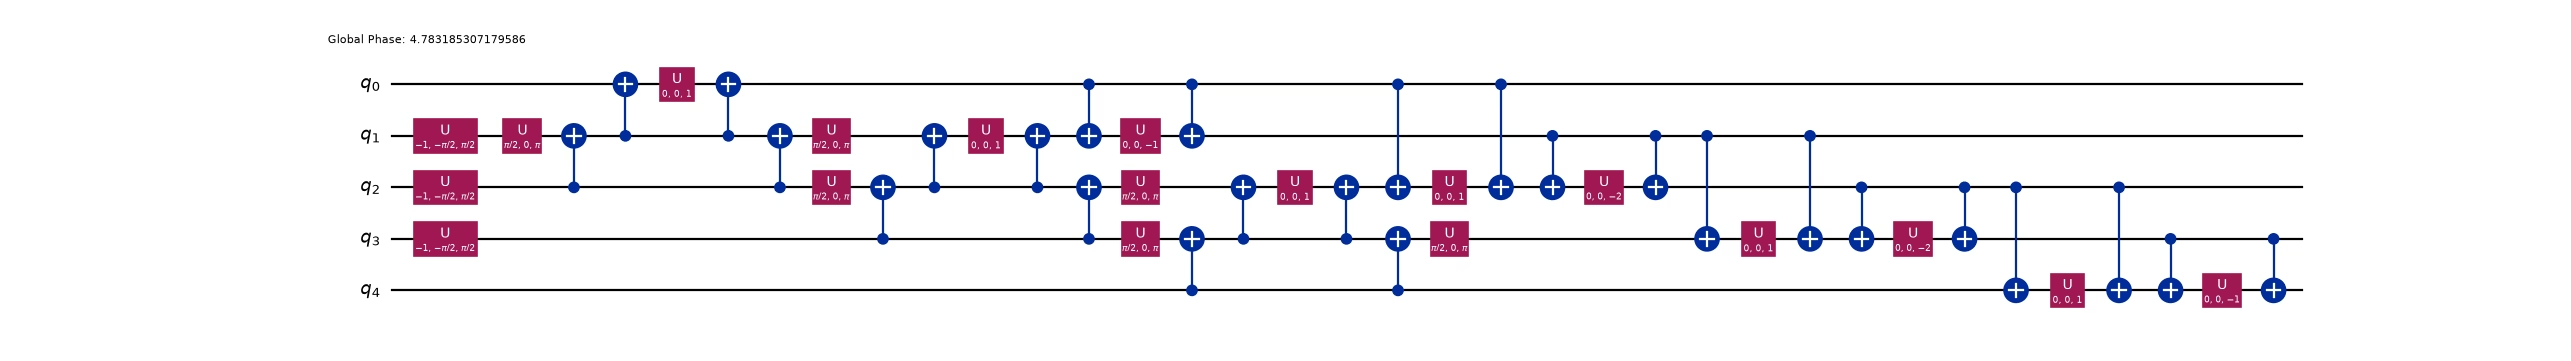
各項は個別にコンパイルされています。基底変換、単一の回転までの CX ラダー、そしてラダーの巻き戻しです。重み1のフローセットはコストがかかりません。その項は周囲にラダーのない単独の回転ですが、重み3の各項は4つの CX Gateを要し、ラダーが順番に出力されるため、何も重なりません。
このようにグループ分けはパイプライン全体を通して保たれていますが(3つのフローセット、3つの写像された PauliEvolutionGate)、それでもほとんど利点がありません。ステップ5のフェルミオンTrotter化は役目を果たしましたが、それを無駄にしているのはQubit側の公式です。LieTrotter は項の集合を受け取りますが、それについて何も知らされておらず、各項を個別にコンパイルします。項が互いに可換であることを知り得ないため、基底変換を共有できるはずのものを直列化してしまいます。
これこそがこの符号化が埋めるために存在するギャップです。2つの積公式が働いていますが、これまでは フェルミオン側だけが構造を与えられてきました。次のステップでは、それを利用するQubit側の合成を提供します。
7. フローセットを認識する合成
この利点を取り戻すには、Qubit側の合成に構造を伝える必要があります。これは文献 [1] のSection IV Cにあたります。フローセットのすべての項は可換なので、単一のClifford回路で同時に対角化でき、項ごとに1回ではなく、1つの共有基底で回転して元に戻せます。
この符号化では、Cliffordは単純です。最近接間の CZ Gateの連鎖で共役をとると、次のように写像されます。
これはすべての について同時に成り立ちます。1つの CZ 連鎖で、重み3(西)のフローセット全体が、独立した単一Qubitの 回転の層に変わります。EvolutionSynthesis インターフェースが要求するのは synthesize() メソッドだけであり、このクラスが実装するのもそれだけです。このクラスはTrotterステップ数を持ちません。一度に1つのフローセットを受け取るため、セット間で時間発展を細分化できないからです。その細分化は1つ上の階層、つまりフェルミオン空間に属し、そこでは F2FSynthesisPlugin がそれらすべてを一度に見ることができます(ステップ9を参照)。
>>> from qiskit.circuit import QuantumCircuit
>>> from qiskit.synthesis.evolution import EvolutionSynthesis
>>>
>>> def cz_brickwork(circuit):
...     # emit even and odd bonds as two layers, so the CZs are scheduled in
...     # parallel: a chain of overlapping CZs has depth 2, not num_qubits - 1
...     #
...     # NOTE: CZ gates are diagonal, so they all commute and each is its own inverse.
...     # This whole layer is therefore self-inverse, which is why the conjugation below
...     # calls it twice rather than calling it and then its inverse.
...     for offset in (0, 1):
...         for j in range(offset, circuit.num_qubits - 1, 2):
...             circuit.cz(j, j + 1)
>>>
>>> # The interaction reaches nearest (distance 1) and next-nearest (distance 2)
>>> # neighbors, so every interior qubit carries four Rzz gates and can only do one at
>>> # a time: four layers is the best any schedule can do. These offsets achieve it.
>>> def rzz_layers(circuit, angles):
...     """Emit the diagonal Rzz gates in four layers of disjoint qubit pairs."""
...     near = [(j, k) for j, k in angles if k - j == 1]
...     far = [(j, k) for j, k in angles if k - j == 2]
...     schedule = [
...         [(j, k) for j, k in near if j % 2 == 0],
...         [(j, k) for j, k in far if j % 4 in (0, 1)],
...         [(j, k) for j, k in near if j % 2 == 1],
...         [(j, k) for j, k in far if j % 4 in (2, 3)],
...     ]
...     # emit layer by layer, since Qiskit's depth follows the order gates were added
...     for layer in schedule:
...         for j, k in layer:
...             circuit.rzz(angles[j, k], j, k)
>>>
>>> class FlowSetSynthesis(EvolutionSynthesis):
...     '''Synthesize one flow set of the encoded Hamiltonian at a time.'''
...
...     preserve_order = True
...
...     def synthesize(self, evolution):
...         circuit = QuantumCircuit(evolution.operator.num_qubits)
...         east, west, diagonal = [], [], {}
...
...         for label, indices, coeff in evolution.operator.to_sparse_list():
...             angle = 2 * evolution.time * coeff.real
...             match label, indices:
...                 case "", _:  # the identity contributes only a global phase
...                     circuit.global_phase -= angle / 2
...                 case "X", [qubit]:  # east flow set: already weight-1
...                     east.append((qubit, angle))
...                 case "ZXZ", [j, k, l] if (k, l) == (j + 1, j + 2):
...                     west.append((k, angle))  # needs the CZ conjugation below
...                 case "ZZ", [j, k]:  # interaction: diagonal, see rzz_layers above
...                     diagonal[min(j, k), max(j, k)] = angle
...                 case _:
...                     raise ValueError(f"unexpected Pauli term: {label} on {indices}")
...
...         # east flow set: bare rotations, no entangling gates at all
...         for qubit, angle in east:
...             circuit.rx(angle, qubit)
...
...         # west flow set: one CZ chain diagonalizes the WHOLE set at once
...         if west:
...             cz_brickwork(circuit)
...             for qubit, angle in west:
...                 circuit.rx(angle, qubit)
...             cz_brickwork(circuit)
...
...         if diagonal:
...             rzz_layers(circuit, diagonal)
...
...         return circuit
見落としやすい細かな点が2つあります。カスタムの EvolutionSynthesis は、高レベル合成パスが読み取る preserve_order 属性を公開しなければなりません。
どちらのヘルパーも、項の順序ではなく明示的な層でGateを出力します。これは depth() が、Gateを追加された順に、できるだけ早くスケジュールするためです。これらのセット内のGateはすべて可換なので、順序は自由に選べます。項ごとの合成は順序の選び方が悪くなります。重なり合う CZ 連鎖を順番に出力すると、ハードウェアが達成できる一定の 2 ではなく、Qubit数に応じて増える深さが報告されます。
上記の合成がTrotterステップ数を持たないのはこのためです。この合成はGateごとに1つのフローセットを受け取るため、その内部での繰り返しはセット間を循環するのではなく、セットの内部で繰り返すことになります。
repeating within one set:      A(t/2) A(t/2) B(t/2) B(t/2)
what a Trotterization needs:   A(t/2) B(t/2) A(t/2) B(t/2)
最初の形式では何も得られません。同じ演算子の連続する指数関数は可換なので、A(t/2) A(t/2) は単に A(t) であり、何ステップを要求しても誤差は1ステップの値のままだからです。
したがってステップ数は、ステップ5のフェルミオン FermionicLieTrotter に属します。これは groups を読み取り、それらを交互に配置できます。この役割分担が要点です。フェルミオンの公式が何ステップかとどの順序かを決め、このクラスが、結果として得られる各セットをどれだけ安価に実現するかを決めます。
順序を選択するには、それを MapperFnEvolutionSynthesis.product_formula に渡します。これは flow_set_pass_manager が受け取る引数です。パイプライン(およびそれが実行されるフェルミオン回路)に関するその他の部分は何も変わりません。
>>> pass_manager = flow_set_pass_manager(flow_set_circuit.register, FlowSetSynthesis())
>>>
>>> flow_circuit = pass_manager.run(flow_set_circuit).decompose(reps=6)
>>> flow_circuit.count_ops()["cx"]
22
>>> flow_circuit.depth(lambda instruction: len(instruction.qubits) == 2)
12
>>> flow_circuit.draw("mpl", fold=-1)
<Figure size ... with 1 Axes>
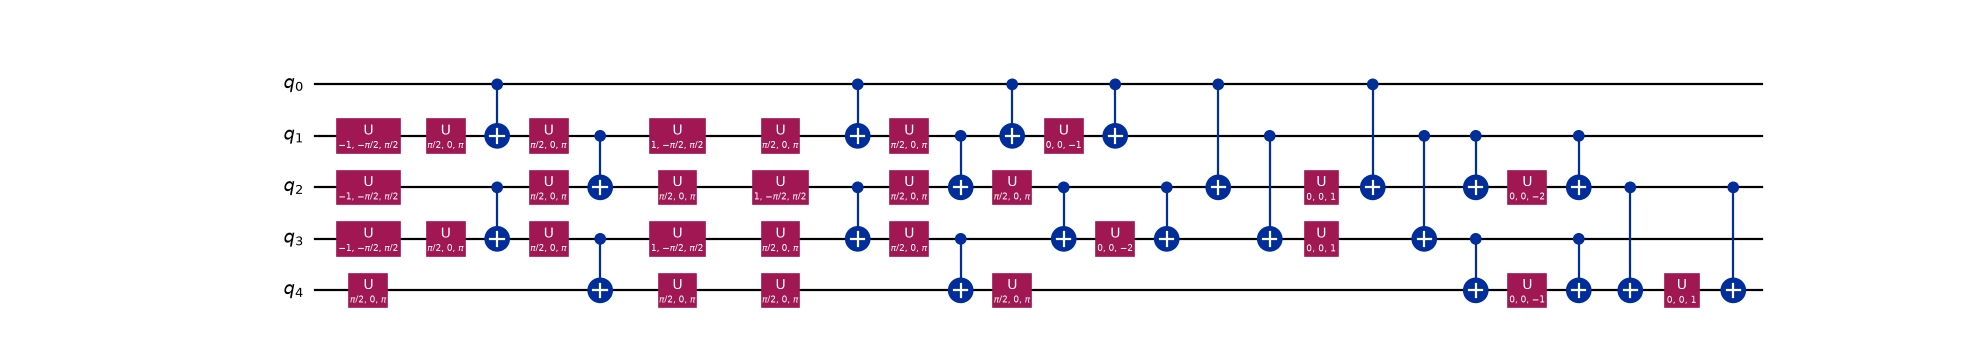
深さ23・CX Gate 26個から、深さ12・CX Gate 22個になりました。これはエンタングルメントGateが少なくなり、深さがほぼ半分になったことを意味する点に注意してください。2つの図を比べると、違いはGateが安価になったことではなく、積み重なるようになったことです。直列のラダーはなくなり、西のフローセット全体が単一の共有基底で回転され、相互作用が互いに素なペアの層として出力されるため、エンタングルメントGateは共有された層の中で上下に並んでいます。
FlowSetSynthesis は絶対的なQubitインデックスをパターンマッチングしますが、これがここで安全なのは、このハミルトニアンのすべてのフローセットがレジスタ全体にまたがっているからにすぎません。フェルミオンの積公式は各因子を実際に触れるモードに絞り込むため、セットが鎖の一部しか覆わないようなグループ分けでは、ラベルが付け替えられて到着し、上記のパターンは一致しなくなります。
どちらの図も decompose(reps=6) の後の回路を示しており、すべてが U と CX の基底に書き換えられているため、FlowSetSynthesis が出力する CZ、Rx、Rzz Gateはそのままの形では見えません。これは意図的なもので、両方の回路を同じ基底に置くことが、上記の2Qubit数と深さを比較可能にする唯一の方法だからです。これらの図で注目すべきは、Gateのラベルではなく層の構造です。
8. 大規模での一定の深さ
興味深い問いは、4モードでの数ではなく、それがどうスケールするかです。2つの CZ ブリックワーク層は鎖の長さに応じて増えないため、1回のTrotterステップの2Qubit深さは一定であるはずです。総当たりでシミュレーションできる範囲をはるかに超えて、完全なFermi-Hubbardハミルトニアンで直接測定すると次のようになります。
>>> def evolution_stats(num_sites, product_formula):
...     operator = fermi_hubbard_1d(num_sites, tunneling=1.0, interaction=2.0)
...     operator.groups = flow_set_groups(operator)
...
...     circuit = FermionicCircuit(num_sites)
...     circuit.append(
...         Evolution(
...             num_sites, operator, time=total_time, synthesis=FermionicLieTrotter()
...         ),
...         circuit.modes,
...     )
...     circuit = circuit.decompose()  # one Evolution per flow set, as in step 5
...
...     pass_manager = flow_set_pass_manager(circuit.register, product_formula)
...     decomposed = pass_manager.run(circuit).decompose(reps=6)
...     two_qubit = lambda instruction: len(instruction.qubits) == 2
...     return decomposed.count_ops()["cx"], decomposed.depth(two_qubit)
>>>
>>> sites = [4, 10, 20, 50, 100]
>>> flow = [evolution_stats(n, FlowSetSynthesis()) for n in sites]
>>> lie_trotter = [evolution_stats(n, LieTrotter()) for n in sites]
>>>
>>> [depth for _, depth in flow]
[12, 12, 12, 12, 12]
>>> [depth for _, depth in lie_trotter]
[23, 47, 87, 207, 407]
2Qubit深さは4モードから100モードまで12のままですが、LieTrotter は線形に増加して407に達します。フローセットによってパイプライン内で少し並列化できますが、各セットは依然として項ごとにTrotter化されるため、増加は遅くなるだけで、なくなりはしません。
>>> import matplotlib.pyplot as plt
>>>
>>> figure, axes = plt.subplots(1, 2, figsize=(9, 3.5), layout="constrained")
>>> for panel, index, title in zip(axes, (1, 0), ("two-qubit depth", "CX count")):
...     _ = panel.plot(sites, [stat[index] for stat in lie_trotter], "o-", label="qubit-level")
...     _ = panel.plot(sites, [stat[index] for stat in flow], "s-", label="flow set")
...     _ = panel.set(xlabel="modes", title=title)
...     _ = panel.legend()
>>> figure
<Figure size ... with 2 Axes>

Gate数はどちらでも線形に増加しますが(適用すべき項が 個あり、それは避けられません)、フローセット合成はそれらを一定数の並列な層で適用します。これが文献 [1] の一定深さの結果です。
深さ12は、どの鎖の長さでも、3つのフローセットに 0 + 4 + 8 と分かれます。東のフローセットの寄与はゼロで、これは単なる Rx 回転です。西のフローセットのコストは4で、入る側の2つの CZ ブリックワーク層と出る側の2つによるものです。相互作用を除くと、どの鎖の長さでも2Qubit深さは4になります。残りの8は相互作用で、その Rzz 項は最近接と次近接の両方の隣接に作用するため4つの互いに素な層が必要であり、各層が CX Gate 2個分のコストを要します。ここでは4が最適です。内部のどのQubitも4つの Rzz Gate(各隣接に2つずつ、各次近接に2つずつ)を持ち、一度に1つにしか参加できないため、これより良いスケジュールはあり得ません。
深さの3分の2は相互作用によるもので、この符号化がホッピング、ひいては自由フェルミオン鎖の動力学に優れていることを示しています。ただし、相互作用はホッピングと可換ではないことに注意してください。それを除くことはFermi-Hubbardの近似ではなく、別のモデルです。与えられた問題でバランスがどこに落ち着くかは、探る価値があります。
9. 動力学を確認する
domain-wallマップのもとでは、占有パターンは累積パリティ文字列になるため、初期状態はJordan-Wignerの場合とは異なる方法で準備されます。これはパリティの非局所化による、見落とされやすい実用上の帰結です。ステップ4のヘルパーが正しいラベルを与えます。
>>> occupations = [1, 0, 1, 0]
>>> initial_label = "".join(str(b) for b in reversed(domain_wall_bits(occupations)))
>>> initial_label
'00110'
状態を準備したところで、2つの問いが残ります。それらは別々に問うのが最善です。フローセット合成は正しいものを計算しているか、そしてそれをより安価に計算しているか、という問いです。
まず正しさです。FlowSetSynthesis とQiskitの LieTrotter は、同じフェルミオンTrotter化から得られた同じ符号化済みフローセットを受け取るため、大域位相を除いて同じユニタリを実現しなければなりません。カスタムCliffordは作業を組み直すだけで、結果は変えません。ランダムな状態ベクトルを使えば、完全なユニタリを構築するよりはるかに安価に、あらゆる不一致を検出できます。
>>> from qiskit.quantum_info import Statevector
>>>
>>> rng = np.random.default_rng(1234)
>>>
>>> def agrees_up_to_one_phase(reps, samples=3):
...     """Compare both qubit-side syntheses of the same fermionic Trotterization."""
...     step = trotter_steps(reps)
...     trotter = flow_set_pass_manager(step.register, LieTrotter()).run(step)
...     flow = flow_set_pass_manager(step.register, FlowSetSynthesis()).run(step)
...     trotter, flow = trotter.decompose(reps=6), flow.decompose(reps=6)
...     dimension = 2**trotter.num_qubits
...     residuals, phases = [], []
...     for _ in range(samples):
...         vector = rng.normal(size=dimension) + 1j * rng.normal(size=dimension)
...         state = Statevector(vector / np.linalg.norm(vector))
...         a = state.evolve(trotter).data
...         b = state.evolve(flow).data
...         overlap = np.vdot(a, b)
...         phases.append(overlap / abs(overlap))
...         residuals.append(np.linalg.norm(b - a * overlap / abs(overlap)))
...     # the SAME global phase must work for every input state
...     spread = max(abs(phase - phases[0]) for phase in phases)
...     return bool(max(residuals) < 1e-9), bool(spread < 1e-9)
>>>
>>> [agrees_up_to_one_phase(reps) for reps in (1, 3)]
[(True, True), (True, True)]
このチェックの両方の側面が重要です。単一の状態での絶対値1の重なりは必要条件ですが十分条件ではありません。状態に依存する位相を誤った合成であっても、それは現れてしまいます。複数のランダムな状態にわたって同じ位相を要求することが、そのギャップを埋めます。複数の reps を確認することも重要です。それにより、一致が単一のスイープだけでなく、フローセットの交互配置を経ても保たれることが確認できるからです。
したがって、Qubit側の合成の選択は精度に影響しないため、コストの比較が意味を持ちます。残る問いは、符号化全体が、明白な代替手段、つまり補助Qubitもカスタム Cliffordも使わない num_sites 個のQubit上の素のJordan-Wignerに対して何をもたらすかです。2つの列では符号化とQubit側の合成の両方が異なりますが、上のチェックで後者は結果に影響しないことが示されたため、忠実度が検証しているのは符号化です。また、どちらのパイプラインも同じフェルミオンTrotter化から始まるため、忠実度に差があればトレードオフではなくバグを示すことになります。2つの列は符号化、つまりフローセットとJordan-Wignerです。
>>> def jordan_wigner_pass_manager(mode_register, product_formula):
...     """The same pipeline under plain Jordan-Wigner: one qubit per mode."""
...     synthesis = F2QSynthesis()
...     synthesis.methods["Evolution"] = MapperFnEvolutionSynthesis(
...         transfer_vertex_jordan_wigner, product_formula=product_formula
...     )
...     qubit_register = QuantumRegister(mode_register.size, "q")
...     return MultiStagePassManager(
...         input=FermionicCircuitToDAG(),
...         layout=CustomF2QLayout({mode_register: qubit_register}),
...         synthesis=synthesis,
...         output=QuantumDAGToCircuit(),
...     )
>>>
>>> from scipy.linalg import expm
>>>
>>> jw_state = np.zeros(2**num_sites, dtype=complex)
>>> jw_state[sum(o << j for j, o in enumerate(occupations))] = 1.0
>>> reference_jw = expm(-1j * total_time * jw_matrix) @ jw_state
>>> reference_flow = expm(-1j * total_time * flow_matrix) @ (isometry @ jw_state)
>>>
>>> def cost_and_fidelity(reps):
...     step = trotter_steps(reps)
...     flow = flow_set_pass_manager(step.register, FlowSetSynthesis()).run(step)
...     jw = jordan_wigner_pass_manager(step.register, LieTrotter()).run(step)
...     flow, jw = flow.decompose(reps=6), jw.decompose(reps=6)
...     two_qubit = lambda instruction: len(instruction.qubits) == 2
...     evolved_flow = Statevector.from_label(initial_label).evolve(flow).data
...     evolved_jw = Statevector(jw_state).evolve(jw).data
...     return (
...         abs(np.vdot(evolved_flow, reference_flow)) ** 2,
...         flow.count_ops()["cx"],
...         flow.depth(two_qubit),
...         abs(np.vdot(evolved_jw, reference_jw)) ** 2,
...         jw.count_ops()["cx"],
...         jw.depth(two_qubit),
...     )
>>>
>>> for reps in (1, 2, 4, 8):
...     flow_f, flow_cx, flow_d, jw_f, jw_cx, jw_d = cost_and_fidelity(reps)
...     print(
...         f"{reps} step(s):  flow set {flow_f:.6f}"
...         f" ({flow_cx:3d} CX, depth {flow_d:3d})"
...         f"   JW {jw_f:.6f} ({jw_cx:3d} CX, depth {jw_d:3d})"
...     )
1 step(s):  flow set 0.590661 ( 22 CX, depth  12)   JW 0.590661 ( 18 CX, depth  14)
2 step(s):  flow set 0.926656 ( 44 CX, depth  24)   JW 0.926656 ( 36 CX, depth  26)
4 step(s):  flow set 0.982053 ( 88 CX, depth  48)   JW 0.982053 ( 72 CX, depth  50)
8 step(s):  flow set 0.995395 (176 CX, depth  96)   JW 0.995395 (144 CX, depth  98)
まず忠実度の列を読んでください。2つの異なるヒルベルト空間で、2つの異なる符号化のもとで、表示されるすべての桁まで同一です。これはフェルミオンTrotter化が表に出ているということです。近似はどちらの符号化も選ばれる前のステップ5で固定されているため、両方の回路はまさに3つのフローセットにわたる1次の公式の誤差を持ち、ステップ数が2倍になるごとにおよそ4分の1に減少します。
符号化が異なるのはコストであり、そのトレードオフは率直に述べる価値があります。フローセットはエンタングルメントGateをより多く使います。1ステップで22個に対して18個です。その理由は補助Qubitではありません。補助Qubit自体には2QubitGateがないからです。理由は、ステップ3が警告したとおり相互作用にあります。パリティを非局所化すると、3つの最近接 ZZ 項が、最近接および次近接にまたがる7つの項になり、それぞれが2つの CX Gateを要します。これがホッピングを安価にするために払う代償です。
また、このサイズでは深さでもわずかに勝るだけです(12対14)。4モードでは漸近的な振る舞いが現れるには小さすぎるためです。重要なのはステップ8で測定したスケーリングです。深さ12は一定である一方、Jordan-Wignerの深さは鎖とともに増加します。14モードではすでに12対34です。
上記の decompose() の呼び出しは、2つの独立した理由から不可欠です。
evolve() と Operator は、PauliEvolutionGate の厳密な定義を使用し、カスタムのQubit側合成を迂回します。分解されていない回路に対して検証すると、意図的に誤った合成であっても完全な忠実度が報告されます。
同じことが1つ上の階層、フェルミオン合成にも当てはまります。分解されない Evolution GateはそのままフェルミオンからQubitへの段階に渡され、Evolution.synthesis を一切参照せずに写像されるため、reps は気づかれないまま何の効果も持たなくなります。ステップ5の trotter_steps はその分解を行います。F2FSynthesis で方法を設定するパイプラインでは、代わりにそのパスから同じ展開が得られます。
最後のクロスチェックとして、符号化された空間で計算されたサイト密度 は、Jordan-Wignerの結果を再現しなければなりません。このチェックは回路ではなく符号化に関するものなので、Trotter近似は入りません。どちらの時間発展も、それぞれのハミルトニアンの行列指数関数によって厳密に計算されます。したがって、不一致があれば、積公式ではなく符号化に原因があることになります。
>>> time = 0.8
>>> state_jw = np.zeros(2**num_sites, dtype=complex)
>>> state_jw[sum(o << j for j, o in enumerate(occupations))] = 1.0
>>> evolved_jw = expm(-1j * time * jw_matrix) @ state_jw
>>> evolved_flow = expm(-1j * time * flow_matrix) @ (isometry @ state_jw)
>>>
>>> for j in range(num_sites):
...     v_flow = to_matrix(
...         SparseObservable.from_sparse_list([("ZZ", [j, j + 1], 1.0)], num_qubits)
...     )
...     v_jw = to_matrix(SparseObservable.from_sparse_list([("Z", [j], 1.0)], num_sites))
...     density_flow = (1 - np.vdot(evolved_flow, v_flow @ evolved_flow).real) / 2
...     density_jw = (1 - np.vdot(evolved_jw, v_jw @ evolved_jw).real) / 2
...     print(f"site {j}:  {density_flow:.10f}  {density_jw:.10f}")
site 0:  0.6507935456  0.6507935456
site 1:  0.5963201678  0.5963201678
site 2:  0.3365016619  0.3365016619
site 3:  0.4163846247  0.4163846247
密度は小数点以下10桁まで一致します。
まとめ
-
写像の前にグループ化する。 フローセットは有向のフェルミオン相互作用グラフ上で定義されるため、問題の構造がまだ利用できるうちにグループ分けが選ばれます。
groups属性がそれを回路に持ち込み、そこで1回のdecompose()によってフローセットごとに1つのEvolutionGateになります。 -
補助Qubitは構造をもたらす。 Qubitを1つ追加することで、フローセット全体が重み1のPauliに変わり、その時間発展にはエンタングルメントGateが不要になります。文献 [1] はこのトレードオフを一般的に観察しています。Qubitとフェルミオンの比率が大きいほど、より浅い時間発展回路が可能になります。
-
カスタム符号化は1つの関数である。 単一の一般化された転送演算子をPauli文字列に写像すれば、
map_transfer_vertex_generators()とMapperFnEvolutionSynthesisが残りを行います。 -
写像とグループ化だけでは十分ではない。 時間発展をフローセットごとに分割しても、深さの線形な増加が遅くなっただけでした。各セットを項ごとに合成すると、その項が可換であるという事実が依然として無駄になっていました。フローセットを認識する
EvolutionSynthesisを与えて初めて、深さが一定になりました。カスタム符号化、グループ化、カスタム合成は互いに補完し合うもので、3つすべてが必要です。 -
2つの積公式、2つの役割。
FermionicLieTrotterは、グループ分けがまだ見えているフェルミオン空間で近似を固定するため、Trotter誤差とステップ数はこれだけで決まります。Qubit側のEvolutionSynthesisは、各セットをどれだけ安価に実現するかだけを決めます。ステップ9で、どちらの選択でも同じユニタリになることが確認されました。この2つを分離することで、精度とコストを独立に調整できます。フェルミオン空間でのEvolution Gateの合成を参照してください。 -
検証する。 可換関係を満たす符号化でも、係数や符号が間違っていれば、異なるハミルトニアンを表している可能性があります。相互結合関係(またはより安価にはスペクトル)を確認すれば、これを見つけられます。
上記の FlowSetSynthesis は、1次元鎖上のこの符号化のために意図的に書かれています。符号化が生成する特定のPauliラベルをパターンマッチングし、それ以外には、汎用の積公式に黙ってフォールバックするのではなく、例外を送出します。一般的な実装には2つの半分があります。演算子の groups からフローセット構造を読み取ることは、時間発展用の F2FSynthesisPlugin がすでに行っていることです。文献 [1] のSection IV Cで説明されているように、スタビライザー群から対角化するCliffordを導出することが、符号化に固有のまま残る半分です。
また、パリティを非局所化すると、相互作用項 は単一Qubitでの対角ではなく重み2になります。これは、より安価なホッピング項に対応するコストです。
次へ:2次元
上記はすべて1次元であり、意図的にそうしています。鎖では、フローセットは2つの矢印の向きにすぎず、符号化に必要な補助Qubitは1つだけです。どちらの単純化も2次元では成り立たず、そこで局所符号化が必要になります。
平面格子では、フローセットは相互作用グラフを通る有向パス(または頂点を共有しない有向パスの和集合)であり、すべての辺を覆う小さなパスの集合を見つけることは、2行の分類ではなく、それ自体が組合せ問題になります。符号化の性格も変わります。鎖全体に対して1つの補助Qubitではなく、格子のサイトまたはセルごとに1つ追加します。Verstraete-Cirac符号化はすべてのフェルミオンサイトをそれぞれ専用の補助Qubitと対にし、Qubit対モード比は になります。一方、Derby-Klassen符号化は奇数のプラケットの中心にそれぞれ1つ置き、比は になります。すると、レジスタのレイアウトは真に2次元的な構造を持ち、射影すべきスタビライザー群はもはや自明ではありません。符号化されたハミルトニアンは部分空間上でのみ忠実であり、状態準備と、ステップ4の検証手順の両方が変わります。
このガイドで構築した部品のうち、引き継がれるのは次のものです。モード数と異なるサイズのレジスタのための CustomF2QLayout、符号化そのものための map_transfer_vertex_generators()、それをTranspilerに組み込むための MapperFnEvolutionSynthesis、そしてフローセット構造を活かすためのカスタム EvolutionSynthesis です。異なるのは符号化とフローセット分解だけです。
2次元フローセットガイドはここから続き、正方格子上のVerstraete-Cirac符号化を扱います。4つのフローセット、それぞれに対する深さ2のClifford、そして検証に必要なスタビライザー射影です。
A. Gandon, S. Piccinelli, M. Rossmannek, F. Tacchino, A. Baiardi, J. Nys, and I. Tavernelli, Stabilizer-based quantum simulation of fermion dynamics with local qubit encodings (2026), arXiv:2512.11418v2.