エンコーディングを選択してBose-Hubbardダイナミクスをシミュレーション
このガイドでは、ハミルトニアンの記述から、時間発展した各サイトの密度を厳密な参照値と照合するところまで、1次元Bose-Hubbardモデルの時間ダイナミクスの回路を構築します。このアプローチが興味深いのは、次の1つの考え方によります。
回路を構築する際に、ボソンから量子ビットへのエンコーディングを選択しないでください。ボソンモード上で回路を構築し、それらのモードをどのように量子ビットにするかはトランスパイラーに任せてください。
ボソンの場合、ほぼ常にエンコーディングを先送りにする必要があります。ボソンモードは任意の数の粒子を保持できるため、そのFock空間は無限次元であり、まず打ち切り(保持する占有レベルの数)を選ぶまでエンコーディングは存在しません。コードでは、打ち切りはモードが保持できる最大占有数max_occupation として指定されます。したがって、レベルを保持するモードではmax_occupation = 2、となります。
このため、打ち切りは物理ではなくエンコーディングのパラメーターとなり、変化させたいパラメーターでもあります。小さすぎると答えが間違い、大きすぎると回路が不必要に幅広くなります。エンコーディングをトランスパイル時まで先送りにすれば、回路、ハミルトニアン、グルーピングを変えることなく、打ち切りを掃引できます。
演算子のデータ構造については演算子ガイド、エンコーディングとカスタムマッパーの作成手順についてはマッパーガイド、全体を通して参照されるトランスパイラーのステージについてはトランスパイルガイドを参照してください。
打ち切りとそのコスト
モードをレベルに打ち切ると、保持される最高レベルで正準交換関係が破れます[1]。そのため、どのエンコーディングも代数の同型写像にはなりません。ボソンのエンコーディングは、状態と、打ち切られた部分空間内で作用する演算子を写像します。以降のすべてにおいて、次の2つの帰結が重要です。
-
は、初期状態だけでなく、ダイナミクスによって到達可能な占有数を上回っていなければなりません。
-
写像は正規順序と可換ではないため、ハミルトニアンを正規順序の形式で定義するかどうかを一度決めて、一貫して従ってください。
マッパーガイドでは、この欠陥を導出し、動作するコードで両方の帰結を示します。
1. ハミルトニアン
結合を持つ格子上のBose-Hubbardモデルは次のとおりです。
ここでです。相互作用はサイト上のボソンのペアを数えるため、サイトが同時に2つの粒子を保持できる必要があります。正規順序ではとなり、以降ではこの形式を使用します。
幾何学的構造はエッジリストにのみ現れるため、チェーンに固有のものは何もありません。
>>> from qiskit_bosons.operators import BosonOperator, ann, cre
>>>
>>> def bose_hubbard(edges, num_sites, tunneling, interaction):
...     """Build the normal-ordered Bose-Hubbard Hamiltonian on an arbitrary lattice."""
...     terms = {}
...     for i, j in edges:
...         terms[(cre(i), ann(j))] = -tunneling
...         terms[(cre(j), ann(i))] = -tunneling
...     for i in range(num_sites):
...         # U/2 * n_i (n_i - 1), already normal-ordered
...         terms[(cre(i), cre(i), ann(i), ann(i))] = 0.5 * interaction
...     return BosonOperator.from_dict(terms)
>>>
>>> num_sites = 4
>>> edges = [(i, i + 1) for i in range(num_sites - 1)]
>>> hamiltonian = bose_hubbard(edges, num_sites, tunneling=1.0, interaction=2.0)
>>> print(f"Number of terms: {len(hamiltonian)}")
Number of terms: 10
まず確認する価値のある2つの性質があります。がユニタリーであるためにはハミルトニアンがエルミートでなければならず、またハミルトニアンはボソンの総数を保存します。
>>> hamiltonian.is_hermitian()
True
>>> hamiltonian.conserves_particle_number()
True
ここで、ボソンに特有の問いです。この演算子は何レベルを必要とするのでしょうか。
>>> hamiltonian.max_occupation()
2
相互作用項は1つのモードに2つの生成演算子を作用させるため、この項が作用するにはモードが2つのボソンを保持できなければなりません。これは最大占有数が2であることを意味し、LevelSpecがmax_occupationとして受け取る数です。占有数を保持するモードはレベルとなるため、max_occupation >= 2はと同じ要件です。
これは下限にすぎません。演算子を1回適用したときのものであり、時間発展で繰り返し適用すると、さらに遠くまで到達する可能性があります。これにより、確実に小さすぎるカットオフは除外され、このモデルと状態に対してカットオフがどれだけ大きくなければならないかは、ステップ6で決定します。mode_occupations()は各モードについて個別に下限を報告します。モードごとのカットオフはこれと比較されます。
2. マッピングの前にグループ化
時間発展はトロッター化され、ハミルトニアンをどう分割するかによって、合成に渡されるものが決まります。2つの考慮事項が同じ方向を指しています。
1つ目は物理的なものです。個々のホッピング項はエルミートではありません。エルミートなのは、ペアだけです。単一の非エルミート項で時間発展させると、その操作はユニタリーではなく、マッピングされた演算子はPauliEvolutionGateが拒否する複素係数を持つことになります。したがって、各結合の2つのホッピング項は一緒に保持する必要があります。
2つ目は効率に関するものです。すべてのオンサイト相互作用項は占有数基底で対角であり、互いに可換であるため、1つのグループにまとめて一緒に合成できます。共通のサイトに触れない結合についても同様です。チェーンでは、1つおきの結合がそのような集合になります。結合0と2は互いに素なモードのペアに作用するため、そのホッピング項は可換であり、1つのグループにまとめることができ、結合1は単独のグループになります。したがって、偶数番目と奇数番目の結合をグループ化すると3つのグループで済み、結合ごとに1グループとすると4つ必要になります。グループが少なければ因子が少なくなり、回路も浅くなります。max_occupation = 2のGray符号では、2量子ビット深さは139に対して95です。どの結合が1つのグループを共有できるかは格子によって決まるため、ここで分割を選択します。
groups属性は、その決定を回路に引き継ぎます。グループ化された演算子に対するEvolutionゲートは、グループごとに1つのサブ時間発展に分解されます。分割は、格子構造がまだ見えているボソンのレベルで選択され、マッピングを通じてそのまま維持されます。グループ化ガイドでは、グループ化が満たすべき確認事項を扱っています。
>>> def group_of(actions, edges):
...     """Assign each term to the even bonds, the odd bonds, or the on-site group."""
...     creations = sorted(mode for action, mode in actions if action)
...     annihilations = sorted(mode for action, mode in actions if not action)
...     if creations == annihilations:
...         return 2  # diagonal: the on-site interaction group
...     bond = tuple(sorted(set(creations) | set(annihilations)))
...     return edges.index(bond) % 2  # bonds 0 and 2 share a group, bond 1 has its own
>>>
>>> hamiltonian.groups = [group_of(actions, edges) for actions, _ in hamiltonian.iter_terms()]
>>> hamiltonian.num_groups()
3
各グループ自体がエルミートでなければならず、先ほどのペアリングがそれを保証します。groups_are_hermitian()は、1回の呼び出しですべてのグループを確認します。
>>> from qiskit_bosons.operators.terms import groups_are_hermitian
>>> groups_are_hermitian(hamiltonian)
[True, True, True]
各グループの内容を確認するには、グループを分離します。
>>> for index, group in enumerate(hamiltonian.split_out_groups()):
...     print(f"group {index}: {len(group)} terms, hermitian={group.is_hermitian()}")
group 0: 4 terms, hermitian=True
group 1: 2 terms, hermitian=True
group 2: 4 terms, hermitian=True
偶数・奇数によるグループ化は1つの選択であり、代替案も簡単に測定できます。すべての結合に独自のグループを与えると4つのグループが必要になり、同じ回路でも2量子ビット深さのコストが大きくなります。深さは、ステップ4で説明するmax_occupation = 2のGray符号で回路を低レベル化した後に数えます。
>>> from qiskit.transpiler import PassManager
>>> from qiskit_bosons.circuit import BosonicCircuit
>>> from qiskit_bosons.circuit.library import Evolution
>>> from qiskit_bosons.mappers import LevelSpec
>>> from qiskit_bosons.transpiler.presets import generate_preset_occupation_pass_manager
>>>
>>> def two_qubit_depth(operator):
...     """The two-qubit depth of one evolution under ``operator``, lowered with the Gray code."""
...     probe = BosonicCircuit(num_sites)
...     probe.append(Evolution(num_sites, operator, time=0.4), probe.modes)
...     pass_manager = generate_preset_occupation_pass_manager(LevelSpec(2, "gray"))
...     pass_manager.qubit = PassManager()
...     lowered = pass_manager.run(probe.decompose())
...     return lowered.decompose(reps=6).depth(lambda instruction: len(instruction.qubits) == 2)
>>>
>>> per_bond = bose_hubbard(edges, num_sites, tunneling=1.0, interaction=2.0)
>>> per_bond.groups = [
...     len(edges) if sorted(m for a, m in actions if a) == sorted(m for a, m in actions if not a)
...     else edges.index(tuple(sorted({m for _, m in actions})))
...     for actions, _ in per_bond.iter_terms()
... ]
>>> per_bond.num_groups(), two_qubit_depth(per_bond)
(4, 139)
>>> hamiltonian.num_groups(), two_qubit_depth(hamiltonian)
(3, 95)
3. ボソン回路
回路に何がないかに注目してください。打ち切りも、エンコーディングも、量子ビット数もありません。回路は4つのボソンモードに作用します。
>>> from qiskit_bosons.circuit import BosonicCircuit
>>> from qiskit_bosons.circuit.library import Evolution, InitializeModes
>>>
>>> total_time = 0.4
>>> occupation = [1, 1, 0, 0]  # one boson on each of the first two sites
>>>
>>> circuit = BosonicCircuit(num_sites)
>>> circuit.append(InitializeModes(occupation), circuit.modes)
>>> circuit.append(Evolution(num_sites, hamiltonian, time=total_time), circuit.modes)
>>> dict(circuit.count_ops())
{'InitializeModes': 1, 'Evolution': 1}

ワイヤーは量子ビットではなく、ボソンモードです。InitializeModesはフラグではなく整数を受け取ることに注意してください。モードは任意の数のボソンを保持できるため、Fock状態は占有数のリストです。
1回のdecompose()で、ステップ2のグループ化がグループごとに1つのゲートに変換されます。
>>> decomposed = circuit.decompose()
>>> dict(decomposed.count_ops())
{'Evolution': 3, 'InitializeModes': 1}
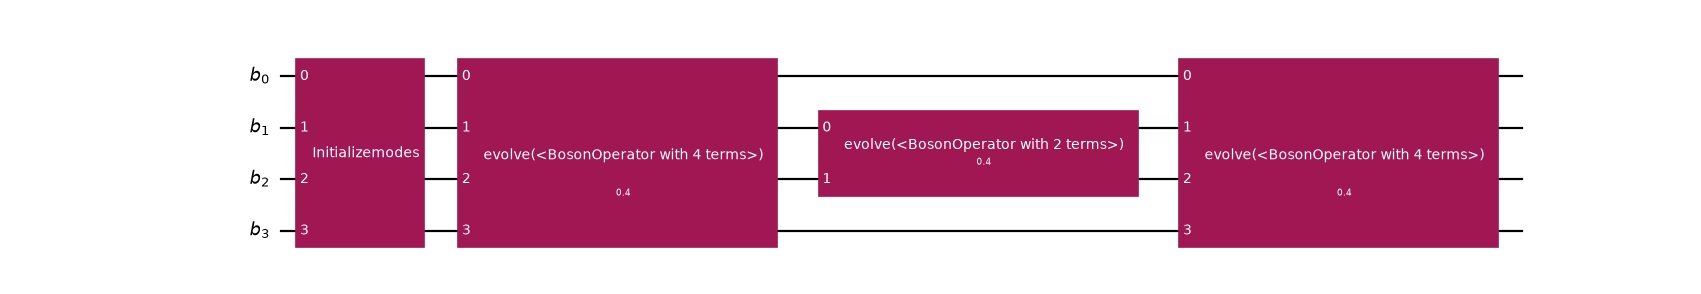
最初のグループにはモード0と1、およびモード2と3の結合が含まれるため、そのゲートは4つのモードすべてにまたがり、オンサイトのグループも同様です。中央の結合には、モード1と2に対する独自のゲートがあります。
この分解を省略すると、グループ化は単に無視されます。分割を行う方法はゲートのsynthesisであり、デフォルトはBosonicLieTrotterです。代替手段についてはボソン空間でのEvolutionゲートの合成を参照してください。
4. トランスパイル時にエンコーディングを選択
ここが利点です。同じ回路を、4つの異なるLevelEncodingの値で、引数を1つ変えるだけで4回低レベル化します。LevelSpecは、エンコーディングをすべてのモードの打ち切りと組み合わせ、以下のプリセットは、その1つの仕様からレイアウト、状態準備、演算子のマッピングを導出します(LevelSpecによる打ち切りの記述を参照)。"gray"のような文字列は、LevelEncodingが受け入れられる場所ならどこでも使用できます。
>>> from qiskit.transpiler import PassManager
>>> from qiskit_bosons.mappers import LevelEncoding, LevelSpec
>>> from qiskit_bosons.transpiler.presets import generate_preset_occupation_pass_manager
>>>
>>> max_occupation = 2  # the largest occupation per mode, so d = max_occupation + 1 = 3 levels
>>>
>>> encodings = (
...     LevelEncoding.UNARY_PROJECTED,
...     LevelEncoding.UNARY_UNPROJECTED,
...     LevelEncoding.STANDARD_BINARY,
...     LevelEncoding.GRAY,
... )
>>> for encoding in encodings:
...     pass_manager = generate_preset_occupation_pass_manager(
...         LevelSpec(max_occupation, encoding)
...     )
...     pass_manager.qubit = PassManager()  # keep the circuit as the pipeline synthesized it
...     qubit_circuit = pass_manager.run(decomposed)
...     basis = qubit_circuit.decompose(reps=6)
...     two_qubit = basis.depth(lambda instruction: len(instruction.qubits) == 2)
...     print(f"{encoding!s:18s} qubits={qubit_circuit.num_qubits:2d}  2q-depth={two_qubit:4d}")
unary_projected    qubits=12  2q-depth= 645
unary_unprojected  qubits=12  2q-depth= 383
standard_binary    qubits= 8  2q-depth= 218
gray               qubits= 8  2q-depth=  95
これらの数値は、自然な推測と矛盾します。ユーナリー(単項)エンコーディングはモードあたり個の量子ビットを使用するのに対し、コンパクトな符号は個で済み、ではコンパクトな符号が両方の面で同時に優れています。つまり、量子ビットが少なく、エンタングルゲートもはるかに少なくなります。2つのユナリー変種は、レイアウトではなく、出力する演算子が異なります。LevelEncoding.UNARY_PROJECTEDはモードの1つおきの量子ビットに射影演算子を持つため、4つの中で時間発展のコストが最も高くなります。LevelEncoding.UNARY_UNPROJECTEDは射影演算子を省略し、one-hot部分空間ではそれと一致します。マッパーガイドでは、2つの演算子を並べて示し、ホッピング項でGray符号が標準2進数(SB)より優れている理由を説明しています。
Sawayaらも同じ順序を報告しています[2]。
ユナリー符号は、より多くの量子ビットを必要とするが演算数は少ない傾向がある一方で、SBまたはGray符号のほうが、量子ビット数と演算数の両方の面で効率的であることが多い
彼らの結論は、最適な符号はハミルトニアンとに依存するというものであり、これは回路内で選択を固定しないことを支持する最も強力な論拠です。
レベルエンコーディングでは、1つのモードが複数の量子ビットにまたがるため、量子ビットレジスターはモードレジスターより幅が広くなります。プリセットはOccupationB2QLayoutを使用し、これはLevelSpecからレジスターの幅を導出します。トランスパイルガイドでは、プリセットが実行するステージを順に説明しています。
5. 厳密なダイナミクスとの照合
これまでのステップのいずれも、回路が正しいことを確立するものではありません。そのためには、時間発展後のサイト密度を、エンコードされたハミルトニアン上で計算した厳密な参照値と比較します。
参照値は回路が動作するのと同じ打ち切り空間で計算する必要があります。打ち切りのない計算と比較すると、別々のものであり分けて考える価値のあるトロッター誤差と打ち切り誤差が混同されてしまうためです(Fock空間の打ち切りを参照)。
>>> import numpy as np
>>> from qiskit.quantum_info import SparsePauliOp, Statevector
>>> from scipy.sparse.linalg import expm_multiply
>>> from qiskit_bosons.mappers.library import occupation_encoding
>>>
>>> def sparse_matrix(operator, encoding):
...     """Map a bosonic operator and hand back a sparse qubit matrix."""
...     spec = LevelSpec(max_occupation, encoding).resolve(num_sites)
...     observable = occupation_encoding(operator, spec)
...     return SparsePauliOp.from_sparse_observable(observable).to_matrix(sparse=True)
>>>
>>> def fock_index(occupation, encoding):
...     """The computational basis index encoding a product Fock state."""
...     spec = LevelSpec(max_occupation, encoding).resolve(num_sites)
...     return sum(
...         encoding.level_to_bits(n) << offset for n, offset in zip(occupation, spec.offsets)
...     )
>>>
>>> def densities(state, encoding):
...     """The per-site boson number <n_m> of an encoded state vector."""
...     out = []
...     for mode in range(num_sites):
...         number = BosonOperator.from_dict({(cre(mode), ann(mode)): 1.0})
...         matrix = sparse_matrix(number, encoding)
...         out.append(float((state.conj() @ (matrix @ state)).real))
...     return out
これらを用意した上で、打ち切り空間での厳密な時間発展を求めます。
>>> encoding = LevelEncoding.GRAY
>>> num_qubits = LevelSpec(max_occupation, encoding).resolve(num_sites).total_width
>>>
>>> initial = np.zeros(2**num_qubits, dtype=complex)
>>> initial[fock_index(occupation, encoding)] = 1.0
>>>
>>> evolved_exact = expm_multiply(
...     -1j * total_time * sparse_matrix(hamiltonian, encoding), initial
... )
>>> reference = densities(evolved_exact, encoding)
>>> for site, value in enumerate(reference):
...     print(f"site {site}: {value:.6f}")
site 0: 0.993834
site 1: 0.858853
site 2: 0.141309
site 3: 0.006004
ボソンは、チェーンの占有されている端から空の端に向かって広がり、2つのボソンは保存されます。
>>> bool(np.isclose(sum(reference), 2.0))
True
次に回路です。先ほどの参照値はinitialから直接構築されているため、それと比較される回路には時間発展のみを含める必要があることに注意してください。InitializeModesゲートは、すでに準備されている状態を再び準備してしまうためです。
>>> from qiskit_bosons.circuit.library.synthesis import BosonicLieTrotter
>>>
>>> def trotter_densities(steps, encoding):
...     """Site densities after `steps` first-order Trotter steps of the grouped evolution."""
...     circuit = BosonicCircuit(num_sites)
...     circuit.append(
...         Evolution(
...             num_sites, hamiltonian, time=total_time, synthesis=BosonicLieTrotter(reps=steps)
...         ),
...         circuit.modes,
...     )
...     pass_manager = generate_preset_occupation_pass_manager(
...         LevelSpec(max_occupation, encoding)
...     )
...     qubit_circuit = pass_manager.run(circuit.decompose())
...     # decompose BEFORE evolving: see the warning that follows
...     basis = qubit_circuit.decompose(reps=6)
...     state = np.asarray(Statevector(initial).evolve(basis).data)
...     return densities(state, encoding)
>>>
>>> for steps in (1, 2, 4, 8, 16):
...     error = max(
...         abs(a - b) for a, b in zip(trotter_densities(steps, encoding), reference)
...     )
...     print(f"steps={steps:2d}  max density error = {error:.4f}")
steps= 1  max density error = 0.0843
steps= 2  max density error = 0.0389
steps= 4  max density error = 0.0183
steps= 8  max density error = 0.0088
steps=16  max density error = 0.0043
ステップ数を2倍にすると誤差は半分になります。これは1次の積公式に特有のの特徴です。これは、不一致がトロッター誤差であり、エンコーディングが忠実であることの証拠です。
繰り返しは、ゲートのsynthesisに由来します。これは、グループ化がまだ存在するボソン空間でトロッター化を行い、各ステップですべてのグループを1回ずつ適用し、ステップが順に続きます。これは、reps > 1のLieTrotterを量子ビットレベルの合成プラグインに渡す場合とは異なります。その場合、各グループはすでにそれぞれ独立したPauliEvolutionGateであるため、公式はグループ内の項を細分化するだけで、グループ同士を交互に配置することはありません。グループは互いに可換ではないため、結果として外側のトロッターステップが1つだけ残り、その誤差はrepsをどれだけ大きくしても小さくなりません。ボソン空間でのEvolutionゲートの合成では、この2つを比較し、より高次の公式も扱っています。
先ほどのdecompose()呼び出しは不可欠です。evolve()はPauliEvolutionGateの厳密な定義を使用し、積公式を完全にバイパスします。分解されていない回路で検証すると、意図的に誤った合成であってもほぼ完全な一致が見られます。また、分解されていない回路では密な演算子の構築が必要になりますが、分解された回路ではゲートを1つずつ適用します。他のシミュレーターではゲートの扱いが異なる場合があるため、この確認はシミュレーターに依存しますが、ハードウェアでは常に分解された形式が必要です。
最後に、中心となる確認です。物理は、どのエンコーディングが選択されたかに依存してはなりません。
>>> def exact_densities(encoding):
...     """Exact truncated-space densities, computed under a given encoding."""
...     width = LevelSpec(max_occupation, encoding).resolve(num_sites).total_width
...     start = np.zeros(2**width, dtype=complex)
...     start[fock_index(occupation, encoding)] = 1.0
...     evolved = expm_multiply(
...         -1j * total_time * sparse_matrix(hamiltonian, encoding), start
...     )
...     return densities(evolved, encoding)
>>>
>>> all(
...     bool(np.allclose(exact_densities(name), reference, atol=1e-10))
...     for name in encodings
... )
True
量子ビット数、パウリ構造、回路の深さはすべて異なりますが、物理量は小数点以下10桁まで一致します。エンコーディングは実装上の選択であり、だからこそトランスパイラーに属するのです。2つのユナリー変種がここで一致するのは、シミュレートされた状態がone-hot部分空間にとどまっているためで、そこから外れると異なる結果になります。
6. 打ち切りは収束パラメーター
最後のステップは、ボソンに特有のものです。ここまではすべてmax_occupation = 2、つまりに固定していました。しかし、打ち切りは自由な選択ではありません。それは収束パラメーターであり、答えは変化しなくなって初めて信頼できます(Fock空間の打ち切りを参照)。
回路には打ち切りが含まれないため、カットオフが変わっても回路自体は変わりません。繰り返されるのはトランスパイルのみです。変わるのは出力されるものの大きさであり、掃引がここまで安価なのは、システムが非常に小さいからにすぎません。以下の参照値は、打ち切られたダイナミクスの厳密な古典シミュレーションです。これは4サイトでは可能ですが、量子ビット数に対して指数関数的に増加します。この範囲を超える問題では、比較対象となる厳密な参照値がなく、収束は他の手段で判断する必要があります。
>>> def densities_at_cutoff(max_occ, encoding=LevelEncoding.GRAY):
...     """Exact truncated-space densities at a given cutoff."""
...     spec = LevelSpec(max_occ, encoding).resolve(num_sites)
...
...     start = np.zeros(2**spec.total_width, dtype=complex)
...     start[
...         sum(encoding.level_to_bits(n) << offset for n, offset in zip(occupation, spec.offsets))
...     ] = 1.0
...
...     def matrix(operator):
...         observable = occupation_encoding(operator, spec)
...         return SparsePauliOp.from_sparse_observable(observable).to_matrix(sparse=True)
...
...     evolved = expm_multiply(-1j * total_time * matrix(hamiltonian), start)
...     out = []
...     for mode in range(num_sites):
...         number = BosonOperator.from_dict({(cre(mode), ann(mode)): 1.0})
...         out.append(float((evolved.conj() @ (matrix(number) @ evolved)).real))
...     return out
>>>
>>> previous = None
>>> for max_occ in (1, 2, 3, 4):
...     current = densities_at_cutoff(max_occ)
...     # Report the drift bucketed rather than to full precision: after it reaches machine
...     # epsilon, the exact digits are arithmetic noise and vary between BLAS builds.
...     if previous is None:
...         drift = "--"
...     else:
...         gap = max(abs(a - b) for a, b in zip(current, previous))
...         drift = f"{gap:.0e}" if gap > 1e-12 else "< 1e-12"
...     print(f"d={max_occ + 1}  "
...           + " ".join(f"{x:.6f}" for x in current)
...           + f"   drift={drift}")
...     previous = current
d=2  0.993986 0.858173 0.141827 0.006014   drift=--
d=3  0.993834 0.858853 0.141309 0.006004   drift=7e-04
d=4  0.993834 0.858853 0.141309 0.006004   drift=< 1e-12
d=5  0.993834 0.858853 0.141309 0.006004   drift=< 1e-12
max_occupation = 1()では、各サイトは最大で1つのボソンしか保持しないため、サイト上に2つ必要な相互作用項はまったく作用せず、密度は約ずれます。3番目のレベルを追加すると、結果は相互作用を捉え、max_occupation = 3以降は結果が機械精度で定常になります。つまり、収束しています。
max_occupation = 2で止まる理由は粒子数にあります。ハミルトニアンはボソンの数を保存し、この状態は2つを保持しているため、時間発展の長さや、相互作用が斥力か引力かにかかわらず、どのサイトも2つを超えて保持することはありません。の代わりにまで時間発展させたり、の符号を反転させたりしても、max_occupation = 2以上での密度はまで変化しません。
必要条件を引き上げるのは、ボソンの数です。同じチェーン上の3つのボソンでは、同じ短い時間発展の後、max_occupation = 2と3の間で約変化し、の後では約変化します。これはこのモデルと保存量についての記述であり、粒子数を保存する演算子に対してのみ成り立つ上限です。一般的な規則ではないため、カットオフは推測ではなく掃引する必要があります。
掃引には、回路側でもコストがかかります。これは厳密な参照値には現れません。同じボソン回路を、各カットオフでGray符号を使って低レベル化した場合を示します。
>>> for max_occ in (1, 2, 3, 4):
...     pass_manager = generate_preset_occupation_pass_manager(
...         LevelSpec(max_occ, LevelEncoding.GRAY)
...     )
...     pass_manager.qubit = PassManager()
...     lowered = pass_manager.run(decomposed)
...     depth = lowered.decompose(reps=6).depth(lambda instruction: len(instruction.qubits) == 2)
...     print(f"d={max_occ + 1}  qubits={lowered.num_qubits:2d}  2q-depth={depth:4d}")
d=2  qubits= 4  2q-depth=   8
d=3  qubits= 8  2q-depth=  95
d=4  qubits= 8  2q-depth= 217
d=5  qubits=12  2q-depth=1176
レベルが1つ増えるごとに深さのコストが増え、が2の冪を超えるたびに量子ビット数が跳ね上がります。したがって、で収束させる際には、精度と回路サイズのトレードオフが生じるため、掃引は単なる数値的な確認以上のものです。
また、がほぼ正しいのは観測量による偶然であることにも注意してください。サイトの密度はほとんど動きませんが、基になる状態は定性的に誤っています(二重占有の成分がありません)。1つの観測量が収束しても、別の観測量が収束したことを示すものではありません。
重要なポイント
-
エンコーディングはトランスパイラーの関心事です。 ステップ3のボソン回路には、トランケーションも、エンコーディングも、量子ビット数も含まれていません。4つのエンコーディングがそれを4つの異なる回路に変換しましたが、いずれも同じ物理を再現しています。トランスパイラーより上流では何も変更する必要がありませんでした。
-
ボソンの場合、これは単に便利というだけではありません。 トランケーションは掃引する必要のある収束パラメーターであり、エンコーディングの内部に存在します。固定されたエンコーディングに対して構築した回路は、 の値ごとに作り直す必要があります。
-
マッピングの前にグループ化し、エルミート性のためにグループ化します。 単一のホッピング項はエルミートではなく、指数化できません。一方、ボンド対はエルミートであるため、指数化できます。格子がまだ見えているボソンのレベルで分割を決めてください。これは物理的に必要なことであり、
groups属性はその決定を先へ引き継ぐために存在します。 -
低重みのエンコーディングが安価だと決めつけないでください。 では、コンパクトなコードが量子ビット数でもゲート数でも両方のユナリー版を上回り、射影版は全体で最もコストが高くなります。測定してください。交差点は に依存します。
-
トランケーションは代数を破りますが、その程度は定量化できます。 破れるのは保持される最上位レベルだけで、その大きさは です。これはマッピングが正規順序付けと可換でない理由でもあります。
次のステップ
この例を拡張する方向は2つあります。チェーンの辺リストを正方格子のボンドに置き換えても、他に変更は不要です。先ほど定義したbose_hubbard関数がすでに幾何に依存しないためです。独自のカスタムエンコーディング(たとえば、ユナリーとコンパクトの中間を補間するブロック・ユナリーコード)も、プリセットが使うのと同じMapperFnEvolutionSynthesisの接続点から組み込めます。
-
演算子表現の設計原則では、ハミルトニアンの背後にある演算子のデータ構造を説明します。
-
演算子表現のマッピングでは、エンコーディングと独自のマッパーの作成方法を扱います。
-
ボソン回路のトランスパイルでは、プリセットが実行する各段階を順に説明します。
-
ボソン空間でのEvolutionゲートの合成では、ボソン空間でトロッター誤差を減らす方法を示します。
報告されているすべての深さは、抽象的な全結合レジスター上のものです。実際のハードウェアの接続性へのマッピングは別の段階であり、占有数エンコーディングのモードごとの量子ビットブロックは、1モードにつき1量子ビットの場合とはかなり異なる構造をルーターに与えます。
[1]
R. Somma, G. Ortiz, E. Knill, and J. Gubernatis, Quantum Simulations of Physics Problems (2003), arXiv:quant-ph/0304063, Sec. 4, Eq. 22.
[2]
N. P. D. Sawaya, T. Menke, T. H. Kyaw, S. Johri, A. Aspuru-Guzik, and G. G. Guerreschi, Resource-efficient digital quantum simulation of d-level systems for photonic, vibrational, and spin-s Hamiltonians, npj Quantum Information 6, 49 (2020), arXiv:1909.12847.