時空間符号を用いた低オーバーヘッドのエラー検出
このチュートリアルでは、クリフォード回路からサンプリングし、qiskit-paulice パッケージを使って回路全体に時空間パウリ・チェックを適用することで、測定された分布の忠実度を高めるワークフローを実装します。時空間パウリ・チェックは、コヒーレント・パウリ・チェック(CPC)と似ており、クリフォードの「ペイロード」回路をいくつかの補助量子ビットとエンタングルさせて、回路内の特定の不変量を「チェック」します。補助量子ビットの測定によりシンドロームが得られ、回路の実行中に論理エラーが検出されたかどうかの判定に使われます。エラーが検出されなかったサンプルだけをポストセレクションすることで、ポストセレクション率が下がる代わりに、サンプリングされた分布の忠実度を向上させることができます。CPC と時空間チェックの主な違いは、CPC のシンドロームの測定には、時間的に局在した重みの大きい演算子の測定が必要になる点です。ヘビーヘックスのように接続性が限られた量子ビット・トポロジーでは、これらのチェックを実装するために多数の SWAP ゲートが必要となり、回路が深くなりすぎて実際には実行できないことがよくあります。パウリ・チェックを時空間符号として実装すると、ペイロード回路全体にチェックを分散させることができ、ハードウェア効率のよい量子ビット符号化が可能になり、回路の実行中の論理エラーの検出に引き続き有効です。qiskit-paulice パッケージの主な役割は、エラー検出の効果を最大化しつつ量子ビットのオーバーヘッドを最小化できる回路内の位置を見つけ、そこに有効な時空間パウリ・チェックを挿入することです。
このチュートリアルでは、時空間チェックを使って、量子回路からサンプリングされた分布の忠実度を高めるワークフローを実装します。クリフォード回路を使用するため、回路のスタビライザーの平均期待値から忠実度を簡単に推定できます。次の手順で進めます。
-
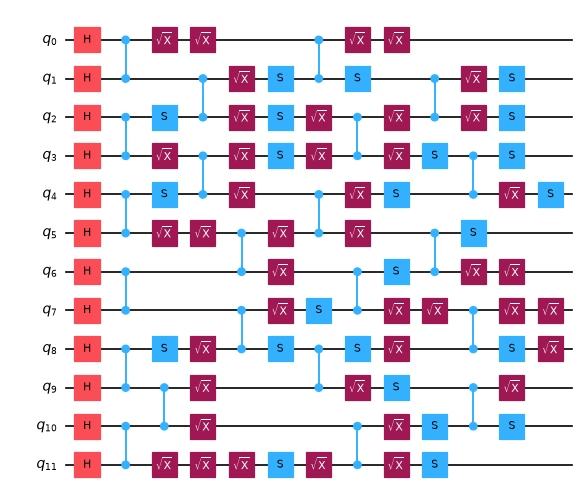
回路を作成する:チェックを可視化するために使用する、浅い1次元ブリックワークのランダム・クリフォード回路。
-
チェックの対象となる量子ビットを特定する:回路を
ibm_bostonHeron QPU の物理量子ビットにマッピングし、隣接する補助量子ビットを持つ量子ビットを特定します。 -
回路をバックエンド向けにトランスパイルする:量子ビットのレイアウトを選択し、回路のゲートを
ibm_bostonのネイティブ・ゲートセットに変換します。 -
バックエンドのデータからノイズモデルを作成する:バックエンドのベンチマーク・データに基づいて、大まかなノイズモデルを生成します。このノイズ・データは、追加する各チェックの有効性を評価するために使用されます。
-
パウリ・チェックを可視化する:浅い回路にいくつかのパウリ・チェックを追加し、チェックがどのように追加されるかを可視化します。
-
測定するスタビライザーを決定する:回路の深さを増やして、ゲート・ノイズの影響を大きくします。より深い回路のスタビライザーの部分集合をランダムにサンプリングします。
-
状態全体に対する良いチェックを見つける:回路が準備する状態のスタビライザーに対するチェックのセットを1つ見つけます。このようなチェックは、その後に何を測定しても有効であるため、同じチェック付き回路がサンプリングされたすべてのスタビライザーに使えます。
-
ノイズのある回路からサンプリングする:samplomatic を使って、サンプリングされた各スタビライザーの基底でチェックなしの回路とチェック付き回路を測定し、チェックの探索に使用したのと同じ脱分極ノイズを使うノイズ付きシミュレーター上で
Executorプリミティブを使ってサンプリングします。 -
エラーが検出されなかったチェック付き回路のサンプルをポストセレクションする:少なくとも1つのチェックに失敗したサンプルを除去します。チェックなしのノイズのある回路と、チェックを含む回路について、期待値を計算します。
-
元のノイズ状態とポストセレクション後のノイズ状態の忠実度を比較する:エラーが検出されなかったサンプルだけをポストセレクションすることで、ノイズ状態の推定忠実度が向上することを示します。
1. 回路を作成する
まず、エンタングリング・ゲートをブリックワーク状の接続で配置した、浅いクリフォード回路を作成します。この小さな回路を使って、回路にチェックがどのように追加されるかを可視化します。
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "qiskit": "qiskit", "qiskit_aer": "qiskit-aer", "qiskit_ibm_runtime": "qiskit-ibm-runtime", "qiskit_paulice": "qiskit-paulice", "samplomatic": "samplomatic"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import numpy as np
from qiskit import QuantumCircuit

def random_clifford_circuit(
    num_qubits: int, depth: int, rng: np.random.Generator
) -> QuantumCircuit:
    """Brickwork random Clifford on `num_qubits`, with `depth` CZ layers."""
    qc = QuantumCircuit(num_qubits)
    qc.h(range(num_qubits))
    for d in range(depth):
        for i in range(d % 2, num_qubits - 1, 2):
            qc.cz(i, i + 1)
        for q in range(num_qubits):
            if rng.integers(0, 2):
                qc.sx(q)
            if rng.integers(0, 2):
                qc.s(q)
            if rng.integers(0, 2):
                qc.sx(q)
    return qc

num_qubits = 12
depth = 4
seed = 1764
rng = np.random.default_rng(seed)
np.random.seed(seed)
circuit = random_clifford_circuit(num_qubits, depth, rng)
circuit.draw("mpl", fold=-1, scale=0.6)
2. チェックの対象となる量子ビットを特定する
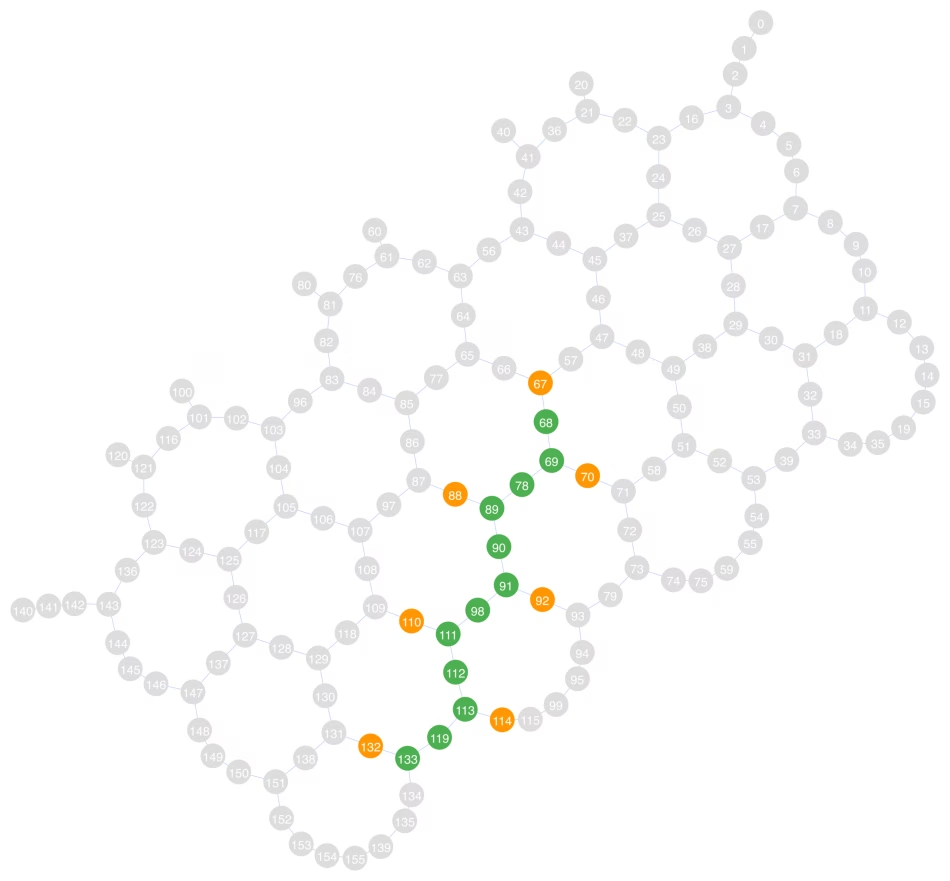
次に、Heron r3 QPU の ibm_boston 上の1次元量子ビット・レイアウトを選択します。結合グラフ上を斜めにジグザグに通り、利用可能な補助量子ビットの数が最大になるレイアウトを選びます。利用可能な補助量子ビットを見つけるには get_check_qubits 関数を使います。この関数は、ターゲット量子ビットと補助量子ビットのペアのリストを返します。target_qubits[i] に対するパウリ・チェックは ancilla_qubits[i] を使って実装されます。
以下の結合グラフでは、緑の量子ビットがペイロード量子ビット、オレンジの量子ビットがチェックの実装に使用する補助量子ビットです。量子ビット 68、69、89、91、111、113、133 には隣接する補助量子ビットがあるため、これらの量子ビット(仮想量子ビット 0、1、3、5、7、9、11 に対応)を、チェックを実装するためのターゲット量子ビットとして使用します。なお、量子ビット 134 はペイロード内で量子ビット 133 に隣接していますが、補助量子ビットとしてはハイライトされていません。これは、133 がすでに(任意に)補助量子ビット 132 とのチェックの実装に選ばれているためです。
from qiskit.visualization import plot_coupling_map
from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit_paulice.layout import get_check_qubits

service = QiskitRuntimeService()
backend = service.backend("ibm_boston")

# Choose a layout and pair each available target qubit with a neighboring ancilla
layout = [68, 69, 78, 89, 90, 91, 98, 111, 112, 113, 119, 133]
target_qubits, ancilla_qubits = get_check_qubits(backend, layout)

print(f"Target qubits:  {target_qubits}")
print(f"Ancilla qubits: {ancilla_qubits}")
plot_coupling_map(
    num_qubits=backend.num_qubits,
    qubit_coordinates=getattr(
        backend.configuration(), "qubit_coordinates", None
    ),
    coupling_map=backend.configuration().coupling_map,
    figsize=(12, 12),
    qubit_color=[
        "#4CAF50"
        if i in set(layout)
        else "#FF9800"
        if i in set(ancilla_qubits)
        else "#DDDDDD"
        for i in backend.coupling_map.graph.node_indices()
    ],
    qubit_size=220,
    line_width=2,
    font_size=90,
)
Target qubits:  [68, 69, 89, 91, 111, 113, 133]
Ancilla qubits: [67, 70, 88, 92, 110, 114, 132]
3. 回路をバックエンド向けにトランスパイルする
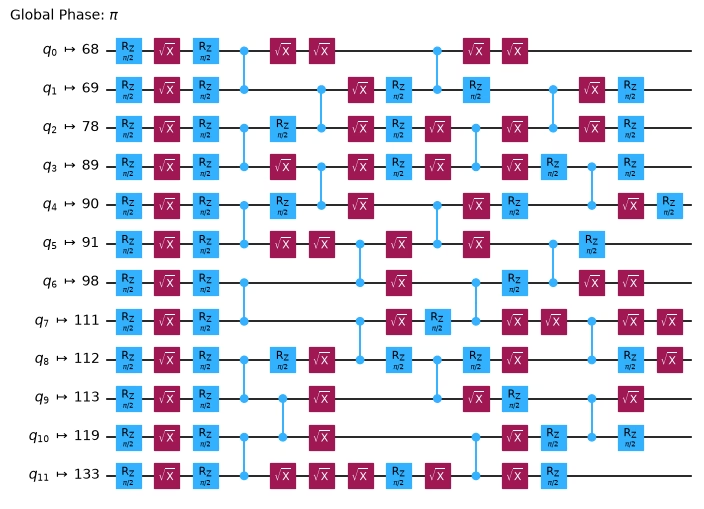
バックエンドはすでに選択されているので、仮想回路を ISA 回路にトランスパイルできます。ここでは、量子ビットのレイアウトを設定し、ゲートを ibm_boston のネイティブ・ゲートセットに変換するだけです。
from qiskit.transpiler import generate_preset_pass_manager

pm = generate_preset_pass_manager(
    optimization_level=0, backend=backend, initial_layout=layout
)
circuit_isa = pm.run(circuit)
circuit_isa.draw("mpl", fold=-1, scale=0.6)
4. バックエンドのデータからノイズモデルを作成する
回路が QPU 上でどのようにレイアウトされるかがわかったので、バックエンドのゲート・ノイズと読み出しノイズが回路の実行にどのように影響するかをモデル化できます。このノイズモデルは、回路内でパウリ・チェックを配置する最適な場所を決めるために使用されます。チェックは、最も多くのエラーを捉えられる位置に配置したいからです。より正確なノイズモデルはチェックの検出能力を向上させますが、通常は QPU をサンプリングしてノイズモデルを学習する必要はありません。ここでは、qiskit-ibm-runtime のバックエンド・ベンチマーク・データだけを使って一様な脱分極ゲート・ノイズモデルを推定し、同時に報告される読み出しエラーは除外します。ステップ7で見つけるチェックは補助量子ビットだけを読み出すため、ペイロードの読み出しエラーはチェックには見えず、ステップ10のポストセレクション後の忠実度を下げるだけだからです。ゲート・ノイズと読み出しノイズの指定の詳細については、qiskit_paulice.NoiseModel のドキュメントを参照してください。学習済みのパウリ・リンドブラッド・ノイズモデルを使用したい場合は、NoiseModel.from_pauli_lindblad_maps を参照してください。
from dataclasses import replace

from qiskit_paulice.noise_models import NoiseModel

# Model the gate noise as a uniform depolarizing channel based on backend benchmark data
noise_model = replace(
    NoiseModel.from_backend(backend, layout, uniform_gate_noise=True),
    readout_noise=None,
)
print(noise_model)
NoiseModel(gate_noise=0.0015808382794757693, readout_noise=None, idling_noise=None)
5. パウリ・チェックを可視化する
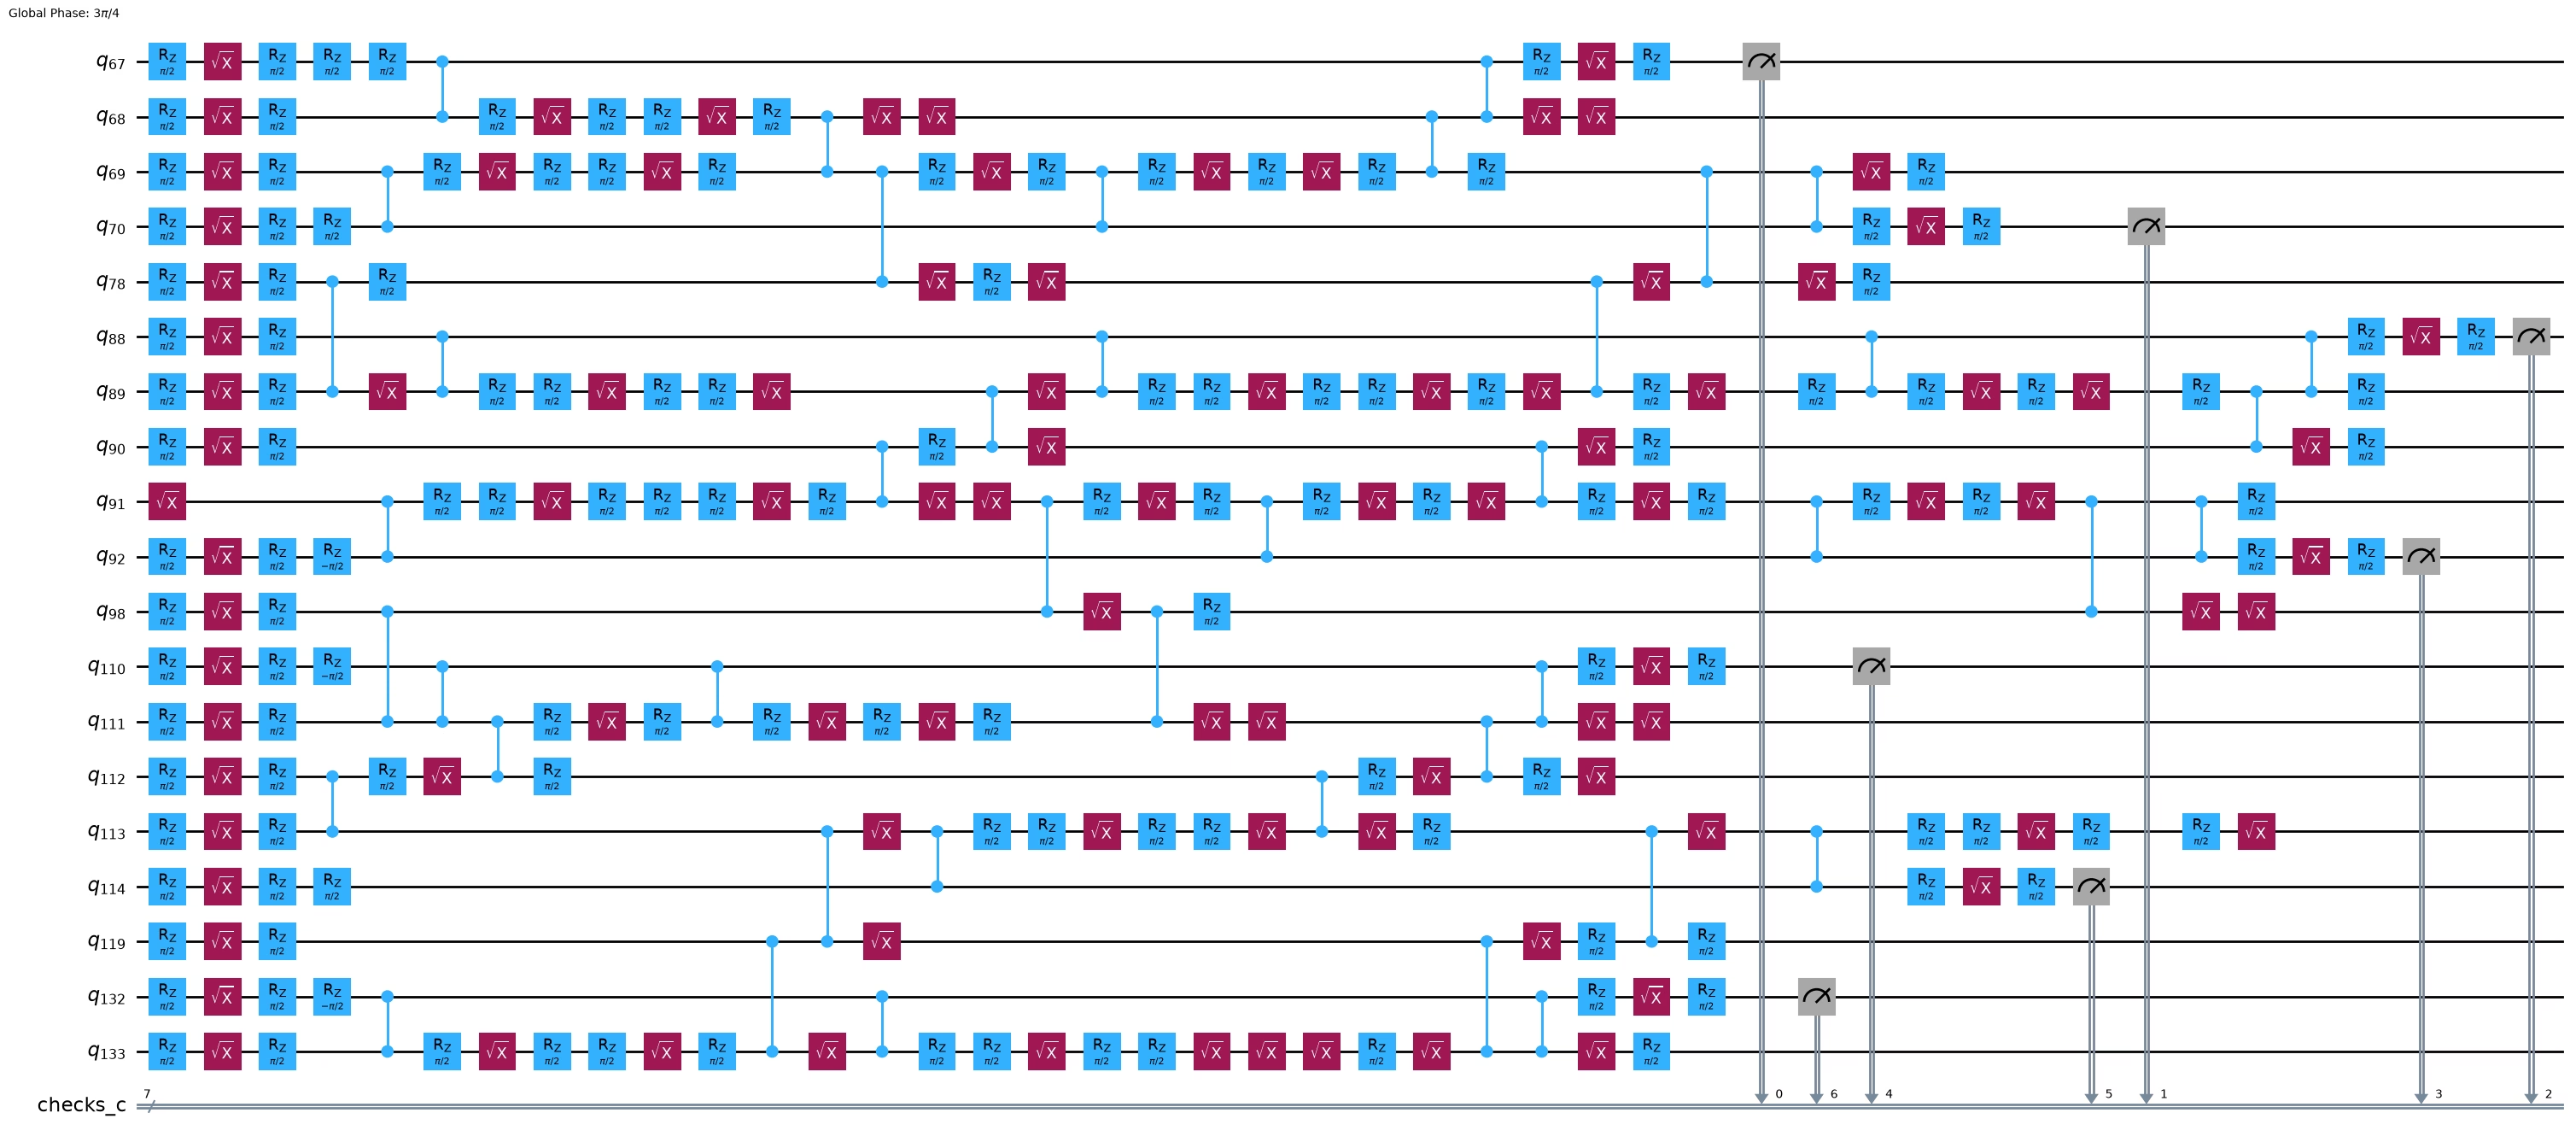
それでは、回路にいくつかのチェックを追加して、どのように見えるか確認しましょう。qiskit_paulice.add_pauli_checks 関数を使って、有効なチェックの良いセットを見つけることができます。入力として、クリフォードのペイロード回路、チェックを追加するペイロード量子ビット(ターゲット量子ビット)のリスト、前のステップで作成したノイズモデルを渡します。この例では、利用可能な補助量子ビットを持つ 7 個すべてのターゲット量子ビットにチェックを追加します。チェックは target_qubits に現れる順序で量子ビットに追加されるため、チェック付き回路の最終的なレイアウトを簡単に把握できます:final_layout = layout + ancilla_qubits。出力された回路のうち、チェックの数がより少ない(i 個の)ものを実行したい場合、最終レイアウトは final_layout = layout + ancilla_qubits[:i+1] になります。
回路の可視化から、指定したターゲット量子ビットと補助量子ビットのペアを使ってチェックが正しく実装されたことがわかります。
qiskit_paulice.add_pauli_checks の詳細:
- 最初の入力はクリフォード回路である必要があります。ここでは測定を含まず、
stabilizers="all"を渡しているため、回路が準備する状態のスタビライザーに対するチェックが見つかります。チェックが有効であるのは、その時空間パウリ積がそのようなスタビライザーを測定し、そのシンドロームが補助量子ビットのビットだけであり、その後にペイロードをどの基底で測定しても有効なままである場合です。サンプリングされた各スタビライザーは異なる基底で測定されるため、これは忠実度の推定に必要です。(stabilizersを省略すると、代わりに回路の終端測定に対するチェックが見つかります。) - 2番目の位置引数はターゲット量子ビットのインデックスのリストです。各ターゲット量子ビットは補助量子ビットとエンタングリング・ゲートを共有してチェックを形成します。チェックは、この引数で指定された順序で見つけられ、回路に追加されます。
- 最後の位置引数は、回路の実行中に影響すると予想されるノイズを表すノイズモデルです。このモデルは、特定のチェックの有効性を評価するために使用されます。
ancilla_qubits:入力回路にレイアウトがある場合、このキーワード引数は、新しく追加される補助量子ビットにどのように物理量子ビットを割り当てるかをadd_pauli_checksに指示します。ancilla_qubitsはtarget_qubits(2番目の位置引数)と同じ長さである必要があり、ancilla_qubits[i]がtarget_qubits[i]のチェックの実装に使用されます。cost:チェックの評価に使用するコスト関数です。gammaまたはLER(論理エラー率)を指定できます。これらはいずれも、ノイズ・チャネルのうちチェックで検出されずに残る割合を表す方法です。stabilizers="all"の場合、エラーが準備された状態を変化させるなら論理エラーとして数えられ、これはまさに忠実度が測るものです。method:有効なチェックを見つけるために使用する手法です。ここではwindowedを使用します。これは、ターゲット量子ビットのサポート(ワイヤー)の多数の空間ウィンドウ部分集合をランダムにサンプリングします。その他の有効な値はgeneticとwindowed_geneticです。add_pauli_checksの出力には、チェックの数が段階的に増える回路が含まれます。チェックなしの回路から、すべてのターゲット量子ビットにチェックを持つ回路までです(有効なチェックが見つかる場合)。
良い時空間パウリ・チェックを見つける方法の詳細については、補足情報のセクション II~IV を参照してください。
import matplotlib.pyplot as plt
from qiskit_paulice import add_pauli_checks

# Find checks on circuit
checked = add_pauli_checks(
    circuit_isa,
    target_qubits,
    noise_model,
    ancilla_qubits=ancilla_qubits,
    cost="gamma",
    method="windowed",
    seed=seed,
    stabilizers="all",
)

print(f"Physical layout of payload+ancillas: {layout + ancilla_qubits}")
print("Checked circuit:")
checked[-1].circuit.draw("mpl", fold=-1, idle_wires=False)
Physical layout of payload+ancillas: [68, 69, 78, 89, 90, 91, 98, 111, 112, 113, 119, 133, 67, 70, 88, 92, 110, 114, 132]
Checked circuit:
6. 測定するスタビライザーを決定する
エラー検出の性能をテストするために、回路が理想的に準備するスタビライザー状態 と、ハードウェアが実際に出力するノイズ状態 との忠実度を推定します。純粋なスタビライザー状態 への射影は、そのスタビライザー群 の 個の要素に対する一様平均として定義されます。
これを忠実度の式に代入すると、ノイズ状態 の忠実度は、 に関するすべてのスタビライザー の期待値の平均と等しいことがわかります。
問題が大きくなると、 個すべてのスタビライザーを測定する(列挙することさえ)のは現実的ではないため、忠実度はスタビライザーのランダムなサンプルを測定して推定されることがよくあります。 から 個のスタビライザー を一様ランダムにサンプリングすると、忠実度 の不偏推定量が得られます。
この実験では、ゲート・ノイズの影響を大きくするために回路をはるかに深くし、隣接する補助量子ビットを持つすべての量子ビットにチェックを追加します。忠実度を推定するためにスタビライザーをサンプリングする、より洗練された方法もありますが、この例では 個のスタビライザーを一様な確率でサンプリングします。
from qiskit.quantum_info import Clifford, Pauli, PauliList

num_stabilizers = 100
num_shots = 1_000
num_checks = len(target_qubits)
depth = 72

circuit = random_clifford_circuit(num_qubits, depth, rng)
# Create all 2^N stabilizers
stabilizers = PauliList([Pauli("I" * num_qubits)])
for generator in (
    Pauli(label) for label in Clifford(circuit).to_labels(mode="S")
):
    stabilizers = stabilizers + stabilizers.compose(generator)

# Choose some random stabilizers from the set
keep = np.where(stabilizers.x.any(axis=1) | stabilizers.z.any(axis=1))[0]
chosen = np.random.default_rng(seed).choice(
    keep, size=min(num_stabilizers, len(keep)), replace=False
)
stabilizers = stabilizers[chosen]
depth = circuit.depth(lambda x: x.operation.num_qubits == 2)
print(
    f"Sampled {len(stabilizers)} stabilizers of {circuit.num_qubits}-qubit circuit with two-qubit depth of {depth}: {{{stabilizers[0]}, {stabilizers[1]}, ...}}"
)
Sampled 100 stabilizers of 12-qubit circuit with two-qubit depth of 72: {-YIIYZZZIZIYY, -XIXYIIZXYIZX, ...}
7. 状態全体に対する良いチェックを見つける
ステップ5とまったく同じように、深い回路に対するチェックのセットを1つ見つけます。チェックは補助量子ビットだけを読み出すため、同じチェック付き回路がサンプリングされたすべてのスタビライザーに使えます。返される回路は、チェックの補助量子ビットだけを測定するので、ペイロードの測定は次のステップで追加します。
import time

# Transpile the deep payload without measurements and find one set of checks for the whole state
payload_isa = pm.run(circuit)
t0 = time.time()
checked = add_pauli_checks(
    payload_isa,
    target_qubits,
    noise_model,
    ancilla_qubits=ancilla_qubits,
    cost="gamma",
    method="windowed",
    seed=seed,
    stabilizers="all",
)
print(
    f"Added {len(checked[-1].check_qubits)} checks in {time.time() - t0:.0f}s."
)
print(
    f"2-qubit depth increased from {payload_isa.depth(lambda x: len(x.qubits) == 2)} to "
    f"{checked[-1].circuit.depth(lambda x: len(x.qubits) == 2)} when adding {num_checks} checks."
)
Added 7 checks in 3s.
2-qubit depth increased from 72 to 85 when adding 7 checks.
8. ノイズのある回路からサンプリングする
サンプリングされた各スタビライザーについて、チェックなしのペイロードから 7 個すべてのチェックを持つ回路まで、すべてのバリアントをサンプリングします。チェックが0個のバリアントは、同じ測定を持つチェックなしのペイロードであるため、ノイズのある基準として機能します。すべてのバリアントのコピーに各スタビライザーの基底回転を追加する代わりに、samplomatic にサンプリング時に測定基底を選択させます。各バリアントについて、次の処理を行います。
-
ペイロードを測定し、samplomatic のボックス化パスマネージャーを使って終端測定を1つのボックスにまとめます。このボックスには
ChangeBasisアノテーションが付いているため、buildは、基底変更ゲートがパラメーター化されたテンプレート回路と、要求された基底に対するパラメーターを計算する samplex を返します。 -
テンプレートと samplex を
QuantumProgramに追加します。samplex は、ボックス内の各量子ビットについて、物理量子ビットの昇順に1つの測定基底を受け取り、、、、 として符号化されます。先頭の軸の長さが100の基底の配列を渡すと、1つのアイテムで100個すべてのスタビライザーを測定できます。ペイロードは各スタビライザーの基底で、補助量子ビットは で測定されます。スタビライザーのサポートの外にある量子ビットも で測定され、そのビットはスタビライザーの期待値を計算する際には無視されます。
qiskit-ibm-runtime の Executor プリミティブは、プログラム全体を1つのジョブで実行します。QPU の代わりに AerSimulator を渡すと、そのシミュレーター上でローカルに実行されます。そこで、チェックの探索に使用したのと同じ脱分極ゲート・ノイズを持つシミュレーターを渡し、すべての回路がクリフォードであるため、スタビライザー法を使用します。Qiskit Aer が必要なのは、このシミュレーターを構築するためだけです。ローカルモードは Executor オプションからシードを取得しますが、その noise_model は無視するため、ノイズはシミュレーター自体に設定する必要があります。代わりに QPU バックエンドを渡せば、同じプログラムがハードウェア上で実行されます。シミュレーションが完了したら、データを可視化する前に、ポストセレクション率と期待値を計算して、エラー検出がどの程度うまく機能したかを把握します。
from qiskit import ClassicalRegister
from qiskit_aer import AerSimulator
from qiskit_aer.noise import NoiseModel as AerNoiseModel
from qiskit_aer.noise import depolarizing_error
from qiskit_ibm_runtime import Executor
from qiskit_ibm_runtime.quantum_program import QuantumProgram
from samplomatic.builders import build
from samplomatic.transpiler import generate_boxing_pass_manager

# Group the terminal measurements into a box whose measurement basis is chosen at sampling time
boxing_pm = generate_boxing_pass_manager(
    enable_gates=False, measure_annotations="change_basis"
)

# bases[i, q]: basis in which physical qubit q is measured for stabilizer i (I=0, Z=1, X=2, Y=3)
bases = np.ones((len(stabilizers), backend.num_qubits), dtype=np.uint8)
bases[:, layout] = stabilizers.z + 2 * stabilizers.x

program = QuantumProgram(shots=num_shots)
for variant in checked:
    circ = variant.circuit.copy()
    circ.add_register(meas := ClassicalRegister(num_qubits, "meas"))
    circ.measure(layout, meas)
    template, samplex = build(boxing_pm.run(circ))
    (basis_input,) = samplex.inputs().get_specs()
    measured_qubits = sorted(layout + list(variant.check_qubits))
    program.append_samplex_item(
        template,
        samplex=samplex,
        samplex_arguments={basis_input.name: bases[:, measured_qubits]},
        shape=(len(stabilizers),),
    )

# Simulate the program with the same gate noise we used to find the checks
aer_nm = AerNoiseModel()
aer_nm.add_all_qubit_quantum_error(
    depolarizing_error(noise_model.gate_noise, 2), ["cz"]
)
noisy_sim = AerSimulator(method="stabilizer", noise_model=aer_nm)

# outs[k][register]: bits of the variant with k checks, shape (stabilizers, shots, bits)
t0 = time.time()
outs = (
    Executor(noisy_sim, options={"simulator": {"seed_simulator": seed}})
    .run(program)
    .result()
)
print(
    f"Sampled {len(checked)} circuits for {len(stabilizers)} stabilizers in {time.time() - t0:.0f}s."
)
Sampled 8 circuits for 100 stabilizers in 77s.
9. チェック付き回路のサンプルをポストセレクションする
このパッケージでは、チェックは1つの補助量子ビットと1つのターゲット量子ビットの間のエンタングリング・ゲートを使って実装されます。各補助量子ビットは で始まるため、 はその入力状態を安定化します。補助量子ビットの開始時点からチェック付き回路全体を通して を順方向に伝播させると、 と準備された状態のスタビライザーとの積が得られるため、補助量子ビットのビットが であればチェックに合格します。すべてのチェックに合格した場合に、サンプルが保持されます。
チェック付き回路は補助量子ビットを checks_c レジスターに測定するため、そのレジスターのすべてのビットが 0 であればサンプルが保持されます。一般に、add_pauli_checks が出力する CheckedCircuit インスタンスの get_postselection_method メソッドは、1ショットのビット列をすべてのチェックのシンドロームに一度に対応付けます。準備された状態のスタビライザーに対して見つけたチェックでは、各シンドロームは単にその補助量子ビットのビットであるため、レジスターを直接読み取ります。
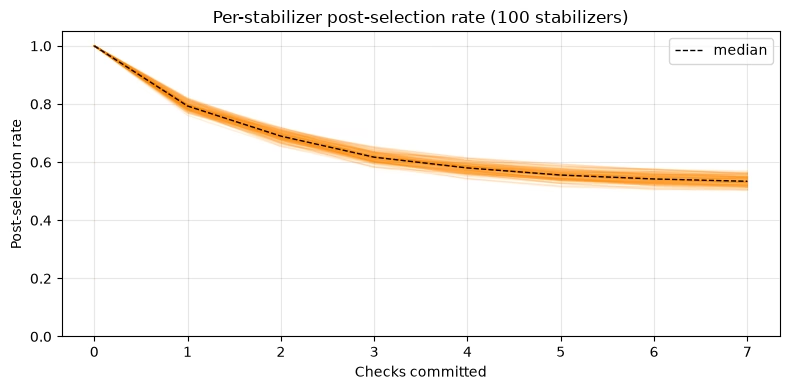
チャートを見ると、チェックを追加するほどポストセレクション率が下がることがわかります。エラー検出の目的はできるだけ多くのエラーを捉えることですが、ポストセレクション率が下がるにつれて、目標の精度を達成するためにより多くのショットが必要になる場合があります。ポストセレクション率が低くなりすぎると、1つの論理サンプルを集めるのに必要なショット数が非現実的になる可能性があります。この例では、ポストセレクション率は収束しているように見え、追加のチェックによる検出能力の向上が小さくなっていることを示唆しています。パウリ・チェックを追加すると、一般にエラー検出能力は高まりますが、回路の深さとサンプリングのコストが増加します。
def keep_mask(out):
    """Per-shot True/False: every ancilla read 0, so every Pauli check passed."""
    if "checks_c" not in out:  # the bare payload has no checks
        return np.ones(out["meas"].shape[:-1], dtype=bool)
    return ~out["checks_c"].any(axis=-1)

# masks[k][i]: kept shots of stabilizer i measured on the variant with k checks
masks = [keep_mask(out) for out in outs]
psrs_arr = np.array([mask.mean(axis=-1) for mask in masks]).T
ks = np.arange(psrs_arr.shape[1])

fig, ax = plt.subplots(figsize=(8, 4))
ax.plot(ks, psrs_arr.T, color="darkorange", alpha=0.15, linewidth=1)
ax.plot(
    ks,
    np.median(psrs_arr, axis=0),
    color="black",
    linewidth=1,
    linestyle="--",
    label="median",
)
ax.set(
    xlabel="Checks committed",
    ylabel="Post-selection rate",
    ylim=(0, 1.05),
    title=f"Per-stabilizer post-selection rate ({len(psrs_arr)} stabilizers)",
)
ax.legend()
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
10. 元のノイズ状態とポストセレクション後のノイズ状態の忠実度を比較する
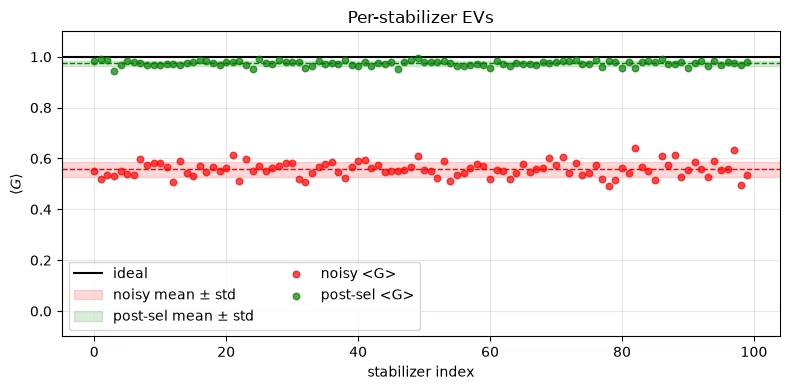
エラーが検出されなかったサンプルだけをポストセレクションすることで、すべてのスタビライザーの期待値が大幅に改善され、その結果スタビライザー状態の推定忠実度も向上することがわかります。ポストセレクション後の値は、すべてのチェックに合格したサンプルだけを使って計算されましたが、期待値ははるかに正確で、サンプリングの分散も小さくなっています。また、先ほどのポストセレクション率が、実際にはノイズのある回路の忠実度に近い値に収束していたこともわかります。ポストセレクション率が収束していたのは、回路の実行中に実際に発生しているエラーの大部分をチェックが捉えていたためです。
def expectation_values(out, mask):
    """EV of each stabilizer from the shots of ``out`` kept by ``mask``.

    Bit q of ``meas`` is virtual qubit q, so a stabilizer's eigenvalue in a shot is the parity of
    the bits in its support, times its sign.
    """
    support = stabilizers.x | stabilizers.z
    parity = (out["meas"] & support[:, None, :]).sum(axis=-1) % 2
    signs = np.where(stabilizers.phase == 2, -1.0, 1.0)
    eigenvalues = np.where(parity, -1.0, 1.0) * signs[:, None]
    kept = mask.sum(axis=-1)
    return np.where(
        kept > 0,
        (eigenvalues * mask).sum(axis=-1) / np.maximum(kept, 1),
        np.nan,
    )

evs_noisy = expectation_values(outs[0], masks[0])
evs_post = expectation_values(outs[-1], masks[-1])
print(
    f"ideal fidelity: 1.0\n"
    f"noisy fidelity: {np.nanmean(evs_noisy):.4f}\n"
    f"postselected fidelity: {np.nanmean(evs_post):.4f}\n"
    f"mean post-sel rate: {masks[-1].mean():.3f}\n"
)

evs_ideal = np.ones(len(stabilizers))
idx = np.arange(len(stabilizers))

def cum_mean_sem(ys):
    valid = ~np.isnan(ys)
    s = np.cumsum(np.where(valid, ys, 0.0))
    s2 = np.cumsum(np.where(valid, ys**2, 0.0))
    n = np.maximum(np.cumsum(valid).astype(float), 1)
    mean = s / n
    sem = np.sqrt(np.maximum(s2 / n - mean**2, 0) / n)
    return np.where(np.cumsum(valid) > 0, mean, np.nan), sem

def strip(ax, ys, color, label):
    m, s = np.nanmean(ys), np.nanstd(ys)
    ax.axhspan(
        m - s, m + s, color=color, alpha=0.15, label=f"{label} mean ± std"
    )
    ax.axhline(m, color=color, linewidth=1, linestyle="--")

fig, ax = plt.subplots(figsize=(8, 4))
ax.axhline(np.nanmean(evs_ideal), color="black", linewidth=1.5, label="ideal")
strip(ax, evs_noisy, "red", "noisy")
strip(ax, evs_post, "green", "post-sel")
ax.scatter(
    idx, evs_noisy, color="red", s=22, alpha=0.7, zorder=3, label="noisy <G>"
)
ax.scatter(
    idx,
    evs_post,
    color="green",
    s=22,
    alpha=0.7,
    zorder=3,
    label="post-sel <G>",
)
ax.set(
    xlabel="stabilizer index",
    ylabel=r"$\langle G \rangle$",
    ylim=(-0.1, 1.1),
    title="Per-stabilizer EVs",
)
ax.legend(loc="lower left", ncol=2)
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()

M = np.arange(1, len(stabilizers) + 1)
fig, ax = plt.subplots(figsize=(8, 4))
for ys, color, label in [
    (evs_ideal, "black", "ideal"),
    (evs_noisy, "red", "noisy"),
    (evs_post, "green", "post-sel"),
]:
    cm, sem = cum_mean_sem(ys)
    ax.plot(M, cm, color=color, linewidth=1.5, label=label)
    ax.fill_between(M, cm - sem, cm + sem, color=color, alpha=0.15)
ax.set(
    xlabel="number of stabilizers averaged",
    ylabel="running fidelity estimate",
    title="Fidelity convergence vs. number of stabilizers",
)
ax.legend()
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
ideal fidelity: 1.0
noisy fidelity: 0.5582
postselected fidelity: 0.9747
mean post-sel rate: 0.535

1つのチェックのセットがすべてのスタビライザーに使えるため、見るべきガンマ曲線は1つだけです。これは、各チェックが確定した後のコスト関数の値です。異なる物理量子ビットのセットを使う別の問題や、不完全なノイズモデル(このチュートリアルのノイズモデルは、サンプルに影響するノイズを正確にモデル化していたことを思い出してください)では、チェックをターゲット量子ビットに追加する順序が、曲線の収束の仕方により顕著な影響を与えることがあります。
このガンマ曲線が 1.0 に収束することは、チェックで検出されないモデル化されたエラーがほとんどないため、追加のチェックでは、これ以上多くのエラーを検出できないことを意味します。これは、ポストセレクション率の収束が、回路内に未検出のエラーがないことによるものだという先ほどの観察を裏付けています。
costs = [variant.cost for variant in checked]

fig, ax = plt.subplots(figsize=(8, 4))
ax.plot(range(len(costs)), costs, color="steelblue", marker="o")
ax.set(
    xlabel="Checks committed",
    ylabel="Gamma",
    yscale="log",
    title="Gamma of the noise left uncovered by the checks",
)
ax.grid(True, alpha=0.3, which="both")
plt.tight_layout()
plt.show()
